

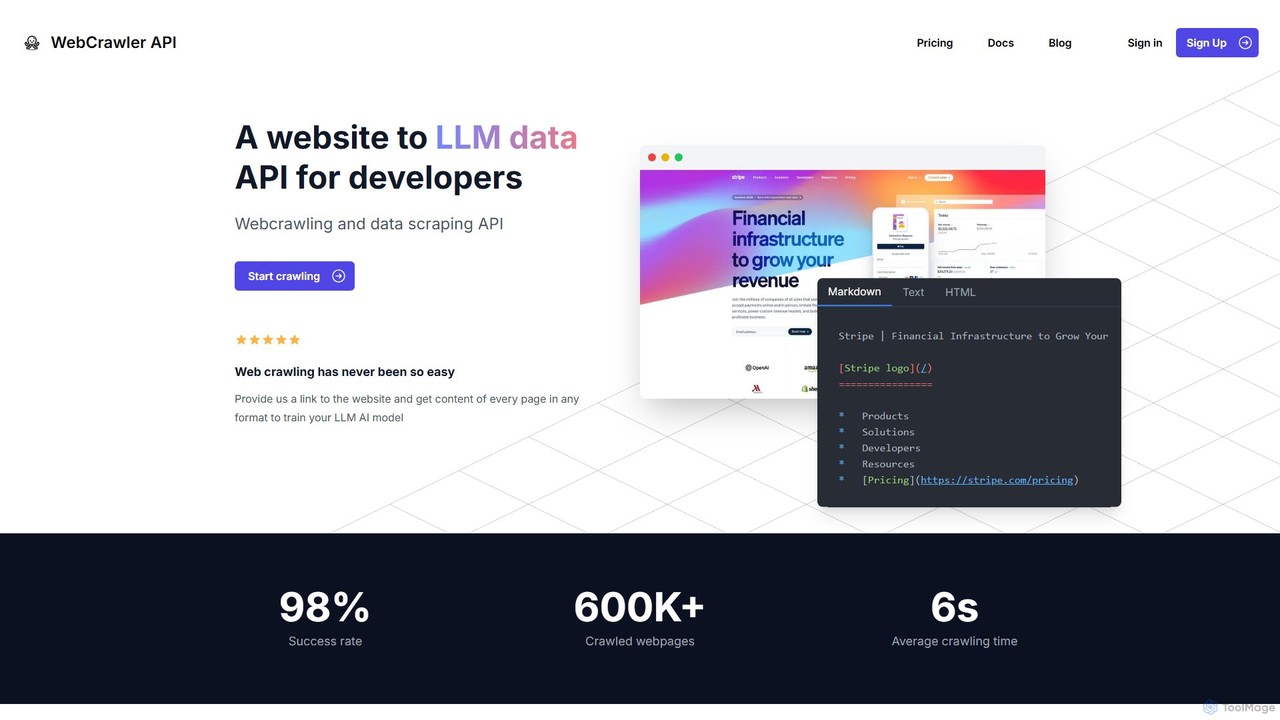
Webcrawlerapi Overview
Webcrawlerapi é uma API especializada projetada para otimizar o processo de rastreamento da web e extração de dados para desenvolvedores. Em uma era onde os dados são cruciais para treinar grandes modelos de linguagem (LLMs) e alimentar aplicações de IA, a raspagem de dados tradicional apresenta desafios significativos. Estes incluem lidar com conteúdo dinâmico renderizado por JavaScript, contornar sistemas anti-bot sofisticados, gerenciar proxies e limpar HTML bagunçado em formatos utilizáveis. A Webcrawlerapi abstrai todas essas complexidades, fornecendo uma interface simples, mas poderosa, para transformar qualquer site em uma fonte de dados estruturada.
Com uma taxa de sucesso relatada de 98% e um tempo médio de rastreamento de apenas 6 segundos, o serviço é construído para eficiência e confiabilidade. Ele permite que os desenvolvedores se concentrem na lógica principal de sua aplicação, em vez de se prenderem às complexidades de construir e manter uma infraestrutura de rastreamento escalável. Ao fornecer um link, os desenvolvedores podem receber conteúdo limpo e pronto para uso em formatos como Markdown, texto ou HTML bruto, tornando-o perfeito para alimentar pipelines de treinamento de modelos de IA ou bases de conhecimento para sistemas RAG.
Como usar Webcrawlerapi
Integrar a Webcrawlerapi em seu projeto é projetado para ser simples. O processo geralmente envolve apenas algumas linhas de código. Primeiro, você precisa se inscrever no site da Webcrawlerapi para obter sua chave de acesso única da API. Em seguida, você pode usar uma de suas bibliotecas de cliente fornecidas para linguagens de programação populares.
Por exemplo, em um ambiente NodeJS, você começaria instalando a biblioteca do cliente via npm: npm i webcrawlerapi-js. Então, em seu código, você importa a biblioteca, cria uma nova instância do cliente com sua chave de API e chama o método `crawl`. Este método aceita parâmetros como a `url` de destino, o `scrape_type` desejado (por exemplo, 'markdown') e limites opcionais como `items_limit`. A API então lida com todo o processo de rastreamento em segundo plano e retorna uma resposta JSON estruturada com os dados extraídos. Padrões de integração simples semelhantes estão disponíveis para Python, PHP e .NET, tornando-o acessível a uma ampla gama de desenvolvedores.
Recursos principais do Webcrawlerapi
- Manuseio Automatizado de Links: A API descobre e gerencia inteligentemente todos os links internos em um site, garantindo um rastreamento abrangente enquanto lida automaticamente com duplicatas e limpa URLs.
- Renderização Avançada de JavaScript: Renderiza efetivamente conteúdo dinâmico do lado do cliente usando um sistema estável e robusto, superando a instabilidade e os problemas de memória frequentemente associados a ferramentas como Puppeteer ou Playwright.
- Evasão Robusta de Anti-Bot: A Webcrawlerapi vem com mecanismos integrados para lidar com CAPTCHAs, bloqueios de IP, limites de taxa e outras defesas anti-bot comuns, garantindo uma alta taxa de sucesso.
- Limpeza Automática de Dados: Inclui regras de análise poderosas para converter HTML bruto e complexo em formatos limpos e estruturados como Markdown ou texto simples, economizando um tempo significativo de pós-processamento para os desenvolvedores.
- Infraestrutura Escalável: O serviço gerencia uma infraestrutura distribuída de rastreadores e proxies, permitindo que você dimensione seus esforços de extração de dados de algumas páginas para milhões sem se preocupar com o hardware subjacente ou o gerenciamento de rede.
- API e SDKs Amigáveis para Desenvolvedores: Oferece uma API simples e bibliotecas de cliente oficiais para as principais linguagens como NodeJS, Python, PHP e .NET, completas com documentação clara.
Casos de uso para Webcrawlerapi
A Webcrawlerapi é versátil e pode ser aplicada a uma variedade de tarefas intensivas em dados. Seus principais casos de uso giram em torno de IA e análise de dados.
- Coleta de Dados para Treinamento de LLM: Rastreie sistematicamente sites, blogs e fóruns para coletar grandes quantidades de dados de texto de alta qualidade e específicos de domínio para treinar ou ajustar modelos de linguagem grandes personalizados.
- Geração Aumentada por Recuperação (RAG): Construa e mantenha bases de conhecimento atualizadas para sistemas RAG. Rastreie documentação de produtos, centrais de ajuda ou sites de notícias para fornecer aos LLMs informações precisas e em tempo real para responder às perguntas dos usuários.
- Pesquisa de Mercado e Análise Competitiva: Extraia automaticamente detalhes de produtos, informações de preços, avaliações de clientes e conteúdo de marketing de sites de concorrentes para obter insights estratégicos.
- Agregação de Conteúdo: Potencialize agregadores de notícias, quadros de empregos ou sites de listagem de imóveis, rastreando regularmente várias fontes и consolidando os dados em uma plataforma unificada.
Vantagens do Webcrawlerapi
A principal vantagem da Webcrawlerapi é sua simplicidade e eficiência. Ela permite que as equipes de desenvolvimento terceirizem toda a infraestrutura de rastreamento da web e o ônus da manutenção. Isso significa um tempo de lançamento mais rápido para produtos orientados a dados. A alta taxa de sucesso (98%) e os recursos robustos anti-bot garantem que os pipelines de dados sejam confiáveis. Além disso, seu modelo de preços transparente e de pagamento conforme o uso é altamente econômico, pois você paga apenas por solicitações bem-sucedidas, eliminando o risco e a sobrecarga associados a assinaturas ou à construção de uma solução interna.
Preços e planos
A Webcrawlerapi emprega um modelo de preços 'pague pelo uso' direto e transparente, evitando completamente assinaturas e taxas ocultas. Os custos são calculados com base no número de páginas que você rastreia com sucesso a cada mês. O serviço inclui trabalhos de rastreamento ilimitados, uma rede de proxy ilimitada e gerenciada automaticamente, e suporte por e-mail em seu preço. Para uma estimativa de custo clara, o site fornece uma calculadora. Como exemplo, rastrear 10.000 páginas em um mês custaria aproximadamente $20. Este modelo é ideal para projetos de todos os tamanhos, desde experimentos em pequena escala até operações de dados em grande escala, pois os custos escalam diretamente com o uso. A plataforma também permite que os usuários experimentem o serviço antes de fazer uma compra, provavelmente através de uma alocação de crédito gratuito para novas contas.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 5.1K
- 2026-1: 4.5K
- 2026-2: 4.0K
- 2026-3: 4.3K
- 2026-4: 5.6K
- 2026-5: 5.4K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos49.1%
- 🇩🇪Alemanha20.9%
- 🇮🇳Índia14.8%
- 🇻🇳Vietnã12.2%
- 🇦🇺Austrália2.9%
Top keywords
| Keyword | Cost per click |
|---|---|
| better to save as an html or md file packing more information | $0.00 |
| data scraping law cases | $0.00 |
| firecrawl alternatives | $11.71 |
| llms txt generator online | $0.00 |
| submit website to chatgpt | $0.00 |
Webcrawlerapi Alternatives
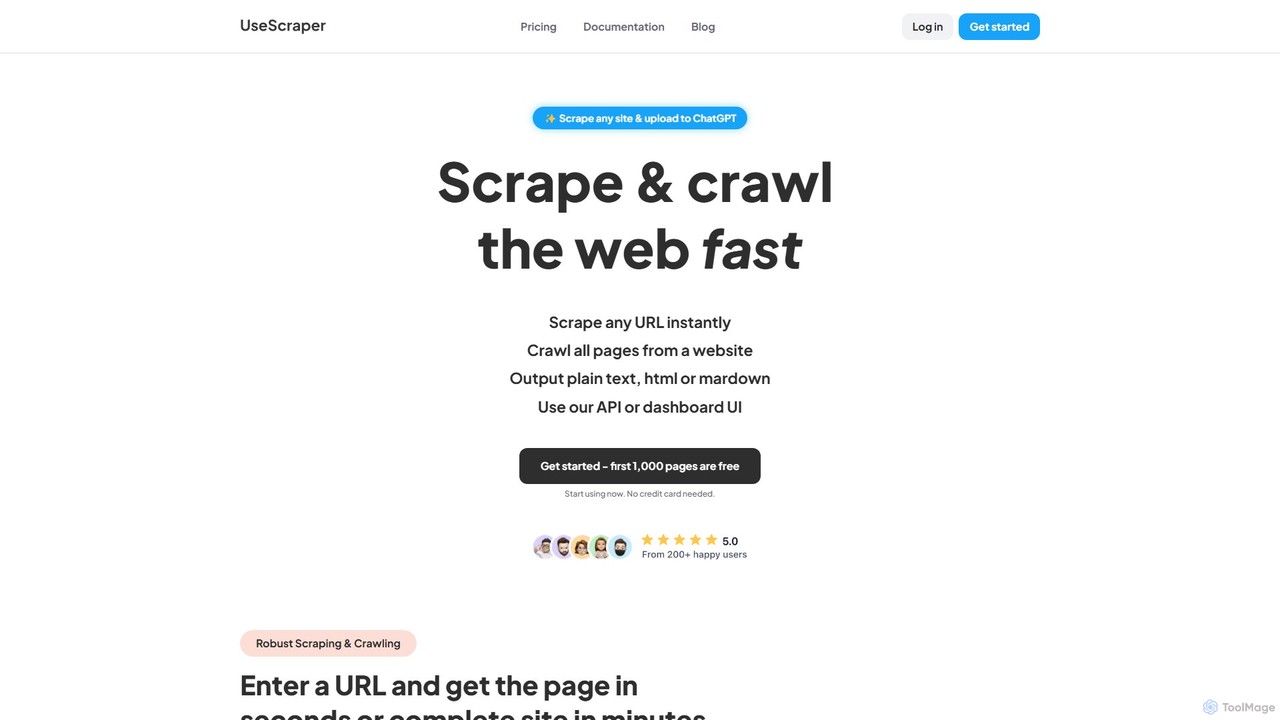
UseScraper
UseScraper é uma poderosa API de crawler e scraper da web projetada para desenvolvedores e aplicações de IA. Extrai dados de qualquer site de forma eficiente, com renderização completa de JavaScript, infraestrutura de autoescalonamento e formatos de saída limpos como Markdown, ideal para alimentar dados em LLMs como o ChatGPT.
Extração de Dados
Foxscrape
O FoxScrape é uma API REST de web scraping com IA para desenvolvedores. Ele simplifica a extração de dados convertendo qualquer site em dados JSON estruturados, usando recursos como análise orientada por IA a partir de inglês simples, renderização de JavaScript para sites dinâmicos e rotação automática de proxy para evitar bloqueios.
Extração de Dados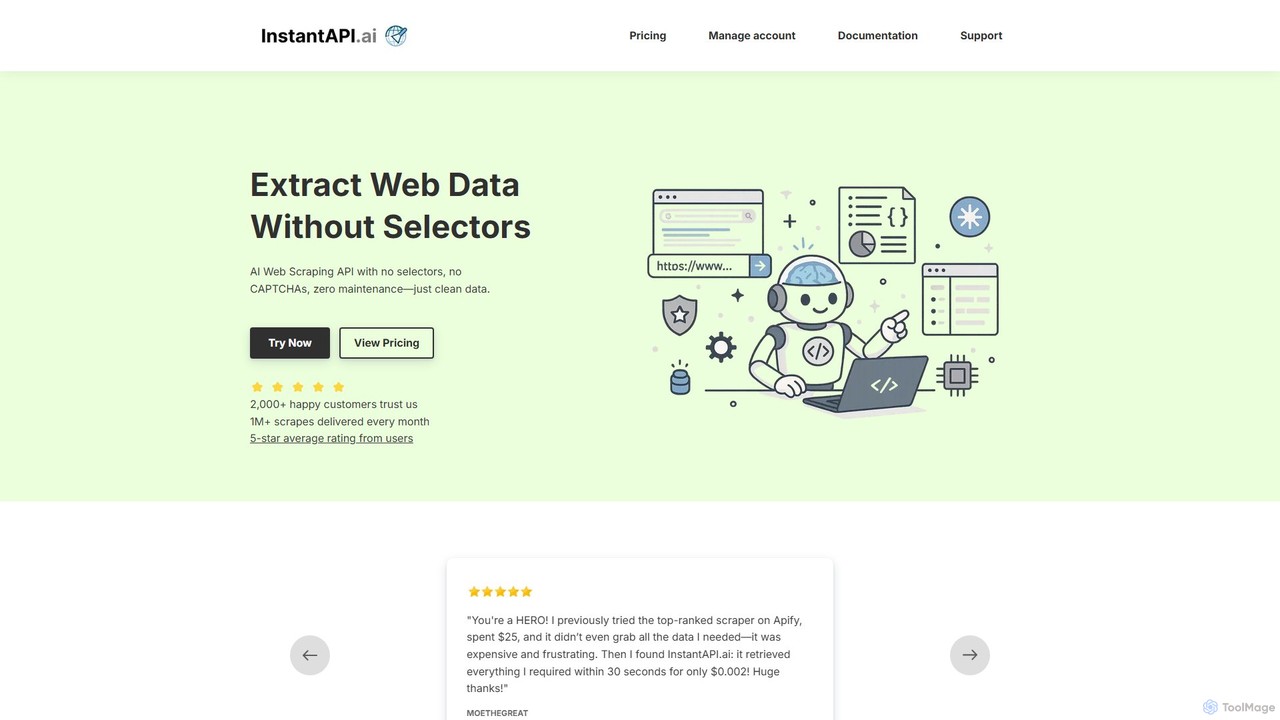
instantapi
O instantapi é uma API de web scraping alimentada por IA, projetada para simplicidade e velocidade. Permite que os usuários extraiam dados estruturados de qualquer site com uma única chamada de API, eliminando a necessidade de codificação complexa ou configuração manual. Ideal para desenvolvedores, analistas de dados e empresas que precisam de extração de dados rápida, acessível e confiável sem o incômodo dos raspadores da web tradicionais.
Extração de Dados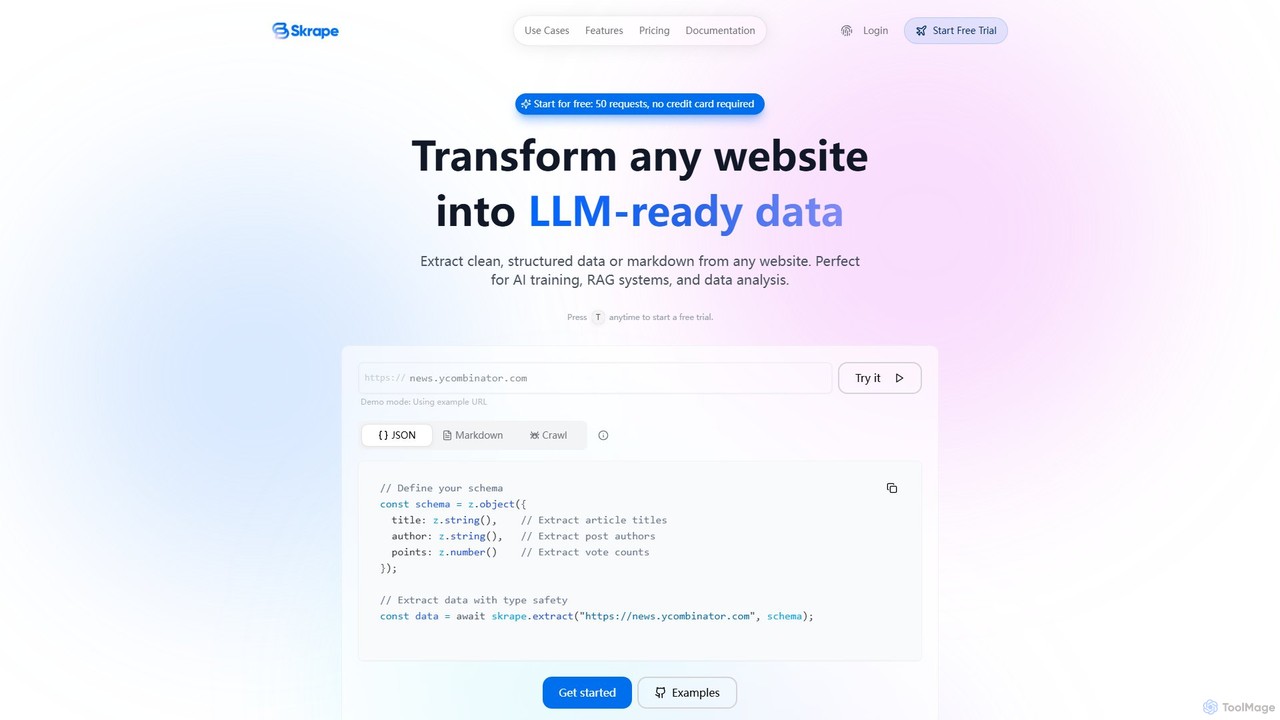
Skrape
Skrape é uma API de web scraping alimentada por LLM, projetada para transformar qualquer site em dados limpos, estruturados e prontos para LLM. Simplifica a extração de dados convertendo páginas da web em JSON estruturado ou markdown limpo, tornando-o ideal para treinamento de IA, sistemas RAG e análise de dados. Com recursos como manipulação de conteúdo dinâmico e rastreamento inteligente, o Skrape oferece uma solução confiável para desenvolvedores e empresas automatizarem seus pipelines de coleta de dados.
Raspagem
Isomeric
Isomeric é uma API alimentada por IA que transforma texto desestruturado e confuso de qualquer fonte em dados JSON limpos e estruturados. Ao definir um esquema JSON simples, você pode extrair automaticamente informações específicas de sites, documentos legais, transcrições de suporte ao cliente e muito mais, otimizando pipelines de dados e automação.
Extração de DadosWebcrawlerapi Categories
Webcrawlerapi Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
UseScraper
UseScraper é uma poderosa API de crawler e scraper da web projetada para desenvolvedores e aplicações de IA. Extrai dados de qualquer site de forma eficiente, com renderização completa de JavaScript, infraestrutura de autoescalonamento e formatos de saída limpos como Markdown, ideal para alimentar dados em LLMs como o ChatGPT.
Extração de DadosSkrape
Skrape é uma API de web scraping alimentada por LLM, projetada para transformar qualquer site em dados limpos, estruturados e prontos para LLM. Simplifica a extração de dados convertendo páginas da web em JSON estruturado ou markdown limpo, tornando-o ideal para treinamento de IA, sistemas RAG e análise de dados. Com recursos como manipulação de conteúdo dinâmico e rastreamento inteligente, o Skrape oferece uma solução confiável para desenvolvedores e empresas automatizarem seus pipelines de coleta de dados.
RaspagemFoxscrape
O FoxScrape é uma API REST de web scraping com IA para desenvolvedores. Ele simplifica a extração de dados convertendo qualquer site em dados JSON estruturados, usando recursos como análise orientada por IA a partir de inglês simples, renderização de JavaScript para sites dinâmicos e rotação automática de proxy para evitar bloqueios.
Extração de Dados
Scrapeless
Um kit de ferramentas de web scraping com tecnologia de IA para desenvolvedores e empresas. Oferece um conjunto de ferramentas, incluindo um Navegador de Scraping, API de Scraping Universal e API Deep SERP para extrair dados públicos da web em escala sem esforço. É especializado em contornar medidas anti-bot, fornecendo dados estruturados para e-commerce, pesquisa de mercado e treinamento de modelos de IA, com foco em confiabilidade e facilidade de uso.
Raspagem
URLtoText
URLtoText é uma ferramenta alimentada por IA que extrai texto limpo e estruturado de qualquer site ou PDF. Remove de forma inteligente anúncios, barras laterais e outros ruídos para fornecer apenas o conteúdo principal. Com renderização de JavaScript, proxies de IP residenciais e uma API para desenvolvedores, é projetado para pesquisadores, desenvolvedores e empresas que precisam de extração de dados confiável de páginas da web estáticas e dinâmicas.
Curadoria de Conteúdo

Apify
Apify é uma plataforma full-stack de web scraping e automação que permite aos desenvolvedores construir, implantar e publicar ferramentas de extração de dados, conhecidas como 'Actors'. Oferece um vasto mercado de scrapers pré-construídos para sites populares como Google Maps, Instagram e TikTok, juntamente com uma infraestrutura de nuvem robusta para criar soluções personalizadas. Com suporte para Python e JavaScript, bibliotecas de código aberto e integrações perfeitas, a Apify simplifica a coleta de dados da web em qualquer escala.
Coleta de Dados
CapSolver
CapSolver é um serviço de resolução automática de CAPTCHA alimentado por IA, projetado para desenvolvedores e profissionais de RPA. Ele fornece uma solução de alta precisão, rápida e escalável para contornar vários tipos de CAPTCHAs, incluindo reCAPTCHA, hCaptcha e FunCaptcha, facilitando a extração de dados da web e a automação de processos sem interrupções.
Extração de Dados
WebScraping.AI
WebScraping.AI é uma API avançada para desenvolvedores que simplifica a raspagem de dados da web usando IA. Possui proxies rotativos, renderização de JavaScript e geolocalização para contornar bloqueios e acessar conteúdo dinâmico. Sua principal força reside em suas ferramentas alimentadas por LLM, que podem extrair dados não estruturados, gerar resumos e responder a perguntas diretamente de páginas da web, otimizando a coleta de dados para qualquer projeto.
Extração de Dados
AgentQL
AgentQL é um conjunto de ferramentas para desenvolvedores que conecta LLMs e agentes de IA à web. Ele usa uma linguagem de consulta alimentada por IA para extrair dados estruturados de forma robusta e automatizar interações na web, servindo como uma alternativa poderosa e auto-reparável aos frágeis seletores XPath e CSS.
LLM
Crawleo
Uma poderosa API dois-em-um para sistemas de IA, fornecendo pesquisa na web em tempo real e crawling profundo. Entrega dados estruturados e prontos para IA (JSON, Markdown) de qualquer site, contornando medidas anti-bot e garantindo a privacidade com uma política rigorosa de retenção zero de dados. Projetado para pipelines RAG, LLMs e fluxos de trabalho de automação.
Recuperação de Dados
Jsonify
Jsonify é uma plataforma alimentada por IA projetada para empresas encontrarem, extraírem e estruturarem dados de vários documentos e fontes da web automaticamente em formato JSON limpo. Ele otimiza os fluxos de trabalho de processamento de dados, eliminando a entrada manual e permitindo a integração perfeita por meio de sua API robusta.
Análise de Dados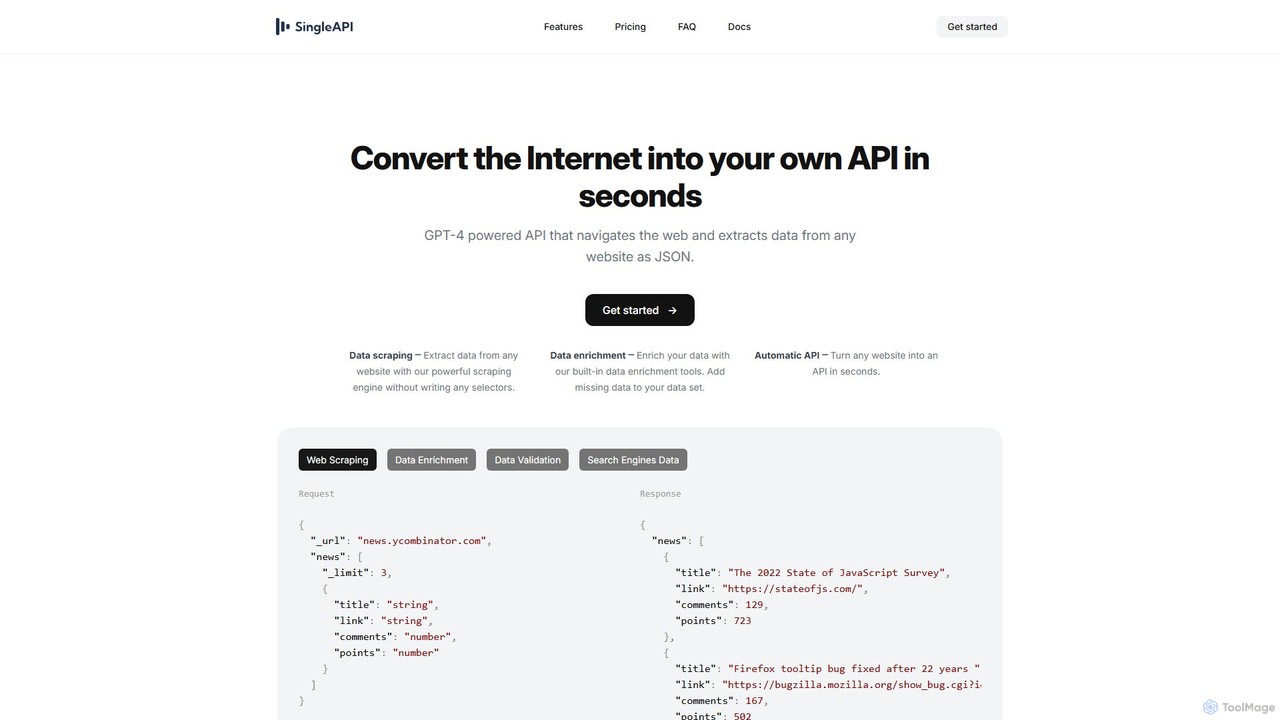
SingleAPI
SingleAPI é uma ferramenta alimentada por GPT-4 que converte instantaneamente qualquer site em uma API JSON estruturada. Simplifica a raspagem de dados da web, extração de dados e enriquecimento de dados sem escrever nenhum código ou seletores, permitindo que os usuários acessem dados da web sem esforço para várias aplicações.
Raspagem de Dados da Web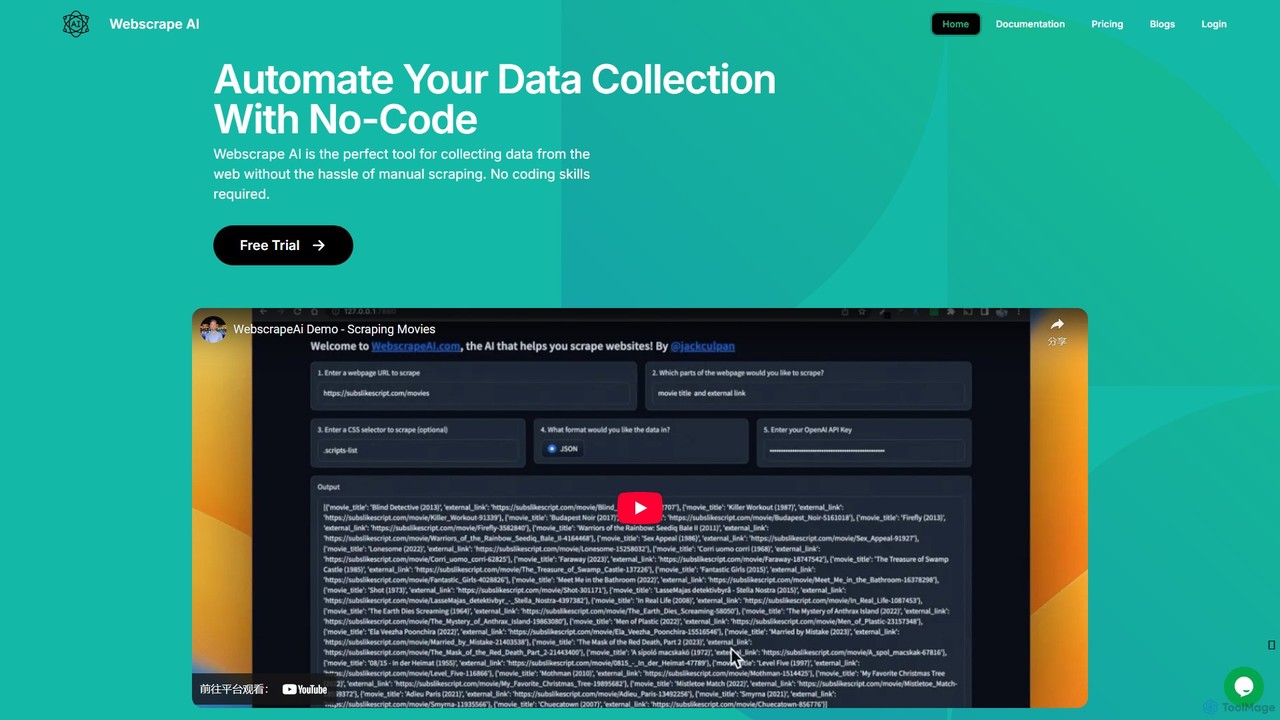
webscrapeai
O WebscrapeAI é uma plataforma sem código, alimentada por IA, projetada para automatizar a coleta de dados da web. Basta fornecer um URL e especificar os dados de que precisa, e a IA lida com todo o processo de scraping. Ele suporta sites dinâmicos, scraping em massa, integração de proxy e oferece uma API para desenvolvedores, tornando a extração de dados rápida, precisa e acessível a todos.
Raspagem de Dados da Web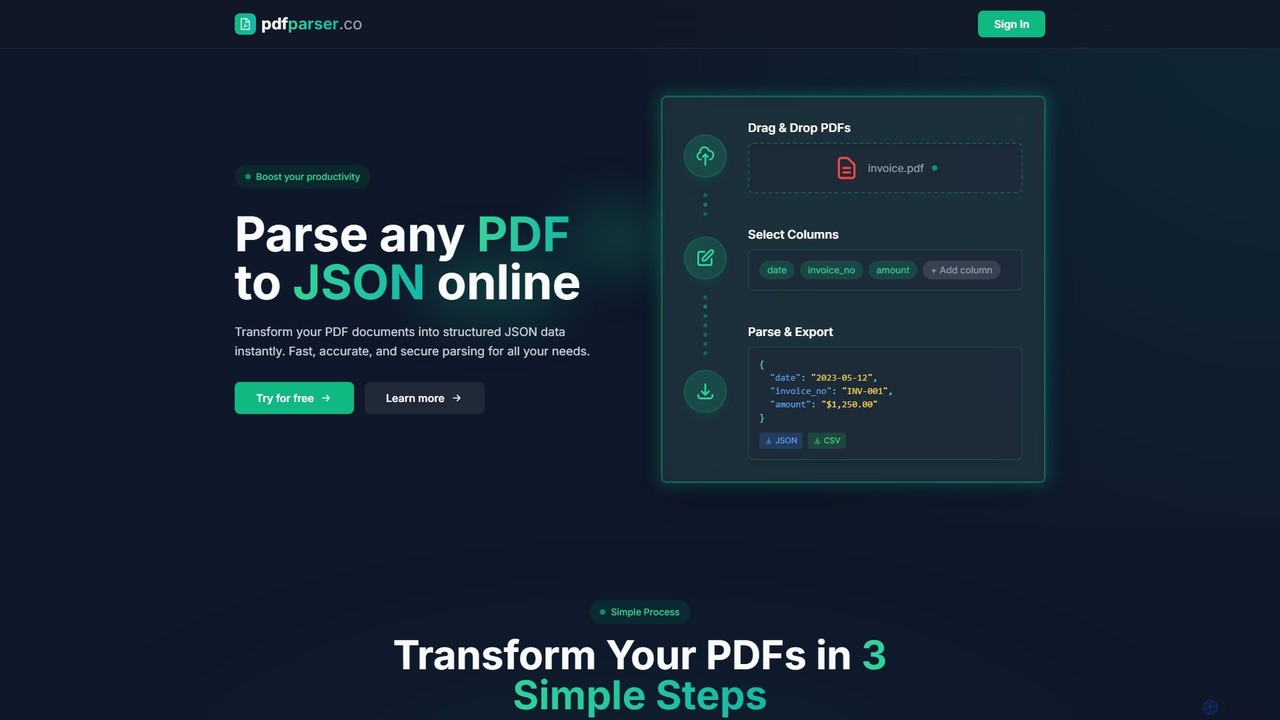
pdfparser
Um serviço de API alimentado por IA, projetado para desenvolvedores e empresas, para analisar documentos PDF sem esforço. Extrai texto, tabelas e dados estruturados de qualquer PDF, incluindo arquivos digitalizados, e retorna uma saída JSON limpa e legível por máquina, automatizando os fluxos de trabalho de extração de dados.
Automação
Webcrawlerapi Comments (0)
Sign in to comment.
EntrarNo comments yet.