

pdfparser Overview
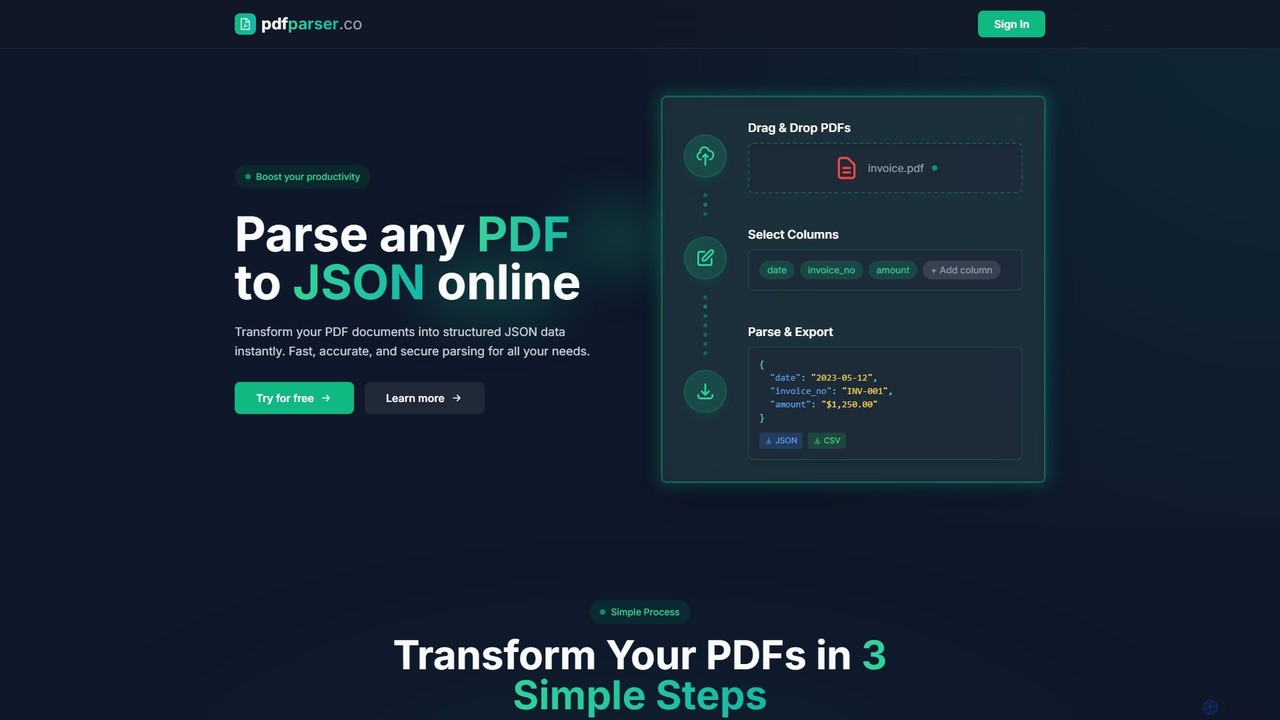
O pdfparser é uma ferramenta especializada de alto desempenho, projetada para desbloquear os dados presos em arquivos PDF. Utilizando IA avançada e tecnologia de Reconhecimento Óptico de Caracteres (OCR), ele oferece uma solução simples, mas poderosa, para converter conteúdo de PDF não estruturado em dados estruturados e acionáveis. Esteja você lidando com PDFs nativos ou digitalizados, faturas, relatórios ou formulários, o pdfparser automatiza o processo de extração, economizando inúmeras horas de entrada manual de dados e reduzindo o erro humano. Sua principal saída é um JSON limpo e bem organizado, tornando incrivelmente fácil para os desenvolvedores integrarem em qualquer aplicação ou pipeline de processamento de dados.
Como usar o pdfparser
O uso do pdfparser foi projetado para ser um processo direto, acessível através de sua API para integração perfeita em seus projetos.
- Inscreva-se e Obtenha Créditos: Crie uma conta no site do pdfparser e compre um pacote de créditos que atenda às suas necessidades. Um crédito corresponde ao processamento de um documento.
- Integração da API: Use sua chave de API exclusiva para autenticar suas solicitações. A documentação fornece exemplos claros para fazer chamadas de API.
- Envie seu PDF: Envie uma solicitação POST para o endpoint da API do pdfparser, incluindo o arquivo PDF que você deseja processar no corpo da solicitação.
- Processamento Alimentado por IA: O backend do serviço analisará automaticamente o documento. Ele detecta o layout, identifica blocos de texto, reconhece tabelas e usa OCR para qualquer texto baseado em imagem.
- Receba JSON Estruturado: A API retornará um objeto JSON detalhado contendo todo o conteúdo extraído, incluindo o texto bruto, dados de tabela estruturados (com linhas e colunas) e metadados sobre o documento.
Recursos principais do pdfparser
- Motor de OCR Avançado: Extrai texto com precisão de documentos digitalizados, imagens de baixa resolução e layouts complexos, suportando vários idiomas.
- Extração Inteligente de Tabelas: Detecta automaticamente tabelas em PDFs e preserva sua estrutura, convertendo linhas e colunas em um array JSON aninhado para fácil análise.
- Saída JSON Estruturada: Todos os dados extraídos são entregues em um formato JSON limpo, previsível e amigável para desenvolvedores, pronto para uso imediato em bancos de dados, aplicações ou ferramentas de análise.
- API Escalável: Construída para desenvolvedores, a API robusta pode lidar com altos volumes de documentos, permitindo o processamento em lote e a extração de dados em tempo real em aplicações empresariais.
- Sistema Simples Baseado em Créditos: O modelo de preços transparente de pagamento conforme o uso permite que você pague apenas pelo que usa, tornando-o econômico tanto para pequenos projetos quanto para operações em grande escala.
Casos de uso para o pdfparser
O pdfparser é uma ferramenta versátil aplicável em inúmeras indústrias:
- Automação Financeira: Extraia automaticamente dados de faturas, ordens de compra, recibos e extratos bancários para otimizar a contabilidade.
- Ciência de Dados e Pesquisa: Analise artigos acadêmicos, relatórios de pesquisa e conjuntos de dados de PDFs para coletar informações para análise sem transcrição manual.
- Jurídico e Conformidade: Extraia rapidamente cláusulas, detalhes de casos e informações-chave de contratos legais, processos judiciais e documentos regulatórios.
- Logística e Cadeia de Suprimentos: Digitalize conhecimentos de embarque, manifestos de remessa e notas de entrega para automatizar o rastreamento e o gerenciamento de estoque.
- Recursos Humanos: Processe currículos e formulários de inscrição para extrair informações de candidatos e popular sistemas de gerenciamento de RH.
Vantagens do pdfparser
A principal vantagem do pdfparser é seu foco na simplicidade e no poder. Ele abstrai a complexidade da análise de PDF e do OCR, fornecendo um serviço confiável que simplesmente funciona. Isso leva a ciclos de desenvolvimento significativamente mais rápidos para aplicações que dependem de dados de documentos. Sua alta precisão na extração de texto e tabelas minimiza a necessidade de revisão e correção manual. O modelo escalável e baseado em créditos garante que empresas de todos os tamanhos possam alavancar o processamento de documentos de nível empresarial sem um grande investimento inicial.
Preços e planos
O pdfparser opera em um sistema de crédito de pagamento conforme o uso, onde 1 crédito é usado para analisar 1 documento.
- Lite: $1,00 por 10 créditos
- Standard: $5,00 por 60 créditos
- Pro: $25,00 por 500 créditos
Os pagamentos são processados com segurança via Cartão ou PayPal. Este preço flexível o torna acessível para desenvolvedores testando uma ideia, pequenas empresas automatizando um fluxo de trabalho ou grandes empresas processando documentos em escala.
pdfparser Alternatives
Finigami AI
A Finigami AI oferece soluções de IA de nível empresarial, especializando-se em processamento inteligente de documentos (IDP) e desenvolvimento de IA personalizado. Fornece uma plataforma poderosa para extrair dados de qualquer documento, incluindo texto manuscrito e tabelas complexas, e estabelece parcerias com empresas para construir sistemas de IA sob medida para funções como finanças, RH e operações.
Automação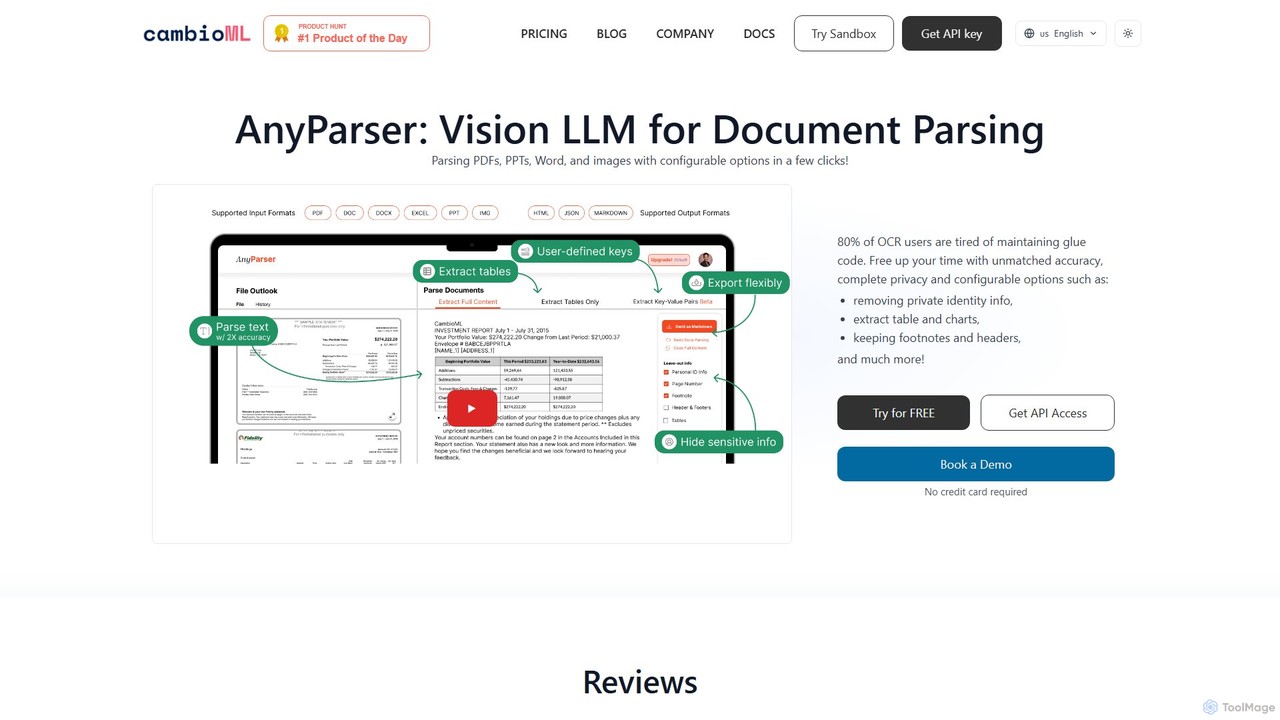
CambioML
O CambioML oferece a API AnyParser, um poderoso LLM de Visão projetado para análise de documentos de alta precisão. Ele extrai texto, tabelas, gráficos e pares chave-valor de PDFs, imagens e documentos do Office. Com recursos como redação de PII, saídas configuráveis e processamento em tempo real, é ideal para desenvolvedores e empresas em finanças, pesquisa e análise de dados para automatizar fluxos de trabalho de extração de dados, garantindo privacidade e eficiência.
Extração de Dados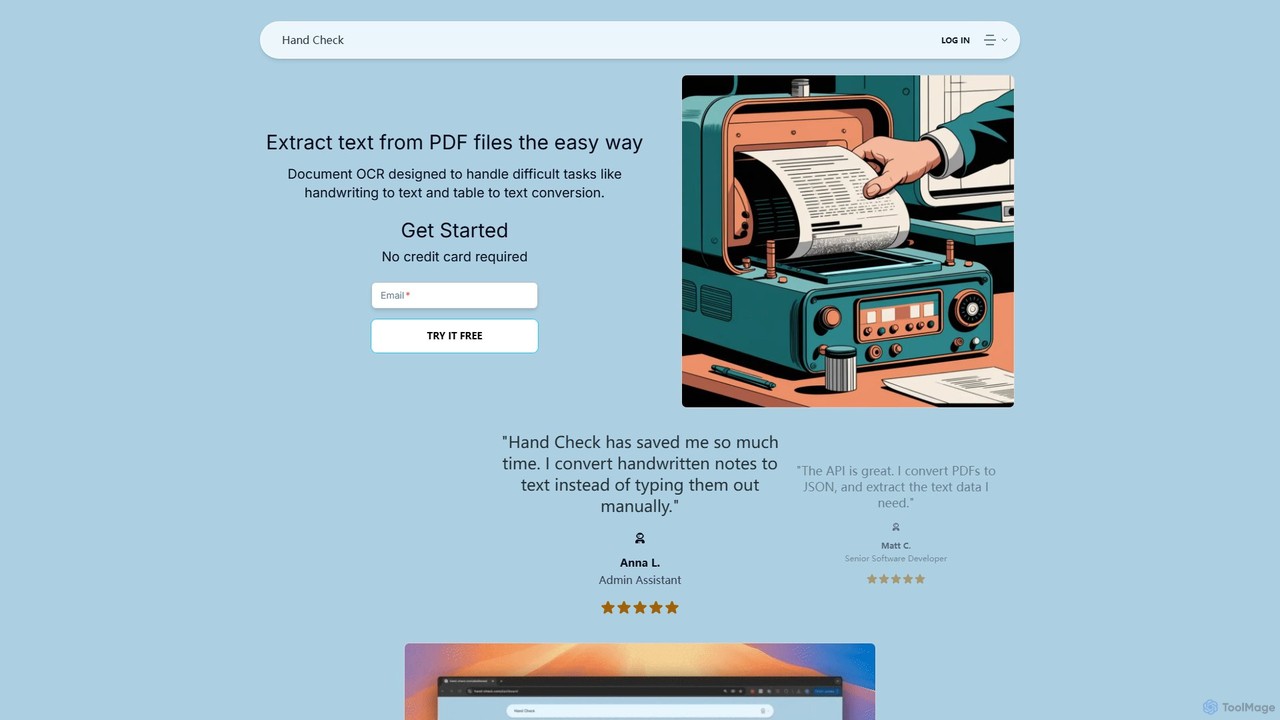
hand_check
hand_check é uma ferramenta avançada de OCR que usa aprendizado de máquina para extrair texto de PDFs e imagens. É especializada na conversão de documentos complexos, incluindo notas manuscritas e tabelas, em texto editável ou dados JSON estruturados. Com uma interface amigável e uma API poderosa para desenvolvedores, é ideal para indivíduos, desenvolvedores e empresas que buscam automatizar o processamento de documentos e a extração de dados.
Extração de Dados
Monkt
Monkt é uma plataforma alimentada por IA que transforma documentos e websites em Markdown limpo e pronto para IA ou JSON estruturado. Suporta vários formatos como PDF, Word e Excel, oferecendo recursos como OCR, processamento em lote e uma API REST para automatizar a extração de dados e preparar conjuntos de dados para treinamento de LLM.
Extração de Dados
Sensible
Sensible é uma plataforma inteligente de processamento de documentos API-first para desenvolvedores. Utiliza análise avançada de LLM e regras baseadas em layout visual para extrair com precisão dados estruturados de qualquer documento, como PDFs, imagens e planilhas. Foi projetado para integração perfeita, escalabilidade e segurança de nível empresarial, incluindo conformidade com SOC 2 e HIPAA.
Automaçãopdfparser Categories
pdfparser Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
CambioML
O CambioML oferece a API AnyParser, um poderoso LLM de Visão projetado para análise de documentos de alta precisão. Ele extrai texto, tabelas, gráficos e pares chave-valor de PDFs, imagens e documentos do Office. Com recursos como redação de PII, saídas configuráveis e processamento em tempo real, é ideal para desenvolvedores e empresas em finanças, pesquisa e análise de dados para automatizar fluxos de trabalho de extração de dados, garantindo privacidade e eficiência.
Extração de Dadoshand_check
hand_check é uma ferramenta avançada de OCR que usa aprendizado de máquina para extrair texto de PDFs e imagens. É especializada na conversão de documentos complexos, incluindo notas manuscritas e tabelas, em texto editável ou dados JSON estruturados. Com uma interface amigável e uma API poderosa para desenvolvedores, é ideal para indivíduos, desenvolvedores e empresas que buscam automatizar o processamento de documentos e a extração de dados.
Extração de DadosFinigami AI
A Finigami AI oferece soluções de IA de nível empresarial, especializando-se em processamento inteligente de documentos (IDP) e desenvolvimento de IA personalizado. Fornece uma plataforma poderosa para extrair dados de qualquer documento, incluindo texto manuscrito e tabelas complexas, e estabelece parcerias com empresas para construir sistemas de IA sob medida para funções como finanças, RH e operações.
Automação
Reducto
Reducto é uma API avançada de Ingestão de Documentos para desenvolvedores e empresas. Utiliza OCR Agente e Modelos de Linguagem e Visão para analisar, dividir, extrair e até editar documentos com precisão. Transforma dados não estruturados de vários formatos de arquivo em entradas estruturadas e prontas para LLM, automatizando fluxos de trabalho complexos de processamento de documentos com alta precisão e segurança de nível empresarial.
Processamento de DocumentosMonkt
Monkt é uma plataforma alimentada por IA que transforma documentos e websites em Markdown limpo e pronto para IA ou JSON estruturado. Suporta vários formatos como PDF, Word e Excel, oferecendo recursos como OCR, processamento em lote e uma API REST para automatizar a extração de dados e preparar conjuntos de dados para treinamento de LLM.
Extração de DadosSensible
Sensible é uma plataforma inteligente de processamento de documentos API-first para desenvolvedores. Utiliza análise avançada de LLM e regras baseadas em layout visual para extrair com precisão dados estruturados de qualquer documento, como PDFs, imagens e planilhas. Foi projetado para integração perfeita, escalabilidade e segurança de nível empresarial, incluindo conformidade com SOC 2 e HIPAA.
Automação
Doctly
Doctly é uma ferramenta alimentada por IA que extrai dados de PDFs e outros documentos com precisão. Converte texto, tabelas, figuras e gráficos em Markdown ou JSON estruturado, preservando a formatação original. Com uma API simples e alta precisão, é projetado para desenvolvedores e empresas automatizarem fluxos de trabalho de processamento de documentos.
Extração de Dados
FormX.ai
FormX.ai é uma plataforma alimentada por IA que automatiza a extração de dados de qualquer documento. Utiliza IA avançada, incluindo LLMs e modelos de visão, para processar faturas, recibos, cartões de identificação e mais, otimizando fluxos de trabalho de negócios e melhorando a eficiência operacional.
Extração de Dados
extracta.ai
extracta.ai é uma plataforma alimentada por IA projetada para extração inteligente de dados de documentos e imagens. Ela automatiza o processo de captura de dados estruturados de várias fontes como faturas, recibos, contratos e formulários, eliminando a entrada manual de dados e otimizando os fluxos de trabalho de negócios.
Automação
Webcrawlerapi
Webcrawlerapi é uma API poderosa para desenvolvedores rastrearem sites e extraírem dados limpos sem esforço. Simplifica a raspagem de dados ao lidar com renderização de JavaScript, medidas anti-bot e análise de dados. Ideal para coletar conteúdo estruturado como Markdown ou texto para treinar modelos de IA LLM ou para sistemas de Geração Aumentada por Recuperação (RAG), oferece uma alta taxa de sucesso e um modelo de preços simples de pagamento conforme o uso.
Extração de Dados
Foxscrape
O FoxScrape é uma API REST de web scraping com IA para desenvolvedores. Ele simplifica a extração de dados convertendo qualquer site em dados JSON estruturados, usando recursos como análise orientada por IA a partir de inglês simples, renderização de JavaScript para sites dinâmicos e rotação automática de proxy para evitar bloqueios.
Extração de Dados
Expenses Day
O Expenses Day é uma poderosa API de OCR alimentada por IA, projetada para digitalizar qualquer tipo de documento de despesa. Ele extrai dados com precisão de recibos, faturas, extratos bancários e até listas manuscritas, transformando documentos financeiros não estruturados em dados estruturados e utilizáveis para empresas e desenvolvedores.
API
pdfmerse
pdfmerse é um extrator de dados alimentado por IA que automatiza o processo de captura de informações de qualquer documento PDF. Ele converte inteligentemente dados de PDF não estruturados em formatos estruturados como JSON e texto. Ideal para empresas e indivíduos que procuram otimizar o processamento de documentos, reduzir a entrada manual de dados e melhorar a eficiência do fluxo de trabalho com alta precisão.
Automação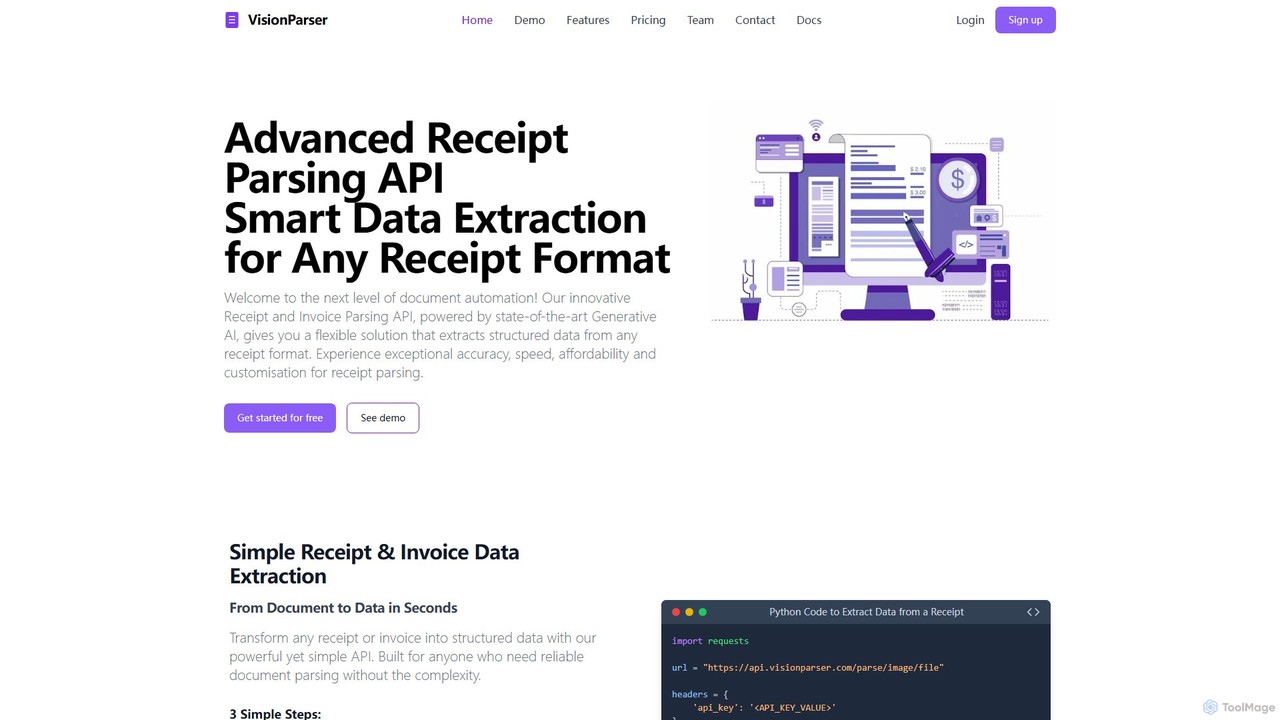
VisionParser
O VisionParser é uma API avançada, alimentada por IA Generativa, para análise de recibos e faturas de alta precisão. Transforma qualquer formato de documento, incluindo cópias digitais e físicas, em dados JSON estruturados em segundos. Projetado para desenvolvedores e empresas, oferece soluções personalizáveis, acessíveis e escaláveis para automatizar a gestão de despesas, contabilidade e análise de dados.
API
pdfparser Comments (0)
Sign in to comment.
EntrarNo comments yet.