

Crawly Overview
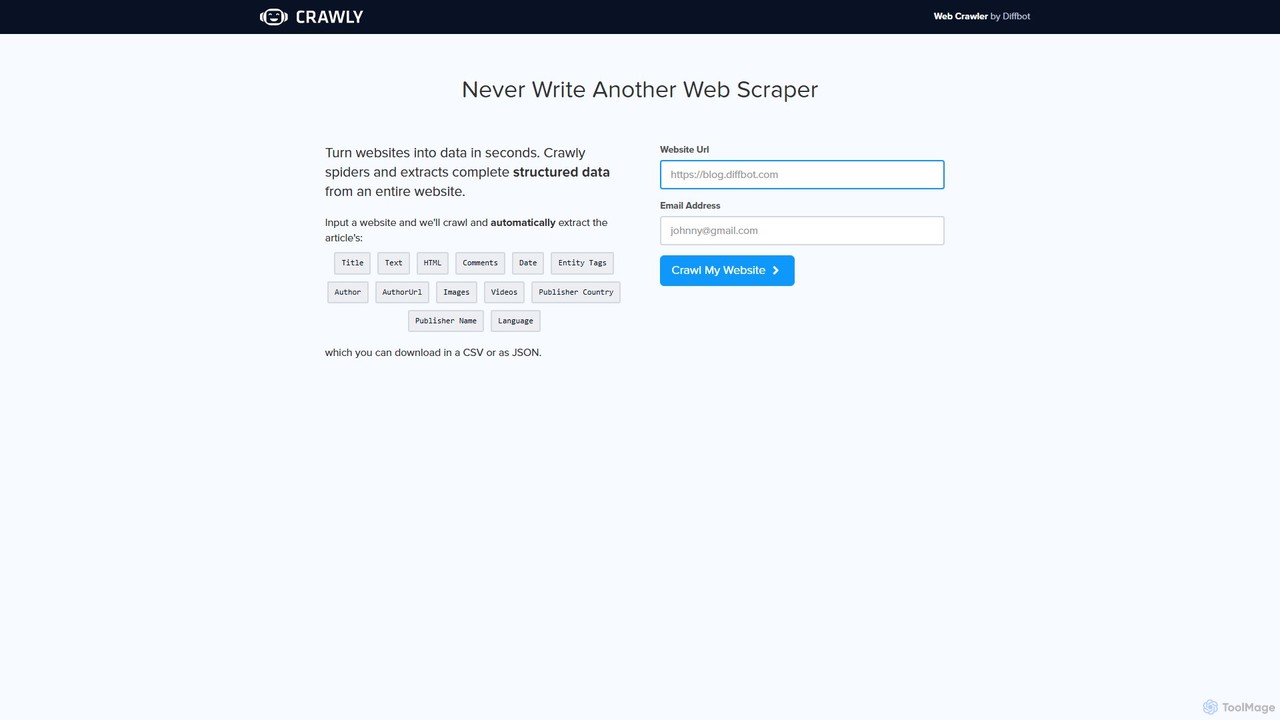
O Crawly é um rastreador da web poderoso e inteligente desenvolvido pela Diffbot, líder em extração de dados alimentada por IA. Ele foi projetado para eliminar completamente os desafios manuais e técnicos da raspagem de dados da web. Em vez de escrever código complexo ou usar seletores frágeis que quebram com as atualizações do site, o Crawly utiliza inteligência artificial avançada, incluindo visão computacional e processamento de linguagem natural, para entender e interpretar páginas da web como um humano. Isso permite que ele identifique e extraia automaticamente dados completos e estruturados de um site inteiro com apenas um URL como entrada.
A promessa central do Crawly é 'transformar sites em dados em segundos'. Ele navega por um site, seguindo links e analisando a estrutura de cada página para diferenciar entre vários tipos de conteúdo, como artigos, produtos, discussões e galerias de imagens. Os dados extraídos são então organizados em um formato limpo e estruturado, pronto para uso imediato em aplicações, análise de dados ou modelos de aprendizado de máquina.
Como usar o Crawly
Usar o Crawly foi projetado para ser incrivelmente simples e acessível a todos, independentemente da habilidade técnica. O processo envolve apenas alguns passos:
- Inserir URL: Navegue até o site do Crawly. No campo de entrada fornecido, insira o URL completo do site que você deseja rastrear.
- Fornecer E-mail: Insira seu endereço de e-mail. Isso é usado para notificá-lo e entregar os resultados assim que o rastreamento for concluído.
- Iniciar Rastreamento: Clique no botão 'Crawl My Website'. O motor de IA do Crawly começará a rastrear todo o site, analisando páginas и extraindo informações.
- Baixar Dados: Assim que o processo for finalizado, você receberá os dados extraídos. Você pode baixá-los em formatos convenientes e estruturados como JSON ou CSV, facilitando a importação para bancos de dados, planilhas ou outro software.
Recursos principais do Crawly
- Extração Automática com IA: Utiliza a IA avançada da Diffbot para reconhecer e extrair automaticamente dados de artigos, produtos, discussões e mais, sem qualquer configuração manual.
- Campos de Dados Abrangentes: Extrai um rico conjunto de pontos de dados, incluindo Título, Texto, HTML, Comentários, Data, Autor, URL do Autor, Imagens, Vídeos, Informações do Editor (País, Nome) e Idioma.
- Reconhecimento de Entidades: Identifica e marca automaticamente entidades dentro do texto, como pessoas, organizações e locais, adicionando outra camada de metadados valiosos.
- Rastreamento de Site Completo: Ao contrário de raspadores de página única, o Crawly navega por um site inteiro para coletar dados de forma abrangente.
- Saída de Dados Estruturados: Fornece dados limpos e bem estruturados nos formatos JSON ou CSV, eliminando a necessidade de pós-processamento e limpeza de dados.
- Solução Sem Código: Não requer habilidades de programação ou conhecimento de tecnologias de raspagem da web, tornando-o acessível a profissionais de marketing, pesquisadores e analistas de negócios.
- Robusto e Resiliente: Como entende a estrutura semântica do conteúdo, não é facilmente quebrado por mudanças no layout do site, um problema comum com raspadores tradicionais.
Casos de uso para o Crawly
O Crawly é uma ferramenta versátil adequada para uma ampla gama de aplicações:
- Pesquisa de Mercado: Colete automaticamente informações de produtos concorrentes, preços, avaliações de clientes e menções na imprensa para obter uma vantagem competitiva.
- Geração de Leads: Extraia detalhes de contato, informações da empresa e pessoal-chave de sites corporativos e diretórios online.
- Agregação de Conteúdo: Crie um feed de notícias personalizado ou plataforma de conteúdo agregando artigos, postagens de blog e vídeos de múltiplas fontes.
- Dados para Aprendizado de Máquina: Crie grandes conjuntos de dados de alta qualidade para treinar modelos de aprendizado de máquina, como análise de sentimento em avaliações de produtos ou análise de tendências de artigos de notícias.
- Monitoramento de Marca: Acompanhe como sua marca, produtos ou executivos são mencionados na web em tempo real.
Vantagens do Crawly
A principal vantagem do Crawly é sua simplicidade e poder. Ele democratiza a extração de dados da web, permitindo que não desenvolvedores realizem tarefas que normalmente exigiriam uma equipe de engenheiros. Ele economiza imensas quantidades de tempo e recursos ao automatizar todo o processo de raspagem. Além disso, sua abordagem orientada por IA garante maior precisão e maior resiliência do que os métodos tradicionais, fornecendo um fluxo confiável de dados de alta qualidade. Por ser um produto da Diffbot, é apoiado por tecnologia de nível empresarial confiada por grandes corporações em todo o mundo.
Preços e planos
O Crawly oferece um rastreamento de teste gratuito diretamente de sua página inicial, permitindo que os usuários testem suas capacidades inserindo um URL e um endereço de e-mail. Isso foi projetado para fornecer uma amostra dos dados estruturados que a ferramenta pode produzir. Para necessidades mais extensas, como rastreamento em larga escala, extração frequente de dados ou acesso à API para uso programático, os usuários normalmente assinariam o conjunto completo de ferramentas oferecido por sua empresa-mãe, a Diffbot. O preço da Diffbot é escalonado, com planos disponíveis para startups, empresas e grandes corporações, oferecendo diferentes níveis de chamadas de API e recursos.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 2.6K
- 2026-1: 784
- 2026-2: 640
- 2026-3: 1.0K
- 2026-4: 475
- 2026-5: 1.8K
Geography
Top 5 countries / regions
- 🇳🇬Nigéria82.4%
- 🇩🇪Alemanha9.9%
- 🇨🇦Canadá7.7%
Top keywords
| Keyword | Cost per click |
|---|---|
| crawl url | $0.00 |
| crawly | $0.00 |
| online web crawler | $0.00 |
| website crawler | $2.37 |
| website crawler online | $0.00 |
Crawly Alternatives
webscrapeai
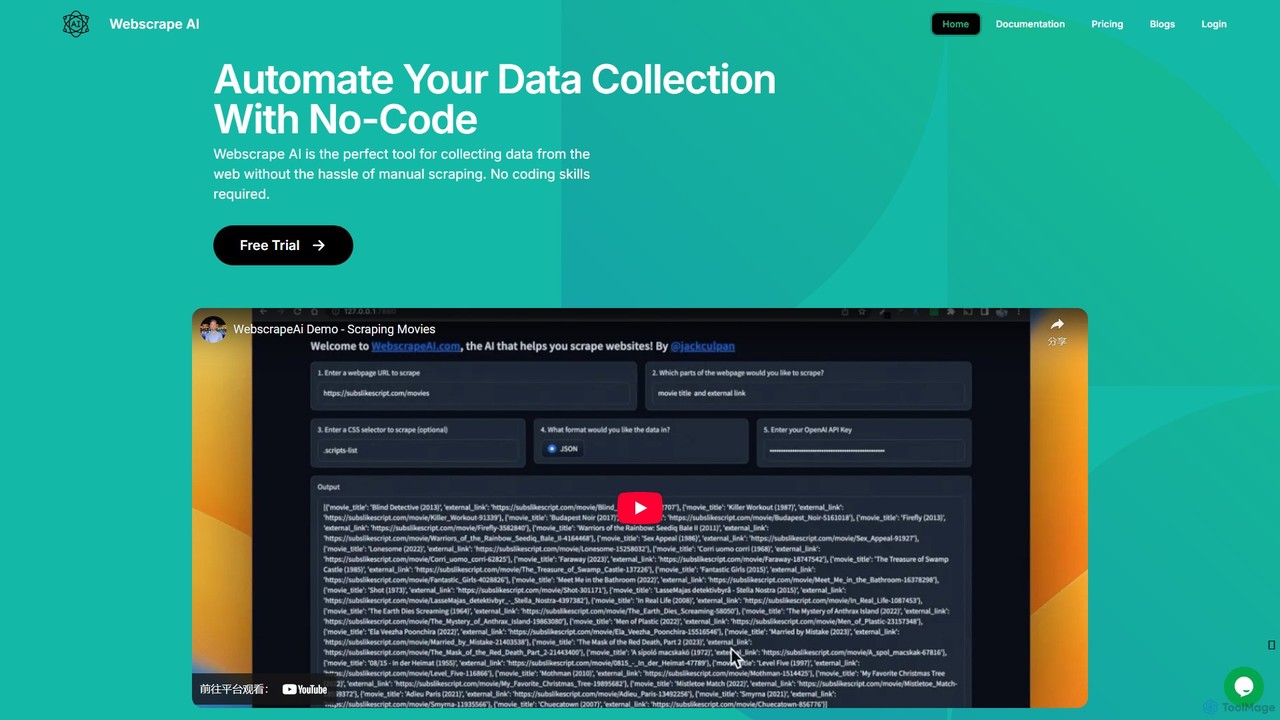
O WebscrapeAI é uma plataforma sem código, alimentada por IA, projetada para automatizar a coleta de dados da web. Basta fornecer um URL e especificar os dados de que precisa, e a IA lida com todo o processo de scraping. Ele suporta sites dinâmicos, scraping em massa, integração de proxy e oferece uma API para desenvolvedores, tornando a extração de dados rápida, precisa e acessível a todos.
Raspagem de Dados da Web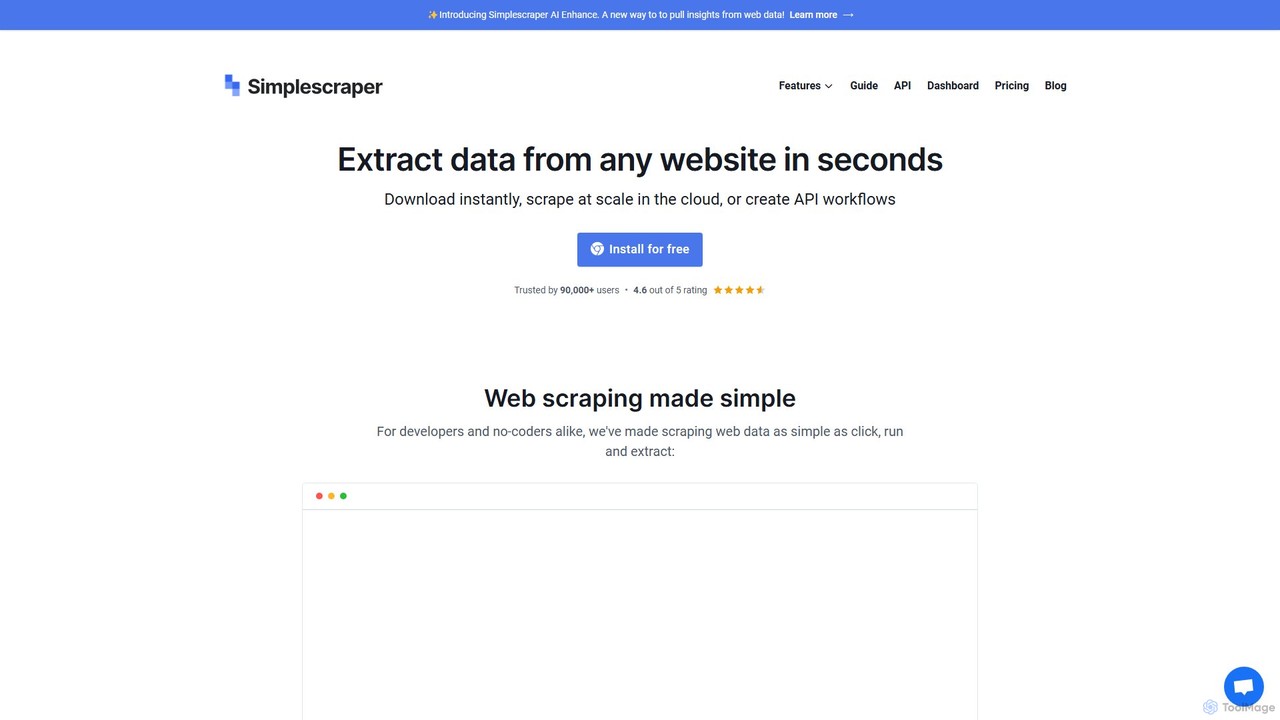
Simplescraper
O Simplescraper é uma poderosa ferramenta de web scraping que extrai dados de qualquer site em segundos. Oferece uma extensão do Chrome fácil de usar para seleção de dados sem código, automação baseada na nuvem para scraping em grande escala e um recurso inovador de IA (AI Enhance) para extrair insights usando prompts simples. Transforme sites em dados estruturados (CSV, JSON) ou APIs instantâneas e integre com ferramentas como Google Sheets e Airtable.
Raspagem de Dados da Web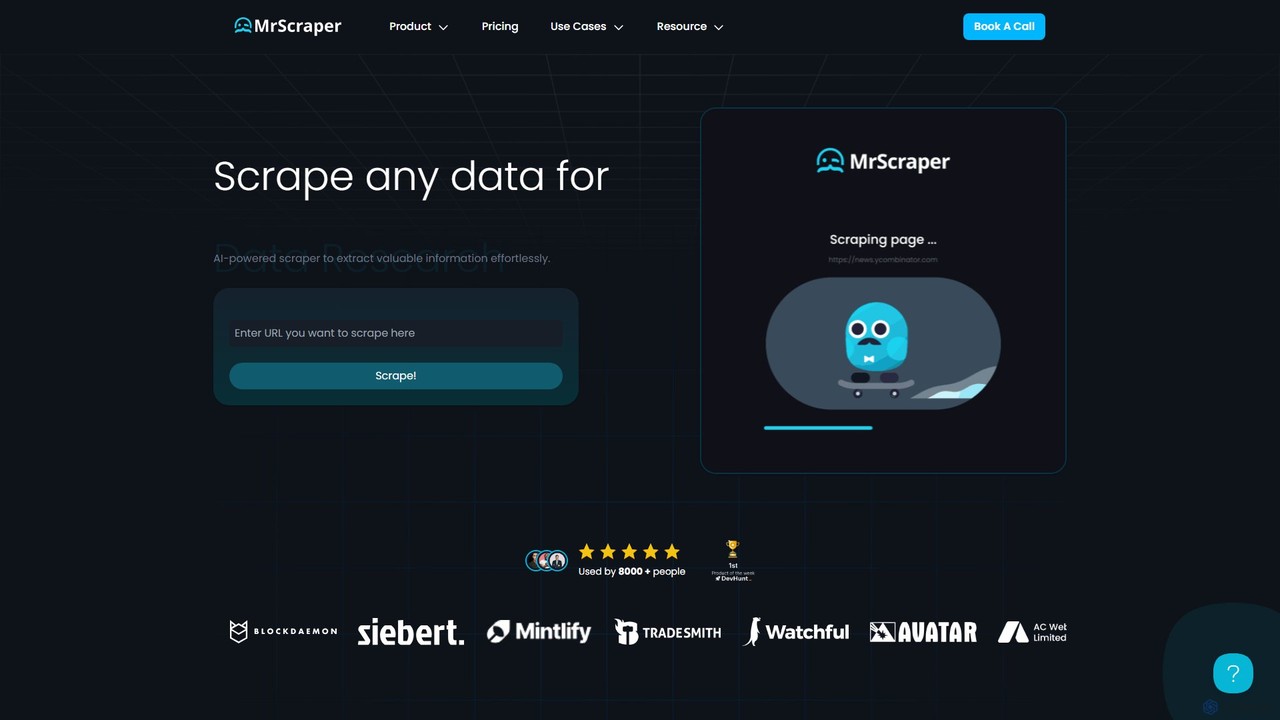
MrScraper
O MrScraper é uma ferramenta de web scraping sem código, alimentada por IA, que permite aos usuários extrair dados estruturados de qualquer site sem esforço. Ele automatiza o processo de coleta de dados, contornando medidas anti-bot como CAPTCHAs e bloqueios de IP, tornando-o ideal para inteligência de preços, pesquisa de mercado e geração de leads.
Raspagem de Dados da Web
SingleAPI
SingleAPI é uma ferramenta alimentada por GPT-4 que converte instantaneamente qualquer site em uma API JSON estruturada. Simplifica a raspagem de dados da web, extração de dados e enriquecimento de dados sem escrever nenhum código ou seletores, permitindo que os usuários acessem dados da web sem esforço para várias aplicações.
Raspagem de Dados da Web
Bright Data
A Bright Data é a plataforma de dados da web líder mundial, oferecendo um conjunto abrangente de ferramentas, incluindo redes de proxy, raspadores da web com IA e conjuntos de dados prontos para uso. Permite que as empresas coletem grandes volumes de dados públicos da web para treinamento de IA, pesquisa de mercado e inteligência competitiva.
Inteligência de NegóciosCrawly Categories
Crawly Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
webscrapeai
O WebscrapeAI é uma plataforma sem código, alimentada por IA, projetada para automatizar a coleta de dados da web. Basta fornecer um URL e especificar os dados de que precisa, e a IA lida com todo o processo de scraping. Ele suporta sites dinâmicos, scraping em massa, integração de proxy e oferece uma API para desenvolvedores, tornando a extração de dados rápida, precisa e acessível a todos.
Raspagem de Dados da WebSimplescraper
O Simplescraper é uma poderosa ferramenta de web scraping que extrai dados de qualquer site em segundos. Oferece uma extensão do Chrome fácil de usar para seleção de dados sem código, automação baseada na nuvem para scraping em grande escala e um recurso inovador de IA (AI Enhance) para extrair insights usando prompts simples. Transforme sites em dados estruturados (CSV, JSON) ou APIs instantâneas e integre com ferramentas como Google Sheets e Airtable.
Raspagem de Dados da Web
Lection
Lection é um agente de web scraping alimentado por IA que permite aos usuários extrair dados estruturados de qualquer site usando linguagem natural. Ele automatiza a coleta de dados, integra-se a fluxos de trabalho populares e fornece dados limpos e validados sem exigir conhecimento de codificação.
3D
Browse AI
O Browse AI é uma plataforma sem código que permite aos usuários extrair e monitorar dados de qualquer site. Treine facilmente um robô para extrair informações, transformar sites em planilhas ou APIs e rastrear alterações automaticamente. É projetado para profissionais de marketing, pesquisadores e desenvolvedores para automatizar a coleta de dados sem escrever nenhum código, oferecendo robôs pré-construídos e integrações perfeitas com ferramentas como Google Sheets e Zapier.
Raspagem de Dados da Web
Octoparse
Octoparse é uma poderosa ferramenta de web scraping sem código que permite a qualquer pessoa extrair dados de sites sem programação. Possui um designer de fluxo de trabalho visual, um assistente com IA para configuração fácil e centenas de modelos pré-construídos para sites populares. Com automação baseada em nuvem, rotação de IP e resolução de CAPTCHA, o Octoparse lida com tarefas complexas de scraping de forma eficiente, transformando páginas da web em dados estruturados para geração de leads, pesquisa de mercado e muito mais.
Raspagem de Dados da Web
hystruct
O hystruct é uma ferramenta de web scraping alimentada por IA que simplifica a extração de dados. Permite que os usuários transformem facilmente conteúdo da web não estruturado em dados estruturados usando esquemas pré-construídos ou personalizados, sem a necessidade de codificação. Com integrações como o Zapier, automatiza fluxos de trabalho para pesquisa de mercado, geração de leads e muito mais. Foi projetado para todos, desde iniciantes até equipes empresariais.
Raspagem
instantapi
O instantapi é uma API de web scraping alimentada por IA, projetada para simplicidade e velocidade. Permite que os usuários extraiam dados estruturados de qualquer site com uma única chamada de API, eliminando a necessidade de codificação complexa ou configuração manual. Ideal para desenvolvedores, analistas de dados e empresas que precisam de extração de dados rápida, acessível e confiável sem o incômodo dos raspadores da web tradicionais.
Extração de Dados
Curlent
Curlent é uma plataforma de web scraping e extração de dados alimentada por IA que automatiza a coleta de dados estruturados de qualquer site. Lida de forma inteligente com conteúdo dinâmico, medidas anti-bot e layouts complexos, fornecendo dados limpos e prontos para uso através de uma API poderosa.
Raspagem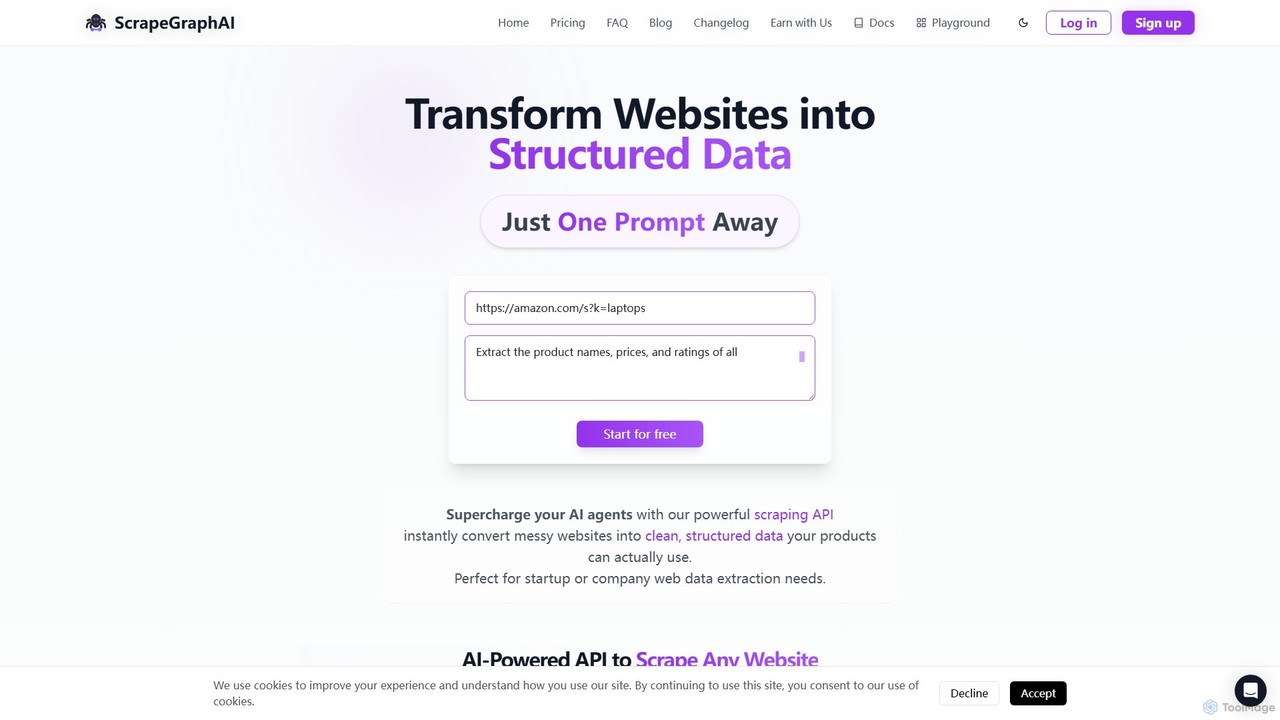
ScrapeGraphAI
ScrapeGraphAI é uma API de web scraping alimentada por IA que transforma sites não estruturados em dados JSON limpos e estruturados usando simples prompts de linguagem natural. Projetado para desenvolvedores, agentes de IA e fluxos de trabalho automatizados, simplifica a extração de dados sem código complexo.
Análise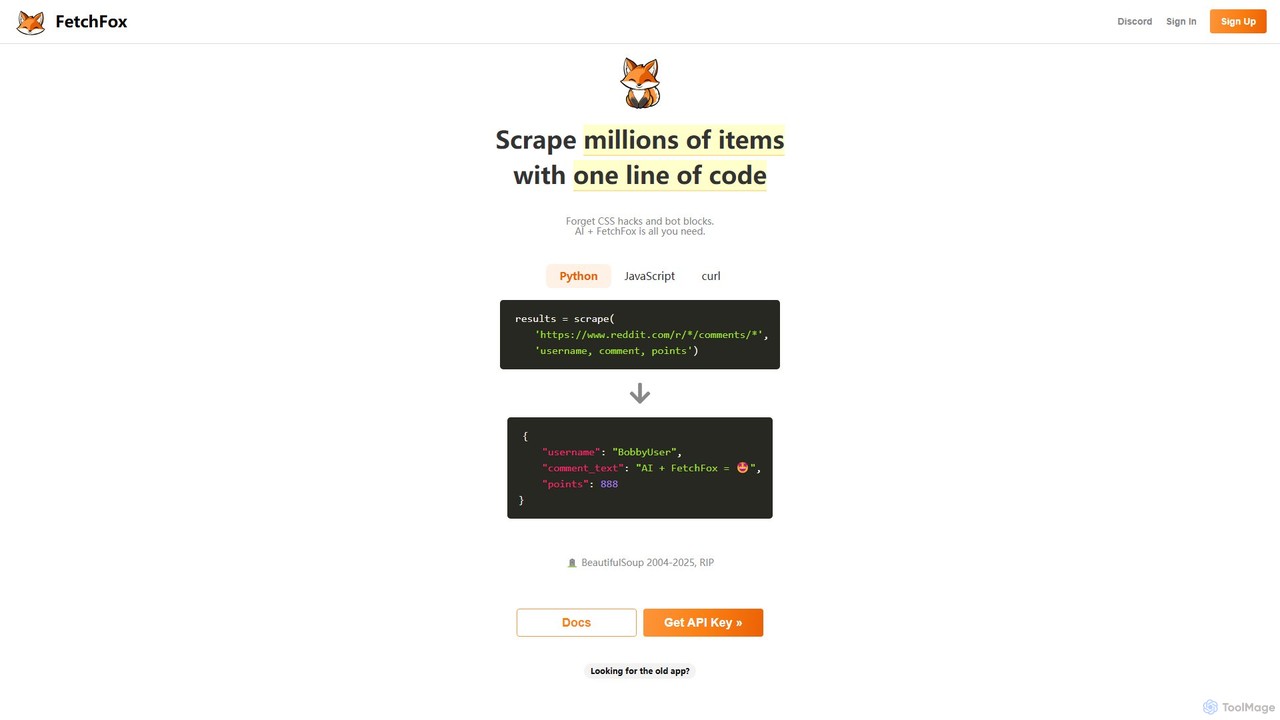
FetchFox
FetchFox é uma ferramenta de web scraping alimentada por IA que permite aos usuários extrair dados de qualquer site usando simples prompts de texto. Elimina a necessidade de codificação complexa ou seletores CSS, lidando automaticamente com medidas anti-bot. Disponível como API, biblioteca JavaScript e extensão para Chrome, foi projetado para desenvolvedores e usuários não técnicos automatizarem a coleta de dados sem esforço.
Extração de Dados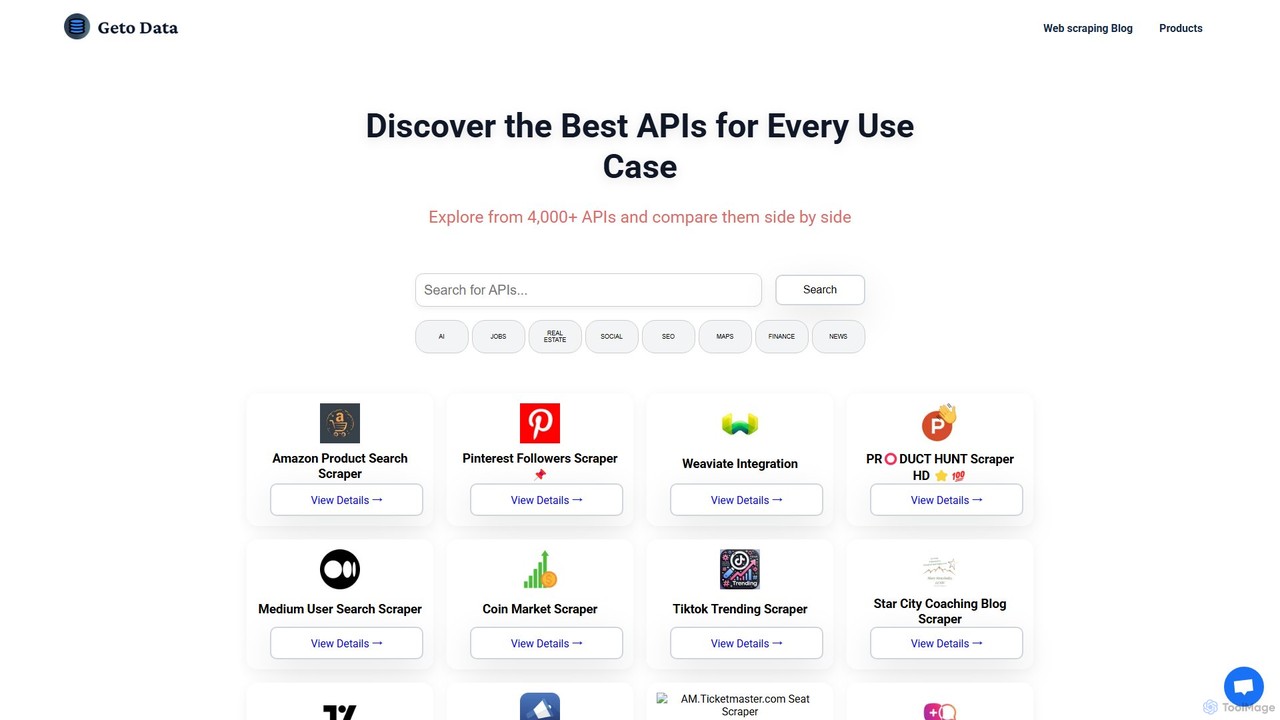
GetOData
Um diretório abrangente para descobrir, comparar e utilizar mais de 4.000 APIs pré-construídas e raspadores da web sem código. Extraia dados estruturados de sites para pesquisa de mercado, geração de leads e automação de processos sem escrever nenhum código.
AnáliseMrScraper
O MrScraper é uma ferramenta de web scraping sem código, alimentada por IA, que permite aos usuários extrair dados estruturados de qualquer site sem esforço. Ele automatiza o processo de coleta de dados, contornando medidas anti-bot como CAPTCHAs e bloqueios de IP, tornando-o ideal para inteligência de preços, pesquisa de mercado e geração de leads.
Raspagem de Dados da WebSingleAPI
SingleAPI é uma ferramenta alimentada por GPT-4 que converte instantaneamente qualquer site em uma API JSON estruturada. Simplifica a raspagem de dados da web, extração de dados e enriquecimento de dados sem escrever nenhum código ou seletores, permitindo que os usuários acessem dados da web sem esforço para várias aplicações.
Raspagem de Dados da Web
Crawlora
Crawlora é uma plataforma de web scraping sem código, alimentada por IA, que permite aos usuários extrair dados de qualquer site sem esforço. Sua interface inteligente de apontar e clicar simplifica a extração de dados, permitindo que você transforme páginas da web em dados estruturados (CSV, JSON) sem escrever uma única linha de código. Ideal para pesquisa de mercado, geração de leads e monitoramento de preços.
Extração de Dados
Crawly Comments (0)
Sign in to comment.
EntrarNo comments yet.