
Fuzzy Match Overview
O Fuzzy Match, desenvolvido pelos especialistas em análise de dados da Radix Analytics, é uma poderosa ferramenta online projetada para revolucionar a forma como as organizações lidam com a correspondência e limpeza de dados. Ele aborda o problema comum e frustrante de dados inconsistentes, como erros de digitação, grafias incorretas e variações de formatação, que podem corromper conjuntos de dados e levar a análises falhas. Ao alavancar modelos sofisticados de aprendizado de máquina e algoritmos avançados, o Fuzzy Match automatiza o processo de encontrar e resolver essas discrepâncias com notável precisão e velocidade.
A plataforma foi construída para uma ampla gama de usuários, desde pesquisadores individuais e analistas de dados até grandes empresas que gerenciam extensos bancos de dados de clientes. Sua missão principal é transformar dados desorganizados e não confiáveis em um ativo limpo, padronizado e acionável. Esteja você tentando remover duplicatas de uma lista de clientes, consolidar registros de diferentes fontes ou preparar um conjunto de dados para inteligência de negócios, o Fuzzy Match oferece uma solução intuitiva e eficaz.
Como usar o Fuzzy Match
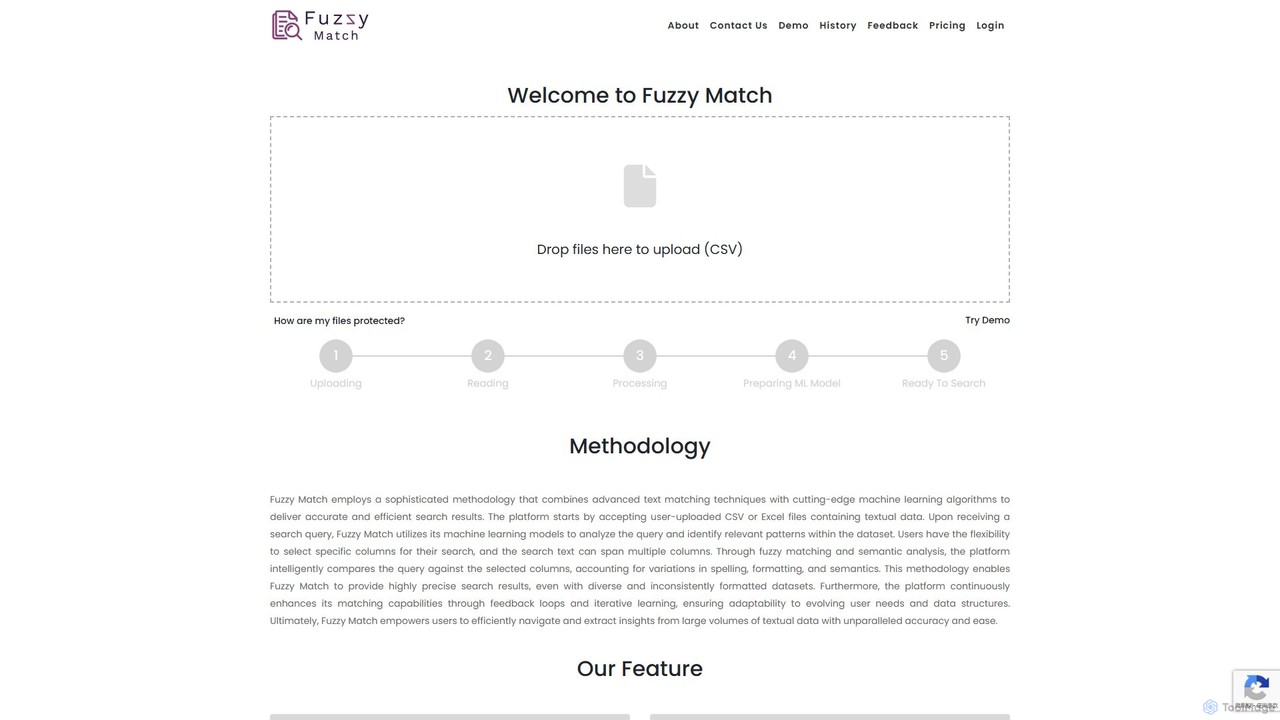
Usar o Fuzzy Match é um processo direto, projetado para eficiência e facilidade de uso, não exigindo instalação de software complexo:
- Faça o upload dos seus dados: Comece fazendo o upload do seu arquivo de dados (por exemplo, CSV, Excel) para a plataforma segura. Os planos gratuitos e pagos acomodam vários tamanhos de arquivo.
- Configure os parâmetros de correspondência: Selecione as colunas que deseja comparar. Você pode personalizar a sensibilidade ou o limiar de correspondência para controlar o quão estritamente o algoritmo identifica possíveis correspondências.
- Inicie a pesquisa: Insira uma string de texto específica para procurar registros semelhantes em seu conjunto de dados ou execute uma comparação em todo o arquivo para encontrar todas as duplicatas.
- Revise os resultados: A ferramenta processa seus dados e apresenta uma lista de possíveis correspondências, muitas vezes com uma pontuação de similaridade indicando a confiança da correspondência. Os resultados são exibidos em um formato claro e de fácil leitura.
- Limpe e exporte: Revise as correspondências sugeridas, mescle duplicatas e corrija inconsistências. Assim que seus dados estiverem limpos, você pode exportar o conjunto de dados padronizado para uso em seus projetos, análises ou sistemas de CRM.
Recursos principais do Fuzzy Match
- Algoritmos avançados de correspondência difusa (Fuzzy Matching): Utiliza algoritmos de ponta para identificar com precisão strings de texto semelhantes, mas não idênticas, levando em conta erros de digitação, semelhanças fonéticas e abreviações.
- Resolução de discrepâncias com IA/ML: Alimentado por um modelo sofisticado de aprendizado de máquina que aprende com padrões de dados para melhorar a precisão da correspondência ao longo do tempo.
- Pesquisa e correspondência em várias colunas: Capaz de pesquisar e corresponder registros com base em informações espalhadas por várias colunas, fornecendo uma visão holística dos dados.
- Limiares de correspondência personalizáveis: Permite que os usuários ajustem a sensibilidade do algoritmo de correspondência para ampliar ou restringir a busca por duplicatas, adaptando o processo às suas necessidades específicas.
- Interface web amigável: Uma plataforma intuitiva baseada na web que simplifica todo o processo de correspondência de dados, tornando-o acessível a usuários sem um profundo conhecimento técnico.
- Manuseio seguro de dados: Implementa políticas claras de retenção de dados e processamento seguro para garantir a privacidade e a integridade de suas informações.
- Planos escaláveis: Oferece uma variedade de planos, desde um nível gratuito robusto para pequenas tarefas até soluções de nível empresarial com modelos personalizados e processamento ilimitado.
Casos de uso para o Fuzzy Match
O Fuzzy Match é uma ferramenta versátil aplicável em vários setores:
- Gerenciamento de dados de clientes: Limpe listas de CRM, remova duplicatas de contatos de clientes e consolide perfis de usuários para criar uma única fonte de verdade precisa.
- Análise de dados e Business Intelligence: Prepare e padronize conjuntos de dados antes de carregá-los em ferramentas de BI, garantindo que as análises e os relatórios sejam baseados em dados confiáveis.
- Pesquisa acadêmica e científica: Consolide dados de pesquisa de várias fontes, corresponda nomes de autores ou vincule registros entre diferentes estudos com terminologias variadas.
- E-commerce e varejo: Padronize nomes de produtos, informações de fornecedores e endereços de clientes para melhorar a gestão de estoque e a eficácia do marketing.
- Finanças e conformidade: Identifique transações duplicadas, verifique nomes de entidades semelhantes em verificações de conformidade e limpe registros financeiros para auditorias precisas.
Vantagens do Fuzzy Match
Usar o Fuzzy Match oferece benefícios significativos:
- Maior precisão: Reduz drasticamente o erro humano e melhora a qualidade e a confiabilidade geral de seus dados.
- Economia de tempo e custo: Automatiza a tarefa tediosa e demorada de limpeza manual de dados, liberando recursos valiosos para atividades mais estratégicas.
- Tomada de decisão aprimorada: Dados limpos e consistentes levam a análises mais precisas, melhores insights e decisões de negócios mais inteligentes e baseadas em dados.
- Acessibilidade e facilidade de uso: Não é necessário conhecimento de codificação ou banco de dados. A ferramenta baseada na web é acessível de qualquer lugar.
- Escalabilidade: O modelo de preços em camadas garante que a ferramenta possa crescer com suas necessidades, desde limpezas em pequena escala até o gerenciamento de dados empresariais contínuo e em grande escala.
Preços e planos
O Fuzzy Match opera em um modelo freemium com vários níveis para atender a diferentes requisitos de usuário:
- Gratuito (sem login): Tamanho máximo de arquivo de 2 MB, 50 resultados de pesquisa, 2 arquivos por dia, retenção de dados por 24 horas.
- Básico (Gratuito com login): Tamanho máximo de arquivo de 10 MB, 100 resultados de pesquisa, 5 arquivos por dia, retenção de dados por 7 dias.
- Plano Padrão: $5/mês. Inclui tamanho máximo de arquivo de 20 MB, 200 resultados de pesquisa, 100 MB de armazenamento, 100 arquivos por mês, retenção de 15 dias e suporte de alta prioridade.
- Plano Premium: $15/mês. Inclui tamanho máximo de arquivo de 50 MB, 500 resultados de pesquisa, 500 MB de armazenamento, arquivos ilimitados, retenção de 30 dias e suporte de prioridade mais alta.
- Plano Empresarial (Entre em contato): Para necessidades de grande escala, oferecendo tamanho de arquivo de até 100 MB, 1000 resultados de pesquisa, 1 GB de armazenamento, retenção personalizada, um modelo de ML personalizado e o mais alto nível de suporte.
Fuzzy Match Alternatives
innicdata
innicdata é uma ferramenta de gerenciamento de banco de dados multiplataforma e gratuita, projetada para desenvolvedores e analistas de dados. Suporta vários bancos de dados SQL como MySQL, PostgreSQL e DuckDB. Seu recurso de destaque é um assistente de IA, alimentado por GPT, que ajuda os usuários a escrever e otimizar consultas SQL sem esforço. Com recursos como edição direta de tabelas, exportação de dados e uma interface amigável, o innicdata simplifica as operações de banco de dados e aumenta a produtividade.
Banco de Dados
Navicat
O Navicat é uma ferramenta abrangente de gerenciamento e desenvolvimento de banco de dados com recursos de IA integrados. Ele fornece uma GUI amigável para gerenciar uma ampla gama de bancos de dados como MySQL, PostgreSQL, MongoDB e Snowflake. Aumenta a produtividade com um Assistente de IA para geração de consultas, modelagem de dados avançada, visualização de BI e colaboração em nuvem contínua, tornando-o a principal escolha para desenvolvedores, DBAs e analistas de dados.
Inteligência de Negócios
iomete
iomete é uma plataforma de data lakehouse auto-hospedada projetada para empresas. Combina a flexibilidade dos data lakes com o desempenho dos data warehouses, dando às organizações controle total sobre seus dados, segurança e custos. Ao implantar on-premises ou em sua própria nuvem, o iomete elimina a dependência de fornecedores e fornece uma solução escalável e econômica para gerenciar conjuntos de dados em escala de petabytes, engenharia de dados e fluxos de trabalho de aprendizado de máquina.
Análise
ERBuilder Data Modeler
O ERBuilder Data Modeler é uma ferramenta de design de banco de dados e modelagem de dados alimentada por IA para arquitetos de dados e desenvolvedores. Facilita a criação visual de Diagramas de Entidade-Relacionamento (DER), suporta engenharia reversa e direta para vários bancos de dados e utiliza IA generativa para criar e atualizar modelos a partir de linguagem natural. Também oferece recursos avançados de documentação, controle de versão e geração de dados de teste.
Geração de Código
Lection
Lection é um agente de web scraping alimentado por IA que permite aos usuários extrair dados estruturados de qualquer site usando linguagem natural. Ele automatiza a coleta de dados, integra-se a fluxos de trabalho populares e fornece dados limpos e validados sem exigir conhecimento de codificação.
3DFuzzy Match Categories
Fuzzy Match Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
connect
O connect da Interzoid é uma plataforma alimentada por IA para qualidade, correspondência e enriquecimento de dados. Ajuda as empresas a limpar, padronizar e aprimorar seus conjuntos de dados, bancos de dados e arquivos. Usando algoritmos avançados e IA generativa, identifica duplicatas, corrige inconsistências e anexa dados personalizados do mundo real sob demanda. Disponível através de um aplicativo web sem código ou de uma poderosa API REST, o connect otimiza pipelines de dados e melhora o ROI dos dados para marketing, CRM e análises.
Limpeza de Dados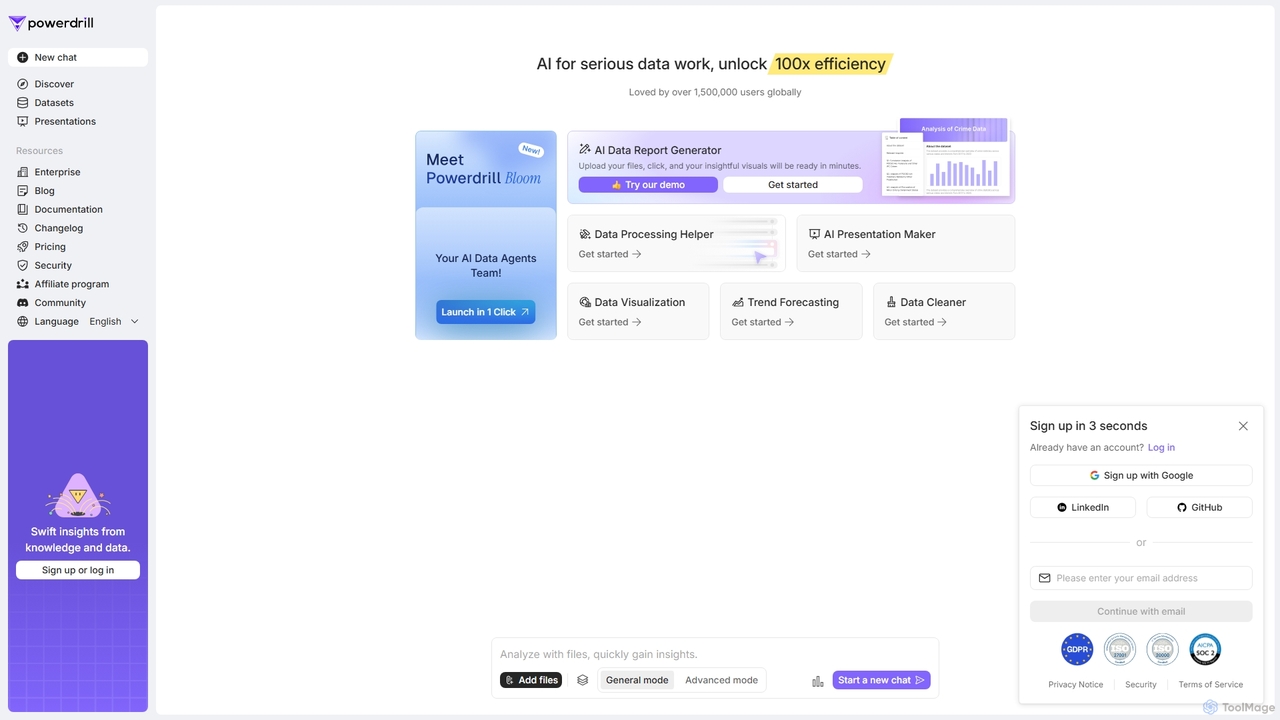
Powerdrill
O Powerdrill é uma plataforma de análise de dados alimentada por IA, projetada para trabalho sério com dados, permitindo que os usuários desbloqueiem uma eficiência 100x maior. Ele automatiza todo o processo, desde o processamento e limpeza de dados até a visualização, geração de relatórios e previsão de tendências. Basta carregar seus arquivos (Excel, CSV, PDF) ou conectar-se a um banco de dados e deixar a IA gerar insights acionáveis, gráficos interativos e apresentações abrangentes em minutos.
Inteligência de Negócios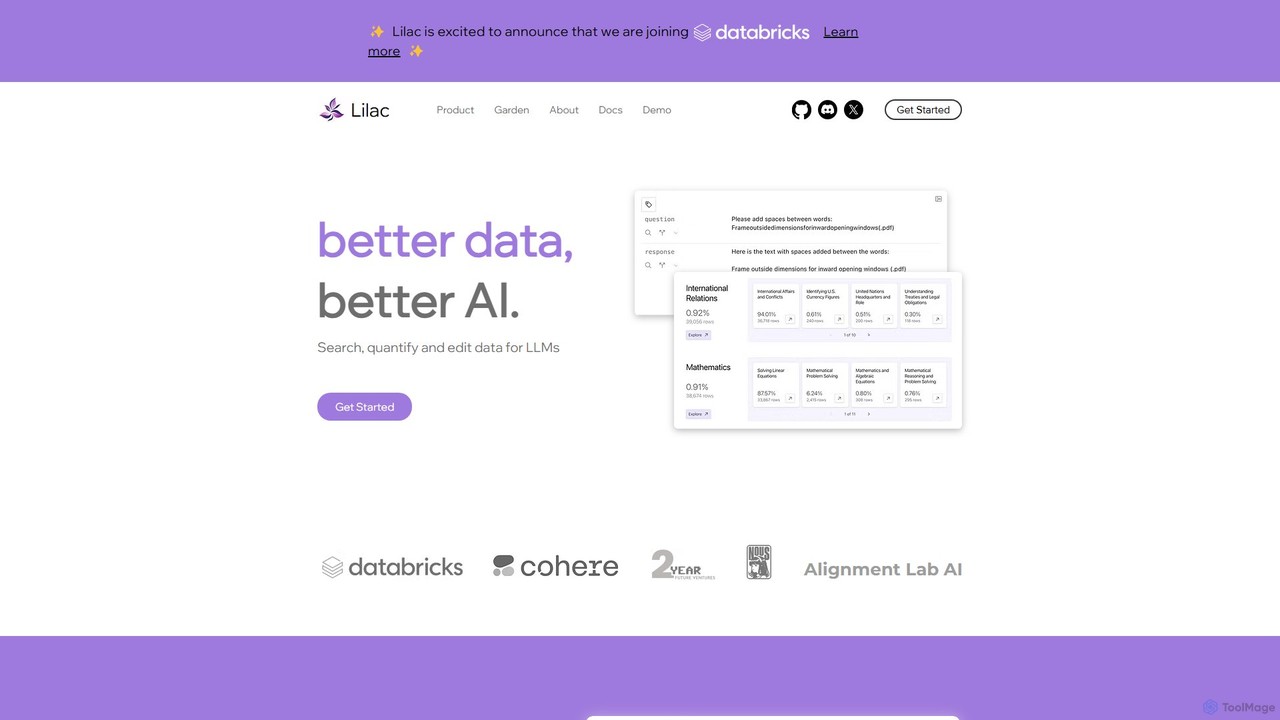
Lilac
Lilac é uma ferramenta de código aberto para cientistas de dados e engenheiros de ML explorarem, limparem e melhorarem conjuntos de dados para modelos de linguagem grandes (LLMs). Oferece busca semântica poderosa, clusterização de dados e análise de qualidade para construir uma IA melhor.
Treinamento de Modelo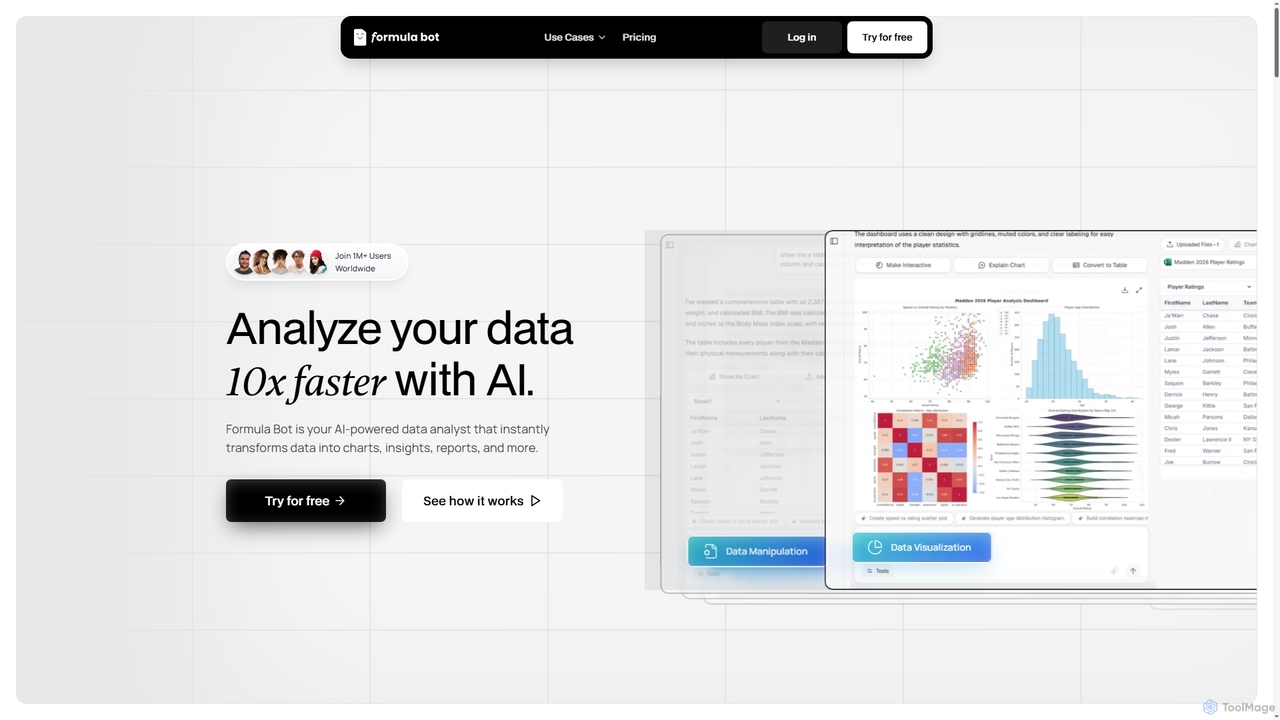
Formula Bot
Formula Bot é um analista de dados com inteligência artificial que transforma instantaneamente dados brutos em insights acionáveis, gráficos impressionantes e relatórios abrangentes. Ele também oferece ferramentas de IA especializadas para gerar fórmulas do Excel, converter PDFs para Excel e fornecer assistência passo a passo para trabalhos de casa em várias disciplinas, otimizando os processos de manuseio de dados e aprendizado para usuários em todo o mundo.
Visualização
MotionExcel
MotionExcel é um editor de planilhas com inteligência artificial que integra IA, Python e SQL para transformar a análise e automação de dados. Ajuda os usuários a analisar dados mais rapidamente, criar insights melhores e trabalhar de forma mais inteligente com agentes inteligentes e recursos avançados.
Planilha
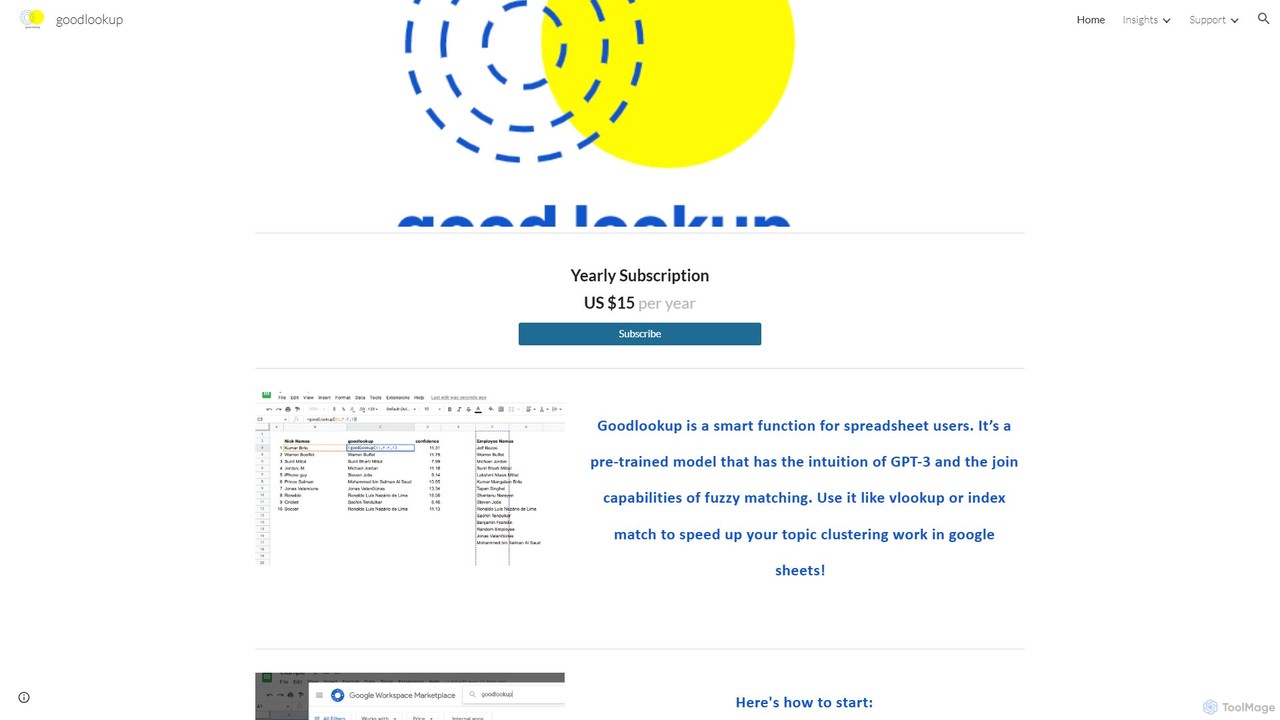
goodlookup
goodlookup é uma função inteligente para o Google Sheets que revoluciona a correspondência de dados. Com a intuição do GPT-3 e NLP avançado, vai além da correspondência difusa tradicional para entender relações semânticas, sinônimos e contexto. Use-o como um VLOOKUP superpotente para limpar dados, vincular registros com nomes inconsistentes e realizar agrupamento de tópicos sem esforço, economizando horas de trabalho manual.
Análise de Dadosinnicdata
innicdata é uma ferramenta de gerenciamento de banco de dados multiplataforma e gratuita, projetada para desenvolvedores e analistas de dados. Suporta vários bancos de dados SQL como MySQL, PostgreSQL e DuckDB. Seu recurso de destaque é um assistente de IA, alimentado por GPT, que ajuda os usuários a escrever e otimizar consultas SQL sem esforço. Com recursos como edição direta de tabelas, exportação de dados e uma interface amigável, o innicdata simplifica as operações de banco de dados e aumenta a produtividade.
Banco de Dados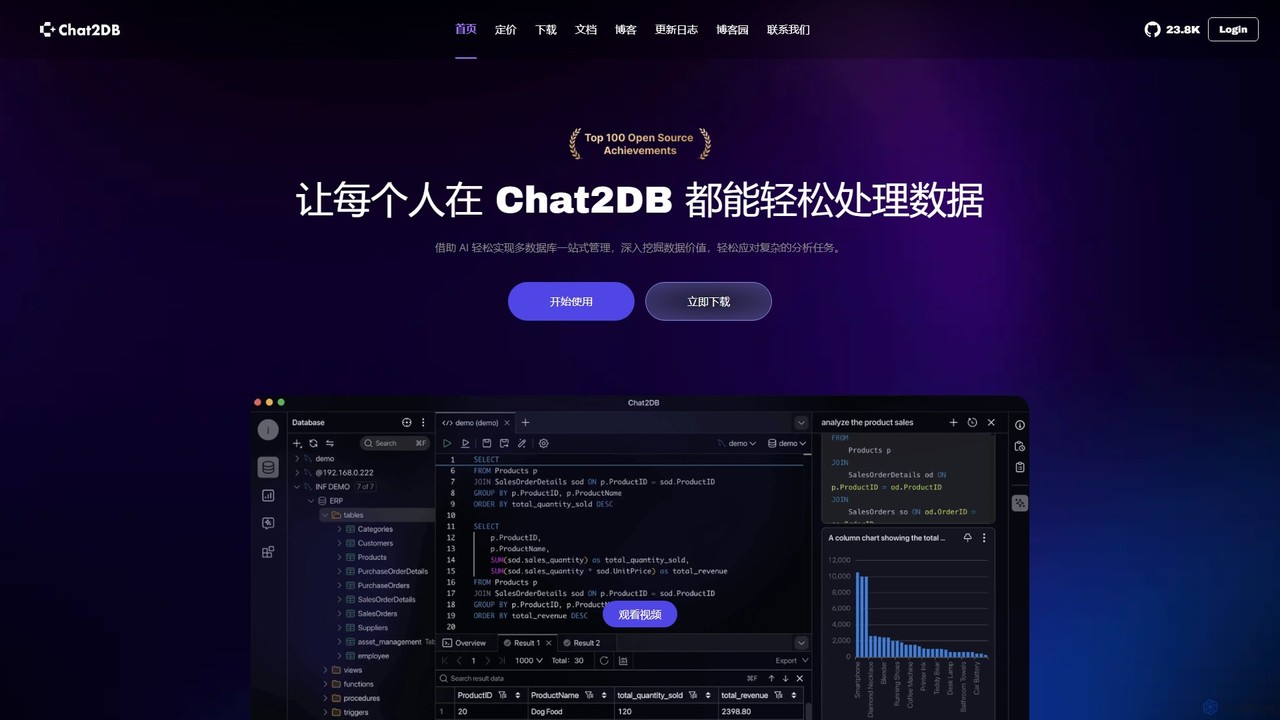
Chat2DB
O Chat2DB é uma ferramenta de gerenciamento de banco de dados inteligente e completa, alimentada por IA. Ele suporta mais de 30 bancos de dados, incluindo MySQL, PostgreSQL e MongoDB, permitindo que os usuários gerenciem, consultem e analisem dados usando linguagem natural. Os recursos incluem geração de SQL por IA, visualização de dados, criação de painéis sem código e protocolos de segurança robustos, tornando-o ideal para desenvolvedores, analistas e usuários de negócios.
Inteligência de Negócios
Coginiti
Coginiti é uma plataforma segura de operações de dados projetada para profissionais de dados. Ela otimiza a limpeza, transformação e modelagem de dados para aplicações de IA, BI e operacionais. Possui um editor SQL poderoso, ferramentas colaborativas, controle de versão e um assistente de IA para aumentar a produtividade e garantir a qualidade dos dados entre as equipes.
Inteligência de Negócios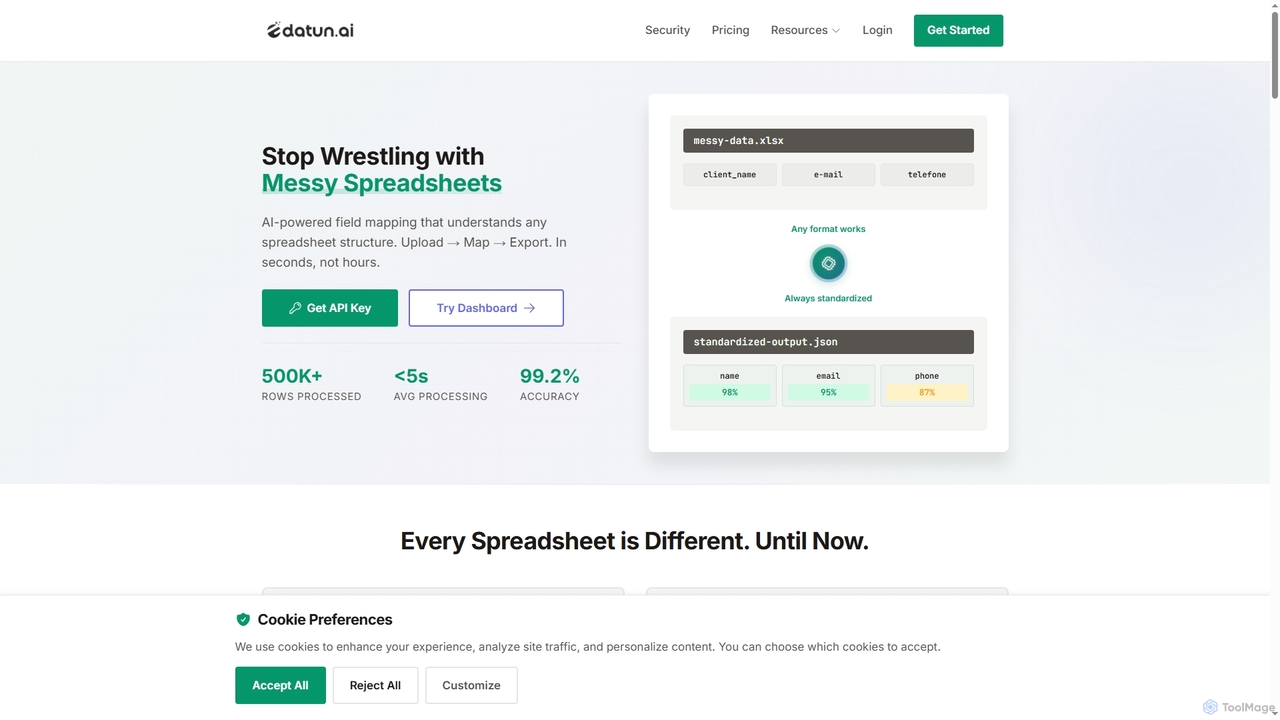
Datun
Datun é uma plataforma alimentada por IA que automatiza o processamento de planilhas desorganizadas. Mapeia inteligentemente campos de qualquer estrutura, formato ou idioma de planilha, padronizando dados em segundos para desenvolvedores e equipes de dados.
Automação
Briefer
Briefer é uma plataforma de dados colaborativa com um analista de IA integrado. Ele capacita as equipes a transformar dados em insights acionáveis usando SQL, Python e visualizações interativas em um espaço de trabalho unificado. Projetado para usuários técnicos e não técnicos, ele simplifica a análise de dados, relatórios e colaboração em tempo real, acelerando a tomada de decisões baseada em dados. É apoiado pela Y Combinator e oferece versões de código aberto auto-hospedadas e hospedadas na nuvem.
Banco de Dados
SlickAlgo
SlickAlgo é uma plataforma de análise de dados com IA que transforma perguntas em linguagem natural em insights de dados instantâneos, código Python e painéis interativos. Conecta-se a mais de 50 fontes de dados, capacitando empresas a tomar decisões baseadas em dados sem codificação.
3D
Octro
Octro é uma ferramenta alimentada por IA projetada para transformar documentos complexos, especialmente PDFs, em formatos de dados estruturados e prontos para LLM, como JSON e CSV. É especializada na extração precisa de tabelas, permitindo que empresas de vários setores otimizem o processamento de dados e aprimorem os fluxos de trabalho analíticos.
3D
astronuts
astronuts é uma plataforma de inteligência de dados alimentada por IA que transforma dados complexos em insights claros e acionáveis. Conecte suas fontes de dados, faça perguntas em linguagem natural e gere automaticamente painéis e relatórios interativos. Foi projetado para equipes explorarem dados, descobrirem padrões ocultos e tomarem decisões mais inteligentes, mais rápido.
3D
Fuzzy Match Comments (0)
Sign in to comment.
EntrarNo comments yet.