ToolMage
Đăng nhập

Best 2 Tập dữ liệu AI tools for Khoa học dữ liệu

Popular Tập dữ liệu AI tools in Khoa học dữ liệu include Allen Institute for AI (AI2) và Project Aria, helping you work more efficiently.

Project Aria

Project Aria

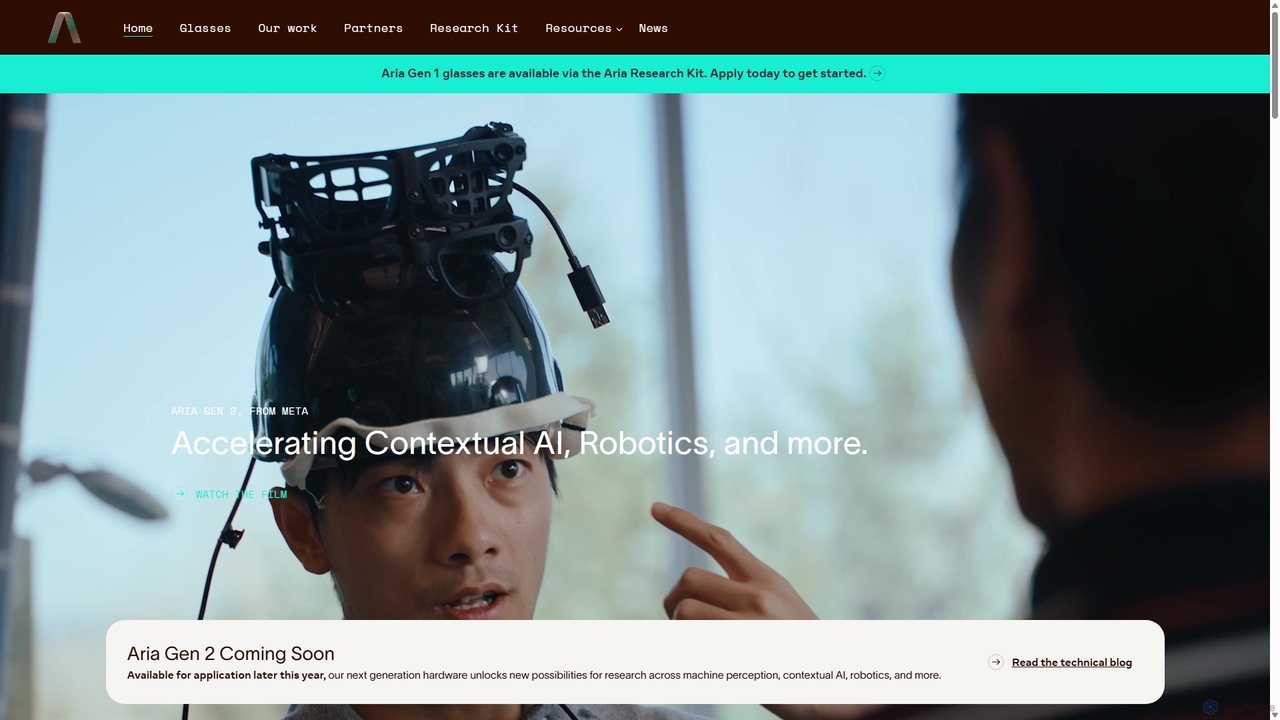
Project Aria là một sáng kiến nghiên cứu của Meta được thiết kế để đẩy nhanh sự phát triển của AI theo ngữ cảnh, thực tế tăng cường (AR) và robot. Sáng kiến này sử dụng kính nghiên cứu tiên tiến, như Aria Gen 2, để thu thập dữ liệu từ góc nhìn người thứ nhất, cung cấp cho các nhà nghiên cứu một nền tảng toàn diện bao gồm phần cứng, bộ dữ liệu mã nguồn mở và các công cụ phát triển để xây dựng tương lai của nhận thức máy.

Tập dữ liệu
Visits 42.7KFavorites 130Likes 122
Allen Institute for AI (AI2)
Free

Allen Institute for AI (AI2)

Viện Trí tuệ Nhân tạo Allen (AI2) là một viện nghiên cứu phi lợi nhuận chuyên xây dựng AI đột phá vì lợi ích chung. Viện tập trung vào việc tạo ra các mô hình ngôn ngữ lớn thực sự mã nguồn mở như OLMo, các bộ dữ liệu toàn diện và các công cụ AI chuyên dụng để thúc đẩy nghiên cứu khoa học và giải quyết các thách thức toàn cầu lớn trong các lĩnh vực như khoa học khí hậu, bảo tồn và y học.

Tập dữ liệu
Visits 375.7KFavorites 122Likes 135

About Tập dữ liệu

Tập dữ liệu là các bộ sưu tập dữ liệu được tuyển chọn dùng để huấn luyện, xác thực và kiểm thử các mô hình trí tuệ nhân tạo. Những bộ sưu tập này, có thể bao gồm hình ảnh, văn bản, âm thanh hoặc dữ liệu số, cung cấp kiến thức nền tảng để các thuật toán học máy học các mẫu và đưa ra dự đoán. Việc truy cập các tập dữ liệu chất lượng cao và phù hợp là bước đầu tiên quan trọng trong việc phát triển các ứng dụng AI hiệu quả, từ hệ thống thị giác máy tính đến bộ xử lý ngôn ngữ tự nhiên. Chúng đóng vai trò là 'sách giáo khoa' để AI học hỏi, ảnh hưởng trực tiếp đến độ chính xác và hiệu suất của mô hình cuối cùng.

Tính năng Cốt lõi

  • Dữ liệu có Cấu trúc & được Gán nhãn: Dữ liệu thường được tổ chức và chú thích bằng các nhãn (ví dụ: 'mèo' hoặc 'chó' cho hình ảnh) để tạo điều kiện cho học có giám sát.
  • Loại Dữ liệu Đa dạng: Bao gồm nhiều định dạng như hình ảnh, tài liệu văn bản, clip âm thanh và dữ liệu dạng bảng để hỗ trợ các tác vụ AI khác nhau.
  • Phân chia Dữ liệu: Thường được chia sẵn thành các tập huấn luyện, xác thực và kiểm thử để đảm bảo đánh giá mô hình đúng cách và ngăn ngừa quá khớp.
  • Siêu dữ liệu Toàn diện: Đi kèm với tài liệu chi tiết giải thích nguồn dữ liệu, phương pháp thu thập và thông tin cấp phép.

Trường hợp Sử dụng

Tập dữ liệu là nền tảng trong nghiên cứu học thuật và phát triển AI thương mại. Chúng được các nhà khoa học dữ liệu sử dụng để huấn luyện các mô hình học máy tùy chỉnh, các nhà nghiên cứu sử dụng để đánh giá hiệu suất thuật toán so với các tiêu chuẩn đã được thiết lập, và các nhà phát triển sử dụng để tinh chỉnh các mô hình đã được huấn luyện trước cho các tác vụ cụ thể như phân tích tình cảm hoặc phát hiện đối tượng.

Cách Lựa chọn

Khi chọn một tập dữ liệu, hãy xem xét sự phù hợp của nó với vấn đề cụ thể của bạn và chất lượng tổng thể, bao gồm độ chính xác của nhãn và không có sự thiên vị. Đồng thời, hãy đánh giá kích thước của tập dữ liệu — nó phải đủ lớn để mô hình của bạn học một cách hiệu quả. Cuối cùng, hãy kiểm tra các điều khoản cấp phép để đảm bảo chúng cho phép mục đích sử dụng của bạn, dù là cho mục đích thương mại hay học thuật.

Tập dữ liệu use cases

1

Huấn luyện Mô hình Nhận dạng Hình ảnh Tùy chỉnh

Một kỹ sư thị giác máy tính cần xây dựng một mô hình để xác định các lỗi sản xuất cụ thể. Họ sử dụng một tập dữ liệu hình ảnh sản phẩm chất lượng cao, đã được gán nhãn, trong đó mỗi hình ảnh được chú thích là 'đạt' hoặc 'không đạt' cùng với loại lỗi. Bằng cách huấn luyện mạng nơ-ron tích chập (CNN) của họ trên tập dữ liệu này, mô hình sẽ học cách phân biệt giữa các sản phẩm hoàn hảo và các lỗi khác nhau, tự động hóa quy trình kiểm soát chất lượng và tăng độ chính xác phát hiện.

2

Tinh chỉnh Mô hình Ngôn ngữ cho Hỗ trợ Khách hàng

Một công ty khởi nghiệp muốn tạo ra một chatbot chuyên biệt cho ngành của mình. Một chuyên gia học máy lấy một mô hình ngôn ngữ lớn đã được huấn luyện trước và tinh chỉnh nó bằng cách sử dụng một tập dữ liệu được tuyển chọn gồm các câu hỏi của khách hàng trong ngành và các câu trả lời tương ứng của chuyên gia. Quá trình này giúp mô hình chung thích ứng để hiểu thuật ngữ chuyên ngành và cung cấp các phản hồi phù hợp, chính xác, cải thiện đáng kể trải nghiệm hỗ trợ khách hàng.

3

Đánh giá một Thuật toán Gợi ý Mới

Một nhóm khoa học dữ liệu đã phát triển một thuật toán mới cho công cụ gợi ý phim. Để chứng minh hiệu quả của nó, họ kiểm thử nó trên một tập dữ liệu công khai, tiêu chuẩn ngành như MovieLens. Họ so sánh độ chính xác dự đoán của thuật toán của mình (ví dụ: khả năng dự đoán xếp hạng của người dùng tốt đến đâu) với các tiêu chuẩn đã được thiết lập. Điều này cho phép đánh giá hiệu suất và xác thực một cách khách quan trước khi triển khai hệ thống mới.

4

Phát triển Thiết bị Nhà thông minh Điều khiển bằng Giọng nói

Một nhà phát triển IoT đang tạo ra một thiết bị phản hồi lại các lệnh bằng giọng nói. Họ sử dụng một tập dữ liệu âm thanh lớn chứa hàng nghìn giờ lệnh nói từ nhiều người nói khác nhau với các giọng điệu khác nhau và trong các môi trường âm thanh đa dạng. Tập dữ liệu này được sử dụng để huấn luyện một mô hình chuyển giọng nói thành văn bản, đảm bảo thiết bị có thể hiểu một cách đáng tin cậy các lệnh của người dùng như 'bật đèn' hoặc 'đặt hẹn giờ' trong điều kiện thực tế.

5

Xây dựng Trợ lý AI Chẩn đoán Y tế

Một viện nghiên cứu y tế đặt mục tiêu tạo ra một công cụ AI để hỗ trợ các bác sĩ X-quang trong việc phát hiện khối u từ các bản quét MRI. Họ sử dụng một tập dữ liệu hình ảnh y tế chuyên biệt, đã được ẩn danh, trong đó mỗi bản quét được các bác sĩ X-quang chuyên gia gán nhãn. Việc huấn luyện một mô hình trên tập dữ liệu này giúp tạo ra một hệ thống có thể làm nổi bật các khu vực đáng lo ngại tiềm ẩn, đóng vai trò như một ý kiến thứ hai và có khả năng cải thiện tốc độ và độ chính xác của chẩn đoán.

6

Thực hiện Phân tích Tình cảm cho Nghiên cứu Thị trường

Một nhà phân tích tiếp thị muốn đánh giá ý kiến của công chúng về việc ra mắt một sản phẩm mới. Họ sử dụng một tập dữ liệu gồm các bài đăng trên mạng xã hội và đánh giá sản phẩm, mỗi bài được gán nhãn tình cảm (tích cực, tiêu cực, trung lập). Bằng cách huấn luyện một mô hình xử lý ngôn ngữ tự nhiên (NLP) trên dữ liệu này, họ có thể tự động phân tích hàng nghìn bình luận mới, cung cấp thông tin chi tiết theo thời gian thực về sự hài lòng của khách hàng và xác định các lĩnh vực cần cải thiện.

Tập dữ liệu FAQ

Tập dữ liệu AI là gì?

Tập dữ liệu AI là các bộ sưu tập thông tin có cấu trúc, chẳng hạn như hình ảnh, văn bản hoặc âm thanh, được chuẩn bị đặc biệt để huấn luyện và đánh giá các mô hình học máy. Chúng hoạt động như nguồn tài liệu mà từ đó AI học cách nhận dạng các mẫu, đưa ra quyết định và tạo ra các dự đoán. Các tập dữ liệu chất lượng cao thường được chú thích bằng các nhãn (ví dụ: xác định các đối tượng trong hình ảnh) để hướng dẫn quá trình học trong các tác vụ học máy có giám sát.

Làm cách nào để chọn tập dữ liệu phù hợp cho dự án của tôi?

Để chọn tập dữ liệu phù hợp, hãy xem xét bốn yếu tố chính. Thứ nhất, sự liên quan: đảm bảo dữ liệu liên quan trực tiếp đến vấn đề bạn muốn giải quyết. Thứ hai, chất lượng: kiểm tra các nhãn chính xác, nhiễu tối thiểu và không có sự thiên vị đáng kể. Thứ ba, kích thước: tập dữ liệu phải đủ lớn để huấn luyện một mô hình mạnh mẽ mà không gây ra quá khớp. Cuối cùng, giấy phép: xác minh rằng quyền sử dụng của tập dữ liệu phù hợp với mục tiêu của dự án của bạn, đặc biệt là đối với các ứng dụng thương mại.

Sự khác biệt giữa tập dữ liệu huấn luyện, xác thực và kiểm thử là gì?

Đây là ba tập hợp con riêng biệt của một tập dữ liệu duy nhất được sử dụng để phát triển mô hình. Tập huấn luyện (thường là phần lớn nhất) được sử dụng để dạy mô hình bằng cách cho nó học các mẫu từ dữ liệu. Tập xác thực được sử dụng trong quá trình huấn luyện để điều chỉnh các tham số của mô hình và ngăn ngừa quá khớp. Tập kiểm thử chỉ được sử dụng sau khi mô hình đã được huấn luyện đầy đủ để cung cấp một đánh giá không thiên vị về hiệu suất cuối cùng của nó trên dữ liệu chưa từng thấy.

Một số loại tập dữ liệu AI phổ biến là gì?

Tập dữ liệu AI có nhiều dạng tùy thuộc vào tác vụ. Các loại phổ biến bao gồm:

  • Tập dữ liệu hình ảnh: Bộ sưu tập hình ảnh cho các tác vụ như phát hiện đối tượng hoặc phân loại hình ảnh (ví dụ: ImageNet).
  • Tập dữ liệu văn bản: Các kho văn bản cho các tác vụ xử lý ngôn ngữ tự nhiên (NLP) như phân tích tình cảm hoặc dịch thuật.
  • Tập dữ liệu âm thanh: Các bản ghi âm giọng nói hoặc âm thanh để nhận dạng giọng nói hoặc phân loại âm thanh.
  • Tập dữ liệu dạng bảng: Dữ liệu được tổ chức theo hàng và cột, phổ biến trong tài chính và phân tích để lập mô hình dự đoán.
Tại sao chất lượng dữ liệu trong một tập dữ liệu lại quan trọng đến vậy?

Chất lượng dữ liệu rất quan trọng vì hiệu suất của một mô hình AI về cơ bản bị giới hạn bởi chất lượng của dữ liệu mà nó được huấn luyện — một khái niệm được gọi là 'rác vào, rác ra'. Dữ liệu chất lượng kém với các nhãn không chính xác, có sự thiên vị hoặc không đủ đa dạng có thể dẫn đến một mô hình đưa ra các dự đoán không chính xác, hành xử không công bằng đối với một số nhóm nhất định và hoạt động kém trong các kịch bản thực tế. Dữ liệu chất lượng cao đảm bảo mô hình học được các mẫu đúng, dẫn đến kết quả chính xác và đáng tin cậy hơn.