
ToolMage
Đăng nhập

Best 1 Cơ sở dữ liệu vector AI tools for Khoa học dữ liệu

Popular Cơ sở dữ liệu vector AI tools in Khoa học dữ liệu include PostgresML, helping you work more efficiently.

PostgresML
Freemium

PostgresML

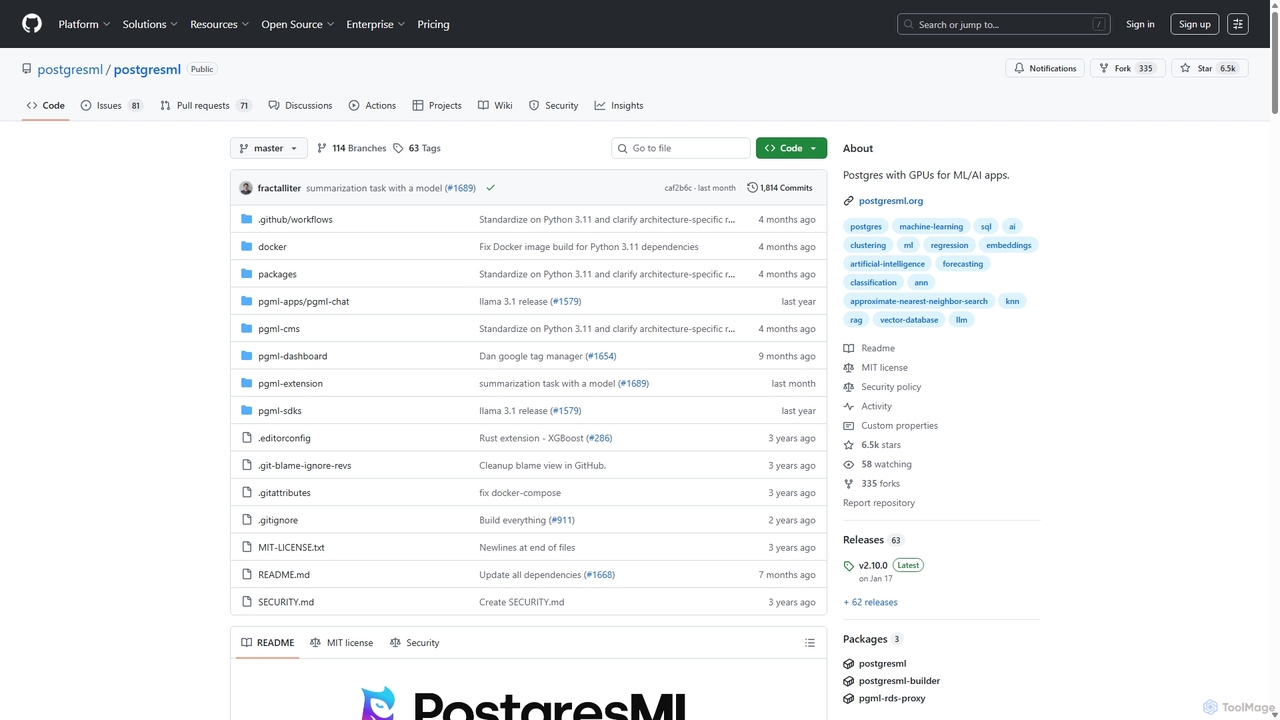
PostgresML là một tiện ích mở rộng mã nguồn mở mạnh mẽ tích hợp học máy và AI trực tiếp vào cơ sở dữ liệu PostgreSQL của bạn. Nó cho phép suy luận được tăng tốc bằng GPU, tìm kiếm vector và các quy trình RAG hoàn chỉnh bằng các lệnh SQL đơn giản, loại bỏ việc di chuyển dữ liệu và đơn giản hóa ngăn xếp MLOps cho các ứng dụng AI hiệu suất cao, có khả năng mở rộng.

MLOps
Visits 6.4KFavorites 137Likes 137

About Cơ sở dữ liệu vector

Cơ sở dữ liệu vector là một loại cơ sở dữ liệu chuyên dụng được thiết kế để lưu trữ, quản lý và tìm kiếm các nhúng vector đa chiều một cách hiệu quả. Không giống như các cơ sở dữ liệu truyền thống truy vấn dựa trên sự trùng khớp chính xác, cơ sở dữ liệu vector sử dụng thuật toán Láng giềng gần nhất xấp xỉ (ANN) để tìm các mục dựa trên sự tương đồng về ngữ nghĩa. Điều này cho phép các ứng dụng hiểu được ngữ cảnh và mối quan hệ trong dữ liệu phức tạp, phi cấu trúc như văn bản, hình ảnh và âm thanh. Là một thành phần quan trọng trong hệ sinh thái AI hiện đại, chúng cung cấp năng lượng cho các tính năng nâng cao như tìm kiếm ngữ nghĩa, hệ thống đề xuất và bộ nhớ dài hạn cho các mô hình ngôn ngữ lớn (LLM).

Tính năng Cốt lõi

  • Lưu trữ Vector Đa chiều: Xử lý và lập chỉ mục tự nhiên các vector có hàng trăm hoặc hàng nghìn chiều, là đầu ra phổ biến từ các mô hình AI.
  • Tìm kiếm Láng giềng Gần nhất Xấp xỉ (ANN): Cung cấp tìm kiếm tương đồng siêu nhanh bằng cách tìm các vector 'gần nhất' trong cơ sở dữ liệu, cho phép hiệu suất thời gian thực trên các bộ dữ liệu khổng lồ.
  • Lọc Siêu dữ liệu: Kết hợp tìm kiếm tương đồng vector với lọc dựa trên thuộc tính truyền thống, cho phép các truy vấn phức tạp như "tìm hình ảnh tương tự với hình này, nhưng chỉ những hình có gắn thẻ 'ngoài trời'".
  • Khả năng Mở rộng và Hiệu suất: Được thiết kế để mở rộng theo chiều ngang nhằm quản lý hàng tỷ vector trong khi vẫn duy trì phản hồi truy vấn có độ trễ thấp.
  • Lập chỉ mục Thời gian thực: Hỗ trợ việc bổ sung liên tục các vector dữ liệu mới mà không làm giảm hiệu suất đáng kể hoặc gây ra thời gian chết.

Trường hợp Sử dụng

Cơ sở dữ liệu vector rất quan trọng đối với các nhà phát triển và nhà khoa học dữ liệu xây dựng các ứng dụng AI gốc. Chúng được sử dụng rộng rãi trong thương mại điện tử để tạo ra các hệ thống đề xuất sản phẩm, trong phần mềm doanh nghiệp để xây dựng tìm kiếm cơ sở kiến thức thông minh, và trong các ứng dụng AI tạo sinh để cung cấp bộ nhớ dài hạn cho chatbot thông qua Retrieval-Augmented Generation (RAG).

Cách Lựa chọn

Khi chọn một cơ sở dữ liệu vector, hãy xem xét các chỉ số hiệu suất của nó, chẳng hạn như độ trễ truy vấn và tốc độ lập chỉ mục. Đánh giá mô hình triển khai—liệu bạn cần một dịch vụ đám mây được quản lý hoàn toàn, một giải pháp tự lưu trữ hay một tùy chọn không máy chủ. Ngoài ra, hãy đánh giá hệ sinh thái của nó, bao gồm việc tích hợp với các framework AI phổ biến như LangChain và LlamaIndex, và sự linh hoạt của các thuật toán ANN và khả năng lọc được hỗ trợ.

Cơ sở dữ liệu vector use cases

1

Xây dựng Tìm kiếm Ngữ nghĩa cho Cơ sở Tri thức

Một nhóm phát triển phần mềm cần xây dựng chức năng tìm kiếm thông minh cho tài liệu kỹ thuật đồ sộ của họ. Thay vì dựa vào việc khớp từ khóa, vốn thường không tìm thấy các bài viết liên quan, họ sử dụng cơ sở dữ liệu vector. Mỗi tài liệu được chuyển đổi thành một nhúng vector bởi một mô hình AI. Khi một nhà phát triển tìm kiếm một truy vấn như "làm thế nào để sửa lỗi xác thực", hệ thống sẽ chuyển đổi truy vấn thành một vector và sử dụng tìm kiếm ANN của cơ sở dữ liệu để tìm các vector tài liệu tương tự nhất về mặt ngữ nghĩa. Điều này cung cấp kết quả có độ liên quan cao, ngay cả khi không có các từ khóa chính xác, giúp giảm đáng kể thời gian khắc phục sự cố.

2

Tăng cường Đề xuất Sản phẩm trong Thương mại Điện tử

Một nhà bán lẻ thời trang trực tuyến muốn cải thiện tính năng 'Bạn cũng có thể thích'. Họ sử dụng một mô hình AI đa phương thức để tạo ra các nhúng vector cho mỗi hình ảnh sản phẩm và mô tả của nó. Các vector này được lưu trữ trong một cơ sở dữ liệu vector. Khi một khách hàng xem một sản phẩm, hệ thống sẽ truy vấn cơ sở dữ liệu để tìm các sản phẩm có vector tương tự nhất. Điều này cho phép đề xuất dựa trên phong cách hình ảnh, mẫu màu và mô tả văn bản (ví dụ: 'váy mùa hè'), tạo ra một trải nghiệm mua sắm hấp dẫn và cá nhân hóa hơn, có thể tăng tỷ lệ chuyển đổi.

3

Tạo Bộ nhớ Dài hạn cho Chatbot AI

Một công ty triển khai chatbot hỗ trợ khách hàng bằng AI. Để đảm bảo các cuộc trò chuyện nhất quán và được cá nhân hóa, họ sử dụng cơ sở dữ liệu vector làm bộ nhớ dài hạn của chatbot. Thông tin chính từ mỗi tương tác của người dùng (ví dụ: sở thích của người dùng, các vấn đề trong quá khứ) được tóm tắt, chuyển đổi thành vector và lưu trữ. Trước khi trả lời một truy vấn mới, chatbot sẽ tìm kiếm trong cơ sở dữ liệu vector các tương tác có liên quan trong quá khứ. Quá trình này, được gọi là Retrieval-Augmented Generation (RAG), cho phép chatbot ghi nhớ ngữ cảnh, tránh hỏi những câu hỏi lặp đi lặp lại và cung cấp sự hỗ trợ hữu ích hơn, nhận biết được ngữ cảnh.

4

Triển khai Tìm kiếm Trực quan cho Tài sản Đa phương tiện

Một công ty tiếp thị lớn quản lý một thư viện tài sản kỹ thuật số với hàng triệu hình ảnh và video. Việc gắn thẻ thủ công cho từng tài sản là không thực tế. Bằng cách sử dụng cơ sở dữ liệu vector, họ có thể triển khai một tính năng tìm kiếm trực quan mạnh mẽ. Một mô hình AI xử lý mỗi hình ảnh và tạo ra một vector đại diện cho nội dung hình ảnh của nó. Một nhà thiết kế sau đó có thể tải lên một hình ảnh (ví dụ: một bức ảnh hoàng hôn trên thành phố) để tìm tất cả các tài sản tương tự về mặt hình ảnh trong thư viện. Họ có thể tinh chỉnh thêm tìm kiếm bằng các bộ lọc siêu dữ liệu, chẳng hạn như 'hướng ngang' hoặc 'có chứa người', giúp hợp lý hóa quy trình làm việc sáng tạo và quá trình khám phá tài sản.

5

Phát hiện Bất thường trong Giao dịch Tài chính

Một công ty công nghệ tài chính đặt mục tiêu phát hiện các giao dịch gian lận trong thời gian thực. Họ mô hình hóa mỗi giao dịch thành một vector đa chiều chứa các đặc điểm như số tiền, thời gian, địa điểm và loại hình người bán. Các vector này được truyền trực tuyến vào một cơ sở dữ liệu vector. Hệ thống xác định các điểm bất thường bằng cách tìm kiếm các vector nằm xa bất kỳ cụm mẫu giao dịch bình thường nào đã được thiết lập. Khi một vector giao dịch mới được phát hiện là một điểm ngoại lai, nó sẽ được gắn cờ để một nhà phân tích gian lận xem xét ngay lập tức. Cách tiếp cận dựa trên sự tương đồng này có thể phát hiện ra các mẫu gian lận mới mà các hệ thống dựa trên quy tắc có thể bỏ lỡ.

6

Tăng tốc Khám phá Thuốc bằng Tìm kiếm Phân tử

Trong nghiên cứu dược phẩm, các nhà khoa học cần xác định các phân tử có đặc tính cấu trúc hoặc chức năng tương tự. Họ biểu diễn các thư viện hợp chất hóa học khổng lồ dưới dạng các nhúng vector (ví dụ: dấu vân tay phân tử). Một nhà nghiên cứu sau đó có thể lấy một phân tử mục tiêu, chuyển đổi nó thành biểu diễn vector và truy vấn một cơ sở dữ liệu vector để tìm ra k hợp chất tương tự nhất từ hàng triệu ứng cử viên. Việc tìm kiếm tương tự này giúp tăng tốc đáng kể quá trình sàng lọc ban đầu cho các ứng cử viên thuốc mới, giúp các nhà nghiên cứu tập trung nỗ lực vào các phân tử hứa hẹn nhất và giảm thời gian phát triển.

Cơ sở dữ liệu vector FAQ

Cơ sở dữ liệu vector là gì?

Cơ sở dữ liệu vector là một loại cơ sở dữ liệu được thiết kế đặc biệt để lưu trữ và truy vấn các vector đa chiều, còn được gọi là các nhúng (embeddings). Thay vì tìm kiếm sự trùng khớp chính xác như cơ sở dữ liệu truyền thống, nó vượt trội trong việc tìm kiếm các mục tương tự nhất dựa trên khoảng cách toán học giữa các vector của chúng. Khả năng này là nền tảng cho các ứng dụng AI như tìm kiếm ngữ nghĩa, hệ thống đề xuất và cho phép bộ nhớ dài hạn cho các mô hình ngôn ngữ lớn (LLM) thông qua Retrieval-Augmented Generation (RAG).

Cơ sở dữ liệu vector khác với cơ sở dữ liệu quan hệ truyền thống (ví dụ: SQL) như thế nào?

Sự khác biệt chính nằm ở loại dữ liệu và phương thức truy vấn. Một cơ sở dữ liệu quan hệ truyền thống lưu trữ dữ liệu có cấu trúc (như văn bản, số, ngày tháng) trong các bảng và sử dụng SQL để tìm các kết quả khớp chính xác dựa trên các giá trị cụ thể. Ngược lại, một cơ sở dữ liệu vector lưu trữ dữ liệu phi cấu trúc được biểu diễn dưới dạng các vector số và sử dụng các thuật toán Láng giềng gần nhất xấp xỉ (ANN) để tìm dữ liệu 'tương tự' hoặc 'gần' về mặt ngữ nghĩa với một vector truy vấn. Cơ sở dữ liệu SQL dành cho các truy vấn có cấu trúc và tính toàn vẹn của dữ liệu, trong khi cơ sở dữ liệu vector dành cho việc tìm kiếm sự tương đồng trên dữ liệu phức tạp.

Cần tìm kiếm những tính năng chính nào khi chọn cơ sở dữ liệu vector?

Khi chọn một cơ sở dữ liệu vector, hãy xem xét các yếu tố quan trọng sau:

  • Hiệu suất: Đánh giá độ trễ truy vấn (tốc độ trả về kết quả) và tốc độ lập chỉ mục (tốc độ có thể thêm dữ liệu mới).
  • Khả năng mở rộng: Đánh giá khả năng xử lý khối lượng dữ liệu dự kiến của bạn (hàng tỷ vector) và tải truy vấn mà không làm giảm hiệu suất.
  • Mô hình triển khai: Lựa chọn giữa dịch vụ đám mây được quản lý hoàn toàn để dễ sử dụng, tùy chọn tự lưu trữ để kiểm soát tối đa, hoặc mô hình không máy chủ để mở rộng linh hoạt.
  • Lọc và Tìm kiếm kết hợp: Kiểm tra các khả năng lọc siêu dữ liệu mạnh mẽ để kết hợp tìm kiếm tương đồng với các truy vấn có cấu trúc.
  • Hệ sinh thái và Tích hợp: Đảm bảo nó tích hợp tốt với hệ thống công nghệ hiện có của bạn, bao gồm các framework AI như LangChain hoặc LlamaIndex và các nền tảng đám mây.
Ai sử dụng cơ sở dữ liệu vector?

Cơ sở dữ liệu vector chủ yếu được sử dụng bởi các kỹ sư AI/ML, nhà khoa học dữ liệu và nhà phát triển phần mềm đang xây dựng các ứng dụng có các tính năng được hỗ trợ bởi AI. Ví dụ, một nhóm phát triển chatbot AI tạo sinh sẽ sử dụng cơ sở dữ liệu vector cho bộ nhớ của nó (RAG). Nhóm khoa học dữ liệu của một công ty thương mại điện tử sẽ sử dụng nó để xây dựng một công cụ đề xuất. Một công ty phần mềm sẽ sử dụng nó để cung cấp năng lượng cho tính năng tìm kiếm ngữ nghĩa trong tài liệu trợ giúp của sản phẩm. Về cơ bản, bất kỳ ai làm việc với các nhúng từ các mô hình AI để kích hoạt chức năng dựa trên sự tương đồng đều là người dùng tiềm năng.

'Nhúng' (embedding) trong bối cảnh cơ sở dữ liệu vector là gì?

Một 'nhúng' (embedding) là một biểu diễn số của dữ liệu phức tạp, chẳng hạn như một từ, một câu, một hình ảnh hoặc một đoạn âm thanh, dưới dạng một vector đa chiều (một danh sách các con số). Các nhúng này được tạo ra bởi các mô hình AI (như các mô hình ngôn ngữ lớn hoặc mô hình thị giác máy tính) và được thiết kế để nắm bắt ý nghĩa ngữ nghĩa hoặc các đặc điểm của dữ liệu gốc. Ý tưởng chính là các mục tương tự sẽ có các nhúng gần nhau trong không gian vector. Công việc chính của một cơ sở dữ liệu vector là lưu trữ các nhúng này và tìm ra những cái gần nhất một cách rất nhanh chóng.