ToolMage
Đăng nhập

Best 2 Ẩn danh hóa AI tools for Quyền riêng tư

Popular Ẩn danh hóa AI tools in Quyền riêng tư include hey_photo và PiktID, helping you work more efficiently.

hey_photo
Freemium

hey_photo

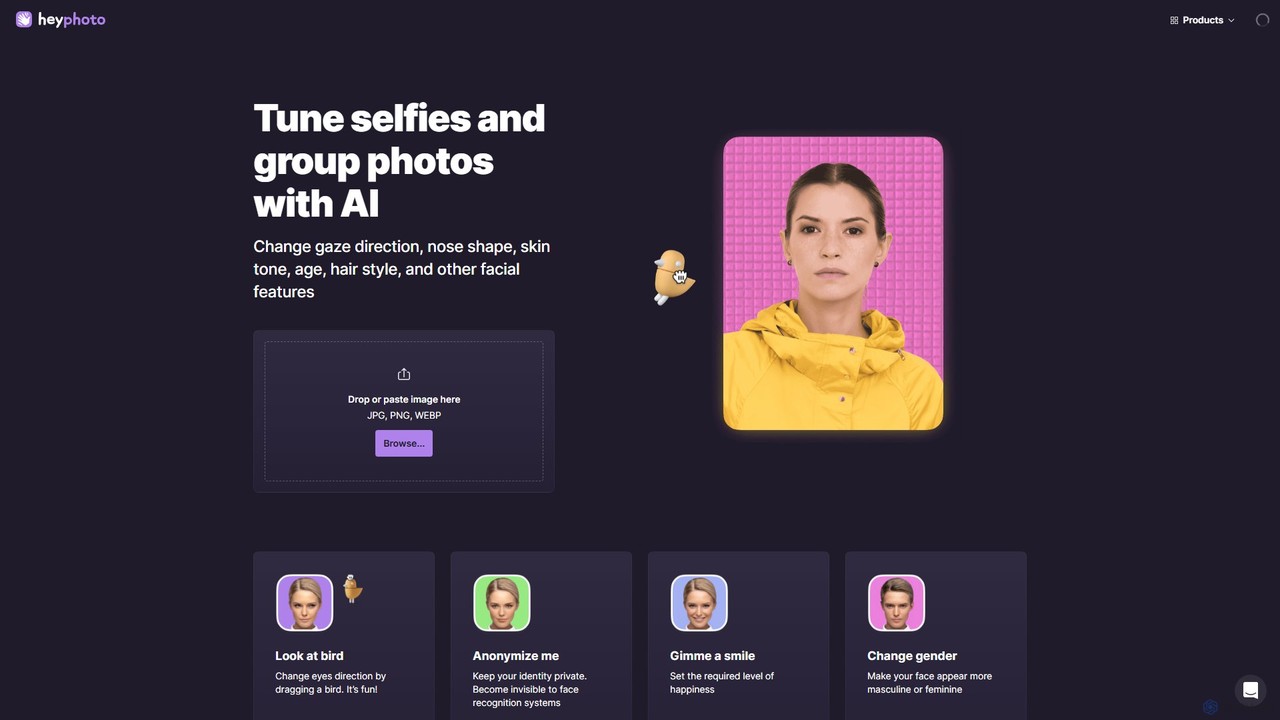
hey_photo là một trình chỉnh sửa ảnh AI trực tuyến được thiết kế để thao tác các đặc điểm trên khuôn mặt một cách dễ dàng. Nó cho phép người dùng dễ dàng thay đổi biểu cảm, tuổi tác, giới tính, ánh mắt và các thuộc tính khuôn mặt khác trong ảnh selfie và ảnh nhóm mà không cần phần mềm phức tạp. Nó trực quan, thú vị và miễn phí sử dụng.

Avatar
Visits 104.4KFavorites 148Likes 140
PiktID
Freemium

PiktID

PiktID là một bộ công cụ chỉnh sửa hình ảnh bằng AI toàn diện dành cho các chuyên gia. Nó chuyên về ẩn danh khuôn mặt tuân thủ GDPR, hoán đổi khuôn mặt độ phân giải cao, nâng cao chất lượng ảnh và chỉnh sửa hình ảnh sản phẩm. Nền tảng này cung cấp một loạt công cụ như EraseID, SuperID và SwapID để tự động hóa các tác vụ xử lý hình ảnh phức tạp, tiết kiệm thời gian và chi phí đồng thời đảm bảo quyền riêng tư và sự linh hoạt sáng tạo.

Chỉnh sửa khuôn mặt
Visits 65.2KFavorites 157Likes 151

About Ẩn danh hóa

Công cụ ẩn danh hóa là một loại phần mềm được hỗ trợ bởi AI, được thiết kế để loại bỏ hoặc che giấu thông tin nhận dạng cá nhân (PII) khỏi các bộ dữ liệu. Các công cụ này sử dụng các kỹ thuật tiên tiến như che dữ liệu, tổng quát hóa và bút danh hóa để biến đổi dữ liệu nhạy cảm, khiến việc liên kết lại với các cá nhân cụ thể trở nên khó khăn. Giá trị chính của chúng nằm ở việc cho phép phân tích dữ liệu, chia sẻ và huấn luyện mô hình trong khi tuân thủ các quy định về quyền riêng tư như GDPR và CCPA. Quá trình này là một thành phần quan trọng của quyền riêng tư dữ liệu, tập trung đặc biệt vào việc làm cho dữ liệu trở nên phi cá nhân để sử dụng an toàn.

Tính năng Cốt lõi

  • Phát hiện PII: Tự động quét các bộ dữ liệu để xác định và phân loại thông tin nhạy cảm như tên, địa chỉ và số an sinh xã hội.
  • Che giấu & Làm rối dữ liệu: Thay thế dữ liệu nhạy cảm bằng thông tin thực tế nhưng hư cấu, bảo toàn định dạng và khả năng sử dụng của dữ liệu cho việc kiểm thử hoặc phân tích.
  • Bút danh hóa: Thay thế các định danh trực tiếp bằng các mã thông báo nhất quán nhưng không thể nhận dạng (bút danh), cho phép liên kết dữ liệu mà không tiết lộ danh tính.
  • Tổng quát hóa & Ức chế: Giảm độ chính xác của dữ liệu (ví dụ: chuyển đổi tuổi chính xác thành một khoảng tuổi) hoặc loại bỏ một số bản ghi nhất định để ngăn chặn việc tái nhận dạng thông qua các kết hợp độc nhất.

Trường hợp sử dụng

Công cụ ẩn danh hóa rất cần thiết trong các lĩnh vực xử lý thông tin nhạy cảm. Trong y tế, chúng cho phép nghiên cứu lâm sàng sử dụng dữ liệu bệnh nhân mà không ảnh hưởng đến tính bảo mật. Các tổ chức tài chính sử dụng chúng để phân tích các mẫu gian lận trên dữ liệu giao dịch. Các công ty công nghệ áp dụng chúng để tạo ra các bộ dữ liệu an toàn, thực tế cho việc phát triển và kiểm thử phần mềm.

Cách chọn

Khi chọn một công cụ, hãy đánh giá các kỹ thuật ẩn danh hóa mà nó hỗ trợ (ví dụ: k-anonymity, differential privacy). Cân nhắc khả năng xử lý các loại dữ liệu đa dạng (có cấu trúc, phi cấu trúc, hình ảnh) và khả năng tích hợp với các luồng dữ liệu hiện có của bạn. Ngoài ra, hãy xác minh các chứng nhận tuân thủ của nó đối với các quy định liên quan đến ngành của bạn.

Ẩn danh hóa use cases

1

Bảo mật Dữ liệu Y tế cho Nghiên cứu Lâm sàng

Các nhà nghiên cứu y học và nhà khoa học dữ liệu thường cần truy cập vào các bộ dữ liệu bệnh nhân quy mô lớn để xác định xu hướng, kiểm tra giả thuyết và phát triển các phương pháp điều trị mới. Tuy nhiên, việc sử dụng dữ liệu thô của bệnh nhân gây ra rủi ro đáng kể về quyền riêng tư và vi phạm các quy định như HIPAA. Các công cụ ẩn danh hóa giải quyết vấn đề này bằng cách loại bỏ hoặc che giấu một cách có hệ thống các PII như tên, mã số bệnh nhân và địa chỉ chính xác, trong khi vẫn bảo toàn các thông tin y tế liên quan như chẩn đoán, phương pháp điều trị và kết quả. Điều này cho phép các nhà nghiên cứu làm việc với dữ liệu phong phú, thực tế, đẩy nhanh các đột phá y học mà không ảnh hưởng đến tính bảo mật của bệnh nhân.

2

Tạo Bộ dữ liệu An toàn để Kiểm thử Phần mềm

Các nhà phát triển phần mềm và kỹ sư QA cần dữ liệu thực tế để kiểm thử ứng dụng một cách hiệu quả, đặc biệt khi xử lý các tính năng liên quan đến thông tin người dùng. Việc sử dụng dữ liệu sản xuất trực tiếp là rủi ro và thường là bất hợp pháp. Các công cụ ẩn danh hóa tạo ra các bộ dữ liệu kiểm thử an toàn, tuân thủ quy định bằng cách lấy một bản sao của dữ liệu sản xuất và áp dụng các kỹ thuật như che dữ liệu và xáo trộn. Điều này đảm bảo rằng dữ liệu kiểm thử vẫn giữ được sự phức tạp và các thuộc tính thống kê của dữ liệu thực — cải thiện độ chính xác của kiểm thử — nhưng không chứa thông tin khách hàng nhạy cảm thực tế, cho phép kiểm thử kỹ lưỡng trên các môi trường phát triển, dàn dựng và bên thứ ba.

3

Cho phép Huấn luyện Mô hình AI Tuân thủ Quyền riêng tư

Các kỹ sư học máy yêu cầu một lượng lớn dữ liệu để huấn luyện các mô hình AI mạnh mẽ. Nếu dữ liệu này chứa PII, nó có thể dẫn đến các mô hình vô tình ghi nhớ và tiết lộ thông tin nhạy cảm, tạo ra các lỗ hổng bảo mật và quyền riêng tư đáng kể. Các công cụ ẩn danh hóa được sử dụng để tiền xử lý dữ liệu huấn luyện, loại bỏ hoặc chuyển đổi PII trước khi nó đến được mô hình. Điều này đặc biệt quan trọng đối với các mô hình trong lĩnh vực tài chính, y tế và dịch vụ khách hàng. Bằng cách huấn luyện trên dữ liệu đã được ẩn danh, các tổ chức có thể xây dựng các hệ thống AI mạnh mẽ và chính xác mà không có nguy cơ rò rỉ dữ liệu hoặc vi phạm luật bảo vệ dữ liệu.

4

Phân tích Hành vi Khách hàng mà không Vi phạm Quyền riêng tư

Các nhóm tiếp thị và kinh doanh thông minh phân tích dữ liệu khách hàng để hiểu xu hướng, phân khúc đối tượng và cá nhân hóa trải nghiệm. Tuy nhiên, các quy định như GDPR và CCPA áp đặt các quy tắc nghiêm ngặt về cách dữ liệu cá nhân có thể được sử dụng để phân tích. Các công cụ ẩn danh hóa cho phép các nhóm này tạo ra một phiên bản 'an toàn về quyền riêng tư' của cơ sở dữ liệu khách hàng của họ. Bằng cách thay thế các định danh trực tiếp bằng bút danh và tổng quát hóa các thuộc tính nhạy cảm như vị trí, các nhà phân tích có thể thực hiện phân tích tổng hợp mạnh mẽ và xác định các mẫu hành vi rộng rãi mà không cần truy cập dữ liệu cá nhân của bất kỳ cá nhân nào, đảm bảo cả phân tích sâu sắc và tuân thủ pháp luật.

5

Chia sẻ Dữ liệu với Đối tác và Bên thứ ba một cách An toàn

Các doanh nghiệp thường cần chia sẻ dữ liệu với các đối tác bên ngoài cho các dự án hợp tác, nghiên cứu hoặc tích hợp dịch vụ. Việc chia sẻ dữ liệu thô là một trách nhiệm bảo mật lớn. Các công cụ ẩn danh hóa hoạt động như một cổng an toàn để chia sẻ dữ liệu. Trước khi chuyển dữ liệu cho bên thứ ba, một tổ chức có thể áp dụng các chính sách ẩn danh hóa để loại bỏ tất cả PII. Điều này cung cấp cho đối tác dữ liệu cần thiết để thực hiện chức năng của họ (ví dụ: phân tích xu hướng thị trường) đồng thời đảm bảo rằng không có thông tin khách hàng nhạy cảm nào thoát khỏi sự kiểm soát của tổ chức, giảm thiểu nguy cơ vi phạm dữ liệu từ các nhà cung cấp bên thứ ba.

6

Công bố Dữ liệu Mở cho Mục đích Công cộng và Học thuật

Các cơ quan chính phủ, tổ chức phi chính phủ và các viện nghiên cứu thường công bố các bộ dữ liệu để minh bạch công khai và nghiên cứu, chẳng hạn như dữ liệu điều tra dân số, thống kê y tế công cộng hoặc kết quả khảo sát xã hội. Để thực hiện điều này một cách có trách nhiệm, tất cả các định danh cá nhân phải được loại bỏ để bảo vệ quyền riêng tư của công dân. Các công cụ ẩn danh hóa rất quan trọng cho quá trình này. Chúng áp dụng các kỹ thuật nghiêm ngặt như tổng quát hóa và quyền riêng tư vi phân để đảm bảo rằng ngay cả khi dữ liệu được công bố công khai, các cá nhân cũng không thể bị tái nhận dạng từ bộ dữ liệu, ngay cả khi kết hợp với các thông tin có sẵn khác. Điều này thúc đẩy các sáng kiến dữ liệu mở đồng thời duy trì các tiêu chuẩn đạo đức và pháp lý về quyền riêng tư.

Ẩn danh hóa FAQ

Công cụ Ẩn danh hóa AI là gì?

Công cụ Ẩn danh hóa AI là phần mềm chuyên dụng sử dụng trí tuệ nhân tạo để tự động xác định và loại bỏ hoặc sửa đổi thông tin nhận dạng cá nhân (PII) trong các bộ dữ liệu. Không giống như các phương pháp tìm và thay thế đơn giản, chúng sử dụng các kỹ thuật tiên tiến như che dữ liệu, bút danh hóa và tổng quát hóa để làm cho dữ liệu an toàn khi sử dụng trong phân tích, kiểm thử hoặc phát hành công khai trong khi vẫn giữ được tiện ích của nó. Mục tiêu chính của chúng là giảm thiểu rủi ro tái nhận dạng các cá nhân, giúp các tổ chức tuân thủ các quy định về quyền riêng tư như GDPR.

Sự khác biệt giữa Ẩn danh hóa và Bút danh hóa là gì?

Ẩn danh hóa và Bút danh hóa là các kỹ thuật bảo mật liên quan nhưng khác biệt. Bút danh hóa thay thế các định danh trực tiếp (như tên) bằng một mã thông báo nhất quán hoặc 'bút danh'. Điều này cho phép theo dõi dữ liệu của một cá nhân theo thời gian mà không cần biết danh tính thực của họ. Quá trình này thường có thể đảo ngược bằng một khóa riêng. Ẩn danh hóa là một quá trình mạnh mẽ hơn, không thể đảo ngược, nhằm mục đích loại bỏ tất cả thông tin có thể, một mình hoặc kết hợp, nhận dạng một cá nhân. Dữ liệu được ẩn danh không còn được coi là dữ liệu cá nhân theo các quy định như GDPR, trong khi dữ liệu được bút danh hóa thường vẫn được coi là dữ liệu cá nhân.

Làm cách nào để chọn công cụ Ẩn danh hóa phù hợp?

Việc chọn công cụ phù hợp phụ thuộc vào nhu cầu cụ thể của bạn. Hãy xem xét các yếu tố sau:

  • Loại dữ liệu: Công cụ có hỗ trợ các định dạng dữ liệu của bạn không (ví dụ: cơ sở dữ liệu có cấu trúc, văn bản phi cấu trúc, hình ảnh)?
  • Kỹ thuật ẩn danh hóa: Nó có cung cấp các phương pháp nâng cao như k-anonymity hoặc quyền riêng tư vi phân để đảm bảo mạnh mẽ hơn, hay chỉ là che giấu cơ bản?
  • Tích hợp: Nó có thể dễ dàng kết nối với các nguồn dữ liệu, kho dữ liệu và nền tảng phân tích hiện có của bạn không?
  • Hiệu suất và Khả năng mở rộng: Nó có thể xử lý khối lượng và tốc độ dữ liệu của bạn mà không tạo ra tắc nghẽn không?
  • Tuân thủ: Công cụ có được chứng nhận hoặc thiết kế để đáp ứng các quy định cụ thể liên quan đến ngành của bạn không (ví dụ: HIPAA, GDPR)?
Tại sao Ẩn danh hóa lại quan trọng đối với việc huấn luyện mô hình AI?

Ẩn danh hóa rất quan trọng đối với việc phát triển AI có trách nhiệm. Việc huấn luyện các mô hình trên dữ liệu cá nhân thô có thể dẫn đến rò rỉ quyền riêng tư, trong đó mô hình có thể vô tình tiết lộ thông tin nhạy cảm mà nó đã học được trong quá trình huấn luyện. Điều này tạo ra những rủi ro bảo mật đáng kể và có thể vi phạm luật bảo vệ dữ liệu. Bằng cách ẩn danh hóa dữ liệu trước khi huấn luyện, các nhà phát triển đảm bảo mô hình học được các mẫu và thông tin chi tiết chung mà không ghi nhớ các chi tiết cá nhân cụ thể. Điều này cho phép tạo ra các hệ thống AI mạnh mẽ, chính xác đồng thời bảo vệ quyền riêng tư của cá nhân và duy trì sự tuân thủ quy định.

Dữ liệu được ẩn danh có hoàn toàn an toàn trước việc tái nhận dạng không?

Mặc dù ẩn danh hóa làm giảm đáng kể rủi ro, không có phương pháp nào là an toàn 100% trước một kẻ tấn công có quyết tâm cao và có quyền truy cập vào các bộ dữ liệu bên ngoài. Mức độ an toàn phụ thuộc vào các kỹ thuật được sử dụng. Các phương pháp cơ bản như che giấu đơn giản đôi khi có thể bị đảo ngược. Các kỹ thuật nâng cao như k-anonymity đảm bảo bất kỳ cá nhân nào trong bộ dữ liệu đều không thể phân biệt được với ít nhất 'k-1' cá nhân khác. Quyền riêng tư vi phân thêm nhiễu thống kê để làm cho việc xác định xem dữ liệu của bất kỳ cá nhân nào có được bao gồm trong bộ dữ liệu hay không trở nên khó khăn về mặt toán học. Việc chọn các công cụ có các tính năng nâng cao này sẽ cung cấp sự bảo vệ mạnh mẽ nhất có thể chống lại việc tái nhận dạng.