ToolMage
Đăng nhập

AI TOOL COMPARISON

Skrape vs Webcrawlerapi

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Tổng quan sản phẩm

Skrape Tổng quan sản phẩm

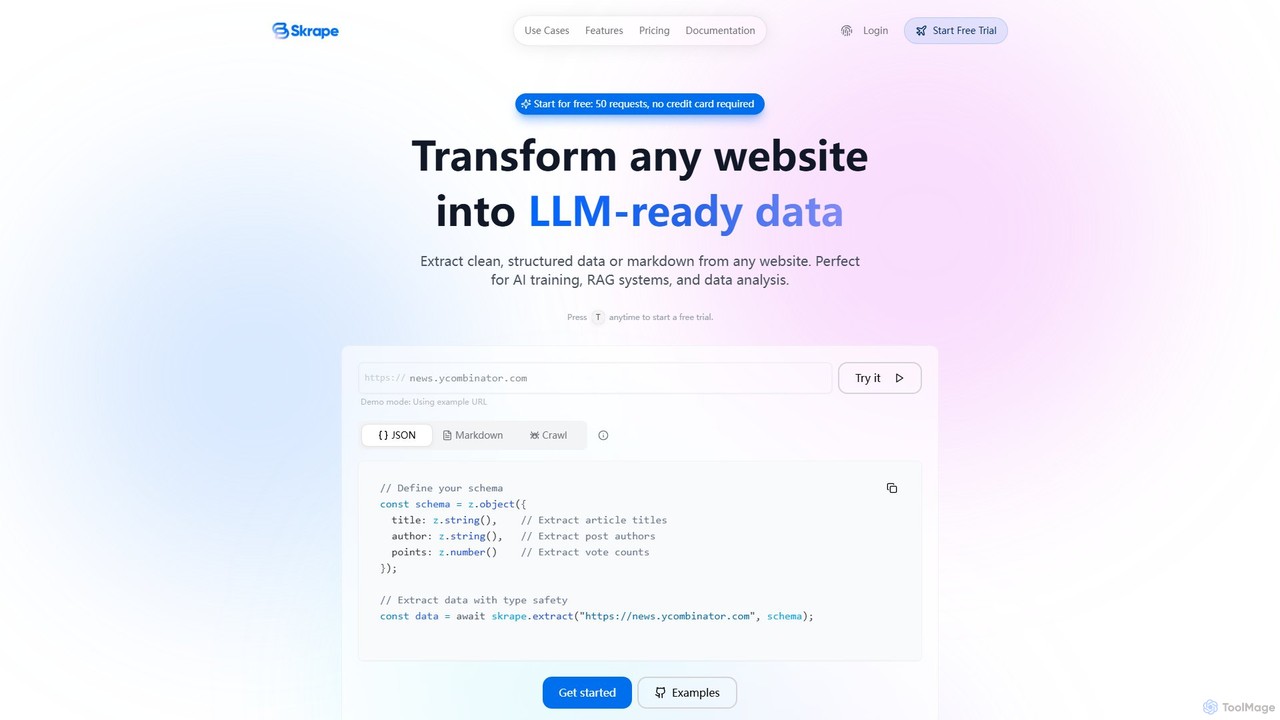
Skrape là một API trích xuất dữ liệu web được hỗ trợ bởi LLM, được thiết kế để biến bất kỳ trang web nào thành dữ liệu sạch, có cấu trúc và sẵn sàng cho LLM. Nó đơn giản hóa việc trích xuất dữ liệu bằng cách chuyển đổi các trang web thành JSON có cấu trúc hoặc markdown sạch, lý tưởng cho việc huấn luyện AI, hệ thống RAG và phân tích dữ liệu. Với các tính năng như xử lý nội dung động và thu thập thông minh, Skrape cung cấp một giải pháp đáng tin cậy cho các nhà phát triển và doanh nghiệp để tự động hóa các quy trình thu thập dữ liệu của họ.

Preview

Webcrawlerapi Tổng quan sản phẩm

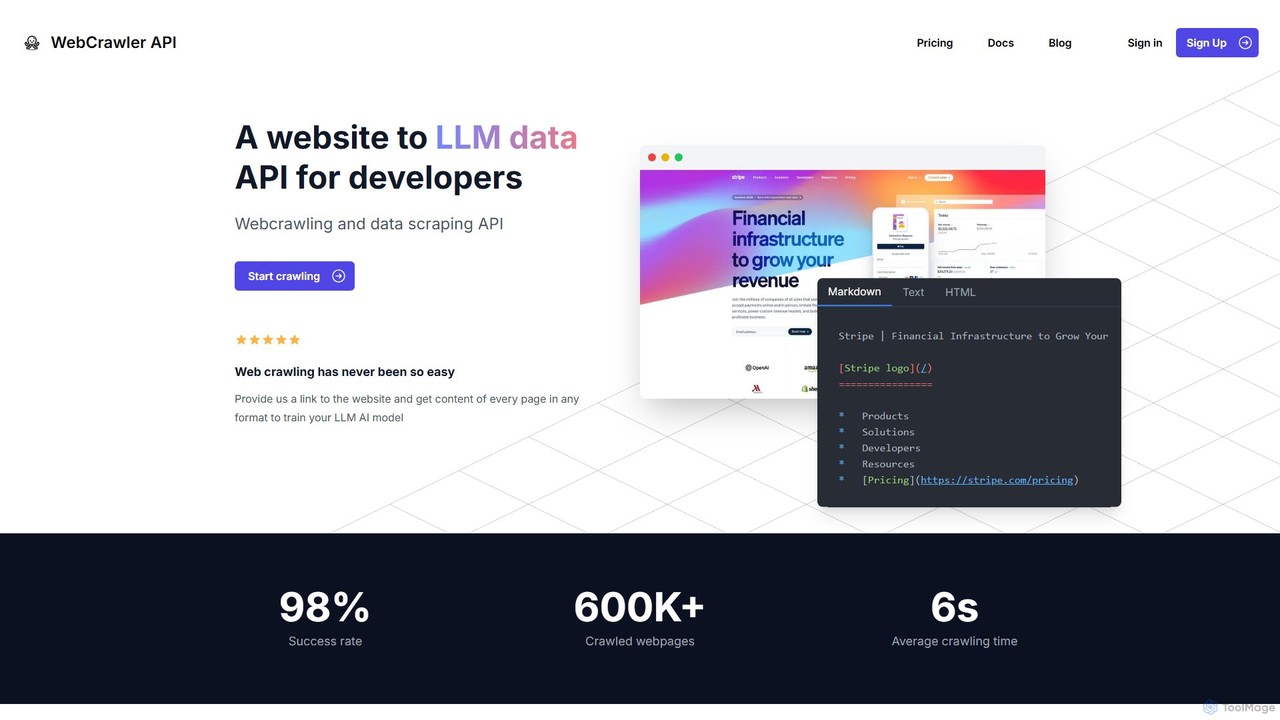
Webcrawlerapi là một API mạnh mẽ dành cho các nhà phát triển để dễ dàng thu thập dữ liệu web và trích xuất dữ liệu sạch. Nó đơn giản hóa việc cào web bằng cách xử lý kết xuất JavaScript, các biện pháp chống bot và phân tích cú pháp dữ liệu. Lý tưởng cho việc thu thập nội dung có cấu trúc như Markdown hoặc văn bản để huấn luyện các mô hình AI LLM hoặc cho các hệ thống Truy xuất-Tăng cường-Tạo sinh (RAG), nó cung cấp tỷ lệ thành công cao và mô hình định giá trả theo mức sử dụng đơn giản.

Preview

Thông tin chính

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Skrape VS Webcrawlerapi — Thông tin chính
Thông tin chínhSkrapeWebcrawlerapi
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusCào dữ liệuTrích xuất Dữ liệu
Đối tượng và vai tròChưa xác minhChưa xác minh
Danh mụcCào dữ liệu · API · Tự động hóaTrích xuất Dữ liệu · API · Tự động hóa
Added12 thg 8, 20252 thg 8, 2025
Cập nhật19 thg 11, 202619 thg 11, 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Skrape

Skrape là một API trích xuất dữ liệu web mạnh mẽ và thân thiện với nhà phát triển, tận dụng các Mô hình Ngôn ngữ Lớn (LLM) để trích xuất dữ liệu sạch và có cấu trúc từ bất kỳ trang web nào. Nó được thiết kế đặc biệt để hợp lý hóa quy trình thu thập dữ liệu cho các ứng dụng AI hiện đại, chẳng hạn như hệ thống Sinh tăng cường truy xuất (RAG), tinh chỉnh mô hình và phân tích dữ liệu sâu. Dịch vụ có thể biến các trang web phức tạp, bao gồm cả những trang có nội dung động được kết xuất bằng JavaScript, thành markdown được định dạng gọn gàng hoặc dữ liệu JSON có cấu trúc theo một lược đồ do người dùng xác định.

Triết lý cốt lõi của Skrape là đơn giản hóa việc trích xuất dữ liệu web. Thay vì phải đối phó với việc phân tích HTML phức tạp, các biện pháp chống trích xuất hoặc quản lý proxy, các nhà phát triển có thể sử dụng một lệnh gọi API đơn giản để lấy dữ liệu họ cần. Nền tảng được xây dựng cho độ tin cậy và khả năng mở rộng, đảm bảo rằng người dùng luôn nhận được dữ liệu tươi mới, thời gian thực mà không cần bộ nhớ đệm.

Cách sử dụng Skrape

Sử dụng Skrape rất đơn giản và được thiết kế để mang lại trải nghiệm liền mạch cho nhà phát triển. Dưới đây là quy trình làm việc điển hình:

  1. Đăng ký & Lấy khóa API: Đầu tiên, tạo một tài khoản trên trang web Skrape. Bạn có thể bắt đầu với bản dùng thử miễn phí cung cấp 50 tín dụng mà không cần thẻ tín dụng. Sau khi đăng ký, bạn sẽ nhận được khóa API từ bảng điều khiển của mình.
  2. Xác thực: Tất cả các yêu cầu API phải được xác thực bằng Token Bearer. Bạn cần bao gồm khóa API của mình trong tiêu đề `Authorization` của các yêu cầu (ví dụ: `Authorization: Bearer YOUR_API_KEY`).
  3. Chọn một điểm cuối (Endpoint): Skrape cung cấp một số điểm cuối API dựa trên nhu cầu của bạn:
    • /api/markdown: Chuyển đổi một trang web duy nhất thành markdown sạch.
    • /api/extract: Trích xuất dữ liệu JSON có cấu trúc từ một trang web dựa trên lược đồ Zod bạn cung cấp. Điều này cho phép trích xuất dữ liệu chính xác và an toàn về kiểu.
    • /api/crawl: Thu thập dữ liệu toàn bộ trang web, theo các liên kết để thu thập dữ liệu từ nhiều trang một cách hiệu quả.
  4. Thực hiện lệnh gọi API: Sử dụng máy khách HTTP ưa thích của bạn hoặc các SDK chính thức của Skrape (có sẵn cho Node.js và Python) để thực hiện yêu cầu đến API. Ví dụ, để trích xuất dữ liệu, bạn sẽ xác định cấu trúc dữ liệu mong muốn của mình dưới dạng một lược đồ và chuyển nó cùng với URL mục tiêu đến điểm cuối `/api/extract`.
  5. Xử lý kết quả: API trả về dữ liệu được trích xuất theo định dạng bạn yêu cầu — markdown sạch hoặc JSON có cấu trúc. Dịch vụ cũng hỗ trợ xử lý công việc nền cho các tác vụ chạy dài, và bạn có thể kiểm tra trạng thái công việc qua điểm cuối `/api/get-job`.

Tính năng chính của Skrape

  • Trích xuất thông minh được hỗ trợ bởi LLM: Xác định cấu trúc dữ liệu mong muốn của bạn bằng cách sử dụng một lược đồ, và AI sẽ trích xuất và định dạng thông tin một cách thông minh thành JSON có cấu trúc.
  • Thu thập thông minh: Tự động thu thập dữ liệu toàn bộ trang web, ngay cả những trang không có sơ đồ trang web, đồng thời tôn trọng các quy tắc của `robots.txt` để đảm bảo việc trích xuất có đạo đức.
  • Xử lý nội dung động: Hỗ trợ đầy đủ việc kết xuất JavaScript, cho phép nó xử lý các Ứng dụng trang đơn (SPA) và các nội dung động khác mà các công cụ trích xuất truyền thống gặp khó khăn.
  • Chuyển đổi Markdown sạch: Chuyển đổi bất kỳ trang web nào thành markdown được định dạng hoàn hảo và sạch sẽ, lý tưởng cho các hệ thống RAG và cơ sở kiến thức.
  • Hành động API: Có thể thực hiện các hành động trên một trang như nhấp vào nút, cuộn và đợi nội dung cụ thể tải xong trước khi trích xuất.
  • Dữ liệu thời gian thực: Skrape không lưu trữ nội dung vào bộ nhớ đệm, đảm bảo bạn luôn nhận được dữ liệu mới nhất, cập nhật nhất trực tiếp từ nguồn.
  • Thân thiện với nhà phát triển: Cung cấp các SDK chính thức cho Node.js và Python, tài liệu API toàn diện và định dạng xử lý lỗi nhất quán.

Các trường hợp sử dụng Skrape

Skrape rất linh hoạt và có thể được áp dụng cho nhiều tác vụ thu thập dữ liệu:

  • Thu thập dữ liệu sẵn sàng cho RAG: Biến các trang web thành các bộ dữ liệu sạch, có cấu trúc với việc trích xuất siêu dữ liệu tự động, hoàn hảo để cung cấp cho các ứng dụng Sinh tăng cường truy xuất.
  • Quy trình dữ liệu huấn luyện AI: Tự động hóa việc thu thập các bộ dữ liệu đa dạng, chất lượng cao, đa ngôn ngữ để tinh chỉnh các mô hình ngôn ngữ và các ứng dụng AI khác.
  • Xây dựng cơ sở kiến thức: Tạo các cơ sở kiến thức toàn diện bằng cách trích xuất tài liệu kỹ thuật, tài liệu tham khảo API, hướng dẫn và các bài báo nghiên cứu từ nhiều nguồn.
  • Giám sát nội dung AI: Luôn cập nhật các xu hướng ngành mới nhất bằng cách theo dõi và thu thập tin tức, nghiên cứu và blog kỹ thuật liên quan đến AI.
  • Dữ liệu đánh giá mô hình: Thu thập dữ liệu thực tế từ các lĩnh vực khác nhau để đánh giá và so sánh hiệu suất của các LLM của bạn.

Ưu điểm của Skrape

Skrape mang lại một lợi thế đáng kể so với các phương pháp trích xuất dữ liệu web truyền thống. Các ưu điểm chính của nó bao gồm sự đơn giản, sức mạnh và độ tin cậy. Cách tiếp cận API-first loại bỏ sự phức tạp của việc trích xuất dữ liệu web, cho phép các nhà phát triển tập trung vào việc sử dụng dữ liệu. Việc sử dụng LLM để trích xuất mang lại độ chính xác và linh hoạt vượt trội so với các phương pháp dựa trên bộ chọn CSS dễ bị lỗi. Hơn nữa, khả năng xử lý nội dung động và cung cấp đầu ra sạch, sẵn sàng sử dụng giúp tiết kiệm đáng kể thời gian và công sức phát triển.

Giá cả và gói dịch vụ

Skrape cung cấp một mô hình định giá dựa trên tín dụng minh bạch, được thiết kế để mở rộng theo nhu cầu của bạn.

  • Dùng thử miễn phí: Bắt đầu với 50 tín dụng miễn phí để thử nghiệm dịch vụ. Không yêu cầu thẻ tín dụng.
  • Gói Starter: $15/tháng cho 3.000 tín dụng. Lý tưởng cho các dự án nhỏ và các nhà phát triển cá nhân.
  • Gói Growth: $50/tháng cho 10.000 tín dụng. Phù hợp cho các nhóm đang phát triển có nhu cầu sử dụng tăng. Bao gồm hỗ trợ ưu tiên.
  • Gói Pro: $250/tháng cho 50.000 tín dụng. Được thiết kế cho các doanh nghiệp và nhóm có yêu cầu khối lượng lớn. Bao gồm hỗ trợ ưu tiên và giới hạn tốc độ tùy chỉnh.

Sử dụng tín dụng:

  • HTML sang Markdown: 1 tín dụng mỗi trang
  • Thu thập dữ liệu web: 1 tín dụng mỗi trang
  • Trích xuất dữ liệu bằng AI: 5 tín dụng mỗi trang

Webcrawlerapi

Webcrawlerapi là một API chuyên dụng được thiết kế để hợp lý hóa quy trình thu thập dữ liệu web và trích xuất dữ liệu cho các nhà phát triển. Trong thời đại mà dữ liệu rất quan trọng để huấn luyện các mô hình ngôn ngữ lớn (LLM) và cung cấp năng lượng cho các ứng dụng AI, việc cào web truyền thống đặt ra những thách thức đáng kể. Chúng bao gồm việc xử lý nội dung được kết xuất bằng JavaScript động, vượt qua các hệ thống chống bot tinh vi, quản lý proxy và làm sạch HTML lộn xộn thành các định dạng có thể sử dụng được. Webcrawlerapi trừu tượng hóa tất cả những phức tạp này, cung cấp một giao diện đơn giản nhưng mạnh mẽ để biến bất kỳ trang web nào thành một nguồn dữ liệu có cấu trúc.

Với tỷ lệ thành công được báo cáo là 98% và thời gian thu thập dữ liệu trung bình chỉ 6 giây, dịch vụ này được xây dựng để đạt hiệu quả và độ tin cậy. Nó cho phép các nhà phát triển tập trung vào logic ứng dụng cốt lõi của họ thay vì bị sa lầy vào sự phức tạp của việc xây dựng và duy trì một cơ sở hạ tầng thu thập dữ liệu có thể mở rộng. Bằng cách cung cấp một liên kết, các nhà phát triển có thể nhận được nội dung sạch, sẵn sàng sử dụng ở các định dạng như Markdown, văn bản hoặc HTML thô, làm cho nó trở nên hoàn hảo để cung cấp cho các đường ống huấn luyện mô hình AI hoặc cơ sở kiến thức cho các hệ thống RAG.

Cách sử dụng Webcrawlerapi

Việc tích hợp Webcrawlerapi vào dự án của bạn được thiết kế rất đơn giản. Quá trình này thường chỉ bao gồm một vài dòng mã. Đầu tiên, bạn cần đăng ký trên trang web Webcrawlerapi để nhận khóa truy cập API duy nhất của mình. Sau đó, bạn có thể sử dụng một trong các thư viện máy khách được cung cấp của họ cho các ngôn ngữ lập trình phổ biến.

Ví dụ, trong môi trường NodeJS, bạn sẽ bắt đầu bằng cách cài đặt thư viện máy khách qua npm: npm i webcrawlerapi-js. Sau đó, trong mã của bạn, bạn nhập thư viện, tạo một phiên bản máy khách mới với khóa API của bạn và gọi phương thức `crawl`. Phương thức này nhận các tham số như `url` mục tiêu, `scrape_type` mong muốn (ví dụ: 'markdown') và các giới hạn tùy chọn như `items_limit`. API sau đó sẽ xử lý toàn bộ quá trình thu thập dữ liệu trong nền và trả về một phản hồi JSON có cấu trúc với dữ liệu đã được trích xuất. Các mẫu tích hợp đơn giản tương tự có sẵn cho Python, PHP và .NET, giúp nó có thể truy cập được đối với nhiều nhà phát triển.

Tính năng chính của Webcrawlerapi

  • Xử lý liên kết tự động: API tự động phát hiện và quản lý tất cả các liên kết nội bộ trên một trang web, đảm bảo việc thu thập dữ liệu toàn diện đồng thời tự động xử lý các liên kết trùng lặp và làm sạch URL.
  • Kết xuất JavaScript nâng cao: Nó kết xuất hiệu quả nội dung động phía máy khách bằng cách sử dụng một hệ thống ổn định và mạnh mẽ, khắc phục sự bất ổn và các vấn đề về bộ nhớ thường liên quan đến các công cụ như Puppeteer hoặc Playwright.
  • Né tránh Anti-Bot mạnh mẽ: Webcrawlerapi đi kèm với các cơ chế tích hợp để đối phó với CAPTCHA, chặn IP, giới hạn tốc độ và các biện pháp phòng thủ chống bot phổ biến khác, đảm bảo tỷ lệ thành công cao.
  • Làm sạch dữ liệu tự động: Nó bao gồm các quy tắc phân tích cú pháp mạnh mẽ để chuyển đổi HTML thô, phức tạp thành các định dạng sạch, có cấu trúc như Markdown hoặc văn bản thuần túy, tiết kiệm đáng kể thời gian xử lý hậu kỳ cho các nhà phát triển.
  • Cơ sở hạ tầng có thể mở rộng: Dịch vụ quản lý một cơ sở hạ tầng phân tán gồm các trình thu thập dữ liệu và proxy, cho phép bạn mở rộng quy mô nỗ lực trích xuất dữ liệu của mình từ một vài trang lên hàng triệu trang mà không cần lo lắng về phần cứng cơ bản hoặc quản lý mạng.
  • API & SDK thân thiện với nhà phát triển: Cung cấp một API đơn giản và các thư viện máy khách chính thức cho các ngôn ngữ chính như NodeJS, Python, PHP và .NET, hoàn chỉnh với tài liệu rõ ràng.

Các trường hợp sử dụng Webcrawlerapi

Webcrawlerapi rất linh hoạt và có thể được áp dụng cho nhiều tác vụ sử dụng nhiều dữ liệu. Các trường hợp sử dụng chính của nó xoay quanh AI và phân tích dữ liệu.

  • Thu thập dữ liệu huấn luyện LLM: Thu thập dữ liệu một cách có hệ thống từ các trang web, blog và diễn đàn để thu thập một lượng lớn dữ liệu văn bản chất lượng cao, theo miền cụ thể để huấn luyện hoặc tinh chỉnh các mô hình ngôn ngữ lớn tùy chỉnh.
  • Truy xuất-Tăng cường-Tạo sinh (RAG): Xây dựng và duy trì các cơ sở kiến thức cập nhật cho các hệ thống RAG. Thu thập dữ liệu từ tài liệu sản phẩm, trung tâm trợ giúp hoặc các trang tin tức để cung cấp cho LLM thông tin chính xác, thời gian thực để trả lời các truy vấn của người dùng.
  • Nghiên cứu thị trường và phân tích cạnh tranh: Tự động trích xuất chi tiết sản phẩm, thông tin giá cả, đánh giá của khách hàng và nội dung tiếp thị từ các trang web của đối thủ cạnh tranh để có được những hiểu biết chiến lược.
  • Tổng hợp nội dung: Cung cấp năng lượng cho các trình tổng hợp tin tức, bảng tin việc làm hoặc các trang web danh sách bất động sản bằng cách thường xuyên thu thập dữ liệu từ nhiều nguồn và hợp nhất dữ liệu vào một nền tảng thống nhất.

Ưu điểm của Webcrawlerapi

Ưu điểm chính của Webcrawlerapi là sự đơn giản và hiệu quả của nó. Nó cho phép các nhóm phát triển giảm tải toàn bộ cơ sở hạ tầng thu thập dữ liệu web và gánh nặng bảo trì. Điều này có nghĩa là thời gian đưa sản phẩm dựa trên dữ liệu ra thị trường nhanh hơn. Tỷ lệ thành công cao (98%) và các tính năng chống bot mạnh mẽ đảm bảo các đường ống dữ liệu đáng tin cậy. Hơn nữa, mô hình định giá trả theo mức sử dụng minh bạch của nó rất hiệu quả về chi phí, vì bạn chỉ trả tiền cho các yêu cầu thành công, loại bỏ rủi ro và chi phí chung liên quan đến đăng ký hoặc xây dựng một giải pháp nội bộ.

Giá cả và gói dịch vụ

Webcrawlerapi sử dụng một mô hình định giá 'trả tiền cho việc sử dụng' đơn giản và minh bạch, hoàn toàn tránh các gói đăng ký và phí ẩn. Chi phí được tính dựa trên số lượng trang bạn thu thập thành công mỗi tháng. Dịch vụ bao gồm các công việc thu thập dữ liệu không giới hạn, một mạng proxy không giới hạn và được quản lý tự động, và hỗ trợ qua email trong giá của nó. Để ước tính chi phí rõ ràng, trang web cung cấp một máy tính. Ví dụ, việc thu thập 10.000 trang trong một tháng sẽ có giá khoảng 20 đô la. Mô hình này lý tưởng cho các dự án ở mọi quy mô, từ các thử nghiệm quy mô nhỏ đến các hoạt động dữ liệu quy mô lớn, vì chi phí tăng trực tiếp theo mức sử dụng. Nền tảng này cũng cho phép người dùng dùng thử dịch vụ trước khi mua, có thể thông qua việc phân bổ tín dụng miễn phí cho các tài khoản mới.

Định vị

Phân loại cho thấy phần giao nhau và trọng tâm riêng của từng sản phẩm. Các trường chưa biết được hiển thị rõ và không được điền bằng giả định.

Danh mục

Chung
APITự động hóa
Chỉ Skrape
Cào dữ liệu
Chỉ Webcrawlerapi
Trích xuất Dữ liệu

Thẻ

Chung
APItự động hóaThu thập dữ liệuTrích xuất dữ liệucông cụ dành cho nhà phát triểnTạo sinh tăng cường truy xuất
Chỉ Skrape
Đào tạo AInội dung độngJSONMô hình ngôn ngữ lớnMarkdownWeb scraping
Chỉ Webcrawlerapi
Cào dữ liệuKết xuất JavaScriptHuấn luyện LLMThu thập dữ liệu web

Đối tượng và vai trò

Chung
Không có dữ liệu đã xác minh
Chỉ Skrape
Không có dữ liệu đã xác minh
Chỉ Webcrawlerapi
Không có dữ liệu đã xác minh

So sánh lưu lượng

Lưu lượng dùng cùng một thang đo để phản ánh đúng mức độ hiện diện trên thị trường.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Skrape

Chưa xác minh

Webcrawlerapi monthly traffic:

Latest traffic · 2026-05

Lượt truy cập tháng
5.4K
Thời lượng trung bình
0:46
Trang mỗi lượt
1.95
Tỷ lệ thoát
41.65%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 5.1K
  • 2026-01: 4.5K
  • 2026-02: 4K
  • 2026-03: 4.3K
  • 2026-04: 5.6K
  • 2026-05: 5.4K

Khu vực hàng đầu

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States49.13%2.7K
🇩🇪Germany20.9%1.1K
🇮🇳India14.85%809
🇻🇳Vietnam12.23%666
🇦🇺Australia2.89%157

Từ khóa tìm kiếm

better to save as an html or md file packing more informationdata scraping law casesfirecrawl alternativesllms txt generator onlinesubmit website to chatgpt

Tín hiệu cộng đồng

Đánh giá và phản hồi là tín hiệu cộng đồng, không thay thế mức độ phù hợp của sản phẩm.

Skrape

Đánh giá
Chưa xác minh
Bình luận
0
Yêu thích
166
Lượt thích
153

Webcrawlerapi

Đánh giá
Chưa xác minh
Bình luận
0
Yêu thích
182
Lượt thích
179

Skrape vs Webcrawlerapi · Câu hỏi thường gặp

What do Skrape and Webcrawlerapi have in common?
Both tools are listed under API、Tự động hóa. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Skrape and Webcrawlerapi free?
Listed pricing models: Skrape — Freemium; Webcrawlerapi — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Skrape and Webcrawlerapi?
The primary listed category is Cào dữ liệu for Skrape, and Trích xuất Dữ liệu for Webcrawlerapi. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

So sánh liên quan