

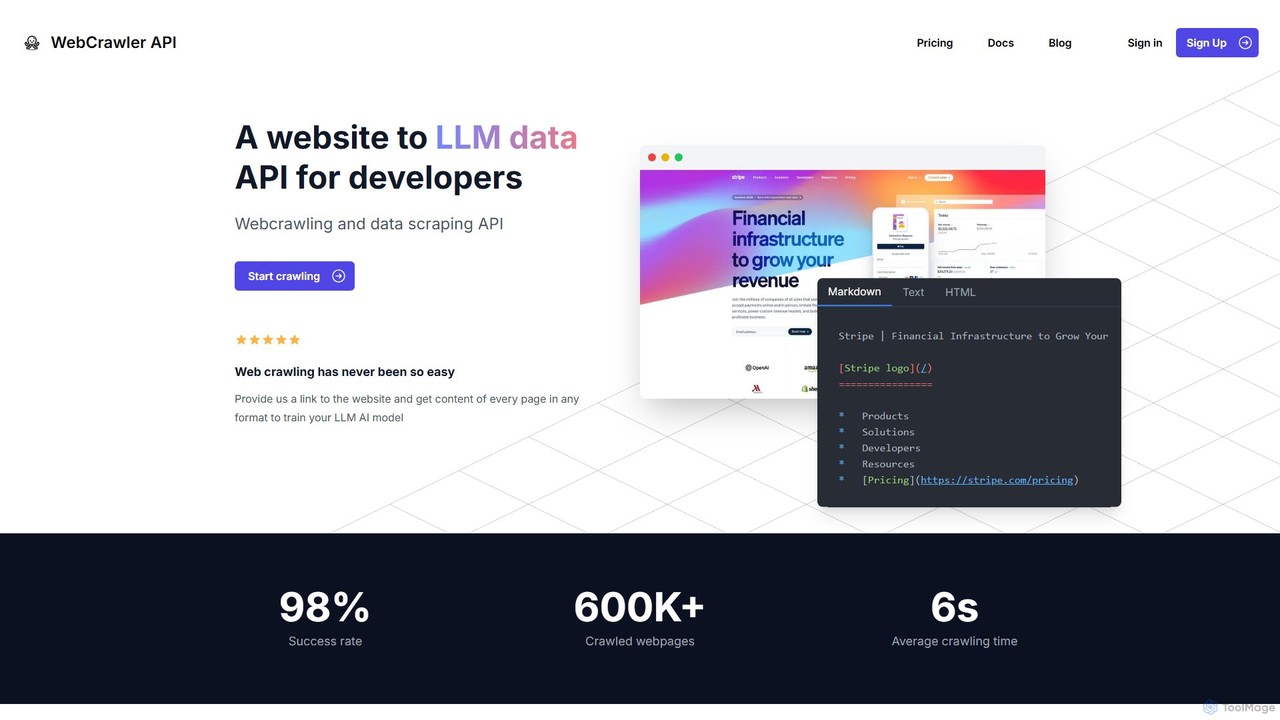
Webcrawlerapi Overview
Webcrawlerapi là một API chuyên dụng được thiết kế để hợp lý hóa quy trình thu thập dữ liệu web và trích xuất dữ liệu cho các nhà phát triển. Trong thời đại mà dữ liệu rất quan trọng để huấn luyện các mô hình ngôn ngữ lớn (LLM) và cung cấp năng lượng cho các ứng dụng AI, việc cào web truyền thống đặt ra những thách thức đáng kể. Chúng bao gồm việc xử lý nội dung được kết xuất bằng JavaScript động, vượt qua các hệ thống chống bot tinh vi, quản lý proxy và làm sạch HTML lộn xộn thành các định dạng có thể sử dụng được. Webcrawlerapi trừu tượng hóa tất cả những phức tạp này, cung cấp một giao diện đơn giản nhưng mạnh mẽ để biến bất kỳ trang web nào thành một nguồn dữ liệu có cấu trúc.
Với tỷ lệ thành công được báo cáo là 98% và thời gian thu thập dữ liệu trung bình chỉ 6 giây, dịch vụ này được xây dựng để đạt hiệu quả và độ tin cậy. Nó cho phép các nhà phát triển tập trung vào logic ứng dụng cốt lõi của họ thay vì bị sa lầy vào sự phức tạp của việc xây dựng và duy trì một cơ sở hạ tầng thu thập dữ liệu có thể mở rộng. Bằng cách cung cấp một liên kết, các nhà phát triển có thể nhận được nội dung sạch, sẵn sàng sử dụng ở các định dạng như Markdown, văn bản hoặc HTML thô, làm cho nó trở nên hoàn hảo để cung cấp cho các đường ống huấn luyện mô hình AI hoặc cơ sở kiến thức cho các hệ thống RAG.
Cách sử dụng Webcrawlerapi
Việc tích hợp Webcrawlerapi vào dự án của bạn được thiết kế rất đơn giản. Quá trình này thường chỉ bao gồm một vài dòng mã. Đầu tiên, bạn cần đăng ký trên trang web Webcrawlerapi để nhận khóa truy cập API duy nhất của mình. Sau đó, bạn có thể sử dụng một trong các thư viện máy khách được cung cấp của họ cho các ngôn ngữ lập trình phổ biến.
Ví dụ, trong môi trường NodeJS, bạn sẽ bắt đầu bằng cách cài đặt thư viện máy khách qua npm: npm i webcrawlerapi-js. Sau đó, trong mã của bạn, bạn nhập thư viện, tạo một phiên bản máy khách mới với khóa API của bạn và gọi phương thức `crawl`. Phương thức này nhận các tham số như `url` mục tiêu, `scrape_type` mong muốn (ví dụ: 'markdown') và các giới hạn tùy chọn như `items_limit`. API sau đó sẽ xử lý toàn bộ quá trình thu thập dữ liệu trong nền và trả về một phản hồi JSON có cấu trúc với dữ liệu đã được trích xuất. Các mẫu tích hợp đơn giản tương tự có sẵn cho Python, PHP và .NET, giúp nó có thể truy cập được đối với nhiều nhà phát triển.
Tính năng chính của Webcrawlerapi
- Xử lý liên kết tự động: API tự động phát hiện và quản lý tất cả các liên kết nội bộ trên một trang web, đảm bảo việc thu thập dữ liệu toàn diện đồng thời tự động xử lý các liên kết trùng lặp và làm sạch URL.
- Kết xuất JavaScript nâng cao: Nó kết xuất hiệu quả nội dung động phía máy khách bằng cách sử dụng một hệ thống ổn định và mạnh mẽ, khắc phục sự bất ổn và các vấn đề về bộ nhớ thường liên quan đến các công cụ như Puppeteer hoặc Playwright.
- Né tránh Anti-Bot mạnh mẽ: Webcrawlerapi đi kèm với các cơ chế tích hợp để đối phó với CAPTCHA, chặn IP, giới hạn tốc độ và các biện pháp phòng thủ chống bot phổ biến khác, đảm bảo tỷ lệ thành công cao.
- Làm sạch dữ liệu tự động: Nó bao gồm các quy tắc phân tích cú pháp mạnh mẽ để chuyển đổi HTML thô, phức tạp thành các định dạng sạch, có cấu trúc như Markdown hoặc văn bản thuần túy, tiết kiệm đáng kể thời gian xử lý hậu kỳ cho các nhà phát triển.
- Cơ sở hạ tầng có thể mở rộng: Dịch vụ quản lý một cơ sở hạ tầng phân tán gồm các trình thu thập dữ liệu và proxy, cho phép bạn mở rộng quy mô nỗ lực trích xuất dữ liệu của mình từ một vài trang lên hàng triệu trang mà không cần lo lắng về phần cứng cơ bản hoặc quản lý mạng.
- API & SDK thân thiện với nhà phát triển: Cung cấp một API đơn giản và các thư viện máy khách chính thức cho các ngôn ngữ chính như NodeJS, Python, PHP và .NET, hoàn chỉnh với tài liệu rõ ràng.
Các trường hợp sử dụng Webcrawlerapi
Webcrawlerapi rất linh hoạt và có thể được áp dụng cho nhiều tác vụ sử dụng nhiều dữ liệu. Các trường hợp sử dụng chính của nó xoay quanh AI và phân tích dữ liệu.
- Thu thập dữ liệu huấn luyện LLM: Thu thập dữ liệu một cách có hệ thống từ các trang web, blog và diễn đàn để thu thập một lượng lớn dữ liệu văn bản chất lượng cao, theo miền cụ thể để huấn luyện hoặc tinh chỉnh các mô hình ngôn ngữ lớn tùy chỉnh.
- Truy xuất-Tăng cường-Tạo sinh (RAG): Xây dựng và duy trì các cơ sở kiến thức cập nhật cho các hệ thống RAG. Thu thập dữ liệu từ tài liệu sản phẩm, trung tâm trợ giúp hoặc các trang tin tức để cung cấp cho LLM thông tin chính xác, thời gian thực để trả lời các truy vấn của người dùng.
- Nghiên cứu thị trường và phân tích cạnh tranh: Tự động trích xuất chi tiết sản phẩm, thông tin giá cả, đánh giá của khách hàng và nội dung tiếp thị từ các trang web của đối thủ cạnh tranh để có được những hiểu biết chiến lược.
- Tổng hợp nội dung: Cung cấp năng lượng cho các trình tổng hợp tin tức, bảng tin việc làm hoặc các trang web danh sách bất động sản bằng cách thường xuyên thu thập dữ liệu từ nhiều nguồn và hợp nhất dữ liệu vào một nền tảng thống nhất.
Ưu điểm của Webcrawlerapi
Ưu điểm chính của Webcrawlerapi là sự đơn giản và hiệu quả của nó. Nó cho phép các nhóm phát triển giảm tải toàn bộ cơ sở hạ tầng thu thập dữ liệu web và gánh nặng bảo trì. Điều này có nghĩa là thời gian đưa sản phẩm dựa trên dữ liệu ra thị trường nhanh hơn. Tỷ lệ thành công cao (98%) và các tính năng chống bot mạnh mẽ đảm bảo các đường ống dữ liệu đáng tin cậy. Hơn nữa, mô hình định giá trả theo mức sử dụng minh bạch của nó rất hiệu quả về chi phí, vì bạn chỉ trả tiền cho các yêu cầu thành công, loại bỏ rủi ro và chi phí chung liên quan đến đăng ký hoặc xây dựng một giải pháp nội bộ.
Giá cả và gói dịch vụ
Webcrawlerapi sử dụng một mô hình định giá 'trả tiền cho việc sử dụng' đơn giản và minh bạch, hoàn toàn tránh các gói đăng ký và phí ẩn. Chi phí được tính dựa trên số lượng trang bạn thu thập thành công mỗi tháng. Dịch vụ bao gồm các công việc thu thập dữ liệu không giới hạn, một mạng proxy không giới hạn và được quản lý tự động, và hỗ trợ qua email trong giá của nó. Để ước tính chi phí rõ ràng, trang web cung cấp một máy tính. Ví dụ, việc thu thập 10.000 trang trong một tháng sẽ có giá khoảng 20 đô la. Mô hình này lý tưởng cho các dự án ở mọi quy mô, từ các thử nghiệm quy mô nhỏ đến các hoạt động dữ liệu quy mô lớn, vì chi phí tăng trực tiếp theo mức sử dụng. Nền tảng này cũng cho phép người dùng dùng thử dịch vụ trước khi mua, có thể thông qua việc phân bổ tín dụng miễn phí cho các tài khoản mới.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 5.1K
- 2026-1: 4.5K
- 2026-2: 4.0K
- 2026-3: 4.3K
- 2026-4: 5.6K
- 2026-5: 5.4K
Geography
Top 5 countries / regions
- 🇺🇸Hoa Kỳ49.1%
- 🇩🇪Đức20.9%
- 🇮🇳Ấn Độ14.8%
- 🇻🇳Việt Nam12.2%
- 🇦🇺Úc2.9%
Top keywords
| Keyword | Cost per click |
|---|---|
| better to save as an html or md file packing more information | $0.00 |
| data scraping law cases | $0.00 |
| firecrawl alternatives | $11.71 |
| llms txt generator online | $0.00 |
| submit website to chatgpt | $0.00 |
Webcrawlerapi Alternatives
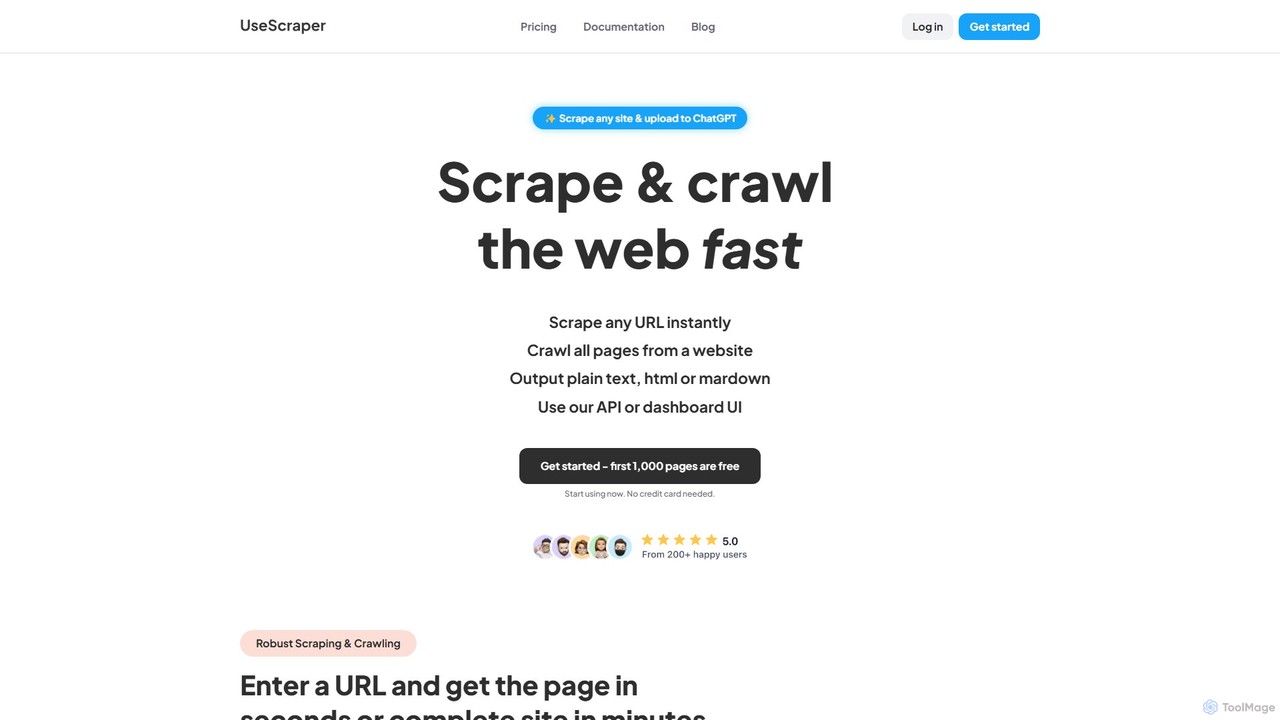
UseScraper
UseScraper là một API crawler và scraper web mạnh mẽ được thiết kế cho các nhà phát triển và ứng dụng AI. Nó trích xuất dữ liệu hiệu quả từ bất kỳ trang web nào, có tính năng render JavaScript đầy đủ, cơ sở hạ tầng tự động mở rộng và các định dạng đầu ra sạch sẽ như Markdown, lý tưởng để cung cấp dữ liệu cho các LLM như ChatGPT.
Trích xuất Dữ liệu
Foxscrape
FoxScrape là một API REST cào dữ liệu web được hỗ trợ bởi AI dành cho các nhà phát triển. Nó đơn giản hóa việc trích xuất dữ liệu bằng cách chuyển đổi bất kỳ trang web nào thành dữ liệu JSON có cấu trúc bằng các tính năng như phân tích cú pháp do AI điều khiển từ tiếng Anh đơn giản, kết xuất JavaScript cho các trang web động và xoay vòng proxy tự động để ngăn chặn việc bị chặn.
Trích xuất Dữ liệu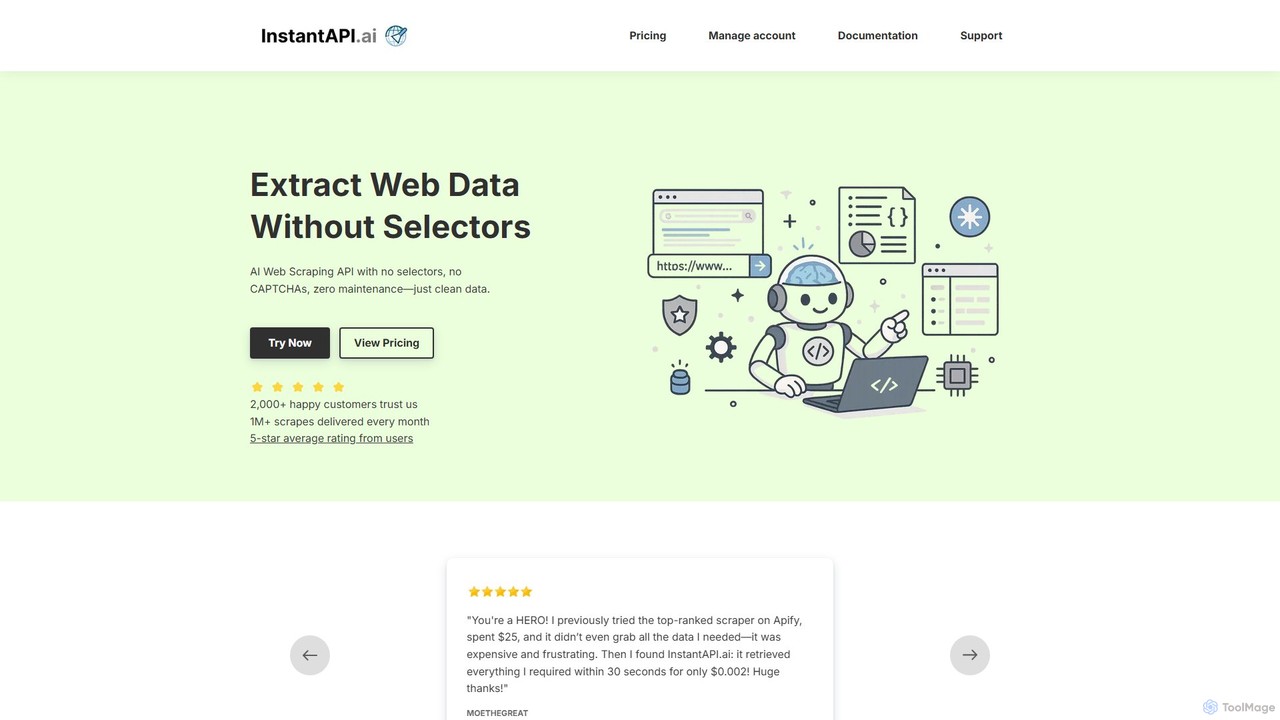
instantapi
instantapi là một API cào web được hỗ trợ bởi AI, được thiết kế cho sự đơn giản và tốc độ. Nó cho phép người dùng trích xuất dữ liệu có cấu trúc từ bất kỳ trang web nào chỉ với một lệnh gọi API duy nhất, loại bỏ nhu cầu về mã hóa phức tạp hoặc thiết lập thủ công. Lý tưởng cho các nhà phát triển, nhà phân tích dữ liệu và doanh nghiệp cần trích xuất dữ liệu nhanh chóng, giá cả phải chăng và đáng tin cậy mà không gặp rắc rối với các công cụ cào web truyền thống.
Trích xuất Dữ liệu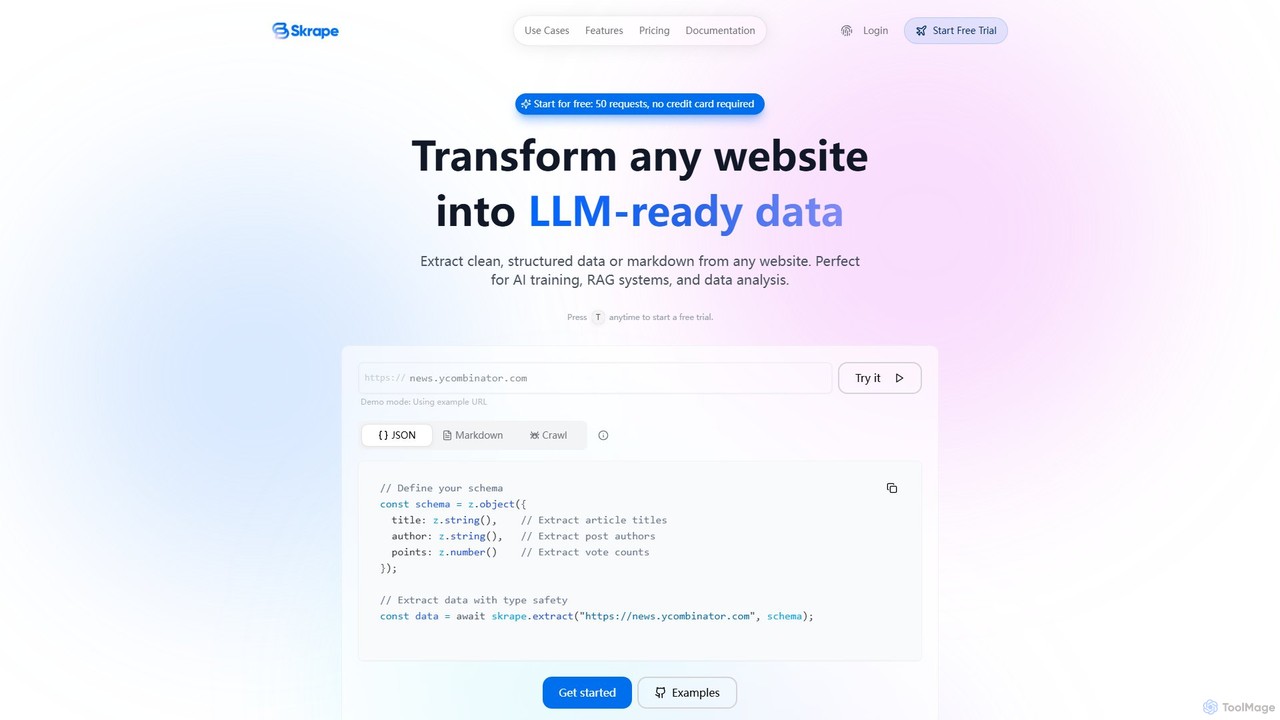
Skrape
Skrape là một API trích xuất dữ liệu web được hỗ trợ bởi LLM, được thiết kế để biến bất kỳ trang web nào thành dữ liệu sạch, có cấu trúc và sẵn sàng cho LLM. Nó đơn giản hóa việc trích xuất dữ liệu bằng cách chuyển đổi các trang web thành JSON có cấu trúc hoặc markdown sạch, lý tưởng cho việc huấn luyện AI, hệ thống RAG và phân tích dữ liệu. Với các tính năng như xử lý nội dung động và thu thập thông minh, Skrape cung cấp một giải pháp đáng tin cậy cho các nhà phát triển và doanh nghiệp để tự động hóa các quy trình thu thập dữ liệu của họ.
Cào dữ liệu
Isomeric
Isomeric là một API được hỗ trợ bởi AI giúp chuyển đổi văn bản lộn xộn, phi cấu trúc từ bất kỳ nguồn nào thành dữ liệu JSON sạch, có cấu trúc. Bằng cách xác định một lược đồ JSON đơn giản, bạn có thể tự động trích xuất thông tin cụ thể từ các trang web, tài liệu pháp lý, bản ghi hỗ trợ khách hàng, v.v., hợp lý hóa các đường ống dữ liệu và tự động hóa.
Trích xuất Dữ liệuWebcrawlerapi Categories
Webcrawlerapi Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
UseScraper
UseScraper là một API crawler và scraper web mạnh mẽ được thiết kế cho các nhà phát triển và ứng dụng AI. Nó trích xuất dữ liệu hiệu quả từ bất kỳ trang web nào, có tính năng render JavaScript đầy đủ, cơ sở hạ tầng tự động mở rộng và các định dạng đầu ra sạch sẽ như Markdown, lý tưởng để cung cấp dữ liệu cho các LLM như ChatGPT.
Trích xuất Dữ liệuSkrape
Skrape là một API trích xuất dữ liệu web được hỗ trợ bởi LLM, được thiết kế để biến bất kỳ trang web nào thành dữ liệu sạch, có cấu trúc và sẵn sàng cho LLM. Nó đơn giản hóa việc trích xuất dữ liệu bằng cách chuyển đổi các trang web thành JSON có cấu trúc hoặc markdown sạch, lý tưởng cho việc huấn luyện AI, hệ thống RAG và phân tích dữ liệu. Với các tính năng như xử lý nội dung động và thu thập thông minh, Skrape cung cấp một giải pháp đáng tin cậy cho các nhà phát triển và doanh nghiệp để tự động hóa các quy trình thu thập dữ liệu của họ.
Cào dữ liệuFoxscrape
FoxScrape là một API REST cào dữ liệu web được hỗ trợ bởi AI dành cho các nhà phát triển. Nó đơn giản hóa việc trích xuất dữ liệu bằng cách chuyển đổi bất kỳ trang web nào thành dữ liệu JSON có cấu trúc bằng các tính năng như phân tích cú pháp do AI điều khiển từ tiếng Anh đơn giản, kết xuất JavaScript cho các trang web động và xoay vòng proxy tự động để ngăn chặn việc bị chặn.
Trích xuất Dữ liệu
Scrapeless
Một bộ công cụ cào web được hỗ trợ bởi AI dành cho các nhà phát triển và doanh nghiệp. Nó cung cấp một bộ công cụ bao gồm Trình duyệt Cào web, API Cào web Toàn cầu và API SERP Chuyên sâu để dễ dàng trích xuất dữ liệu web công khai ở quy mô lớn. Nó chuyên về việc vượt qua các biện pháp chống bot, cung cấp dữ liệu có cấu trúc cho thương mại điện tử, nghiên cứu thị trường và đào tạo mô hình AI, với trọng tâm là độ tin cậy và dễ sử dụng.
Cào dữ liệu
URLtoText
URLtoText là một công cụ hỗ trợ bởi AI giúp trích xuất văn bản sạch, có cấu trúc từ bất kỳ trang web hoặc tệp PDF nào. Nó thông minh loại bỏ quảng cáo, thanh bên và các nội dung lộn xộn khác để chỉ cung cấp nội dung chính. Với tính năng kết xuất JavaScript, proxy IP dân cư và API cho nhà phát triển, nó được thiết kế cho các nhà nghiên cứu, nhà phát triển và doanh nghiệp cần trích xuất dữ liệu đáng tin cậy từ cả trang web tĩnh và động.
Tuyển chọn nội dung
Jyek
Jyek là một nền tảng AI agent hiểu mục tiêu, tạo kế hoạch thực thi, sử dụng công cụ và cung cấp kết quả có thể xác minh cho các tác vụ phức tạp nhiều bước.
Tự động hóa
Apify
Apify là một nền tảng tự động hóa và trích xuất dữ liệu web toàn diện (full-stack) cho phép các nhà phát triển xây dựng, triển khai và xuất bản các công cụ trích xuất dữ liệu, được gọi là 'Actors'. Nền tảng này cung cấp một thị trường rộng lớn các công cụ trích xuất dữ liệu dựng sẵn cho các trang web phổ biến như Google Maps, Instagram và TikTok, cùng với một cơ sở hạ tầng đám mây mạnh mẽ để tạo ra các giải pháp tùy chỉnh. Với sự hỗ trợ cho Python và JavaScript, các thư viện mã nguồn mở và tích hợp liền mạch, Apify đơn giản hóa việc thu thập dữ liệu web ở mọi quy mô.
Thu thập Dữ liệu
CapSolver
CapSolver là một dịch vụ giải CAPTCHA tự động được hỗ trợ bởi AI, được thiết kế cho các nhà phát triển và chuyên gia RPA. Nó cung cấp một giải pháp có độ chính xác cao, nhanh chóng và có thể mở rộng để vượt qua các loại CAPTCHA khác nhau, bao gồm reCAPTCHA, hCaptcha và FunCaptcha, tạo điều kiện cho việc cào web, trích xuất dữ liệu và tự động hóa quy trình một cách liền mạch.
Trích xuất Dữ liệu
WebScraping.AI
WebScraping.AI là một API nâng cao dành cho nhà phát triển giúp đơn giản hóa việc cào dữ liệu web bằng AI. Nó có các proxy xoay vòng, kết xuất JavaScript và nhắm mục tiêu theo địa lý để vượt qua các rào cản và truy cập nội dung động. Sức mạnh cốt lõi của nó nằm ở các công cụ được hỗ trợ bởi LLM, có thể trích xuất dữ liệu phi cấu trúc, tạo tóm tắt và trả lời câu hỏi trực tiếp từ các trang web, hợp lý hóa việc thu thập dữ liệu cho bất kỳ dự án nào.
Trích xuất Dữ liệu
AgentQL
AgentQL là một bộ công cụ dành cho nhà phát triển giúp kết nối LLM và các agent AI với web. Nó sử dụng ngôn ngữ truy vấn được hỗ trợ bởi AI để trích xuất dữ liệu có cấu trúc một cách mạnh mẽ và tự động hóa các tương tác web, đóng vai trò là một giải pháp thay thế mạnh mẽ, tự phục hồi cho các bộ chọn XPath và CSS dễ hỏng.
LLM
Crawleo
Một API hai trong một mạnh mẽ cho các hệ thống AI, cung cấp tìm kiếm web thời gian thực và thu thập dữ liệu sâu. Nó cung cấp dữ liệu có cấu trúc, sẵn sàng cho AI (JSON, Markdown) từ bất kỳ trang web nào, vượt qua các biện pháp chống bot và đảm bảo quyền riêng tư với chính sách không lưu giữ dữ liệu nghiêm ngặt. Được thiết kế cho các quy trình RAG, LLM và tự động hóa.
Truy xuất dữ liệu
Jsonify
Jsonify là một nền tảng do AI cung cấp được thiết kế cho các doanh nghiệp tự động tìm, trích xuất và cấu trúc dữ liệu từ các tài liệu và nguồn web khác nhau thành định dạng JSON sạch. Nó hợp lý hóa quy trình xử lý dữ liệu, loại bỏ việc nhập thủ công và cho phép tích hợp liền mạch thông qua API mạnh mẽ của nó.
Phân tích dữ liệu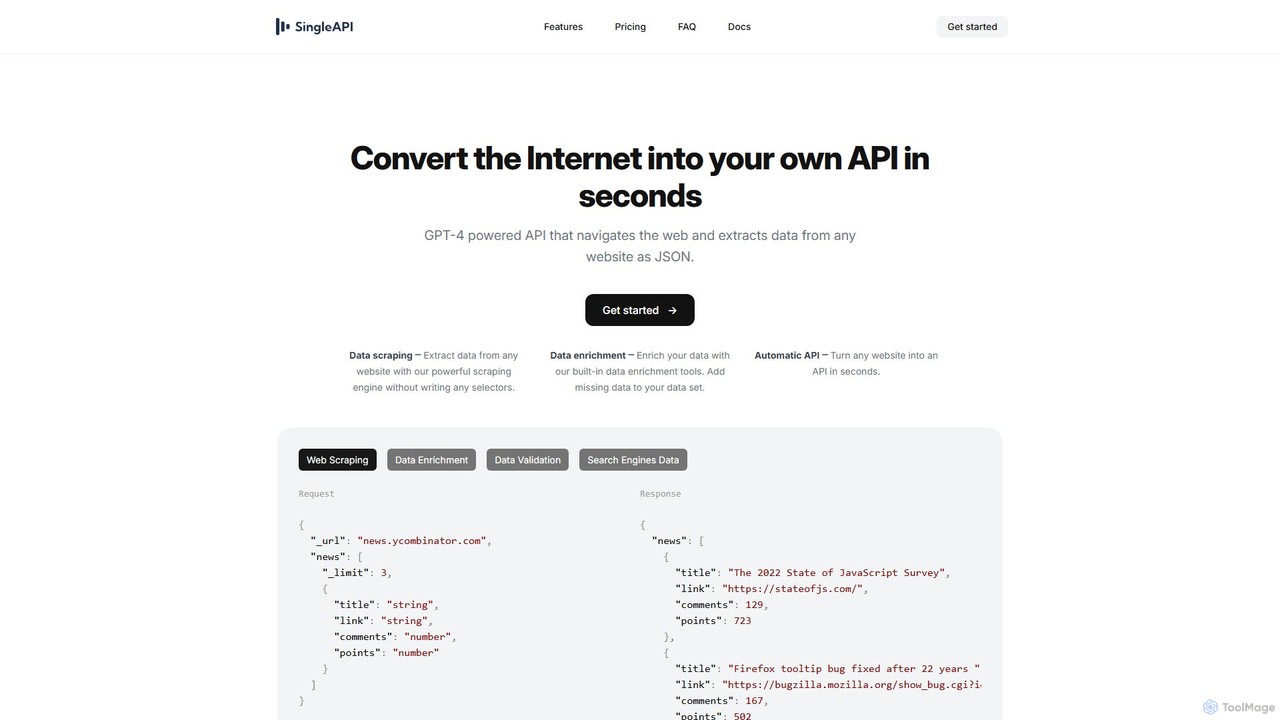
SingleAPI
SingleAPI là một công cụ được hỗ trợ bởi GPT-4, có khả năng chuyển đổi tức thì bất kỳ trang web nào thành một API JSON có cấu trúc. Nó đơn giản hóa việc cào web, trích xuất dữ liệu và làm giàu dữ liệu mà không cần viết bất kỳ mã lệnh hay bộ chọn nào, cho phép người dùng dễ dàng truy cập dữ liệu web cho các ứng dụng khác nhau.
Cào dữ liệu web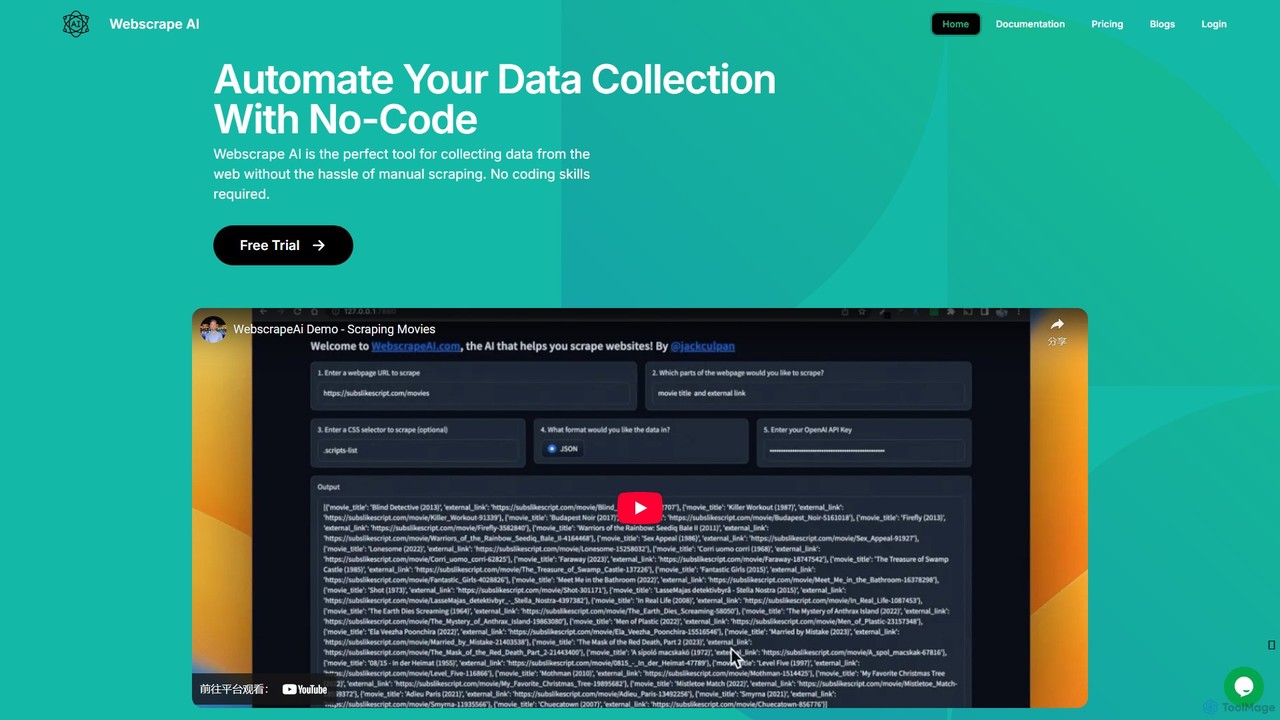
webscrapeai
WebscrapeAI là một nền tảng không cần mã, được hỗ trợ bởi AI, được thiết kế để tự động hóa việc thu thập dữ liệu web. Chỉ cần cung cấp URL và chỉ định dữ liệu bạn cần, AI sẽ xử lý toàn bộ quá trình cào dữ liệu. Nó hỗ trợ các trang web động, cào hàng loạt, tích hợp proxy và cung cấp API cho nhà phát triển, giúp việc trích xuất dữ liệu nhanh chóng, chính xác và dễ tiếp cận với mọi người.
Cào dữ liệu web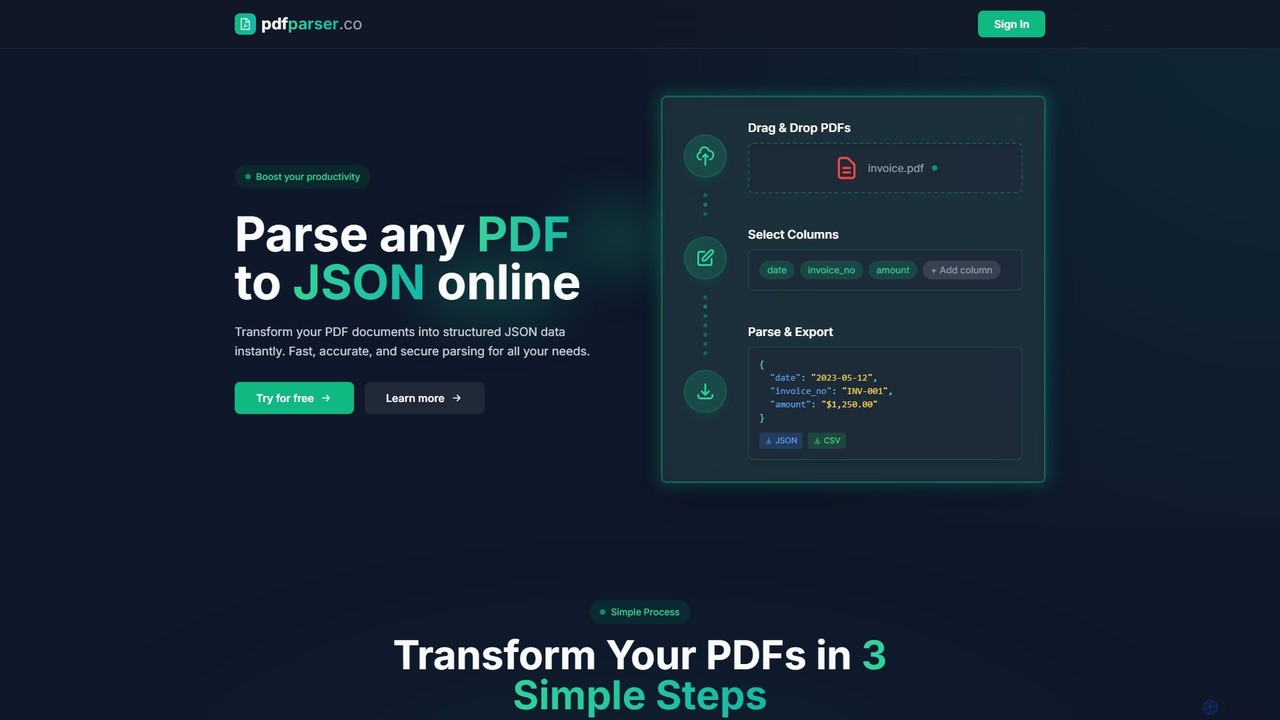
pdfparser
Một dịch vụ API được hỗ trợ bởi AI, được thiết kế cho các nhà phát triển và doanh nghiệp để phân tích cú pháp tài liệu PDF một cách dễ dàng. Nó trích xuất văn bản, bảng biểu và dữ liệu có cấu trúc từ bất kỳ tệp PDF nào, bao gồm cả các tệp được quét, và trả về đầu ra JSON sạch, có thể đọc được bằng máy, tự động hóa quy trình trích xuất dữ liệu.
Tự động hóa
Webcrawlerapi Comments (0)
Sign in to comment.
Đăng nhậpNo comments yet.