ToolMage
Đăng nhập

Best 46 Cào dữ liệu web AI tools for Dữ liệu

Popular Cào dữ liệu web AI tools in Dữ liệu include Firecrawl, Bright Data, Oxylabs, Browse AI, Browserbase, Octoparse, Zyte, UpRock, BrowserAct và Simplescraper, helping you work more efficiently.

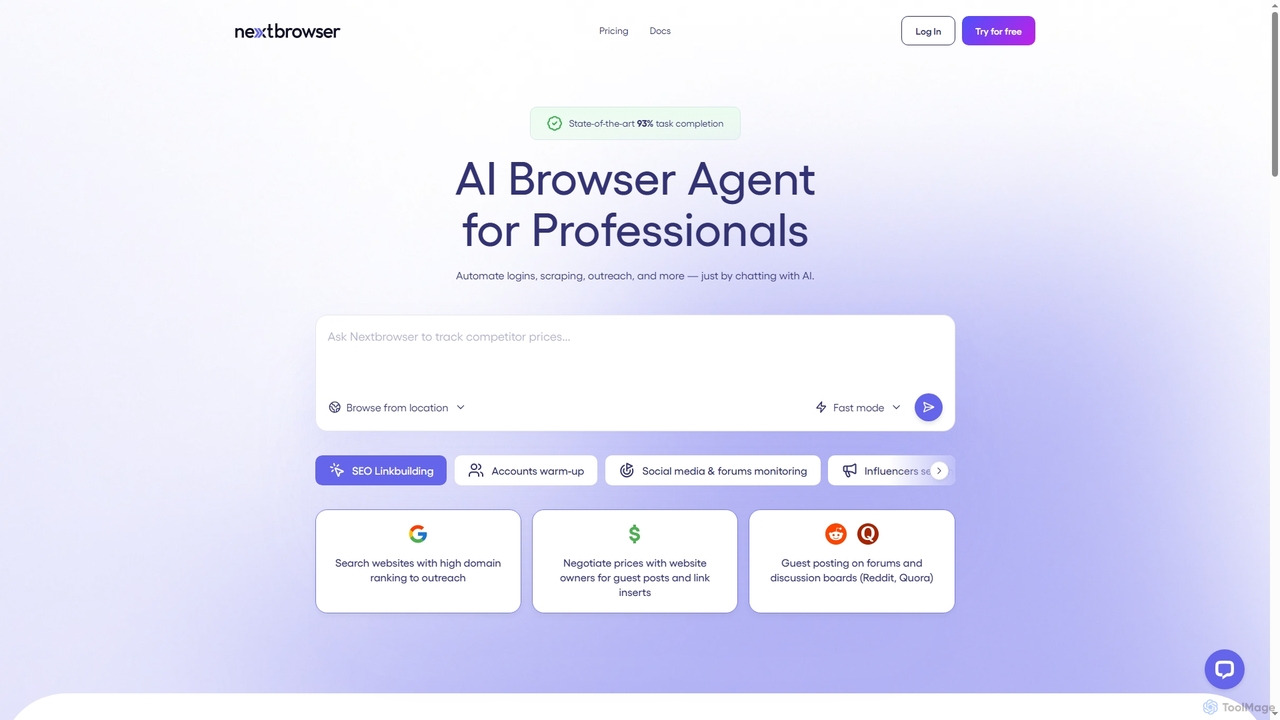
Nextbrowser
Freemium

Nextbrowser

Nextbrowser là một tác nhân trình duyệt được hỗ trợ bởi AI, được thiết kế cho các chuyên gia bán hàng và tiếp thị. Nó tự động hóa các tác vụ web phức tạp như đăng nhập, cạo dữ liệu, xây dựng liên kết SEO và tiếp cận người ảnh hưởng thông qua các lệnh trò chuyện đơn giản. Hoạt động trên đám mây với tương tác giống con người và kiểm soát địa lý, nó hợp lý hóa các quy trình làm việc lặp đi lặp lại, quản lý nhiều tài khoản và lên lịch tác vụ, tăng đáng kể hiệu quả và giảm chi phí vận hành.

Tự động hóa bán hàng
Visits 9.3KFavorites 134Likes 142
Nsocks
Paid

Nsocks

Nsocks là nhà cung cấp dịch vụ proxy chuyên nghiệp cung cấp một kho lưu trữ khổng lồ với hơn 80 triệu IP dân cư trên 195+ quốc gia. Nó cung cấp các proxy dân cư, tĩnh và không giới hạn ổn định, tốc độ cao cho việc trích xuất dữ liệu, nghiên cứu thị trường, xác minh quảng cáo và quản lý mạng xã hội, đảm bảo tính ẩn danh cao và tỷ lệ thành công 99,95%.

Cào dữ liệu web
Visits 30.4KFavorites 123Likes 149
Octoparse
Freemium

Octoparse

Octoparse là một công cụ cào dữ liệu web không cần code mạnh mẽ, cho phép bất kỳ ai cũng có thể trích xuất dữ liệu từ các trang web mà không cần lập trình. Nó có trình thiết kế quy trình làm việc trực quan, trợ lý AI để thiết lập dễ dàng và hàng trăm mẫu dựng sẵn cho các trang web phổ biến. Với tự động hóa dựa trên đám mây, xoay vòng IP và giải CAPTCHA, Octoparse xử lý các tác vụ cào dữ liệu phức tạp một cách hiệu quả, biến các trang web thành dữ liệu có cấu trúc để tạo khách hàng tiềm năng, nghiên cứu thị trường, v.v.

Cào dữ liệu web
Visits 254.9KFavorites 149Likes 141
PandaExtract
Paid

PandaExtract

PandaExtract là tiện ích mở rộng cào web không cần code tối ưu cho Chrome. Nó cho phép các chuyên gia trích xuất dữ liệu từ bất kỳ trang web nào chỉ bằng một cú nhấp chuột. Lý tưởng cho nghiên cứu thị trường, tạo khách hàng tiềm năng, theo dõi giá và phân tích đối thủ cạnh tranh, không yêu cầu kỹ năng lập trình.

Cào dữ liệu web
Visits 6.4KFavorites 103Likes 131
TaskMagic
Freemium

TaskMagic

TaskMagic là một công cụ Tự động hóa Quy trình bằng Robot (RPA) không cần mã, cho phép bạn tự động hóa bất kỳ tác vụ nào trên web. Ghi lại các cú nhấp chuột và thao tác gõ phím của bạn để tạo các quy trình làm việc mạnh mẽ cho việc trích xuất dữ liệu web, nhập liệu và quản lý mạng xã hội mà không cần viết một dòng mã nào. Nó đơn giản hóa các hành động lặp đi lặp lại trên trình duyệt, giúp bạn tiết kiệm thời gian và công sức.

Cào dữ liệu web
Visits 6.7KFavorites 123Likes 146
Zyte
Freemium

Zyte

Zyte là một nền tảng web scraping toàn diện cung cấp API full-stack và dịch vụ trích xuất dữ liệu. Nó đơn giản hóa việc thu thập dữ liệu bằng cách quản lý proxy, trình duyệt không đầu và các hệ thống chống chặn tiên tiến. Được hỗ trợ bởi AI, Zyte cung cấp dữ liệu web đáng tin cậy, có cấu trúc ở quy mô lớn cho các doanh nghiệp trong lĩnh vực thương mại điện tử, nghiên cứu thị trường, v.v.

Thông tin thị trường
Visits 209.1KFavorites 112Likes 115
UpRock
Free

UpRock

UpRock là một Mạng lưới Cơ sở hạ tầng Vật lý Phi tập trung (DePIN) cho phép người dùng kiếm thu nhập tiền điện tử thụ động bằng cách chia sẻ băng thông internet không sử dụng của họ. Mạng lưới do con người cung cấp này cung cấp dữ liệu thời gian thực, không bị kiểm duyệt để thúc đẩy sự đổi mới AI và các dịch vụ web khác nhau.

DePIN
Visits 131.2KFavorites 112Likes 106
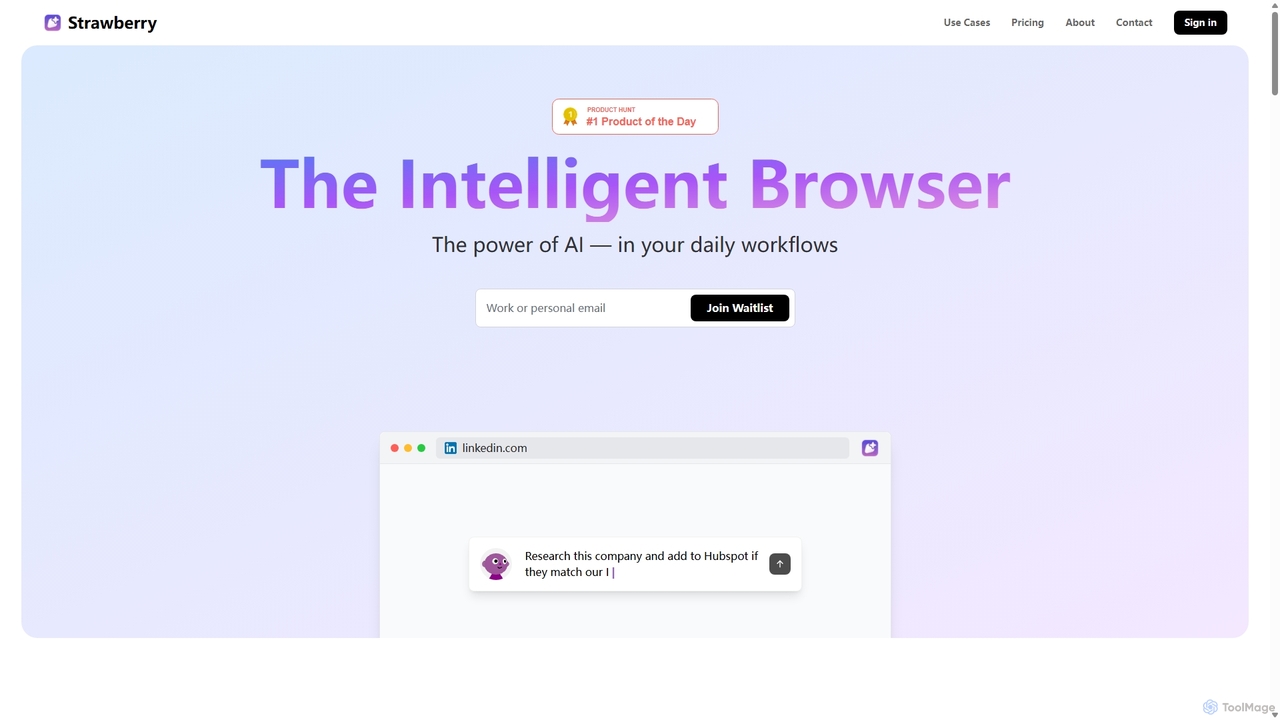
Strawberry Browser
Freemium

Strawberry Browser

Strawberry Browser là một trình duyệt thông minh, được hỗ trợ bởi AI, được thiết kế để tự động hóa quy trình làm việc hàng ngày của bạn. Nó cho phép bạn xây dựng một đội ngũ trợ lý AI có thể tùy chỉnh để xử lý các tác vụ lặp đi lặp lại như nghiên cứu, trích xuất dữ liệu và tạo khách hàng tiềm năng ngay trong trình duyệt của bạn. Loại bỏ công việc nhàm chán, tập trung và nâng cao năng suất của bạn.

Trợ lý AI
Visits 66.4KFavorites 129Likes 111
Browse AI
Freemium

Browse AI

Browse AI là một nền tảng không cần mã lệnh cho phép người dùng trích xuất và giám sát dữ liệu từ bất kỳ trang web nào. Dễ dàng huấn luyện một robot để cào thông tin, biến các trang web thành bảng tính hoặc API, và tự động theo dõi các thay đổi. Nó được thiết kế cho các nhà tiếp thị, nhà nghiên cứu và nhà phát triển để tự động hóa việc thu thập dữ liệu mà không cần viết bất kỳ mã lệnh nào, cung cấp các robot dựng sẵn và tích hợp liền mạch với các công cụ như Google Sheets và Zapier.

Cào dữ liệu web
Visits 348.6KFavorites 170Likes 164
Simplescraper
Freemium

Simplescraper

Simplescraper là một công cụ cào web mạnh mẽ giúp trích xuất dữ liệu từ bất kỳ trang web nào trong vài giây. Nó cung cấp một tiện ích mở rộng Chrome thân thiện với người dùng để chọn dữ liệu không cần mã, tự động hóa dựa trên đám mây để cào dữ liệu quy mô lớn và tính năng AI Enhance sáng tạo để lấy thông tin chi tiết bằng các câu lệnh đơn giản. Biến các trang web thành dữ liệu có cấu trúc (CSV, JSON) hoặc API tức thì và tích hợp với các công cụ như Google Sheets và Airtable.

Cào dữ liệu web
Visits 111.2KFavorites 122Likes 138
MrScraper
Paid

MrScraper

MrScraper là một công cụ cào dữ liệu web không cần code, được hỗ trợ bởi AI, cho phép người dùng dễ dàng trích xuất dữ liệu có cấu trúc từ bất kỳ trang web nào. Nó tự động hóa quy trình thu thập dữ liệu, vượt qua các biện pháp chống bot như CAPTCHA và chặn IP, lý tưởng cho việc thu thập thông tin giá cả, nghiên cứu thị trường và tạo khách hàng tiềm năng.

Cào dữ liệu web
Visits 40.1KFavorites 165Likes 163
PriceResonance
Paid

PriceResonance

PriceResonance là một công cụ tình báo cạnh tranh do AI cung cấp giúp đơn giản hóa việc theo dõi và phân tích giá. Nó tự động hóa việc trích xuất dữ liệu web để theo dõi chiến lược giá của đối thủ cạnh tranh trên các trang thương mại điện tử như Amazon và các nền tảng SaaS, cung cấp thông tin chi tiết hữu ích để doanh nghiệp tối ưu hóa giá cả, duy trì tính cạnh tranh và tăng thị phần.

Cào dữ liệu web
Visits 6.4KFavorites 153Likes 160
Oxylabs
Paid

Oxylabs

Oxylabs là nhà cung cấp hàng đầu về dịch vụ proxy cao cấp và các giải pháp thu thập dữ liệu web cấp doanh nghiệp. Tận dụng mạng lưới proxy khổng lồ được cung cấp một cách có đạo đức với hơn 177 triệu IP, Oxylabs cung cấp các API Scraper được hỗ trợ bởi AI, Trình mở khóa web và AI Studio mới để trích xuất dữ liệu bằng ngôn ngữ tự nhiên. Nó cho phép các doanh nghiệp thu thập dữ liệu web công khai ở quy mô lớn cho thương mại điện tử, an ninh mạng, bảo vệ thương hiệu và nghiên cứu thị trường mà không bị chặn.

Thông tin thị trường
Visits 487.5KFavorites 172Likes 171
BestProxy
Paid

BestProxy

BestProxy là nhà cung cấp dịch vụ proxy dân cư và ISP hàng đầu, cung cấp một kho IP khổng lồ với hơn 80 triệu IP có nguồn gốc hợp pháp. Dịch vụ được tối ưu hóa cho AI, thu thập dữ liệu quy mô lớn, nghiên cứu thị trường và quản lý nhiều tài khoản, nổi bật với tốc độ cao, thời gian hoạt động 99,99%, yêu cầu đồng thời không giới hạn và nhắm mục tiêu địa lý chính xác.

Cào dữ liệu web
Visits 77.2KFavorites 140Likes 129
Scrapybara
Freemium

Scrapybara

Scrapybara là một nền tảng dành cho nhà phát triển cung cấp máy tính để bàn ảo dựa trên đám mây cho các tác nhân AI. Nó cho phép tạo và mở rộng các tác nhân thực hiện các tác vụ máy tính phức tạp bằng cách tương tác với giao diện người dùng đồ họa (GUI) giống như con người. Nền tảng cung cấp các phiên bản máy tính để bàn tức thì, có thể mở rộng (Ubuntu, Windows) với SDK cho Python và TypeScript, hỗ trợ các mô hình như CUA của OpenAI.

Tự động hóa quy trình bằng robot
Visits 14.4KFavorites 149Likes 164
Bright Data
Paid

Bright Data

Bright Data là nền tảng dữ liệu web hàng đầu thế giới, cung cấp một bộ công cụ toàn diện bao gồm mạng proxy, trình thu thập dữ liệu web do AI hỗ trợ và các bộ dữ liệu sẵn sàng sử dụng. Nó cho phép các doanh nghiệp thu thập lượng lớn dữ liệu web công khai để huấn luyện AI, nghiên cứu thị trường và tình báo cạnh tranh.

Kinh doanh thông minh
Visits 817.3KFavorites 112Likes 115
Import.io
Freemium

Import.io

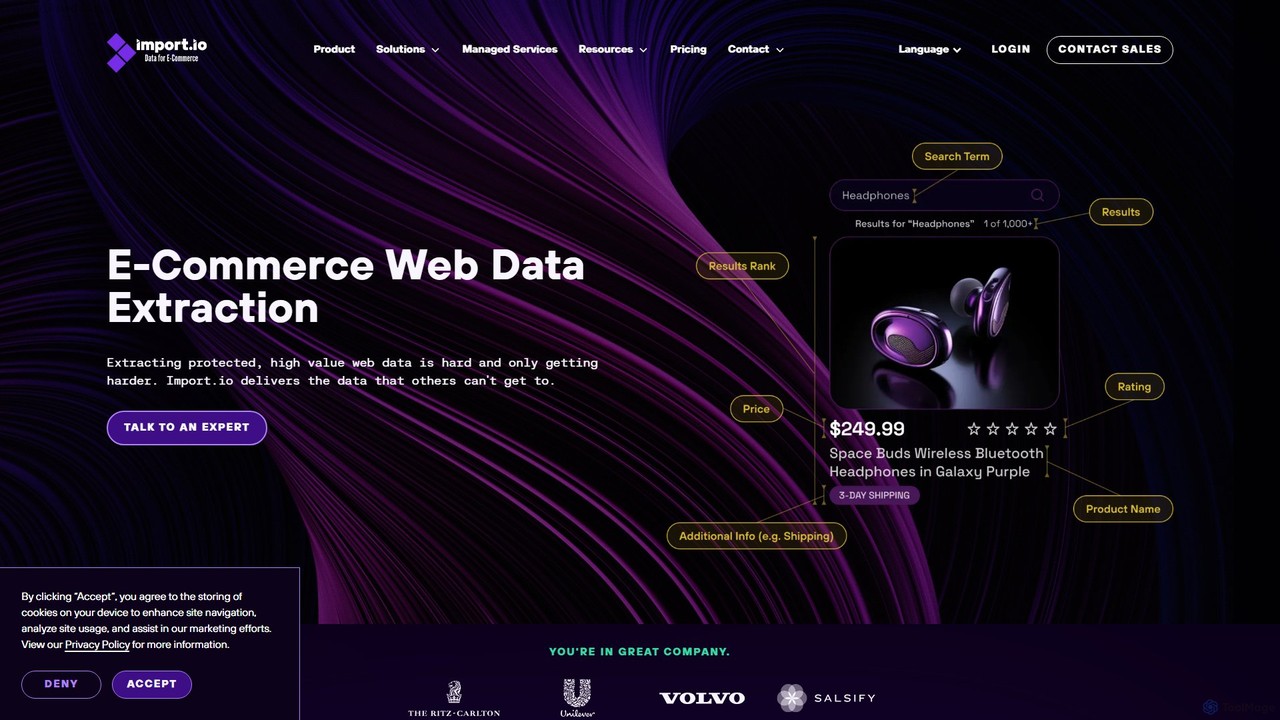
Import.io là một nền tảng trích xuất dữ liệu web cấp doanh nghiệp, cung cấp dữ liệu có cấu trúc, chất lượng cao từ bất kỳ trang web nào. Nền tảng này cung cấp cả dịch vụ được quản lý hoàn toàn và giải pháp tự phục vụ để cung cấp thông tin tình báo thị trường thương mại điện tử, giám sát thương hiệu và ra quyết định kinh doanh dựa trên dữ liệu, vượt qua các công nghệ chống cào dữ liệu phức tạp.

Thông tin thị trường
Visits 42.5KFavorites 140Likes 130
webscrapeai
Freemium

webscrapeai

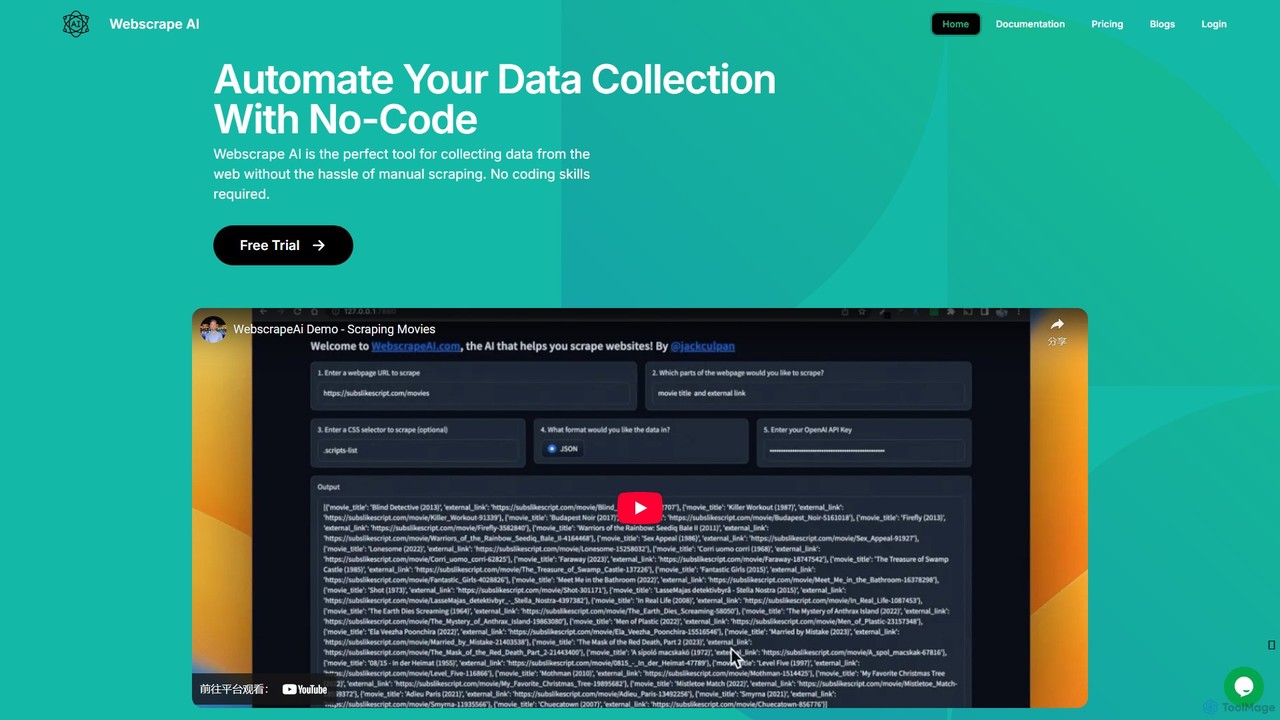
WebscrapeAI là một nền tảng không cần mã, được hỗ trợ bởi AI, được thiết kế để tự động hóa việc thu thập dữ liệu web. Chỉ cần cung cấp URL và chỉ định dữ liệu bạn cần, AI sẽ xử lý toàn bộ quá trình cào dữ liệu. Nó hỗ trợ các trang web động, cào hàng loạt, tích hợp proxy và cung cấp API cho nhà phát triển, giúp việc trích xuất dữ liệu nhanh chóng, chính xác và dễ tiếp cận với mọi người.

Cào dữ liệu web
Visits 6.9KFavorites 126Likes 155
BulkGPT
Freemium

BulkGPT

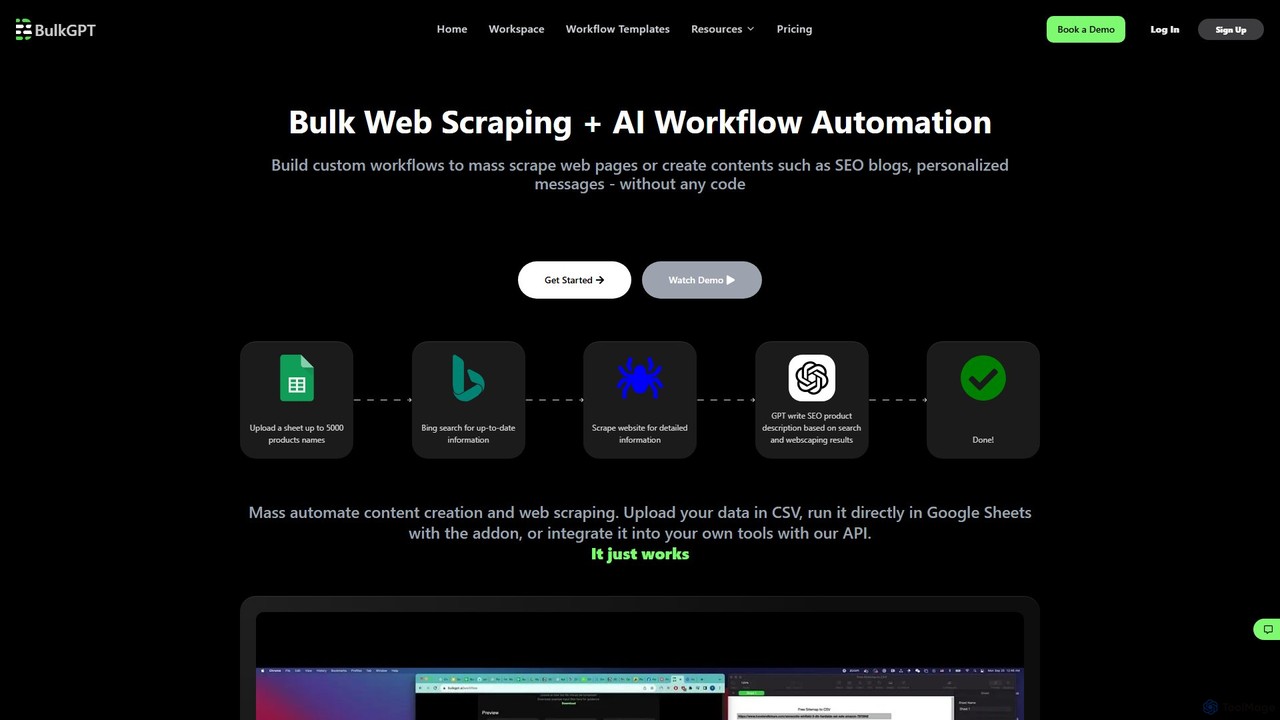
BulkGPT là một nền tảng tự động hóa quy trình làm việc AI không cần mã, cho phép người dùng thực hiện trích xuất dữ liệu web hàng loạt, tạo nội dung quy mô lớn và xử lý hàng loạt các tác vụ AI. Nó tích hợp với CSV, Google Sheets và API để hợp lý hóa các tác vụ lặp đi lặp lại cho tiếp thị, thương mại điện tử và phân tích dữ liệu mà không cần kiến thức lập trình.

Cào dữ liệu web
Visits 7.3KFavorites 146Likes 146
Goover
Freemium

Goover

Goover là một đại lý nghiên cứu AI tiên tiến, tự động hóa toàn bộ quy trình thu thập, phân tích và tổng hợp thông tin. Nó biến các câu hỏi phức tạp và dữ liệu web rải rác thành các báo cáo và bản tóm tắt có cấu trúc, sâu sắc, giúp người dùng tiết kiệm thời gian và đưa ra quyết định sáng suốt.

Cào dữ liệu web
Visits 77.8KFavorites 166Likes 161
No-Code Scraper
Freemium

No-Code Scraper

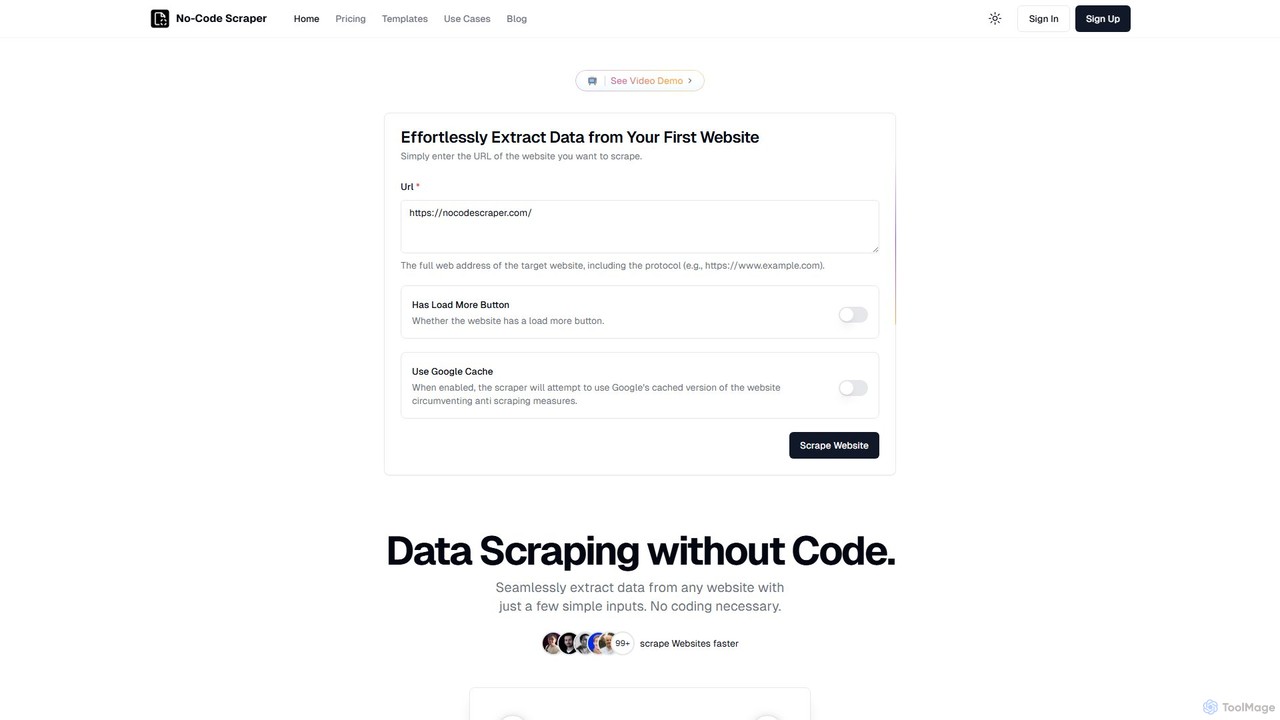
No-Code Scraper là một nền tảng được hỗ trợ bởi AI cho phép người dùng trích xuất dữ liệu từ bất kỳ trang web nào mà không cần viết một dòng mã nào. Nó sử dụng các mô hình ngôn ngữ lớn để tự động hóa việc trích xuất, làm sạch và cấu trúc dữ liệu, giúp việc cào web trở nên dễ tiếp cận, đáng tin cậy và hiệu quả cho mọi người.

Cào dữ liệu web
Visits 9.7KFavorites 158Likes 147
Firecrawl
Freemium

Firecrawl

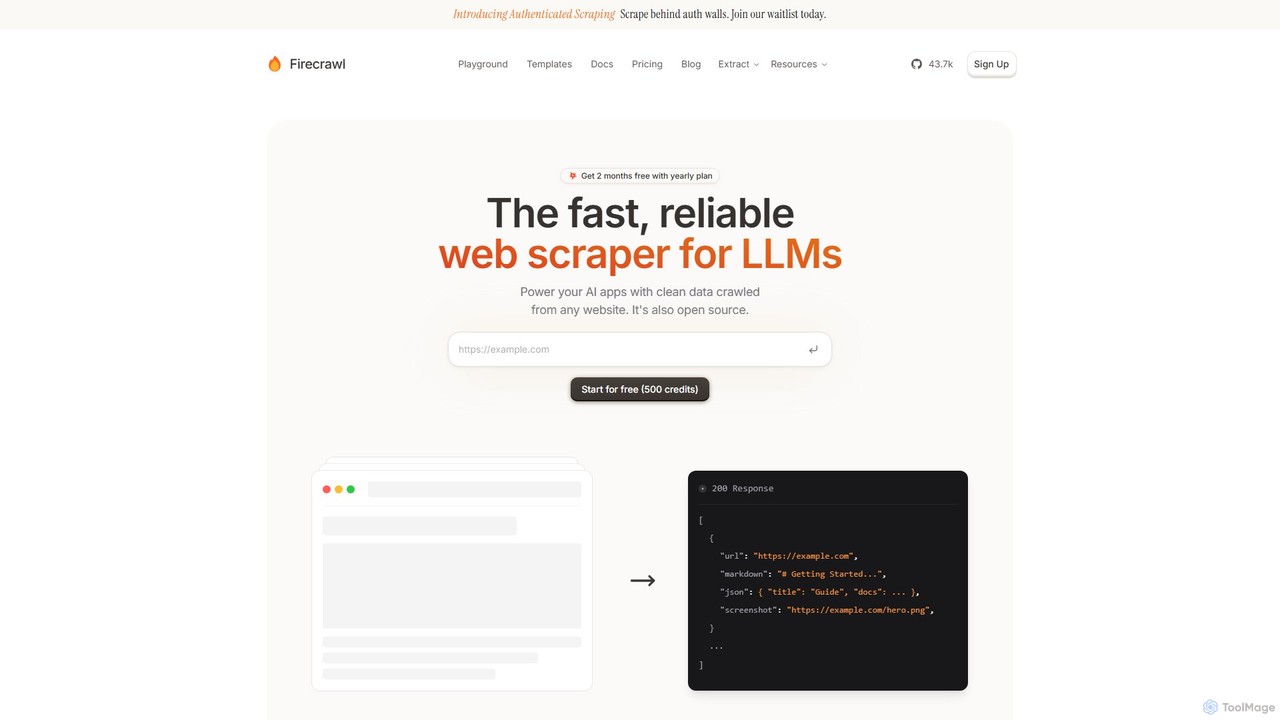
Firecrawl là một API mã nguồn mở, ưu tiên nhà phát triển, giúp biến bất kỳ trang web nào thành dữ liệu sạch, sẵn sàng cho LLM. Nó xử lý mọi sự phức tạp của việc cào dữ liệu web, bao gồm kết xuất JavaScript, xoay vòng proxy và giới hạn tốc độ, cho phép bạn cung cấp năng lượng cho các ứng dụng AI, tác tử và hệ thống RAG bằng nội dung web đáng tin cậy. Nó cung cấp các chức năng cào, thu thập thông tin và tìm kiếm thông qua một API đơn giản.

Thu thập dữ liệu
Visits 1.5MFavorites 145Likes 142
Crawly
Freemium

Crawly

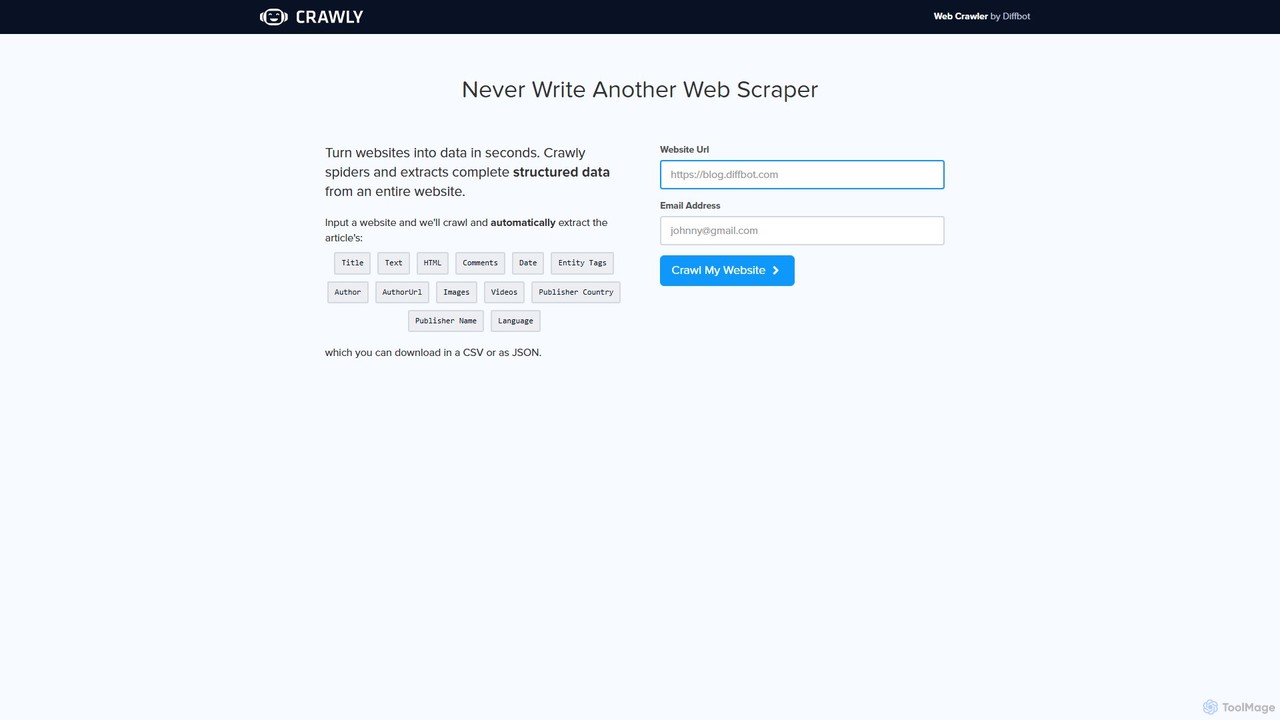
Crawly là một trình thu thập thông tin web do AI cung cấp bởi Diffbot, tự động trích xuất dữ liệu có cấu trúc từ toàn bộ trang web. Chỉ cần nhập URL, Crawly sẽ quét trang web để lấy thông tin chính như bài viết, sản phẩm và thảo luận, chuyển đổi chúng thành dữ liệu JSON hoặc CSV sạch mà không cần viết mã.

Cào dữ liệu web
Visits 8.3KFavorites 120Likes 127
SingleAPI
Freemium

SingleAPI

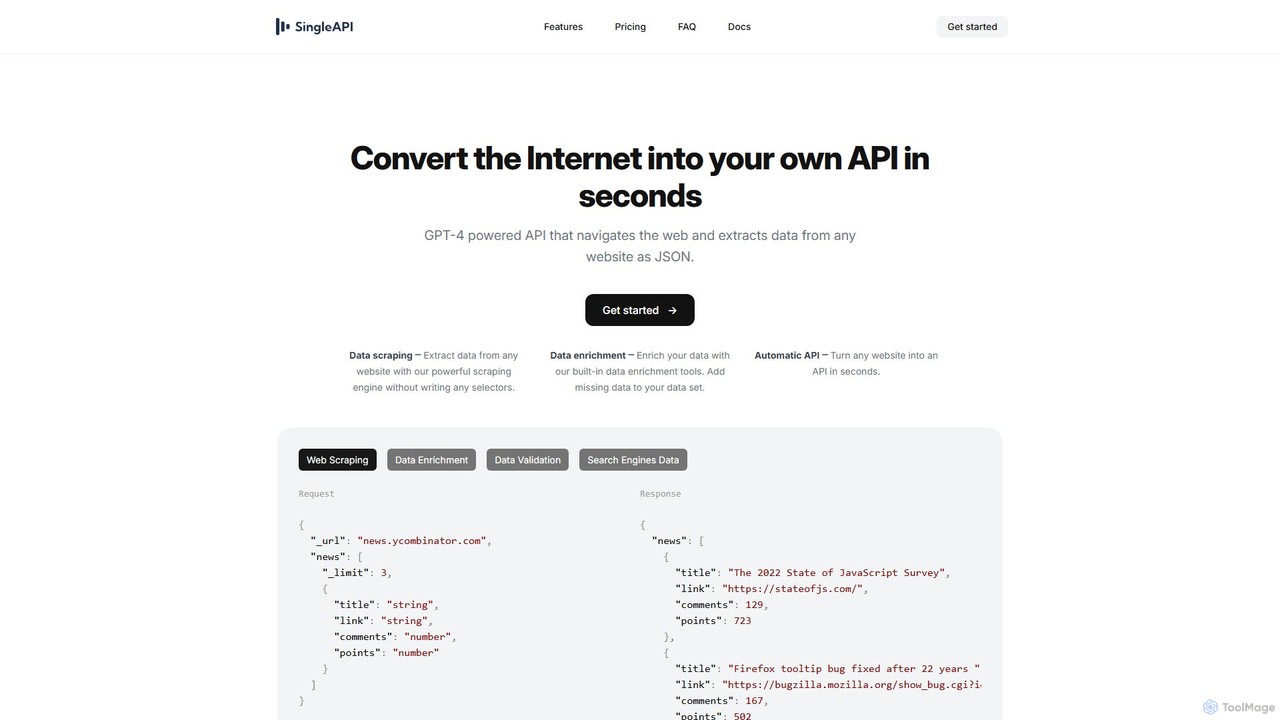
SingleAPI là một công cụ được hỗ trợ bởi GPT-4, có khả năng chuyển đổi tức thì bất kỳ trang web nào thành một API JSON có cấu trúc. Nó đơn giản hóa việc cào web, trích xuất dữ liệu và làm giàu dữ liệu mà không cần viết bất kỳ mã lệnh hay bộ chọn nào, cho phép người dùng dễ dàng truy cập dữ liệu web cho các ứng dụng khác nhau.

Cào dữ liệu web
Visits 6.9KFavorites 162Likes 167

About Cào dữ liệu web

Công cụ AI Web Scraping là các ứng dụng được thiết kế để tự động trích xuất lượng lớn dữ liệu từ các trang web. Chúng tận dụng AI để điều hướng các cấu trúc trang phức tạp, xử lý các biện pháp chống cào dữ liệu như CAPTCHA và phân tích HTML phi cấu trúc thành các định dạng có cấu trúc như JSON hoặc CSV. Điều này cho phép các doanh nghiệp và nhà nghiên cứu thu thập dữ liệu thị trường thời gian thực, theo dõi đối thủ cạnh tranh và tổng hợp thông tin mà không cần can thiệp thủ công. AI tăng cường khả năng cào dữ liệu truyền thống bằng cách thích ứng với các thay đổi của trang web và diễn giải bố cục trực quan để thu thập dữ liệu mạnh mẽ hơn.

Tính Năng Cốt Lõi

  • Trích xuất dữ liệu tự động: Tự động thu thập văn bản, hình ảnh, giá cả và các điểm dữ liệu được chỉ định khác từ các trang web trên quy mô lớn.
  • Phân tích cú pháp bằng AI: Nhận dạng và cấu trúc hóa một cách thông minh các trường dữ liệu từ các bố cục phức tạp, ngay cả khi cấu trúc HTML thay đổi.
  • Vượt qua cơ chế chống Bot: Sử dụng các kỹ thuật như xoay vòng proxy, giả lập user-agent và giải CAPTCHA để tránh bị phát hiện và chặn.
  • Cào dữ liệu theo lịch trình: Cho phép người dùng thiết lập các công việc lặp lại để thu thập dữ liệu mới theo các khoảng thời gian đều đặn (ví dụ: hàng ngày, hàng giờ).
  • Xuất và Tích hợp Dữ liệu: Xuất dữ liệu đã thu thập sang nhiều định dạng khác nhau (CSV, JSON, Excel) và tích hợp với các ứng dụng khác thông qua API hoặc webhook.

Trường Hợp Sử Dụng

Các công cụ này được sử dụng rộng rãi trong thương mại điện tử để theo dõi giá cả, trong tiếp thị để tạo khách hàng tiềm năng, trong tài chính để thu thập dữ liệu thay thế và trong bất động sản để phân tích thị trường. Ví dụ, một nhà phân tích bán lẻ có thể sử dụng công cụ cào dữ liệu web AI để theo dõi giá cả và mức tồn kho của hàng trăm sản phẩm cạnh tranh hàng ngày, đưa dữ liệu này trực tiếp vào các mô hình định giá của họ.

Cách Lựa Chọn

Khi chọn một công cụ, hãy xem xét khả năng xử lý các trang web động, có nhiều JavaScript và khả năng chống lại các công nghệ chống cào dữ liệu. Đánh giá giao diện người dùng—liệu bạn cần một giải pháp không cần mã, chỉ cần trỏ và nhấp hay một API mạnh mẽ hơn dành cho nhà phát triển. Ngoài ra, hãy đánh giá khả năng mở rộng của nó để trích xuất lượng lớn dữ liệu và sự phù hợp của mô hình định giá với tần suất sử dụng và nhu cầu dữ liệu của bạn.

Featured tool rankings

Cào dữ liệu web use cases

1

Theo dõi Giá và Tồn kho trong Thương mại điện tử

Một người quản lý thương mại điện tử cần duy trì giá cả cạnh tranh cho hàng nghìn sản phẩm. Họ sử dụng một công cụ cào dữ liệu web AI để tự động quét các trang web của đối thủ cạnh tranh vài giờ một lần. Công cụ này xác định các trang sản phẩm, trích xuất giá hiện tại, tình trạng tồn kho và các ưu đãi khuyến mại, sau đó cấu trúc dữ liệu này vào một bảng điều khiển. Quy trình tự động này thay thế hàng giờ kiểm tra thủ công, cho phép người quản lý điều chỉnh chiến lược giá của riêng mình gần như trong thời gian thực, phản ứng với tình trạng hết hàng và tối đa hóa cơ hội bán hàng.

2

Tạo Khách hàng Tiềm năng từ Danh bạ Trực tuyến

Một nhân viên phát triển kinh doanh (SDR) được giao nhiệm vụ xây dựng danh sách khách hàng tiềm năng trong một ngành cụ thể. Thay vì duyệt thủ công các danh bạ doanh nghiệp trực tuyến hoặc mạng lưới chuyên nghiệp, SDR cấu hình một công cụ cào dữ liệu web để nhắm mục tiêu vào các trang web này. Công cụ này trích xuất tên công ty, email liên hệ, số điện thoại và chức danh của những người ra quyết định chính. Danh sách có cấu trúc thu được có thể được nhập trực tiếp vào CRM, giúp SDR tiết kiệm hơn 80% thời gian tìm kiếm khách hàng và cho phép họ tập trung vào việc tiếp cận và tương tác.

3

Nghiên cứu Thị trường và Phân tích Cảm tính

Một nhà phân tích thị trường cho một thương hiệu điện tử tiêu dùng muốn hiểu cảm tính của công chúng về việc ra mắt sản phẩm mới. Họ sử dụng một công cụ cào dữ liệu web để thu thập hàng nghìn đánh giá của khách hàng từ các trang bán lẻ, blog công nghệ và nền tảng mạng xã hội. Khả năng AI của công cụ giúp phân tích văn bản phi cấu trúc để xác định các chủ đề chính (ví dụ: 'thời lượng pin', 'chất lượng màn hình') và cảm tính liên quan (tích cực, tiêu cực, trung lập). Dữ liệu tổng hợp này cung cấp một cái nhìn tổng quan toàn diện về thị trường, làm nổi bật điểm mạnh và điểm yếu của sản phẩm nhanh hơn nhiều so với phân tích thủ công hoặc khảo sát.

4

Tổng hợp Dữ liệu Thị trường Bất động sản

Một công ty đầu tư bất động sản cần thông tin cập nhật về danh sách bất động sản trên nhiều thành phố. Họ triển khai một tác nhân cào dữ liệu web để tổng hợp dữ liệu từ các cổng thông tin bất động sản khác nhau như Zillow, Redfin và các trang web của các đại lý địa phương. Công cụ cào dữ liệu trích xuất các chi tiết như địa chỉ bất động sản, giá cả, diện tích, số phòng ngủ và số ngày trên thị trường. Dữ liệu này được biên soạn vào một cơ sở dữ liệu trung tâm, cho phép các nhà phân tích xác định các bất động sản bị định giá thấp, theo dõi xu hướng thị trường và đưa ra quyết định đầu tư dựa trên dữ liệu mà không cần kiểm tra thủ công hàng chục trang web.

5

Thu thập Dữ liệu Thay thế trong Tài chính

Một nhà phân tích định lượng tại một quỹ phòng hộ tìm kiếm các nguồn dữ liệu thay thế để giành lợi thế giao dịch. Họ sử dụng một công cụ cào dữ liệu web để theo dõi và trích xuất thông tin từ các trang tin tức tài chính, hồ sơ quy định và phương tiện truyền thông xã hội về các đề cập đến cổ phiếu cụ thể. Công cụ được lên lịch chạy liên tục, nắm bắt tin tức nóng hổi và sự thay đổi trong cảm tính của công chúng trong thời gian thực. Luồng dữ liệu này sau đó được đưa vào các mô hình giao dịch thuật toán để xác định các mối tương quan và dự đoán biến động thị trường, cung cấp những hiểu biết không có sẵn thông qua các nguồn cấp dữ liệu tài chính truyền thống.

6

Tổng hợp Dữ liệu cho Nghiên cứu Học thuật

Một nhà nghiên cứu đại học đang tiến hành một phân tích tổng hợp yêu cầu dữ liệu từ hàng trăm nghiên cứu khoa học đã được công bố. Việc tìm kiếm và trích xuất thủ công các điểm dữ liệu từ tóm tắt hoặc bảng biểu của mỗi bài báo sẽ cực kỳ tốn thời gian. Nhà nghiên cứu sử dụng một công cụ cào dữ liệu web để tự động thu thập thông tin từ các cơ sở dữ liệu học thuật (như PubMed hoặc Google Scholar), xác định các bài báo liên quan dựa trên từ khóa và trích xuất thông tin cụ thể như kích thước mẫu, phương pháp luận và các phát hiện chính. Điều này tự động hóa việc tạo ra một bộ dữ liệu toàn diện, cho phép phân tích quy mô lớn mà nếu không sẽ không thực tế.

Cào dữ liệu web FAQ

AI Web Scraping là gì?

AI Web Scraping là quá trình sử dụng các công cụ tự động, được tăng cường bởi trí tuệ nhân tạo, để trích xuất dữ liệu từ các trang web. Không giống như các công cụ cào dữ liệu truyền thống dựa vào các quy tắc cố định và bộ chọn HTML, các công cụ được hỗ trợ bởi AI có thể diễn giải trực quan các trang web, hiểu các bố cục phức tạp và thích ứng với những thay đổi về cấu trúc trang. Điều này làm cho chúng linh hoạt hơn và có khả năng trích xuất dữ liệu từ các trang web động, có nhiều JavaScript và xử lý các biện pháp chống cào dữ liệu như CAPTCHA. Mục đích cốt lõi là chuyển đổi nội dung web phi cấu trúc thành dữ liệu có cấu trúc, có thể sử dụng được để phân tích.

Làm thế nào để chọn công cụ Web Scraping phù hợp?

Việc chọn công cụ phù hợp phụ thuộc vào kỹ năng kỹ thuật và độ phức tạp của dự án của bạn. Hãy xem xét các yếu tố sau:

  • Dễ sử dụng: Bạn cần một công cụ không cần mã với giao diện trực quan cho các tác vụ đơn giản, hay một API tập trung vào nhà phát triển cho các công việc cào dữ liệu phức tạp, tùy chỉnh?
  • Độ phức tạp của trang web mục tiêu: Công cụ có thể xử lý nội dung động được tải bằng JavaScript, cuộn vô hạn và yêu cầu đăng nhập không?
  • Khả năng chống lại các biện pháp chống cào dữ liệu: Nó có cung cấp các tính năng như xoay vòng proxy dân cư, giải CAPTCHA và quản lý user-agent để tránh bị chặn không?
  • Khả năng mở rộng và tốc độ: Công cụ có thể xử lý việc cào hàng nghìn hoặc hàng triệu trang một cách hiệu quả mà không gặp vấn đề về hiệu suất không?
  • Xuất và tích hợp dữ liệu: Đảm bảo nó hỗ trợ các định dạng dữ liệu bạn cần (ví dụ: CSV, JSON) và có thể tích hợp với quy trình làm việc của bạn (ví dụ: qua API, Google Sheets).
Sự khác biệt giữa Web Scraping và sử dụng API là gì?

Sự khác biệt chính nằm ở cách truy cập dữ liệu. API (Giao diện lập trình ứng dụng) là một cách có cấu trúc, chính thức để các nhà phát triển truy cập dữ liệu của một trang web. Nó được chủ sở hữu trang web cung cấp, thường ổn định và trả về dữ liệu sạch, được định dạng tốt (như JSON). Mặt khác, Web Scraping trích xuất dữ liệu trực tiếp từ mã HTML của một trang web—cùng một nội dung mà con người nhìn thấy trong trình duyệt. Cào dữ liệu được sử dụng khi một trang web không cung cấp API cho dữ liệu mong muốn. Nó dễ bị hỏng hơn, vì bất kỳ thay đổi nào đối với bố cục của trang web đều có thể làm hỏng công cụ cào dữ liệu.

Web Scraping có hợp pháp không?

Tính hợp pháp của việc cào dữ liệu web rất phức tạp và phụ thuộc vào khu vực pháp lý và dữ liệu cụ thể đang được cào. Nói chung, việc cào dữ liệu công khai không được bảo vệ bởi bản quyền hoặc các quy định về dữ liệu cá nhân thường được coi là được phép. Tuy nhiên, nó có thể vi phạm Điều khoản dịch vụ của một trang web. Điều quan trọng là phải tránh cào dữ liệu cá nhân, nội dung có bản quyền và làm quá tải máy chủ của một trang web (có thể bị coi là một cuộc tấn công từ chối dịch vụ). Luôn cào dữ liệu một cách có trách nhiệm và đạo đức. Thông tin này không phải là lời khuyên pháp lý; hãy tham khảo ý kiến của một chuyên gia pháp lý cho các tình huống cụ thể.

Công cụ Web Scraping có thể trích xuất những loại dữ liệu nào?

Hầu như bất kỳ dữ liệu nào có thể nhìn thấy trên một trang web đều có thể được trích xuất. Các ví dụ phổ biến bao gồm:

  • Dữ liệu thương mại điện tử: Tên sản phẩm, giá cả, mô tả, đánh giá, mức tồn kho.
  • Thông tin liên hệ: Tên, địa chỉ email, số điện thoại từ các danh bạ hoặc trang web của công ty.
  • Dữ liệu tài chính: Giá cổ phiếu, tin tức thị trường, báo cáo tài chính của công ty.
  • Dữ liệu bất động sản: Danh sách bất động sản, giá cả, vị trí, chi tiết về người môi giới.
  • Nội dung mạng xã hội: Bài đăng, bình luận, lượt thích, số lượng người theo dõi.
  • Tin tức và bài báo: Tiêu đề, nội dung bài báo, thông tin tác giả, ngày xuất bản.

Điều quan trọng là chuyển đổi thông tin phi cấu trúc này thành một định dạng có cấu trúc như bảng tính hoặc cơ sở dữ liệu để phân tích.