ToolMage
登录

AI 工具对比

Crawly vs SingleAPI

有什么区别,哪款更适合你?对照功能、使用方式、价格模式与流量数据,找到适合自己工作流的工具。

先看核心差异

产品概览

Crawly 产品概览

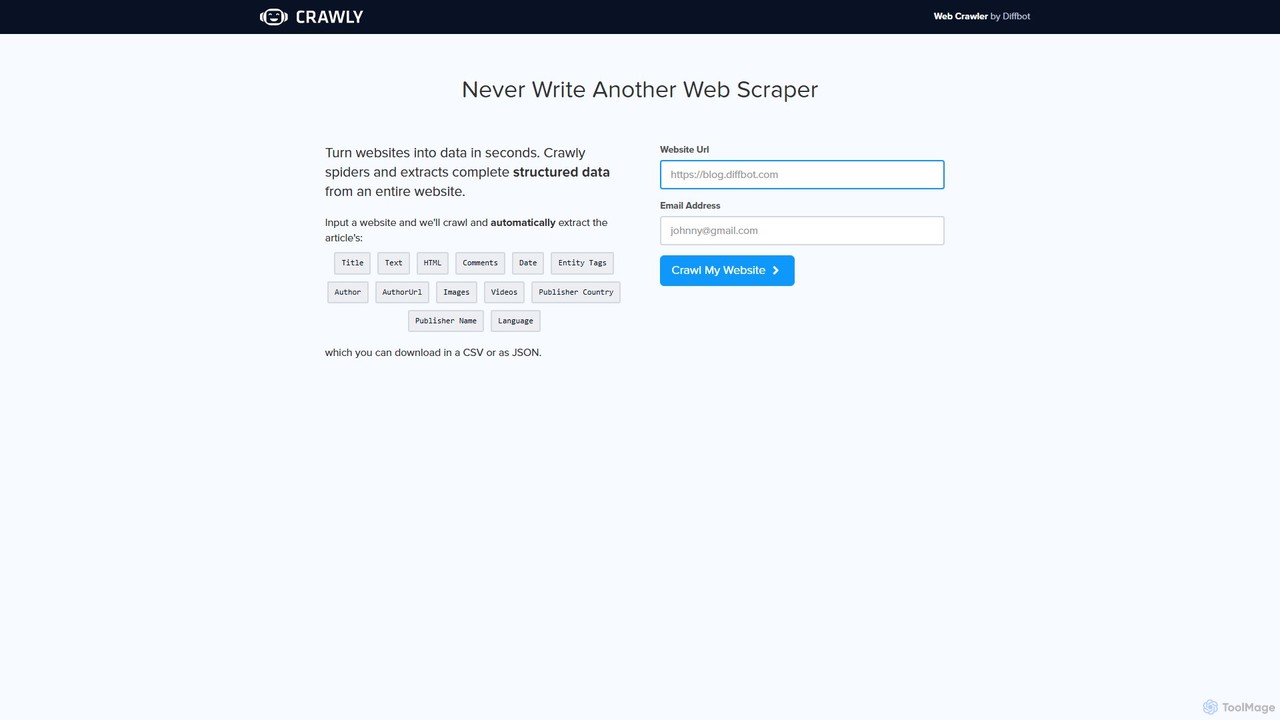
Crawly 是 Diffbot 推出的一款由人工智能驱动的网络爬虫,可自动从整个网站提取结构化数据。只需输入一个 URL,Crawly 即可抓取网站以提取文章、产品和讨论等关键信息,并将其转换为干净的 JSON 或 CSV 数据,无需任何编码。

预览图

SingleAPI 产品概览

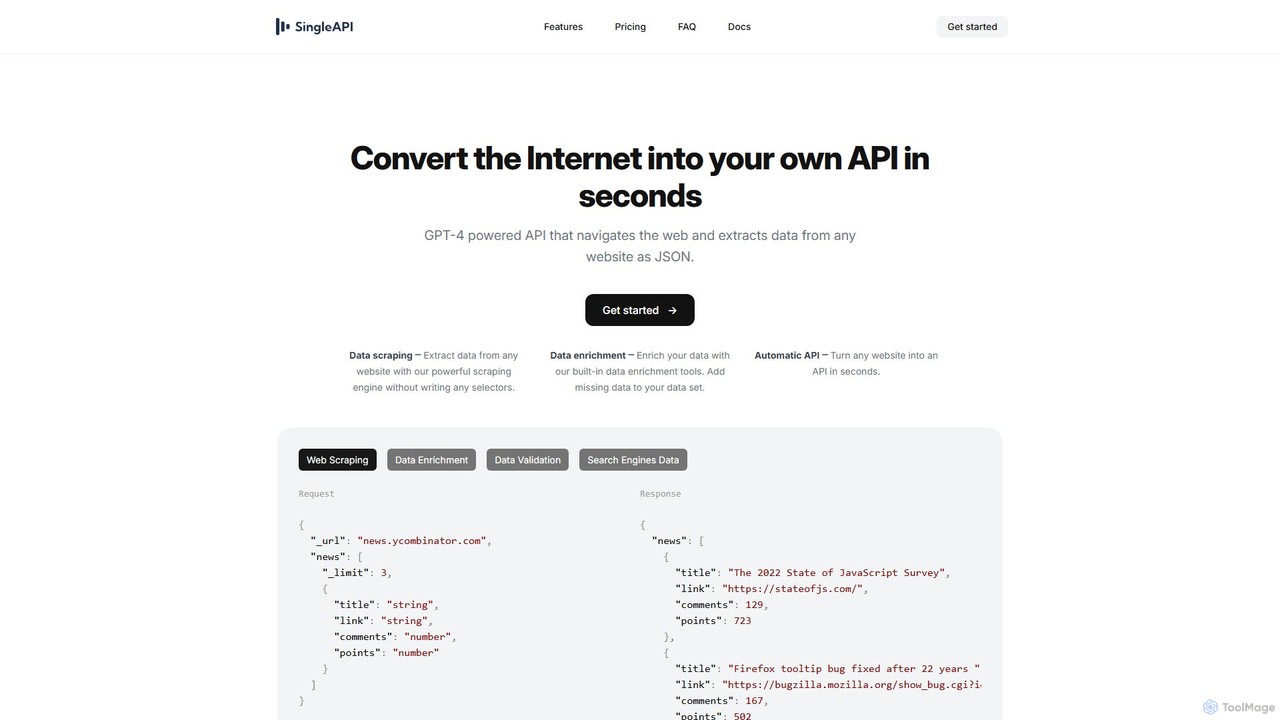
SingleAPI 是一款由 GPT-4 驱动的工具,可立即将任何网站转换为结构化的 JSON API。它简化了网页抓取、数据提取和数据丰富化过程,无需编写任何代码或选择器,让用户能轻松获取各种应用的网页数据。

预览图

核心事实

并排查看产品定位、价格模式和目标用户。浅色行表示收录资料不同;未收录价格不代表免费。

Crawly VS SingleAPI — 核心事实
核心事实CrawlySingleAPI
价格类型免费增值免费增值
产品形态网站网站
主要定位网页抓取网页抓取
受众与岗位暂无数据暂无数据
分类网页抓取 · API · 市场研究 · 自动化网页抓取 · API · 数据提取 · 自动化
收录时间:2025年8月10日2025年8月10日
更新于2026年11月19日2026年11月19日

功能、用法与应用场景

以下展示两款工具已收录的详细资料。按各自的功能和工作方式逐项阅读,不把标签当作功能评测。

Crawly

Crawly 是由人工智能数据提取领域的领导者 Diffbot 开发的一款功能强大且智能的网络爬虫。其设计初衷是彻底消除网络抓取的手动操作和技术挑战。Crawly 不依赖于编写复杂的代码或使用在网站更新后容易失效的脆弱选择器,而是利用包括计算机视觉和自然语言处理在内的先进人工智能技术,像人类一样理解和解读网页。这使其仅需一个 URL 作为输入,即可自动识别并从整个网站提取完整、结构化的数据。

Crawly 的核心承诺是“在几秒钟内将网站转化为数据”。它会在网站中导航,跟踪链接并分析每个页面的结构,以区分文章、产品、讨论和图片库等各种内容类型。提取出的数据随后被组织成干净、结构化的格式,可立即用于应用程序、数据分析或机器学习模型。

如何使用 Crawly

Crawly 的使用设计得极其简单,任何人都可以轻松上手,无论技术水平如何。整个过程仅需几个步骤:

  1. 输入 URL: 访问 Crawly 网站。在提供的输入框中,输入您希望抓取的网站的完整 URL。
  2. 提供电子邮件: 输入您的电子邮件地址。这用于在抓取完成后通知您并交付结果。
  3. 启动抓取: 点击“Crawl My Website”按钮。Crawly 的人工智能引擎将开始抓取整个网站,分析页面并提取信息。
  4. 下载数据: 过程结束后,您将收到提取的数据。您可以下载 JSON 或 CSV 等方便的结构化格式,轻松导入数据库、电子表格或其他软件中。

Crawly 的核心功能

  • AI 驱动的自动提取: 利用 Diffbot 先进的 AI 技术,自动识别并提取文章、产品、讨论等内容的数据,无需任何手动配置。
  • 全面的数据字段: 提取丰富的数据点,包括标题、文本、HTML、评论、日期、作者、作者 URL、图片、视频、发布者信息(国家、名称)和语言。
  • 实体识别: 自动识别并标记文本中的实体,如人物、组织和地点,增加了一层有价值的元数据。
  • 全站抓取: 与单页抓取工具不同,Crawly 会导航整个网站以全面收集数据。
  • 结构化数据输出: 提供干净、结构良好的 JSON 或 CSV 格式数据,无需进行后处理和数据清洗。
  • 无代码解决方案: 无需编程技能或网络抓取技术知识,使营销人员、研究人员和业务分析师也能使用。
  • 稳健且有弹性: 由于它理解内容的语义结构,因此不容易因网站布局更改而中断,这是传统抓取工具的常见问题。

Crawly 的使用案例

Crawly 是一款多功能工具,适用于广泛的应用场景:

  • 市场研究: 自动收集竞争对手的产品信息、定价、客户评论和新闻提及,以获得竞争优势。
  • 潜在客户开发: 从公司网站和在线目录中提取联系方式、公司信息和关键人员。
  • 内容聚合: 通过聚合来自多个来源的文章、博客文章和视频,构建自定义的新闻源或内容平台。
  • 机器学习数据: 为训练机器学习模型创建大型、高质量的数据集,例如对产品评论进行情感分析或对新闻文章进行趋势分析。
  • 品牌监控: 实时跟踪您的品牌、产品或高管在网络上的提及情况。

Crawly 的优势特点

Crawly 的主要优势在于其简单性和强大功能。它使网络数据提取大众化,让非开发人员也能执行通常需要工程师团队才能完成的任务。通过自动化整个抓取过程,它节省了大量的时间和资源。此外,其 AI 驱动的方法确保了比传统方法更高的准确性和更强的弹性,提供了可靠的高质量数据流。作为 Diffbot 的产品,它得到了全球各大公司信赖的企业级技术支持。

定价和计划

Crawly 在其主页上提供免费试用抓取,用户可以通过输入 URL 和电子邮件地址来测试其功能。这旨在提供该工具可以生成的结构化数据的示例。对于更广泛的需求,例如大规模抓取、频繁的数据提取或用于程序化使用的 API 访问,用户通常需要订阅其母公司 Diffbot 提供的全套工具。Diffbot 的定价是分层的,为初创公司、企业和大型企业提供不同的计划,提供不同级别的 API 调用和功能。

SingleAPI

SingleAPI 是一款革命性的工具,旨在将整个互联网转变为对开发者友好的结构化数据源。它由 GPT-4 驱动,提供了一个智能 API,能够浏览任何网站,理解其结构,并在几秒钟内将所需信息提取为干净的 JSON 格式。这消除了传统网页抓取中繁琐复杂的过程,在传统方式中,开发者需要编写和维护脆弱的选择器(如 CSS 选择器或 XPath)来定位特定的数据点。使用 SingleAPI,您只需描述所需的数据,剩下的一切都由 AI 处理。

该平台兼具简单性和强大功能,满足从个人爱好者到大型企业的广泛用户需求。无论您是需要监控竞争对手定价、聚合新闻、生成潜在客户,还是丰富现有数据集,SingleAPI 都提供了一个强大可靠的解决方案,可显著节省时间和资源。

如何使用 SingleAPI

使用 SingleAPI 非常简单。整个过程只需发送一个简单的 HTTP 请求,其 JSON 请求体中指定了目标网站和您希望提取的数据模式。然后,AI 引擎会访问该 URL,解释您的请求,在页面上找到相关数据,并以完美的结构化 JSON 响应返回。

例如,要从 Hacker News 提取前 3 篇文章,您的请求如下所示:

请求:
{
  "_url": "news.ycombinator.com",
  "news": [
    {
      "_limit": 3,
      "title": "string",
      "link": "string",
      "comments": "number",
      "points": "number"
    }
  ]
}

SingleAPI 的 AI 会理解这个结构,导航到 Hacker News,识别文章列表,并提取前三篇文章的标题、链接、评论数和点赞数,最终返回一个干净的 JSON 对象。

SingleAPI 的核心功能

  • AI 驱动的网页抓取: 利用 GPT-4 理解网页布局并提取数据,用户无需编写或管理任何选择器。
  • 自动创建 API: 立即将任何公共网站转变为功能齐全、可查询的 API。
  • 数据丰富化: 自动增强您提取的数据。例如,它可以从公司名称列表中找到社交媒体资料,或为您的数据集添加其他相关信息。
  • 灵活的数据交付: 以多种格式交付数据,包括 JSON、CSV、XML 和 Excel,以适应各种工作流程。
  • 通过 Webhooks 获取实时数据: 配置 webhooks 以在数据被抓取时立即接收,从而实现实时应用。
  • 托管代理轮换: 自动处理代理管理,以防止 IP 被封并确保数据成功检索,同时提供专用代理池选项。
  • 搜索引擎抓取: 能够直接从搜索引擎结果页面(如谷歌)抓取数据,用于 SEO 分析或市场研究。
  • 24/7 监控: 提供对爬虫的持续监控和用户仪表板,以跟踪使用情况并确保服务正常运行时间和可靠性。

SingleAPI 的使用案例

SingleAPI 的多功能性使其适用于广泛的应用场景:

  • 市场研究: 从电商网站跟踪竞争对手的定价、产品详情和客户评论。
  • 潜在客户生成: 从公司网站和专业网络中提取联系信息、公司详情和职位列表。
  • 内容聚合: 构建自定义新闻源、博客聚合器或社交媒体监控器。
  • 金融分析: 抓取股票价格、市场数据和财经新闻,用于分析和建模。
  • AI 模型训练: 从网络上收集大规模的结构化数据集,用于训练机器学习模型。

SingleAPI 的优势特点

SingleAPI 的主要优势在于其简单性和效率。它抽象了网页抓取的复杂性,例如处理动态的、重度依赖 JavaScript 的网站、管理代理和解析 HTML。这使得开发者和非开发者都能专注于使用数据,而不是获取数据。与传统抓取工具相比,其 AI 驱动的方法使其对网站布局变化的适应性更强。其灵活的数据格式和通过 webhooks 实现的实时交付,使其成为现代数据驱动型业务的强大工具。

定价和计划

SingleAPI 提供分层定价结构以满足不同需求:

  • 爱好者计划: 0美元/月。包含 100 次请求、3 个 API 端点和 24 小时数据保留。非常适合个人和测试目的。
  • 专业计划: 75美元/月。包含 5,000 次请求,超出部分每 1,000 次请求收费 10 美元。提供无限的 API 端点、30 天数据保留、优先支持和 Zapier 集成。专为企业设计。
  • 企业计划: 定制价格。专为有高请求量的大公司量身定制。包括自定义 API 诊断、99.99% 的正常运行时间 SLA、高级 24/7 聊天支持和基于 SAML 的单点登录(SSO)。

产品定位

分类与标签可以看出两款产品的重合范围,以及各自更明确的定位重点。 未知字段会明确显示,不会用推测内容补齐。

分类

共同收录
网页抓取API自动化
仅 Crawly
市场研究
仅 SingleAPI
数据提取

标签

共同收录
API自动化数据提取JSON无代码网页抓取
仅 Crawly
Diffbot潜在客户开发市场研究结构化数据网络爬虫
仅 SingleAPI
数据丰富化数据抓取开发者工具GPT-4

受众与岗位

共同收录
暂无收录项
仅 Crawly
暂无收录项
仅 SingleAPI
暂无收录项

流量对比

流量数据使用同一比例尺,避免弱化两款产品在市场可见度上的真实差距。

流量数据怎么解读

左右图表使用相同的月份与纵轴比例。各工具最新统计月份已单独标注;缺失月份保留空缺,不记为零。地区和来源的访问量是根据比例计算的估算值。

Crawly 月流量:

最新流量情况 · 2026-05

月访问量
1.8K
平均访问时长
0:31
单次访问页数
1.15
跳出率
93.85%
数据更新于 2026-06-15

月度流量趋势

  • 2025-09: 2.6K
  • 2026-01: 784
  • 2026-02: 640
  • 2026-03: 1K
  • 2026-04: 475
  • 2026-05: 1.8K

主要地区

Top 5 国家/地区
国家/地区百分比估算访问量
🇳🇬Nigeria82.43%1.5K
🇩🇪Germany9.9%177
🇨🇦Canada7.67%137

搜索关键词

crawl urlcrawlyonline web crawlerwebsite crawlerwebsite crawler online

SingleAPI 月流量:

最新流量情况 · 2026-05

月访问量
438
平均访问时长
0:00
单次访问页数
1.01
跳出率
40.53%
数据更新于 2026-06-15

月度流量趋势

  • 2025-09: 737
  • 2026-01: 0
  • 2026-02: 135
  • 2026-03: 156
  • 2026-04: 0
  • 2026-05: 438

主要地区

Top 5 国家/地区
国家/地区百分比估算访问量
🇮🇶Iraq100%438

搜索关键词

any site to apiturn website to api

社区信号

评分、评论、收藏和点赞属于社区信号,不能替代对具体使用场景的判断。

Crawly

评分
暂无数据
评论
0
收藏
162
点赞
160

SingleAPI

评分
暂无数据
评论
0
收藏
208
点赞
202

Crawly vs SingleAPI · 对比常见问题

Crawly 和 SingleAPI 有哪些共同点?
两款工具均被收录在「网页抓取、API、自动化」分类下。共同分类说明它们有部分应用方向重合;具体工作方式、功能边界和适用场景,请对照上方详细介绍。
Crawly 和 SingleAPI 是免费的吗?
当前收录的价格类型为:Crawly — 免费增值;SingleAPI — 免费增值。未收录价格不代表免费,免费增值也不代表所有功能免费。最新套餐、用量限制和试用条件请通过官网确认。
Crawly 和 SingleAPI,应该选哪款?
Crawly 的主要收录分类为「网页抓取」,SingleAPI 为「网页抓取」。先对照上方的功能、操作步骤和应用案例,再确认价格、数据权限与部署要求。此页没有进行上手实测,因此不会根据流量或标签宣称哪款更好。

资料来源与对比方法

本页由 ToolMage 已收录的产品资料、分类标签、流量统计和站内用户反馈自动整理,不是上手实测或独立评测。
  • 功能和套餐描述反映资料收录时的信息,并非实时承诺;价格、额度、可用性及隐私条款请以官网为准。
  • 流量按各自标注的月份展示;未提供统计不等于零流量,不同月份不能直接判断增长或优劣。地区和来源访问量为占比估算。
  • 标签差异只表示收录信息的差异,不代表另一款工具不支持该能力。评分、收藏和访问量不用于自动选出“赢家”。

相关对比