

Crawly 概览
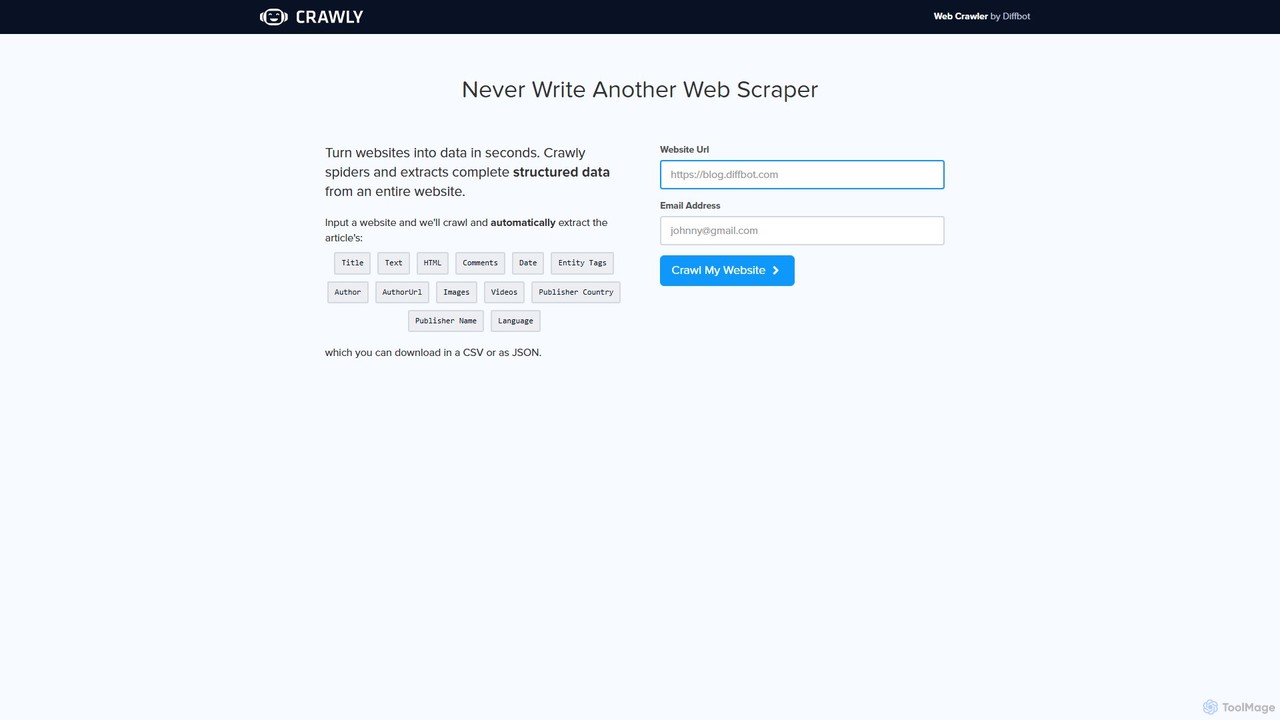
Crawly 是由人工智能数据提取领域的领导者 Diffbot 开发的一款功能强大且智能的网络爬虫。其设计初衷是彻底消除网络抓取的手动操作和技术挑战。Crawly 不依赖于编写复杂的代码或使用在网站更新后容易失效的脆弱选择器,而是利用包括计算机视觉和自然语言处理在内的先进人工智能技术,像人类一样理解和解读网页。这使其仅需一个 URL 作为输入,即可自动识别并从整个网站提取完整、结构化的数据。
Crawly 的核心承诺是“在几秒钟内将网站转化为数据”。它会在网站中导航,跟踪链接并分析每个页面的结构,以区分文章、产品、讨论和图片库等各种内容类型。提取出的数据随后被组织成干净、结构化的格式,可立即用于应用程序、数据分析或机器学习模型。
如何使用 Crawly
Crawly 的使用设计得极其简单,任何人都可以轻松上手,无论技术水平如何。整个过程仅需几个步骤:
- 输入 URL: 访问 Crawly 网站。在提供的输入框中,输入您希望抓取的网站的完整 URL。
- 提供电子邮件: 输入您的电子邮件地址。这用于在抓取完成后通知您并交付结果。
- 启动抓取: 点击“Crawl My Website”按钮。Crawly 的人工智能引擎将开始抓取整个网站,分析页面并提取信息。
- 下载数据: 过程结束后,您将收到提取的数据。您可以下载 JSON 或 CSV 等方便的结构化格式,轻松导入数据库、电子表格或其他软件中。
Crawly 的核心功能
- AI 驱动的自动提取: 利用 Diffbot 先进的 AI 技术,自动识别并提取文章、产品、讨论等内容的数据,无需任何手动配置。
- 全面的数据字段: 提取丰富的数据点,包括标题、文本、HTML、评论、日期、作者、作者 URL、图片、视频、发布者信息(国家、名称)和语言。
- 实体识别: 自动识别并标记文本中的实体,如人物、组织和地点,增加了一层有价值的元数据。
- 全站抓取: 与单页抓取工具不同,Crawly 会导航整个网站以全面收集数据。
- 结构化数据输出: 提供干净、结构良好的 JSON 或 CSV 格式数据,无需进行后处理和数据清洗。
- 无代码解决方案: 无需编程技能或网络抓取技术知识,使营销人员、研究人员和业务分析师也能使用。
- 稳健且有弹性: 由于它理解内容的语义结构,因此不容易因网站布局更改而中断,这是传统抓取工具的常见问题。
Crawly 的使用案例
Crawly 是一款多功能工具,适用于广泛的应用场景:
- 市场研究: 自动收集竞争对手的产品信息、定价、客户评论和新闻提及,以获得竞争优势。
- 潜在客户开发: 从公司网站和在线目录中提取联系方式、公司信息和关键人员。
- 内容聚合: 通过聚合来自多个来源的文章、博客文章和视频,构建自定义的新闻源或内容平台。
- 机器学习数据: 为训练机器学习模型创建大型、高质量的数据集,例如对产品评论进行情感分析或对新闻文章进行趋势分析。
- 品牌监控: 实时跟踪您的品牌、产品或高管在网络上的提及情况。
Crawly 的优势特点
Crawly 的主要优势在于其简单性和强大功能。它使网络数据提取大众化,让非开发人员也能执行通常需要工程师团队才能完成的任务。通过自动化整个抓取过程,它节省了大量的时间和资源。此外,其 AI 驱动的方法确保了比传统方法更高的准确性和更强的弹性,提供了可靠的高质量数据流。作为 Diffbot 的产品,它得到了全球各大公司信赖的企业级技术支持。
定价和计划
Crawly 在其主页上提供免费试用抓取,用户可以通过输入 URL 和电子邮件地址来测试其功能。这旨在提供该工具可以生成的结构化数据的示例。对于更广泛的需求,例如大规模抓取、频繁的数据提取或用于程序化使用的 API 访问,用户通常需要订阅其母公司 Diffbot 提供的全套工具。Diffbot 的定价是分层的,为初创公司、企业和大型企业提供不同的计划,提供不同级别的 API 调用和功能。
流量分析
最新流量情况
状态
月度流量趋势
- 2025-9: 2.6K
- 2026-1: 784
- 2026-2: 640
- 2026-3: 1.0K
- 2026-4: 475
- 2026-5: 1.8K
地理位置
Top 5 国家/地区
- 🇳🇬尼日利亚82.4%
- 🇩🇪德国9.9%
- 🇨🇦加拿大7.7%
热门关键词
| 关键词 | 每次点击费用 |
|---|---|
| crawl url | $0.00 |
| crawly | $0.00 |
| online web crawler | $0.00 |
| website crawler | $2.37 |
| website crawler online | $0.00 |
Crawly 替代方案
webscrapeai
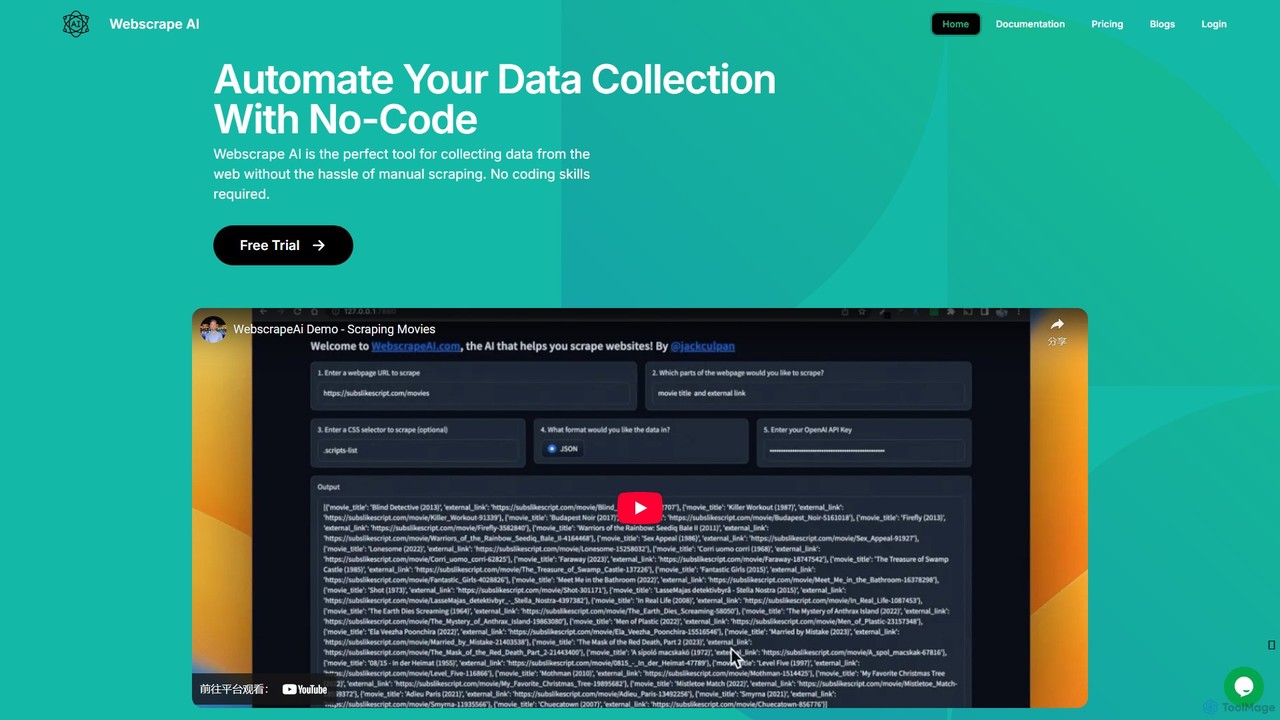
WebscrapeAI 是一个无需编码、由人工智能驱动的平台,旨在自动化网络数据收集。只需提供一个URL并指定您需要的数据,人工智能即可处理整个抓取过程。它支持动态网站、批量抓取、代理集成,并为开发人员提供API,使数据提取变得快速、准确且人人可用。
网页抓取
Simplescraper
Simplescraper 是一款功能强大的网页抓取工具,可在数秒内从任何网站提取数据。它提供了一个用户友好的 Chrome 扩展,用于无代码数据选择;基于云的自动化功能,用于大规模抓取;以及创新的 AI 增强功能,可通过简单提示获取洞察。将网站转化为结构化数据(CSV、JSON)或即时 API,并与 Google Sheets 和 Airtable 等工具集成。
网页抓取
Bright Data
Bright Data是世界领先的网络数据平台,提供包括代理网络、AI驱动的网络爬虫和即用型数据集在内的全面工具套件。它使企业能够为AI训练、市场研究和竞争情报收集海量公开网络数据。
商业智能Crawly 分类
Crawly 嵌入功能
复制这段嵌入代码,将徽章放到博客、文章或产品官网,并把读者直接引导到 ToolMage 详情页。

相关 AI 工具
webscrapeai
WebscrapeAI 是一个无需编码、由人工智能驱动的平台,旨在自动化网络数据收集。只需提供一个URL并指定您需要的数据,人工智能即可处理整个抓取过程。它支持动态网站、批量抓取、代理集成,并为开发人员提供API,使数据提取变得快速、准确且人人可用。
网页抓取Simplescraper
Simplescraper 是一款功能强大的网页抓取工具,可在数秒内从任何网站提取数据。它提供了一个用户友好的 Chrome 扩展,用于无代码数据选择;基于云的自动化功能,用于大规模抓取;以及创新的 AI 增强功能,可通过简单提示获取洞察。将网站转化为结构化数据(CSV、JSON)或即时 API,并与 Google Sheets 和 Airtable 等工具集成。
网页抓取
instantapi
instantapi 是一个由人工智能驱动的网页抓取API,专为简化和提速而设计。它允许用户通过单个API调用从任何网站提取结构化数据,无需复杂的编码或手动设置。对于需要快速、经济、可靠的数据提取而又不想处理传统网络爬虫麻烦的开发人员、数据分析师和企业来说,这是一个理想的选择。
数据提取
ScrapeGraphAI
ScrapeGraphAI 是一款由人工智能驱动的网页抓取 API,它使用简单的自然语言提示,将非结构化的网站内容转化为干净、结构化的 JSON 数据。专为开发人员、AI 代理和自动化工作流设计,无需复杂的代码即可简化数据提取。
分析

Crawly 评论 (0)
登录后发表评论。
登录暂无评论。