免费增值
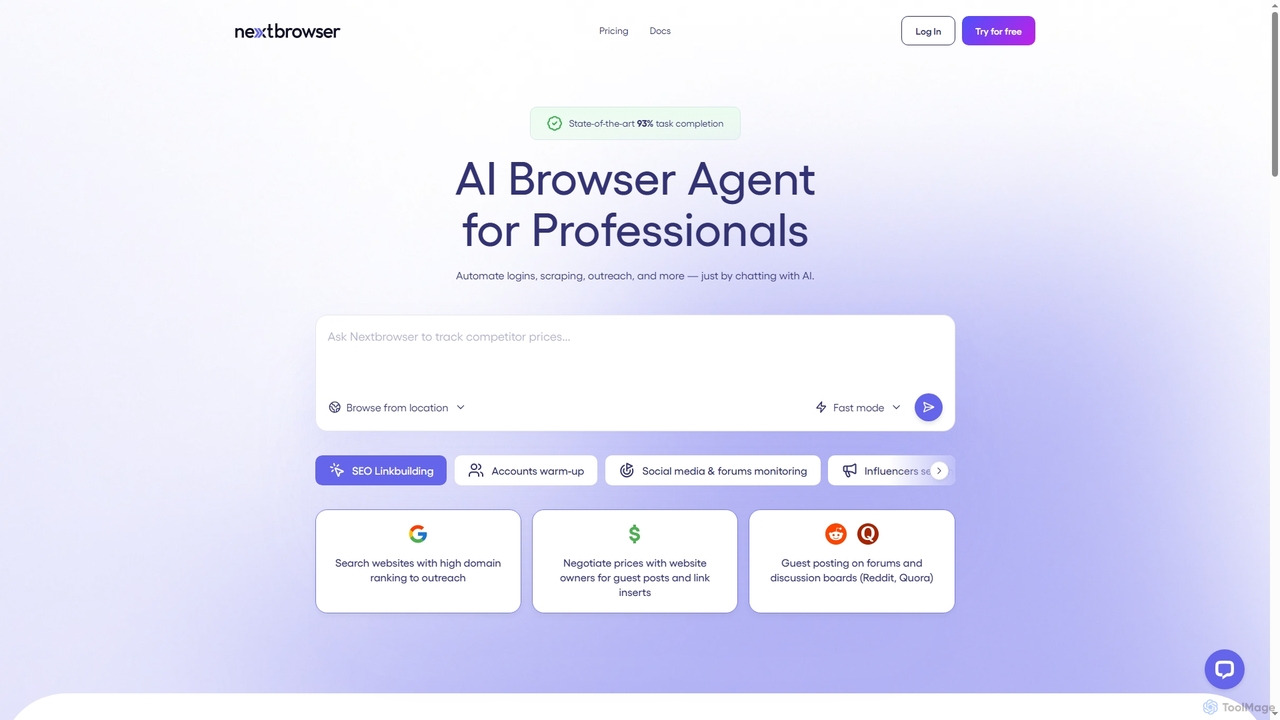
Nextbrowser
Nextbrowser是一款专为销售和营销专业人士设计的AI驱动浏览器代理。它通过简单的聊天指令,自动化复杂的网络任务,如登录、数据抓取、SEO链接建设和网红推广。Nextbrowser在云端运行,具备类人交互和地理位置控制功能,能显著提高效率,降低运营成本,简化重复性工作流程,管理多个账户并安排任务。
销售自动化Visits 10.2KFavorites 140Likes 148
数据领域的网页抓取热门 AI 工具包括 Firecrawl、Bright Data、Oxylabs、Browse AI、Browserbase、Octoparse、Zyte、UpRock、BrowserAct、Simplescraper 等,帮助您快速提升效率。
Nextbrowser是一款专为销售和营销专业人士设计的AI驱动浏览器代理。它通过简单的聊天指令,自动化复杂的网络任务,如登录、数据抓取、SEO链接建设和网红推广。Nextbrowser在云端运行,具备类人交互和地理位置控制功能,能显著提高效率,降低运营成本,简化重复性工作流程,管理多个账户并安排任务。
销售自动化
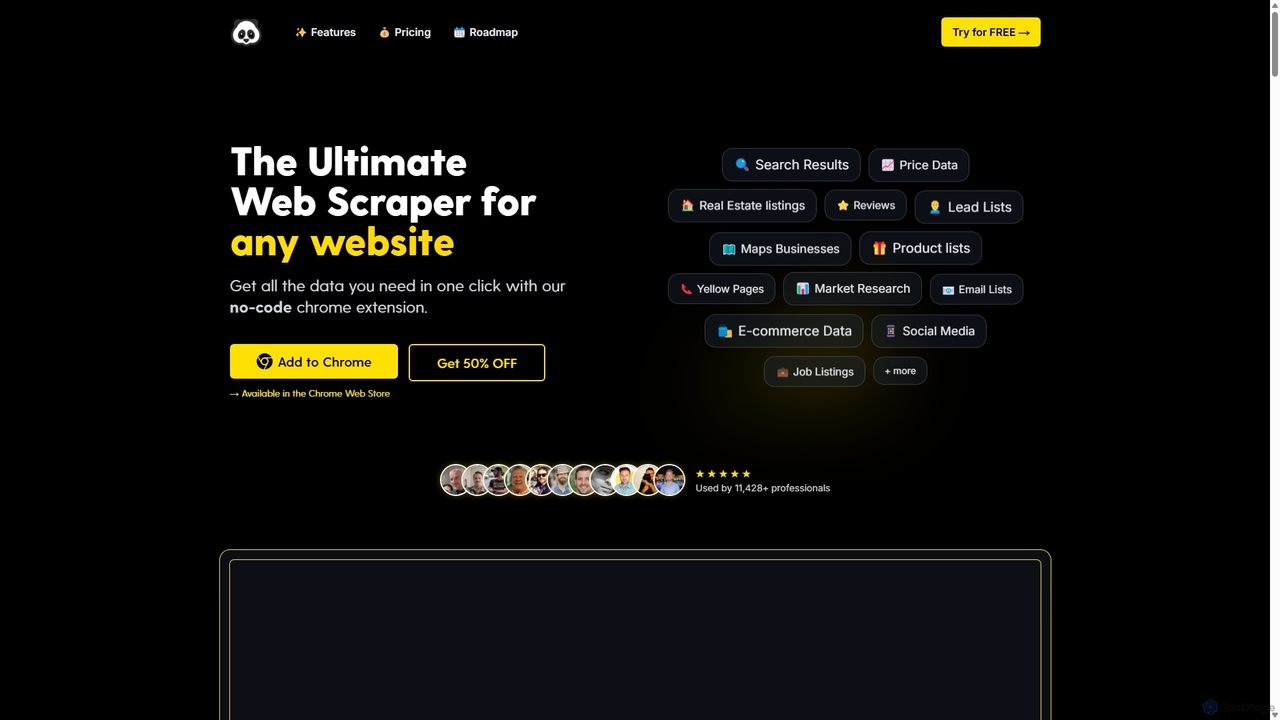
PandaExtract 是一款终极无代码网页抓取 Chrome 扩展程序。它允许专业人士一键从任何网站提取数据。该工具无需编程技能,是市场研究、潜在客户开发、价格监控和竞争对手分析的理想选择。
网页抓取
Strawberry Browser 是一款智能 AI 浏览器,旨在自动化您的日常工作流程。它允许您构建一个可定制的 AI 助手团队,直接在浏览器内处理研究、数据提取和潜在客户开发等重复性任务。消除繁琐工作,保持专注,提升您的生产力。
AI助手
Simplescraper 是一款功能强大的网页抓取工具,可在数秒内从任何网站提取数据。它提供了一个用户友好的 Chrome 扩展,用于无代码数据选择;基于云的自动化功能,用于大规模抓取;以及创新的 AI 增强功能,可通过简单提示获取洞察。将网站转化为结构化数据(CSV、JSON)或即时 API,并与 Google Sheets 和 Airtable 等工具集成。
网页抓取
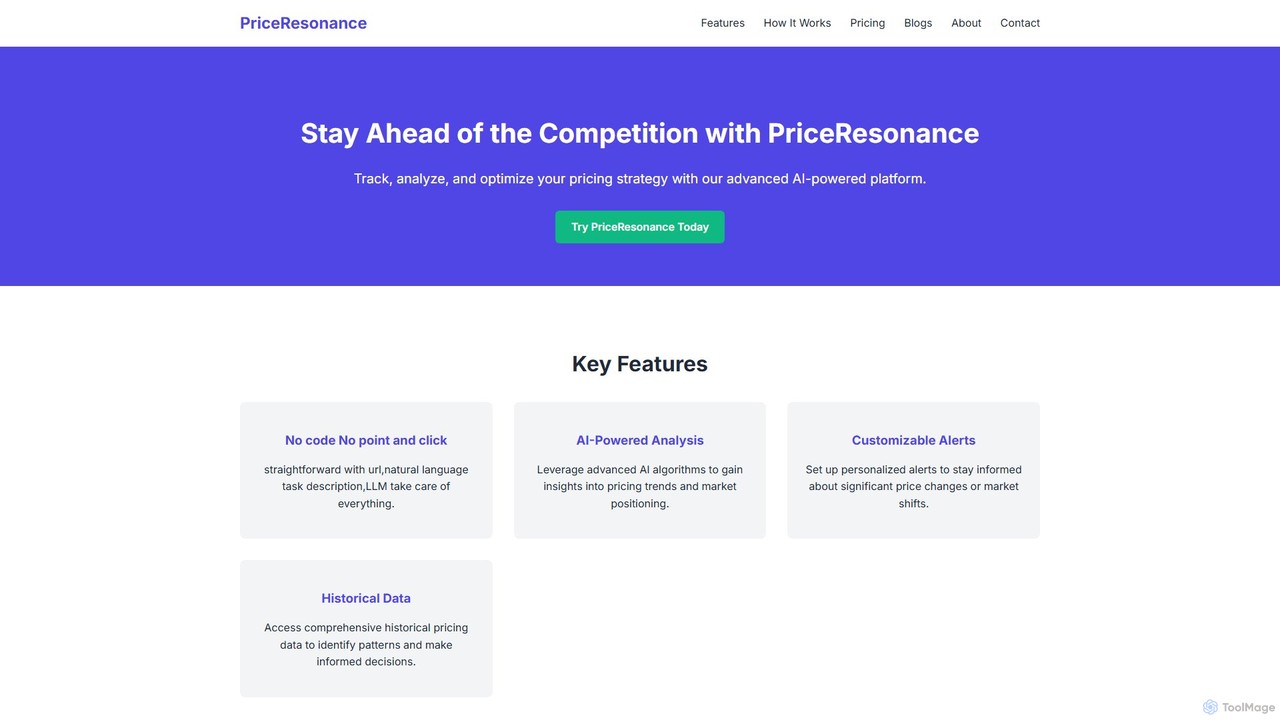
PriceResonance 是一款由人工智能驱动的竞争情报工具,可简化价格跟踪和分析。它能自动进行网络抓取,监控亚马逊等电商网站和SaaS平台的竞争对手定价策略,为企业提供可行的见解,以优化定价、保持竞争力并扩大市场份额。
网页抓取
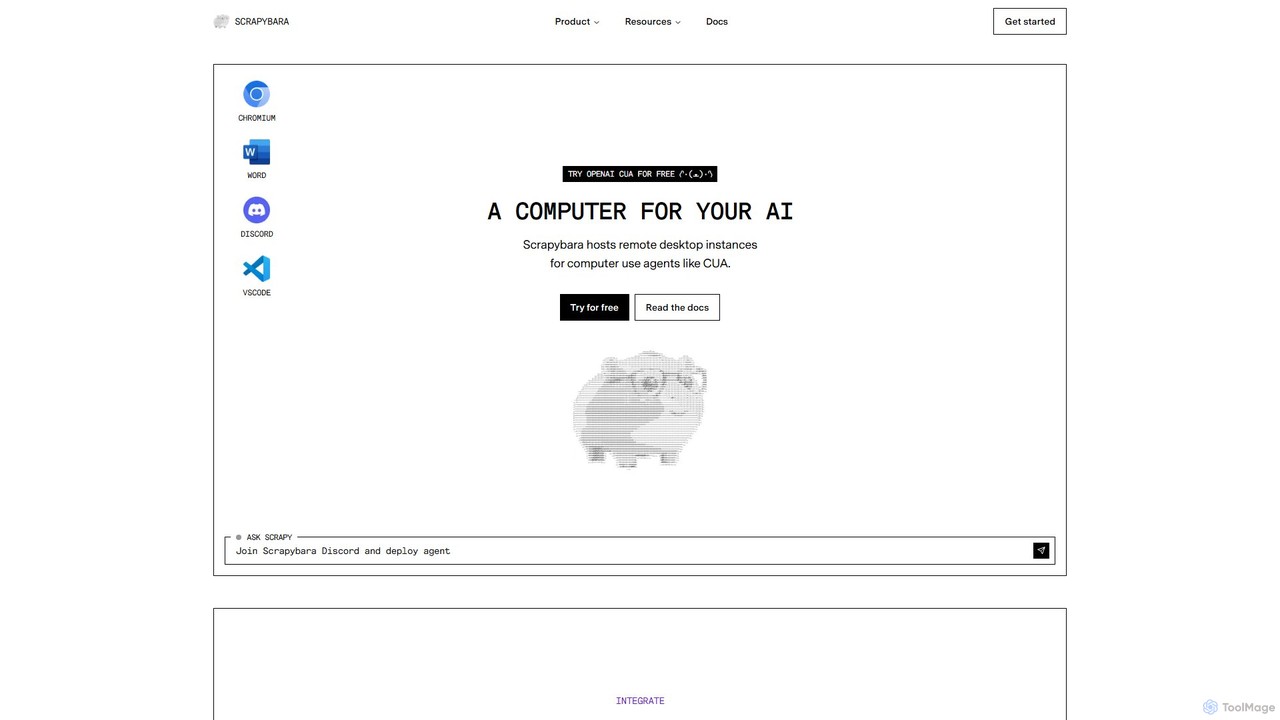
Scrapybara 是一个为 AI 代理提供云端虚拟桌面的开发者平台。它支持创建和扩展能够像人类一样通过图形用户界面(GUI)交互来执行复杂计算机任务的代理。平台提供即时、可扩展的桌面实例(Ubuntu、Windows),配备 Python 和 TypeScript 的 SDK,并支持 OpenAI CUA 等模型。
机器人流程自动化
Bright Data是世界领先的网络数据平台,提供包括代理网络、AI驱动的网络爬虫和即用型数据集在内的全面工具套件。它使企业能够为AI训练、市场研究和竞争情报收集海量公开网络数据。
商业智能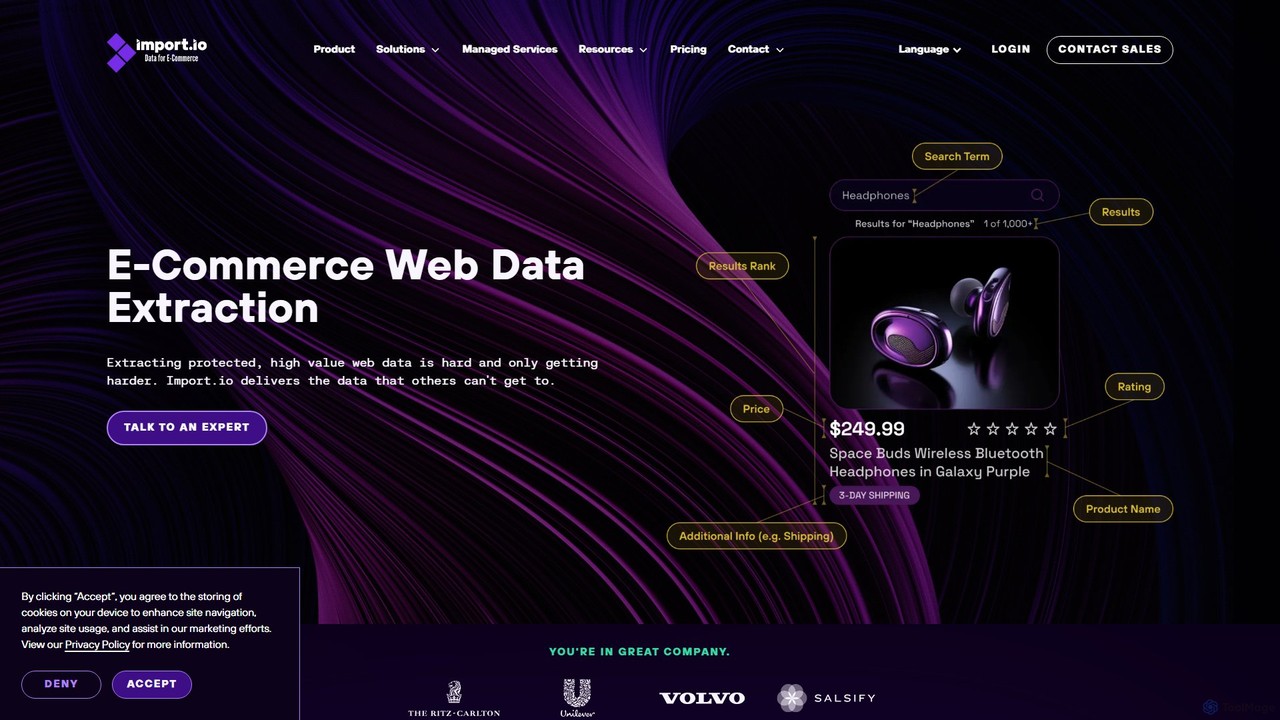
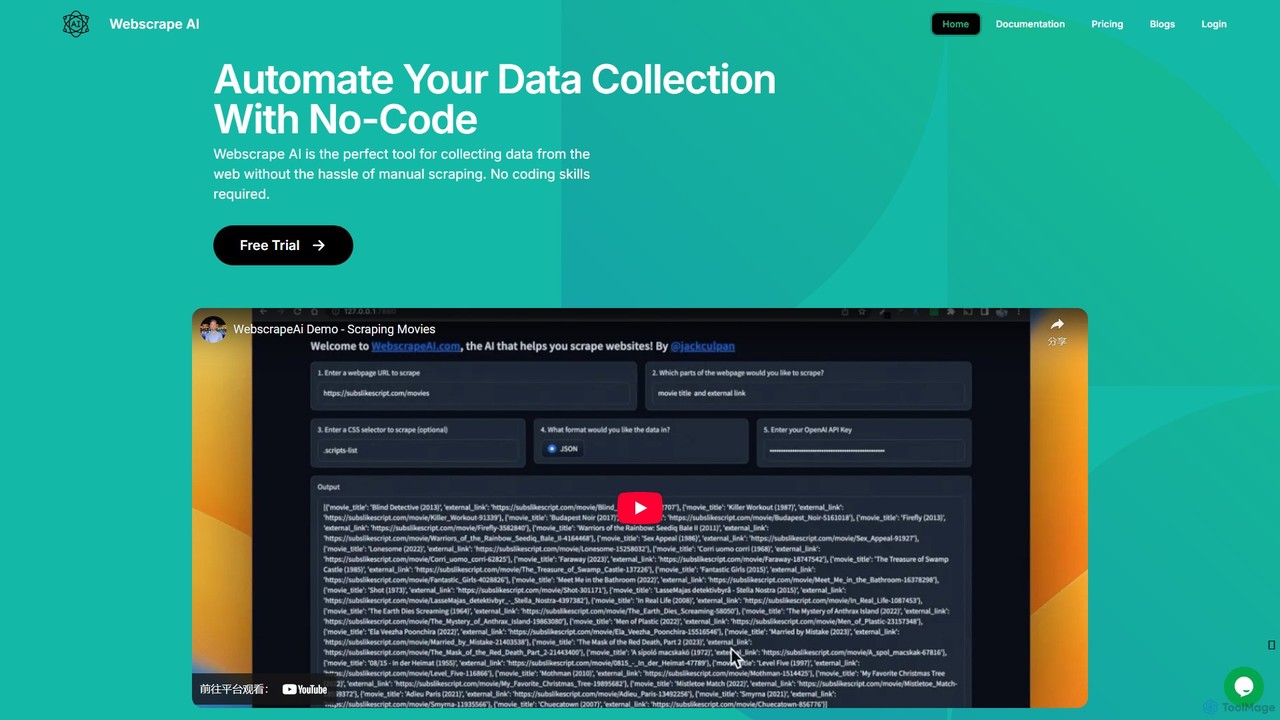
WebscrapeAI 是一个无需编码、由人工智能驱动的平台,旨在自动化网络数据收集。只需提供一个URL并指定您需要的数据,人工智能即可处理整个抓取过程。它支持动态网站、批量抓取、代理集成,并为开发人员提供API,使数据提取变得快速、准确且人人可用。
网页抓取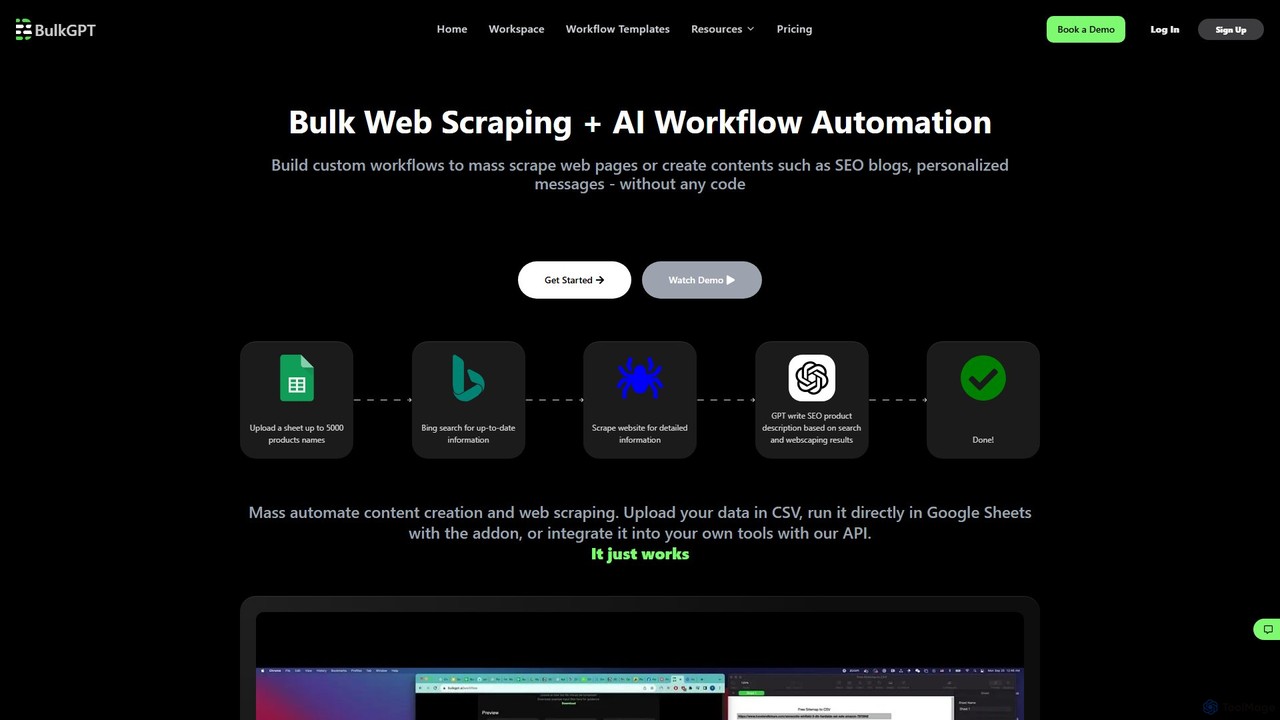
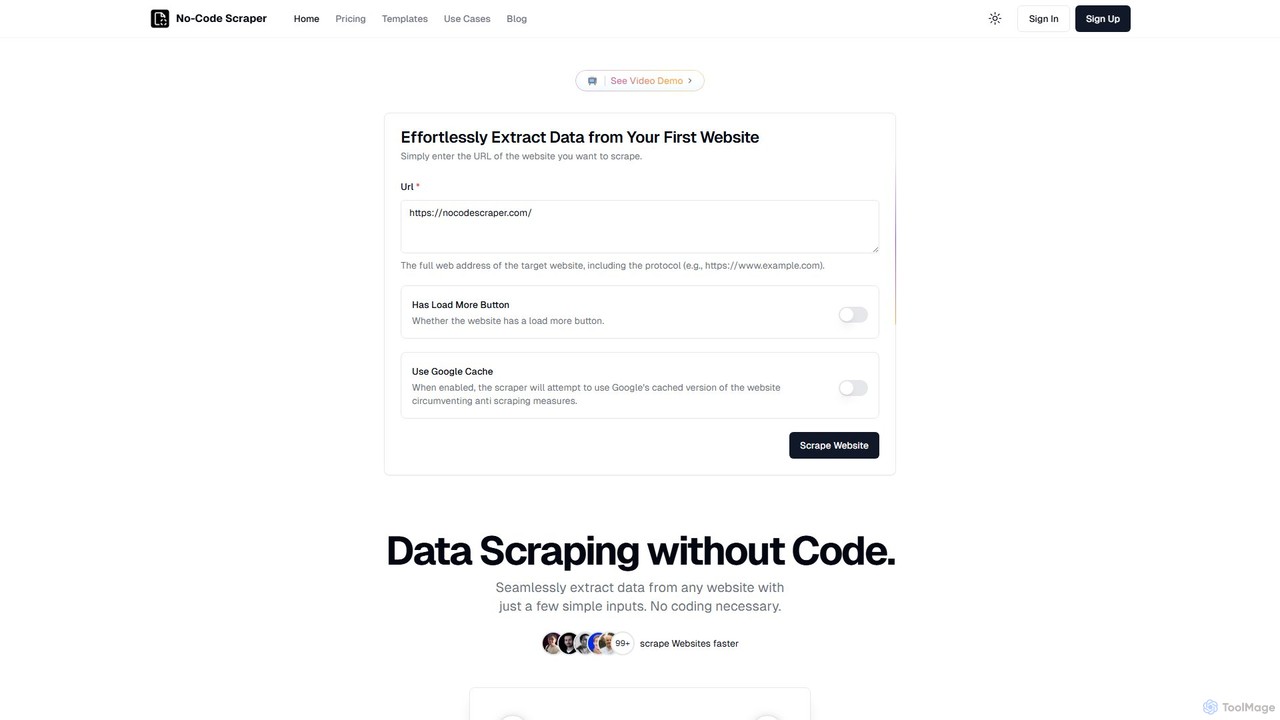
No-Code Scraper 是一个AI驱动的平台,用户无需编写任何代码即可从任何网站提取数据。它利用大型语言模型自动进行数据提取、清洗和结构化,使网络爬虫对每个人来说都变得易于访问、可靠且高效。
网页抓取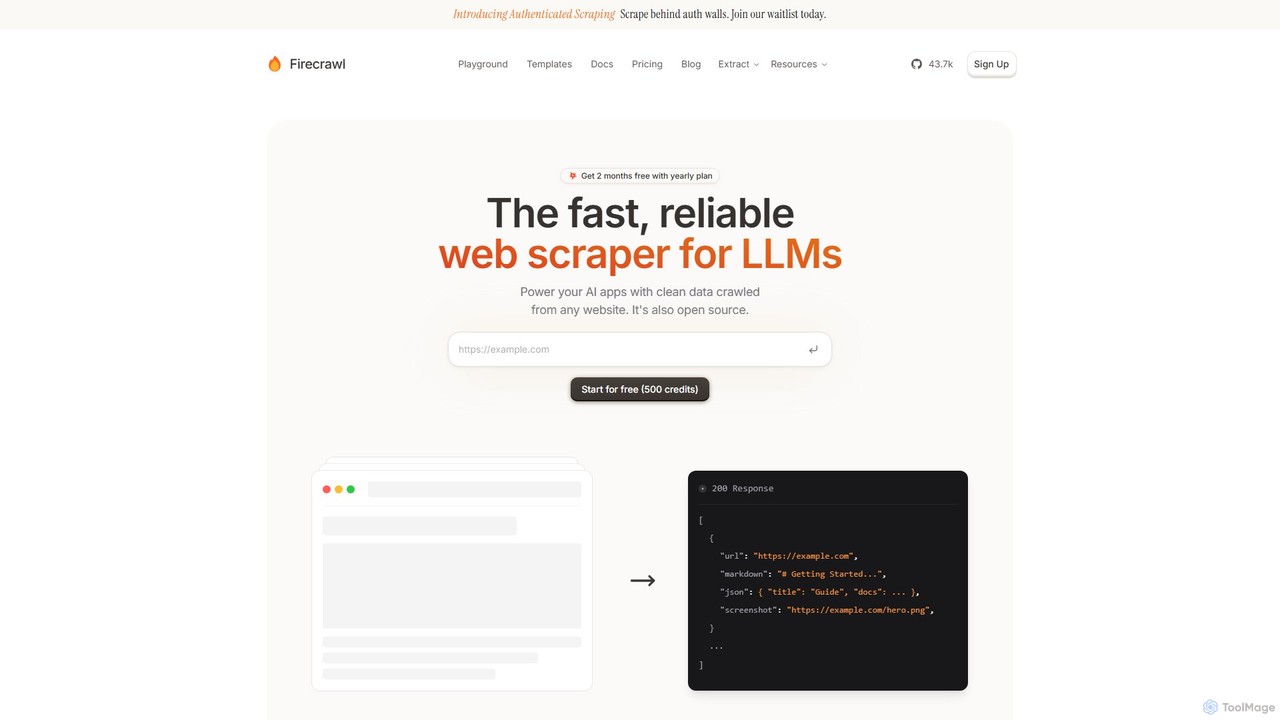
AI网页抓取工具是一类旨在自动从网站提取大量数据的应用程序。它们利用AI技术导航复杂的网站结构,处理验证码等反抓取措施,并将非结构化的HTML解析为JSON或CSV等结构化格式。这使得企业和研究人员能够收集实时市场数据、监控竞争对手并聚合信息,无需人工干预。AI通过适应网站变化和解释视觉布局来增强传统抓取技术,实现更稳健的数据收集。
这些工具广泛用于电子商务的价格监控、市场营销的潜在客户生成、金融领域的另类数据收集以及房地产的市场分析。例如,零售分析师可以使用AI网页抓取工具每日跟踪数百种竞品的价格和库存水平,并将这些数据直接输入其定价模型。
选择工具时,应考虑其处理动态、重JavaScript网站的能力及其对抗反抓取技术的弹性。评估用户界面——您是需要无代码的点选式解决方案,还是功能更强大的面向开发者的API。此外,还需评估其大规模数据提取的可扩展性,以及定价模式是否符合您的使用频率和数据需求。
一位电商经理需要为数千种产品维持有竞争力的定价。他们使用AI网页抓取工具每隔几小时自动扫描竞争对手的网站。该工具能识别产品页面,提取当前价格、库存状况和促销信息,然后将这些数据结构化并呈现在仪表板中。这个自动化流程取代了数小时的人工检查,使经理能够近乎实时地调整自己的定价策略,应对缺货情况,并最大化销售机会。
一位销售开发代表(SDR)的任务是建立特定行业的潜在客户列表。SDR无需手动浏览在线商业目录或专业网络,而是配置一个网页抓取工具来定位这些网站。该工具会提取公司名称、联系邮箱、电话号码以及关键决策者的职位。最终生成的结构化列表可以直接导入CRM系统,为SDR节省超过80%的潜在客户搜寻时间,使他们能专注于客户联系和互动。
一家消费电子品牌的市场分析师希望了解公众对新产品发布的情感反应。他们使用网页抓取工具从零售网站、科技博客和社交媒体平台收集数千条客户评论。该工具的AI功能帮助解析非结构化文本,以识别关键主题(如“电池续航”、“屏幕质量”)及相关情感(正面、负面、中性)。这些汇总的数据提供了一个全面的市场概览,比人工分析或调查更快地揭示了产品的优缺点。
一家房地产投资公司需要获取多个城市的最新房产挂牌信息。他们部署了一个网页抓取代理,从Zillow、Redfin等各种房地产门户网站和本地中介网站聚合数据。抓取工具提取房产地址、价格、面积、卧室数量和上市天数等详细信息。这些数据被汇编到一个中央数据库中,使分析师能够识别估值偏低的房产、跟踪市场趋势,并做出数据驱动的投资决策,而无需手动检查数十个网站。
一家对冲基金的量化分析师寻求另类数据源以获得交易优势。他们使用网页抓取工具来监控和提取来自财经新闻网站、监管文件和社交媒体中提及特定股票的信息。该工具被设置为持续运行,实时捕捉突发新闻和公众情绪的变化。这个数据流随后被输入算法交易模型,以识别相关性并预测市场动向,提供传统金融数据源无法获得的洞察。
一位大学研究员正在进行一项需要来自数百篇已发表科学研究数据的荟萃分析。从每篇论文的摘要或表格中手动查找和提取数据点将非常耗时。该研究员使用网页抓取工具自动爬取学术数据库(如PubMed或Google Scholar),根据关键词识别相关论文,并提取样本量、研究方法和关键发现等特定信息。这自动化了创建综合数据集的过程,使得原本不切实际的大规模分析成为可能。
AI网页抓取是使用经人工智能增强的自动化工具从网站提取数据的过程。与依赖固定规则和HTML选择器的传统抓取工具不同,AI驱动的工具可以直观地解释网页、理解复杂布局并适应网站结构的变化。这使得它们更具弹性,能够从动态、重JavaScript的网站中提取数据,并处理像验证码这样的反抓取措施。其核心目的是将非结构化的网络内容转换为结构化的、可用的数据以供分析。
选择合适的工具取决于您的技术水平和项目复杂性。请考虑以下因素:
主要区别在于数据访问的方式。API(应用程序编程接口)是开发者访问网站数据的结构化、官方途径。它由网站所有者提供,通常很稳定,并返回干净、格式良好的数据(如JSON)。而网页抓取则是直接从网页的HTML代码中提取数据——即人类在浏览器中看到的内容。当网站没有为所需数据提供API时,就会使用抓取技术。它更脆弱,因为网站布局的任何更改都可能导致抓取工具失效。
网页抓取的合法性很复杂,取决于司法管辖区和被抓取的具体数据。通常,抓取不受版权或个人数据法规保护的公开可用数据通常被认为是允许的。然而,这可能会违反网站的服务条款。至关重要的是要避免抓取个人数据、受版权保护的内容,以及使网站服务器过载(这可能被视为拒绝服务攻击)。请始终负责任地、合乎道德地进行抓取。本信息不构成法律建议;具体情况请咨询法律专业人士。
几乎任何在网页上可见的数据都可以被提取。常见示例包括:
关键在于将这些非结构化信息转换为结构化格式,如电子表格或数据库,以便进行分析。