UseScraper
数据提取
数据提取
数据提取
UseScraper 是一款功能强大的网络爬虫和抓取 API,专为开发人员和 AI 应用而设计。它能高效地从任何网站提取数据,具有完整的 JavaScript 渲染、自动扩展的基础设施以及清晰的 Markdown 等输出格式,非常适合为 ChatGPT 等大语言模型提供数据。
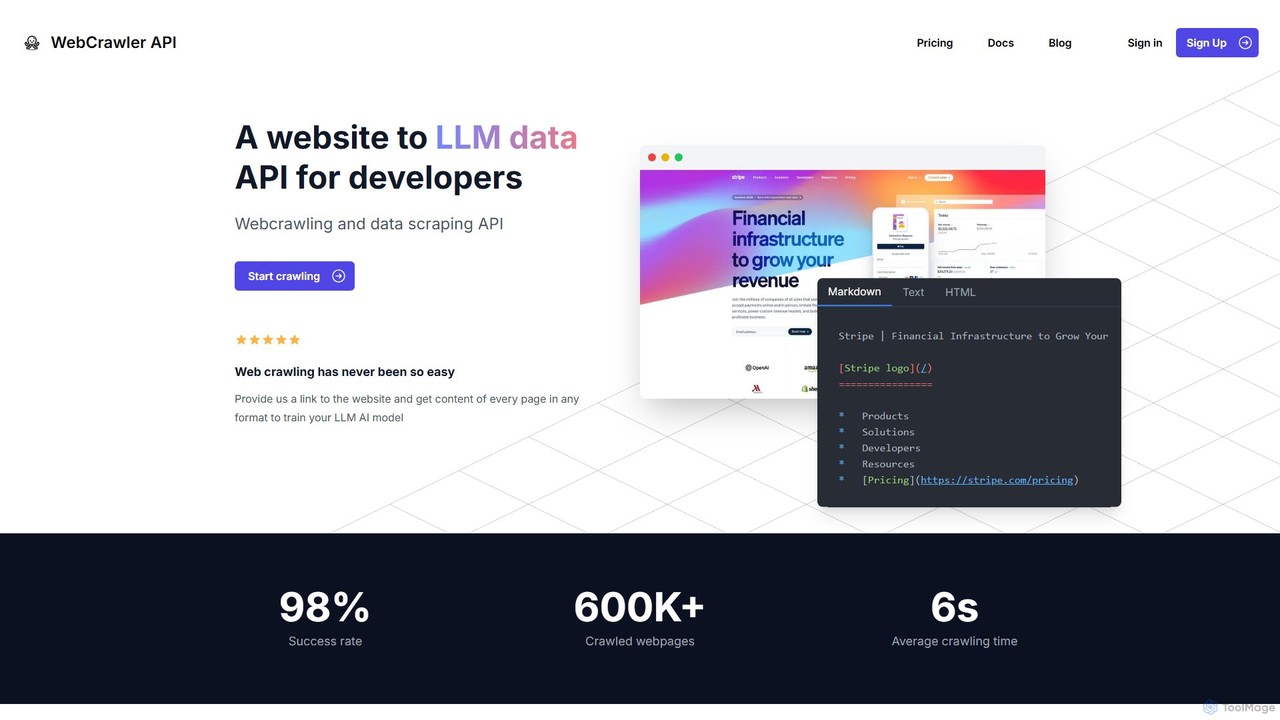
Webcrawlerapi 是一款功能强大的API,专为开发人员设计,可轻松抓取网站并提取干净的数据。它通过处理JavaScript渲染、反机器人措施和数据解析,简化了复杂的网络抓取过程。该工具非常适合收集Markdown或文本等结构化内容,用于训练LLM AI模型或检索增强生成(RAG)系统,并提供高成功率和简单的按量付费定价模式。
并排查看产品定位、价格模式和目标用户。浅色行表示收录资料不同;未收录价格不代表免费。
| 核心事实 | UseScraper | Webcrawlerapi |
|---|---|---|
| 价格类型 | 免费增值 | 免费增值 |
| 产品形态 | 网站 | 网站 |
| 主要定位 | 数据提取 | 数据提取 |
| 受众与岗位 | 暂无数据 | 暂无数据 |
| 分类 | 数据提取 · API · 自动化 | 数据提取 · API · 自动化 |
| 收录时间: | 2025年8月5日 | 2025年8月2日 |
| 更新于 | 2026年11月19日 | 2026年11月19日 |
以下展示两款工具已收录的详细资料。按各自的功能和工作方式逐项阅读,不把标签当作功能评测。
UseScraper 是一项通过简单而强大的 API 提供的稳健且可扩展的网络抓取和爬虫服务。它从零开始为速度和可靠性而设计,使用户能够在几秒钟内从任何网页提取数据,或在几分钟内抓取整个网站。该工具对于需要收集网络数据以进行市场研究、潜在客户开发、价格监控或训练 AI 模型的开发人员、数据科学家和企业尤其有价值。
该平台旨在处理现代网络的复杂性。它利用真实的 Chrome 浏览器进行完整的 JavaScript 渲染,确保动态单页应用(SPA)上的内容被准确捕获。这一能力使其优于许多仅获取静态 HTML 的传统抓取工具。输出可以以多种格式提供,包括原始 HTML、纯文本,以及最值得注意的、干净且结构良好的 Markdown,这是 AI 系统和大型语言模型(LLM)处理的理想格式。
对于各种水平的开发人员来说,使用 UseScraper 都非常简单。该过程包括几个简单的步骤:
UseScraper 用途广泛,可应用于各种数据提取任务:
UseScraper 因其对性能、现代网络兼容性和开发者体验的关注而脱颖而出。其主要优势包括轻松处理重度 JavaScript 网站的能力、提供专为 AI 定制的干净 Markdown 输出,以及其可扩展的高速架构。灵活的定价模式,包括慷慨的免费套餐,使其适用于从小型脚本到大型企业数据操作的各种规模的项目。
UseScraper 提供透明且可扩展的定价结构:
新用户注册后可获得 25 美元的免费积分,为测试和开发提供了坚实的起点。
Webcrawlerapi 是一个专门的API,旨在为开发人员简化网络爬虫和数据提取的过程。在数据对于训练大型语言模型(LLM)和驱动AI应用至关重要的时代,传统的网络抓取面临着重大挑战。这些挑战包括处理动态JavaScript渲染的内容、绕过复杂的反机器人系统、管理代理以及将混乱的HTML清理成可用的格式。Webcrawlerapi 将所有这些复杂性抽象出来,提供了一个简单而强大的接口,可将任何网站转变为结构化的数据源。
据报道,该服务拥有98%的成功率和仅6秒的平均抓取时间,专为效率和可靠性而构建。它使开发人员能够专注于其核心应用逻辑,而不是陷入构建和维护可扩展抓取基础设施的复杂细节中。通过提供一个链接,开发人员可以接收到干净、即用型的内容,格式包括Markdown、文本或原始HTML,非常适合输入到AI模型训练管道或RAG系统的知识库中。
将 Webcrawlerapi 集成到您的项目中非常直接。该过程通常只需要几行代码。首先,您需要在 Webcrawlerapi 网站上注册以获取您唯一的API访问密钥。然后,您可以使用他们为流行编程语言提供的客户端库之一。
例如,在NodeJS环境中,您首先通过npm安装客户端库:npm i webcrawlerapi-js。然后,在您的代码中,导入该库,使用您的API密钥创建一个新的客户端实例,并调用 `crawl` 方法。此方法接受诸如目标 `url`、所需的 `scrape_type`(例如 'markdown')以及可选的限制(如 `items_limit`)等参数。然后,API会在后台处理整个抓取过程,并返回一个包含提取数据的结构化JSON响应。Python、PHP和.NET也提供类似的简单集成模式,使其对广大开发人员都易于使用。
Webcrawlerapi 功能多样,可应用于各种数据密集型任务。其主要用例围绕AI和数据分析。
Webcrawlerapi 的主要优势在于其简单性和效率。它允许开发团队将整个网络抓取基础设施和维护负担外包出去。这意味着数据驱动产品的上市时间更快。98%的高成功率和强大的反机器人功能确保了数据管道的可靠性。此外,其透明的按量付费定价模式具有很高的成本效益,因为您只需为成功的请求付费,从而消除了与订阅或构建内部解决方案相关的风险和开销。
Webcrawlerapi 采用直接透明的“按使用量付费”定价模式,完全避免了订阅和隐藏费用。成本根据您每月成功抓取的页面数量计算。该服务的定价中包含了无限的抓取作业、无限且自动管理的代理网络以及电子邮件支持。为了清晰地估算成本,网站提供了一个计算器。例如,一个月内抓取10,000个页面大约需要20美元。这种模式非常适合各种规模的项目,从小型实验到大规模数据操作,因为成本与使用量成正比。该平台还允许用户在购买前试用服务,很可能是通过为新账户分配免费信用额度的方式。
分类与标签可以看出两款产品的重合范围,以及各自更明确的定位重点。 未知字段会明确显示,不会用推测内容补齐。
流量数据使用同一比例尺,避免弱化两款产品在市场可见度上的真实差距。
左右图表使用相同的月份与纵轴比例。各工具最新统计月份已单独标注;缺失月份保留空缺,不记为零。地区和来源的访问量是根据比例计算的估算值。
暂无数据
| 国家/地区 | 百分比 | 估算访问量 |
|---|---|---|
| 🇺🇸United States | 49.13% | 2.7K |
| 🇩🇪Germany | 20.9% | 1.1K |
| 🇮🇳India | 14.85% | 809 |
| 🇻🇳Vietnam | 12.23% | 666 |
| 🇦🇺Australia | 2.89% | 157 |
评分、评论、收藏和点赞属于社区信号,不能替代对具体使用场景的判断。
本页由 ToolMage 已收录的产品资料、分类标签、流量统计和站内用户反馈自动整理,不是上手实测或独立评测。