
UseScraper 概览
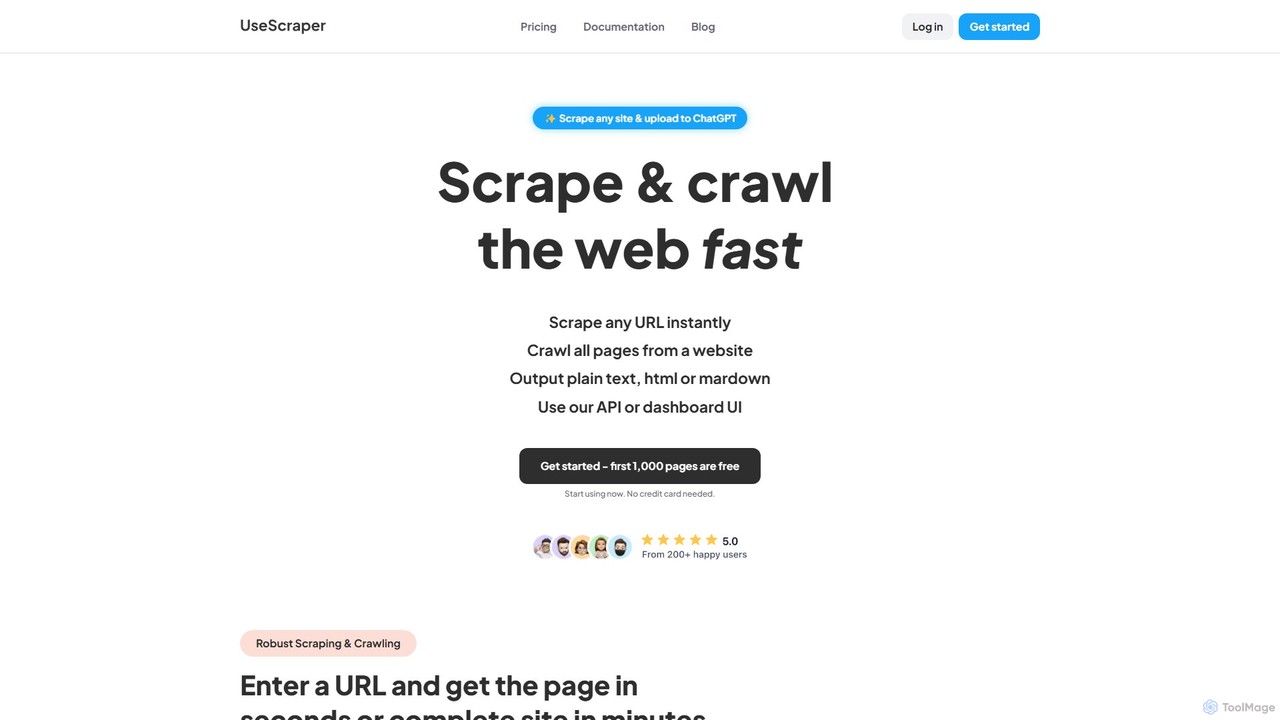
UseScraper 是一项通过简单而强大的 API 提供的稳健且可扩展的网络抓取和爬虫服务。它从零开始为速度和可靠性而设计,使用户能够在几秒钟内从任何网页提取数据,或在几分钟内抓取整个网站。该工具对于需要收集网络数据以进行市场研究、潜在客户开发、价格监控或训练 AI 模型的开发人员、数据科学家和企业尤其有价值。
该平台旨在处理现代网络的复杂性。它利用真实的 Chrome 浏览器进行完整的 JavaScript 渲染,确保动态单页应用(SPA)上的内容被准确捕获。这一能力使其优于许多仅获取静态 HTML 的传统抓取工具。输出可以以多种格式提供,包括原始 HTML、纯文本,以及最值得注意的、干净且结构良好的 Markdown,这是 AI 系统和大型语言模型(LLM)处理的理想格式。
如何使用 UseScraper
对于各种水平的开发人员来说,使用 UseScraper 都非常简单。该过程包括几个简单的步骤:
- 注册: 创建一个免费账户即可开始。无需信用卡,注册后即可获得 1,000 次免费页面抓取和 25 美元的积分。
- 选择您的工具: 决定您是需要抓取单个 URL 还是整个网站。UseScraper 为这两项任务提供了专用的 API(Scraper API 和 Crawler API)。
- 发出 API 请求: 使用您偏好的编程语言(Python、JavaScript、C# 等)向 UseScraper API 端点发出请求。您只需提供目标 URL。
- 配置选项: 您可以使用高级选项自定义您的请求,例如排除特定的 URL 或 CSS 元素、设置用于通知的 webhook,以及选择您期望的输出格式(markdown、text 或 html)。
- 接收数据: 抓取的内容会在 API 响应中返回。对于较大的抓取任务,结果会存储在专用的数据存储中,可以通过 API 访问。您还可以设置数据自动过期以管理存储。
UseScraper 的核心功能
- 抓取器和爬虫 API: 用于即时抓取单个页面或从网站抓取数千个页面的专用 API。
- 完整的 JavaScript 渲染: 使用真实的 Chrome 浏览器渲染 JavaScript,确保从动态网站和 SPA 中准确提取数据。
- 适用于 AI 的 Markdown 输出: 提供干净、结构化的 Markdown 输出,非常适合用于 AI 应用、RAG 系统以及为 ChatGPT 等 LLM 提供知识。也支持纯文本和 HTML 格式。
- 高速、可扩展的基础设施: 基于自动扩展的基础设施构建,允许每分钟超快速、并行地抓取和爬行数千个页面。
- 高级爬取控制: 功能包括在单个任务中进行多站点爬取、使用 glob 模式排除特定 URL,以及使用 CSS 选择器移除重复内容(如页眉/页脚)。
- 自动代理轮换: (即将推出)自动轮换代理以绕过反抓取措施并防止速率限制,确保高成功率。
- Webhook 通知: 通过 webhook 获取有关抓取任务状态和完成情况的实时更新。
- 集成数据存储: 抓取的数据保存到可通过 API 访问的数据存储中,并可选择设置数据自动过期。
UseScraper 的使用案例
UseScraper 用途广泛,可应用于各种数据提取任务:
- AI 模型训练: 抓取大量网络内容以创建用于训练机器学习模型的数据集,或为使用 LLM 的检索增强生成(RAG)系统构建知识库。
- 市场与竞争对手分析: 从竞争对手网站汇总产品信息、定价、评论和新闻,为业务战略提供信息。
- 潜在客户开发: 从在线目录和专业网络中提取联系方式和业务信息。
- 内容聚合: 通过自动从多个来源收集数据,为新闻门户、招聘网站或房地产列表网站提供支持。
- SEO 与市场营销: 通过爬取 SERP 和网站来监控搜索引擎排名、跟踪品牌提及并分析反向链接配置文件。
UseScraper 的优势特点
UseScraper 因其对性能、现代网络兼容性和开发者体验的关注而脱颖而出。其主要优势包括轻松处理重度 JavaScript 网站的能力、提供专为 AI 定制的干净 Markdown 输出,以及其可扩展的高速架构。灵活的定价模式,包括慷慨的免费套餐,使其适用于从小型脚本到大型企业数据操作的各种规模的项目。
定价和计划
UseScraper 提供透明且可扩展的定价结构:
- 按需付费计划: 每月 0 美元。您只需按使用量付费,费率为每 1,000 个网页 1 美元。该计划包括 10 个并发任务、抓取器和爬虫 API、JavaScript 渲染,非常适合小型项目。前 1,000 个页面免费。
- 专业版计划: 每月 99 美元,外加每 1,000 个网页 1 美元的使用费。该计划专为大规模操作而设计,包括免费计划中的所有功能,外加无限并发任务、每个网站无限页面爬取、高级代理(即将推出)和优先支持。
新用户注册后可获得 25 美元的免费积分,为测试和开发提供了坚实的起点。
UseScraper 替代方案
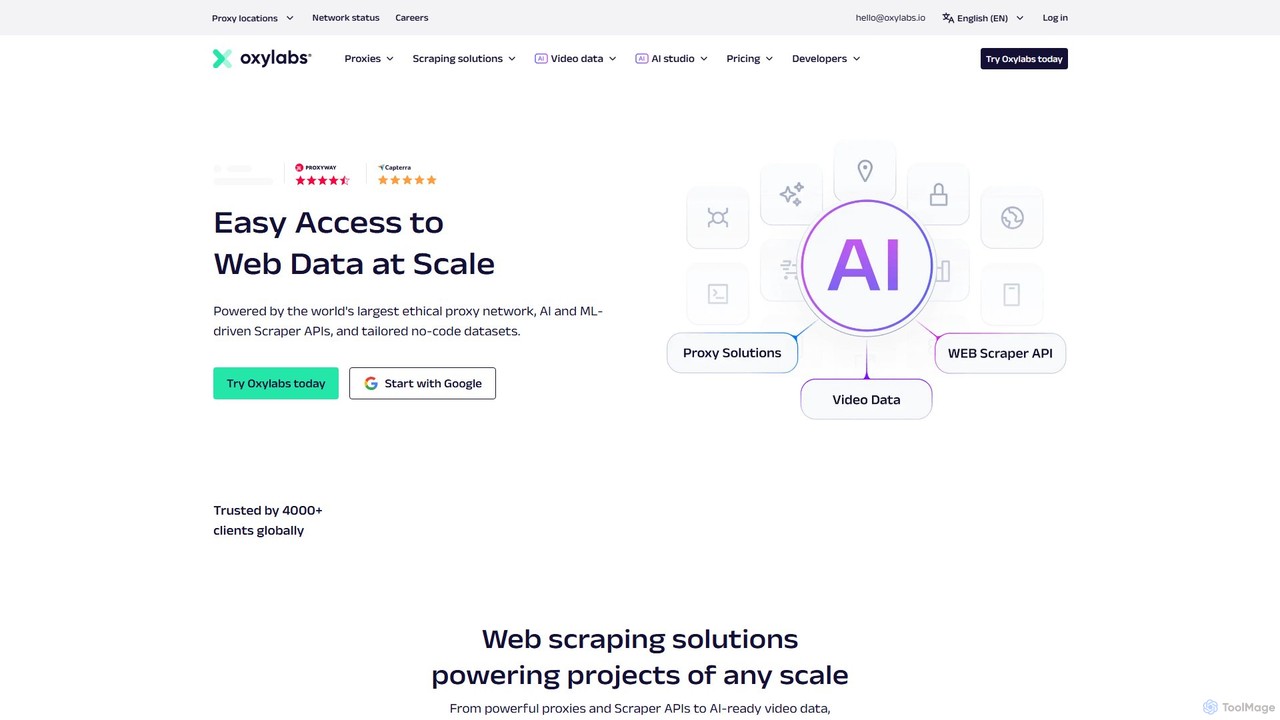
Webcrawlerapi
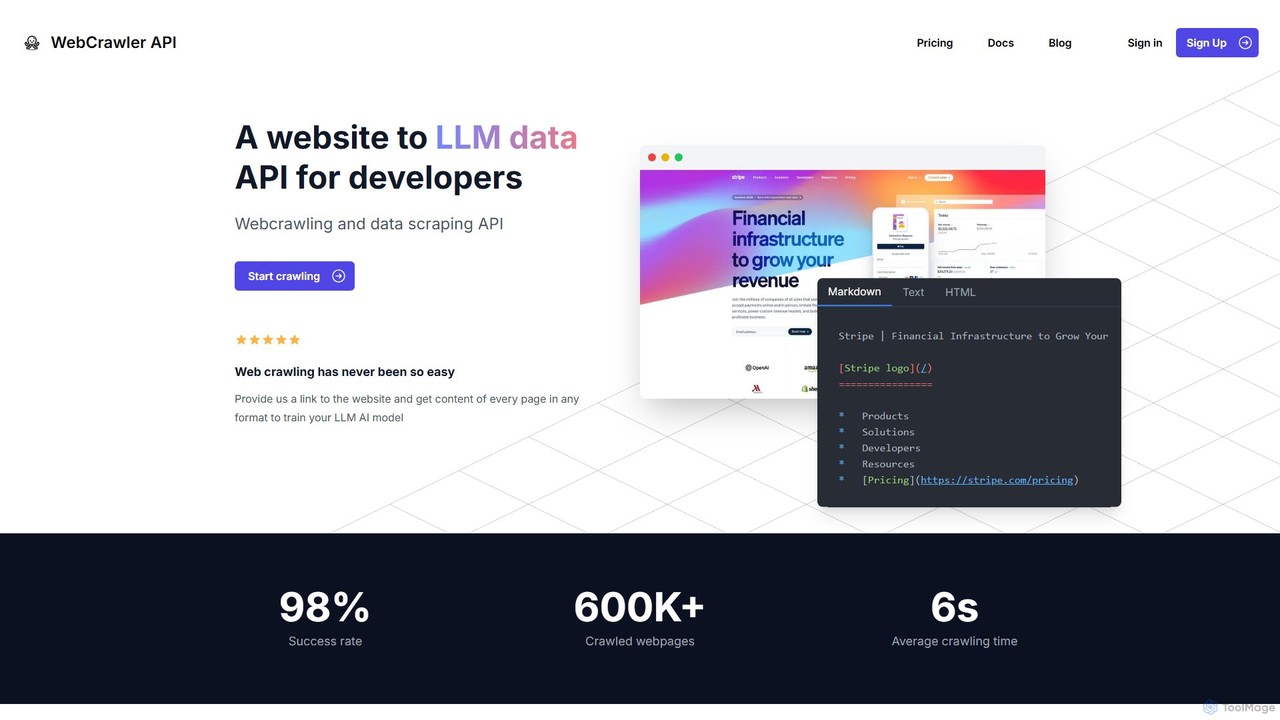
Webcrawlerapi 是一款功能强大的API,专为开发人员设计,可轻松抓取网站并提取干净的数据。它通过处理JavaScript渲染、反机器人措施和数据解析,简化了复杂的网络抓取过程。该工具非常适合收集Markdown或文本等结构化内容,用于训练LLM AI模型或检索增强生成(RAG)系统,并提供高成功率和简单的按量付费定价模式。
数据提取
instantapi
instantapi 是一个由人工智能驱动的网页抓取API,专为简化和提速而设计。它允许用户通过单个API调用从任何网站提取结构化数据,无需复杂的编码或手动设置。对于需要快速、经济、可靠的数据提取而又不想处理传统网络爬虫麻烦的开发人员、数据分析师和企业来说,这是一个理想的选择。
数据提取
UseScraper 分类
UseScraper 嵌入功能
复制这段嵌入代码,将徽章放到博客、文章或产品官网,并把读者直接引导到 ToolMage 详情页。

相关 AI 工具
Webcrawlerapi
Webcrawlerapi 是一款功能强大的API,专为开发人员设计,可轻松抓取网站并提取干净的数据。它通过处理JavaScript渲染、反机器人措施和数据解析,简化了复杂的网络抓取过程。该工具非常适合收集Markdown或文本等结构化内容,用于训练LLM AI模型或检索增强生成(RAG)系统,并提供高成功率和简单的按量付费定价模式。
数据提取
WebScraping.AI
WebScraping.AI 是一款面向开发人员的高级API,利用AI简化网络爬虫。它具备轮换代理、JavaScript渲染和地理定位功能,可绕过封锁并访问动态内容。其核心优势在于由LLM驱动的工具,能直接从网页中提取非结构化数据、生成摘要并回答问题,极大地简化了任何项目的数据收集流程。
数据提取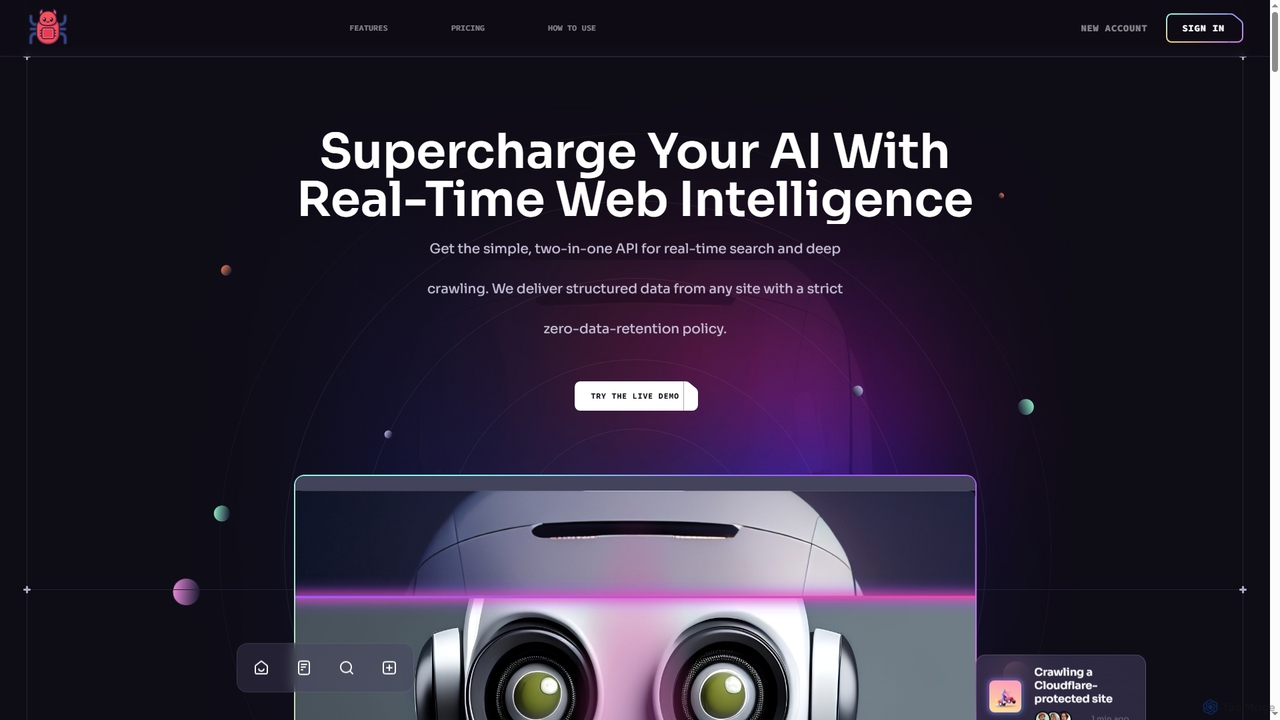
instantapi
instantapi 是一个由人工智能驱动的网页抓取API,专为简化和提速而设计。它允许用户通过单个API调用从任何网站提取结构化数据,无需复杂的编码或手动设置。对于需要快速、经济、可靠的数据提取而又不想处理传统网络爬虫麻烦的开发人员、数据分析师和企业来说,这是一个理想的选择。
数据提取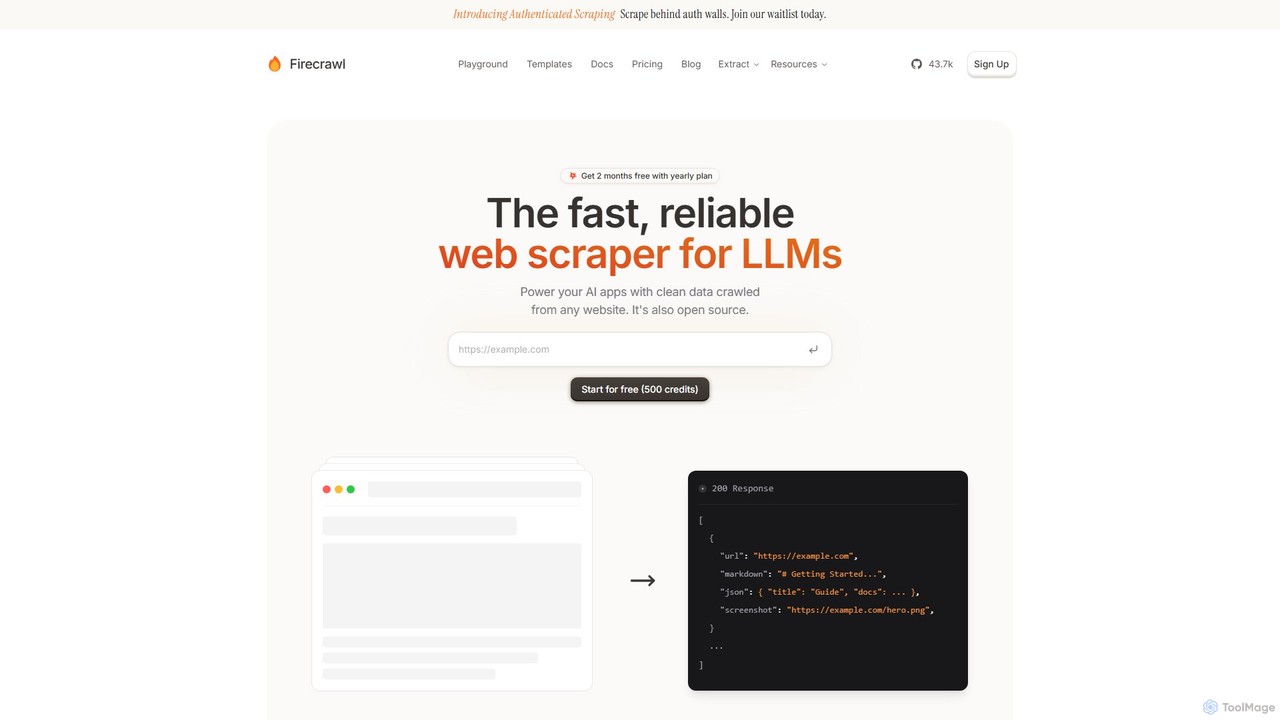
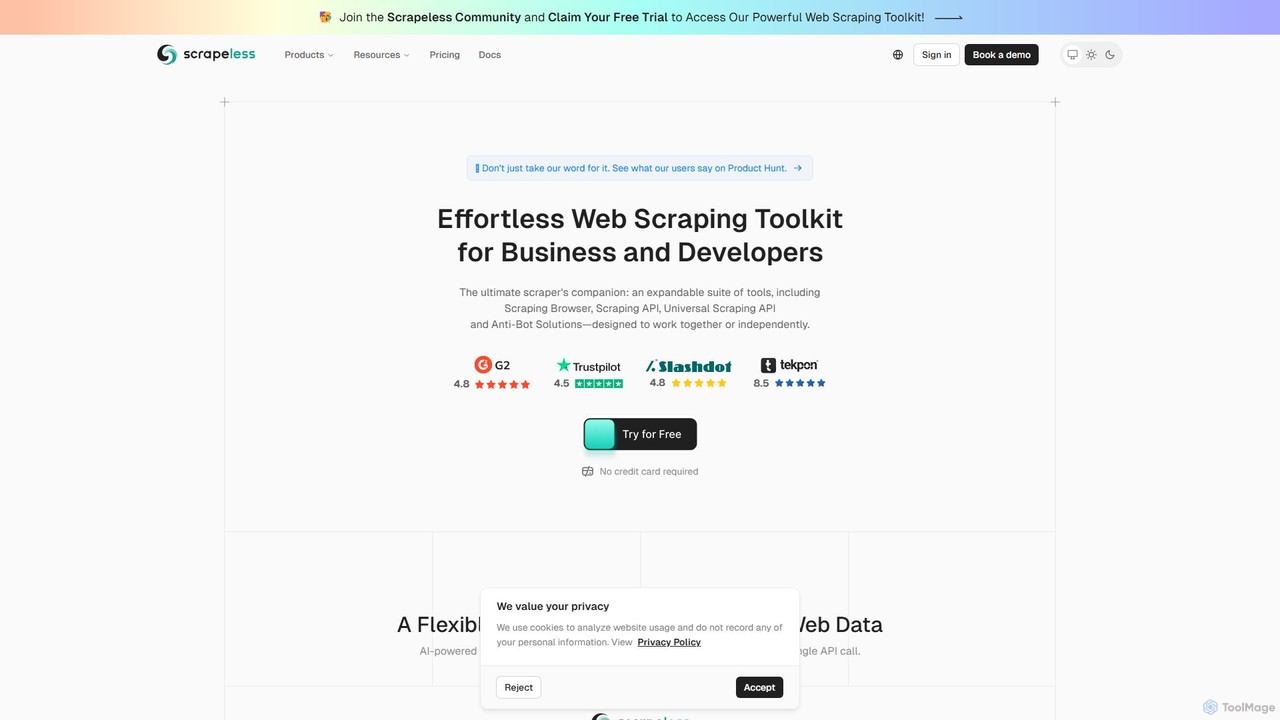
Scrapeless
一款为开发者和企业设计的AI驱动的网络爬虫工具包。它提供包括爬虫浏览器、通用爬虫API和深度SERP API在内的一整套工具,可轻松大规模提取公共网络数据。它专注于绕过反机器人措施,为电子商务、市场研究和AI模型训练提供结构化数据,并以可靠性和易用性为核心。
爬取

UseScraper 评论 (0)
登录后发表评论。
登录暂无评论。