
Tensorlake 概览
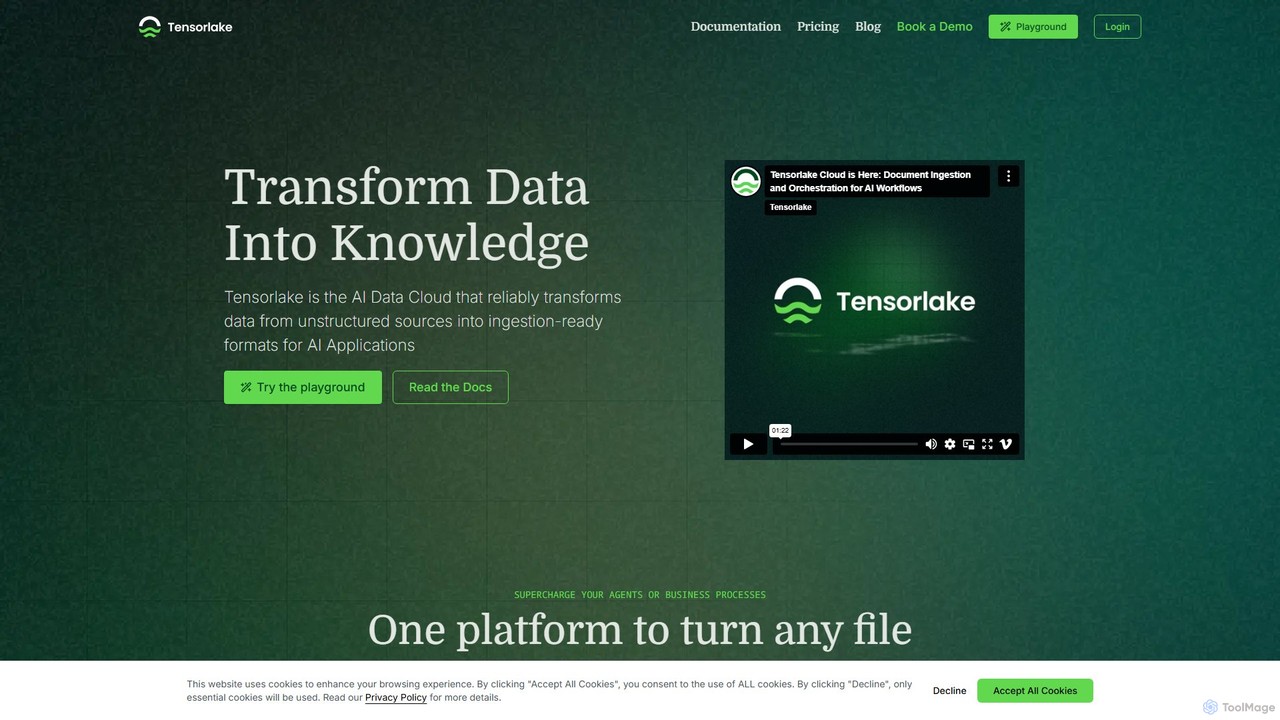
Tensorlake 是一个全面的 AI 数据云,旨在弥合原始非结构化数据与高级 AI 应用之间的鸿沟。它作为一个统一平台,帮助开发者和企业可靠地将来自各种来源(包括 PDF、图像、手写笔记和电子表格)的复杂数据转换为结构化的、可直接提取的格式,如 JSON 或 markdown。这一过程对于驱动大型语言模型 (LLM)、增强检索增强生成 (RAG) 系统以及自动化关键业务工作流至关重要。
该平台建立在两大核心支柱之上:文档提取 API 和无服务器工作流。文档提取 API 提供类人解析能力,在提取高精度信息的同时,保留文档的原始布局和阅读顺序。无服务器工作流则允许用户使用 Python 构建和部署完全托管的端到端数据处理管道。这些工作流具有高度可扩展性,能够处理数百万份文档,并且在空闲时可缩减至零,极具成本效益。
如何使用 Tensorlake
使用 Tensorlake 遵循一个直接、以开发者为中心的工作流程:
- 上传或连接数据: 首先通过 API 直接上传文件或连接您现有的数据源。该平台支持广泛的文件类型。
- 调用 API 进行处理: 使用文档提取 API 处理您的文件。您可以使用“Parse”端点进行通用文档转换,或使用带有预定义 Pydantic 模式的“Extract”端点将特定的结构化数据提取为 JSON 格式。
- 构建自定义工作流(可选): 对于更复杂的数据转换,可使用 Tensorlake 的无服务器工作流。编写 Python 函数来定义数据管道的步骤,例如清洗、丰富数据并将其路由到您的数据库或其他系统。
- 检索处理后的数据: 任务完成后立即访问转换后的结构化数据,或设置 webhook 进行异步通知。输出经过优化,可直接用于 AI 应用。
- 与 AI/LLM 集成: 将高质量的结构化数据输入您的 RAG 管道、AI 代理或其他机器学习模型,以提高其准确性和能力。
Tensorlake 的核心功能
- 文档提取 API: 解析任何文件类型,从手写笔记到复杂的电子表格,同时保留布局和上下文。
- 结构化数据提取: 使用自定义 Python 模式将非结构化内容转换为干净的 JSON 或 markdown 块,实现高精度提取。
- 无服务器工作流: 无需管理任何基础设施,即可构建、部署和扩展基于 Python 的数据处理管道。工作流根据需求自动扩展。
- RAG 优化: 生成富含元数据的结构化数据块,专门用于提高检索增强生成系统的准确性和相关性。
- 大规模可扩展性: 设计用于为每位客户每天处理超过 100,000 份文档,并以极低延迟处理每秒 10,000 次事件。
- 签名检测: 一项集成功能,可自动识别文档中是否存在签名,从而触发智能自动化流程。
- 安全与协作: 提供基于角色的访问控制 (RBAC)、用于数据保护的命名空间以及用于全面可见性和合规性的详细日志。
Tensorlake 的使用案例
Tensorlake 非常适合数据准确性至关重要的高风险应用:
- 高级 RAG 系统: 通过结合语义搜索和从文档内容(如表格、图表、元数据)中提取的结构化过滤器,为 LLM 构建复杂的检索管道。
- 金融服务自动化: 处理贷款申请、税务审计文件和财务报表,以提取关键信息并自动化决策过程。
- 医疗数据管理: 将患者记录、实验室报告和医学研究论文数字化并结构化,以供分析和合规使用。
- 法律与合规: 分析合同、房产契约和法律文件,以提取条款、识别风险并确保合规。
- 供应链与物流: 处理国际贸易单据、发票和提单,以简化运营并提高可见性。
Tensorlake 的优势特点
Tensorlake 提供了显著的竞争优势:
- 无与伦比的准确性: 其类人的解析和结构化提取能力可提供高质量数据,最大限度地减少 AI 模型中的错误。
- 简化开发: 代码优先、API 驱动的方法简化了复杂数据管道的创建,使团队能够更快地进行构建。
- 高性价比的可扩展性: 无服务器架构和透明的按需付费定价模式确保您只需为使用的资源付费,使其扩展成本经济实惠。
- 端到端平台: 它为数据提取、结构化和编排提供了一个单一、统一的解决方案,无需使用脆弱的多工具管道。
- 灵活性: 与 LangChain 和 Qdrant 等流行工具无缝集成,以增强现有的 AI 技术栈。
定价和计划
Tensorlake 提供透明的、基于使用量的定价模型,没有存储或带宽的隐藏费用。
- 文档提取: 简单、按需付费,每页 $0.01。
- 无服务器工作流: 根据消耗的计算资源按秒计费:
- Nvidia H100: $0.0009/秒
- Nvidia A100: $0.0005/秒
- CPU (1 vCPU): $0.00004/秒
- 内存 (DDR4): $0.00009/GB/秒
- 本地部署: 提供定制的企业计划,可在您自己的网络内部署。详情请联系销售。
流量分析
最新流量情况
状态
月度流量趋势
- 2025-9: 6.9K
- 2026-1: 50.0K
- 2026-2: 61.4K
- 2026-3: 46.7K
- 2026-4: 46.4K
- 2026-5: 31.5K
地理位置
Top 5 国家/地区
- 🇺🇸美国55.2%
- 🇳🇬尼日利亚15.5%
- 🇻🇳越南11.4%
- 🇮🇩印度尼西亚9.3%
- 🇮🇳印度8.5%
流量来源
| 来源类型 | 百分比 |
|---|---|
直接访问 | 85.3% |
外链引荐 | 8.3% |
邮件 | 6.3% |
热门关键词
| 关键词 | 每次点击费用 |
|---|---|
| opencode omo claude ekvivalent | $0.00 |
| opencode with everything claude code, direct use | $0.00 |
| tensorlaek | $0.00 |
| tensorlake | $6.31 |
| tensorlake documentation | $0.00 |
Tensorlake 替代方案
ScrapeGraphAI
ScrapeGraphAI 是一款由人工智能驱动的网页抓取 API,它使用简单的自然语言提示,将非结构化的网站内容转化为干净、结构化的 JSON 数据。专为开发人员、AI 代理和自动化工作流设计,无需复杂的代码即可简化数据提取。
分析
boundaryml
boundaryml (BAML) 是一个专为开发人员设计的编程语言和工具包,用于从大型语言模型 (LLM) 中可靠地提取结构化数据。它将复杂的提示工程转变为简化的、类似代码的流程,确保在各种 LLM 和编程语言(如 Python 和 TypeScript)中获得类型安全、错误修正的输出。它旨在提高可靠性、降低成本并加速 AI 应用的开发周期。
API
Tensorlake 分类
Tensorlake 嵌入功能
复制这段嵌入代码,将徽章放到博客、文章或产品官网,并把读者直接引导到 ToolMage 详情页。

相关 AI 工具
ScrapeGraphAI
ScrapeGraphAI 是一款由人工智能驱动的网页抓取 API,它使用简单的自然语言提示,将非结构化的网站内容转化为干净、结构化的 JSON 数据。专为开发人员、AI 代理和自动化工作流设计,无需复杂的代码即可简化数据提取。
分析boundaryml
boundaryml (BAML) 是一个专为开发人员设计的编程语言和工具包,用于从大型语言模型 (LLM) 中可靠地提取结构化数据。它将复杂的提示工程转变为简化的、类似代码的流程,确保在各种 LLM 和编程语言(如 Python 和 TypeScript)中获得类型安全、错误修正的输出。它旨在提高可靠性、降低成本并加速 AI 应用的开发周期。
API

JSON Scout
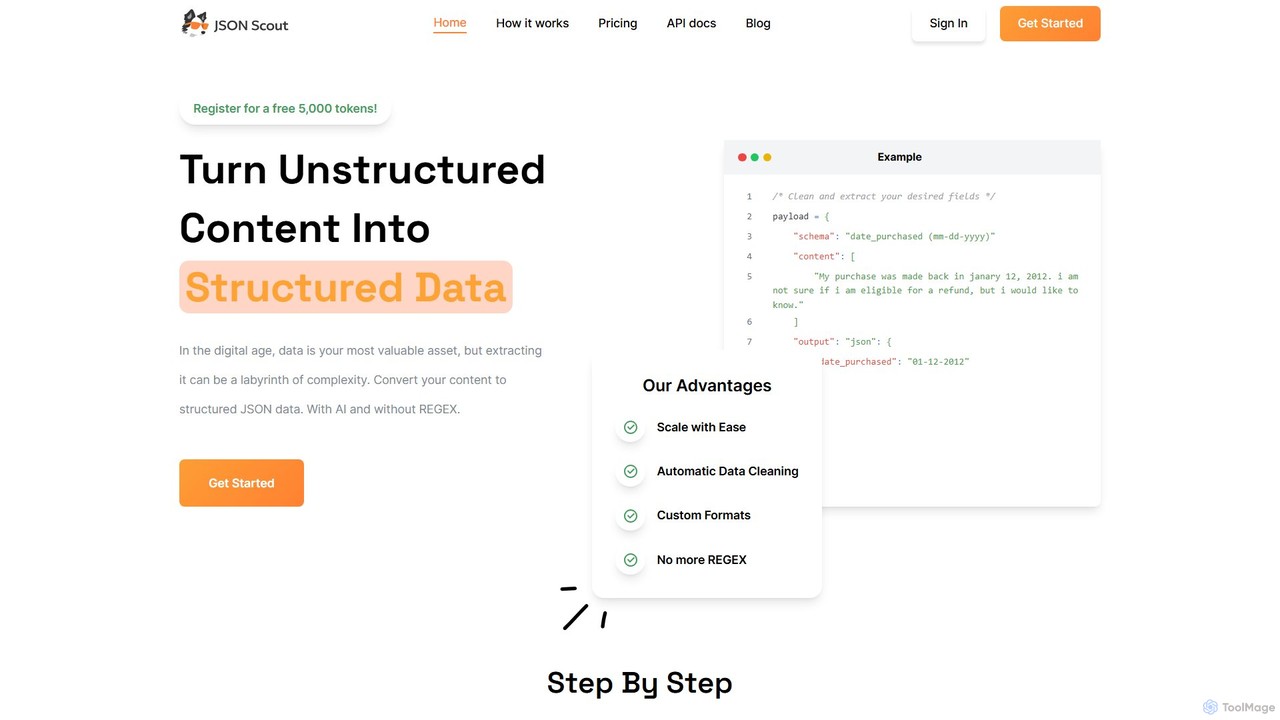
JSON Scout 是一款面向开发人员的人工智能 API,可将非结构化的文本和音频内容转换为结构化的 JSON 数据。它利用 GPT-4o 等大型语言模型 (LLM),无需复杂的正则表达式 (REGEX),从而节省开发时间并提高数据提取的准确性。
数据处理
supermemory
supermemory是面向AI时代的内存API和基础设施,专为开发者设计,用于构建具有长期持久性内存的LLM。它克服了有限上下文窗口的限制,支持创建能够记住过去互动和跨平台信息的智能、情境感知AI代理、聊天机器人和应用程序。
LLM
Tensorlake 评论 (0)
登录后发表评论。
登录暂无评论。