免费增值
Nextbrowser
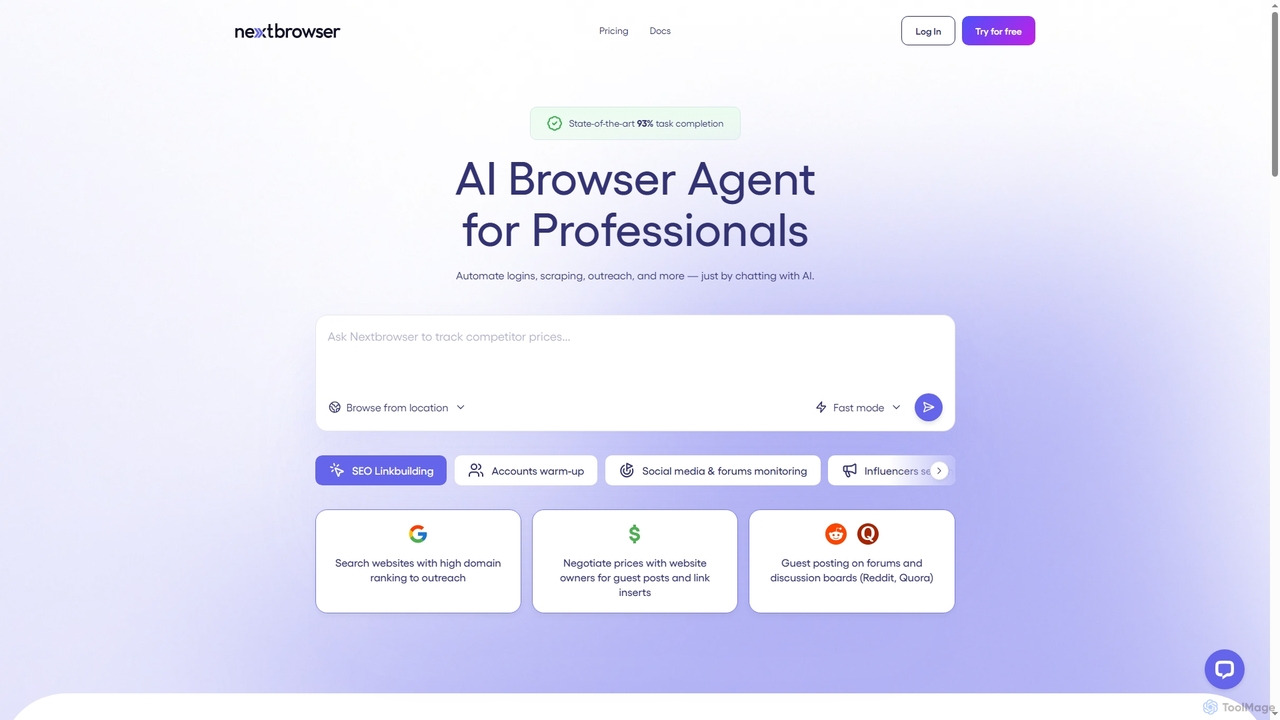
Nextbrowser是一款專為銷售和行銷專業人士設計的AI驅動瀏覽器代理。它透過簡單的聊天指令,自動化複雜的網路任務,如登入、資料抓取、SEO連結建設和網紅推廣。Nextbrowser在雲端運行,具備類人互動和地理位置控制功能,能顯著提高效率,降低營運成本,簡化重複性工作流程,管理多個帳戶並安排任務。
銷售自動化Visits 10.1KFavorites 140Likes 148
數據領域的網頁抓取熱門 AI 工具包括 Firecrawl、Bright Data、Oxylabs、Browse AI、Browserbase、Octoparse、Zyte、UpRock、BrowserAct、Simplescraper 等,幫助您快速提升效率。
Nextbrowser是一款專為銷售和行銷專業人士設計的AI驅動瀏覽器代理。它透過簡單的聊天指令,自動化複雜的網路任務,如登入、資料抓取、SEO連結建設和網紅推廣。Nextbrowser在雲端運行,具備類人互動和地理位置控制功能,能顯著提高效率,降低營運成本,簡化重複性工作流程,管理多個帳戶並安排任務。
銷售自動化
PandaExtract 是一款終極無程式碼網頁抓取 Chrome 擴充功能。它允許專業人士一鍵從任何網站擷取資料。該工具無需編程技能,是市場研究、潛在客戶開發、價格監控和競爭對手分析的理想選擇。
網頁抓取
Strawberry Browser 是一款智慧 AI 瀏覽器,旨在自動化您的日常工作流程。它允許您建立一個可自訂的 AI 助理團隊,直接在瀏覽器內處理研究、資料擷取和潛在客戶開發等重複性任務。消除繁瑣工作,保持專注,提升您的生產力。
AI助理
Simplescraper 是一款功能強大的網頁抓取工具,可在數秒內從任何網站擷取資料。它提供了一個使用者友善的 Chrome 擴充功能,用於無程式碼資料選取;基於雲端的自動化功能,用於大規模抓取;以及創新的 AI 增強功能,可透過簡單提示獲取洞察。將網站轉化為結構化資料(CSV、JSON)或即時 API,並與 Google Sheets 和 Airtable 等工具整合。
網頁抓取
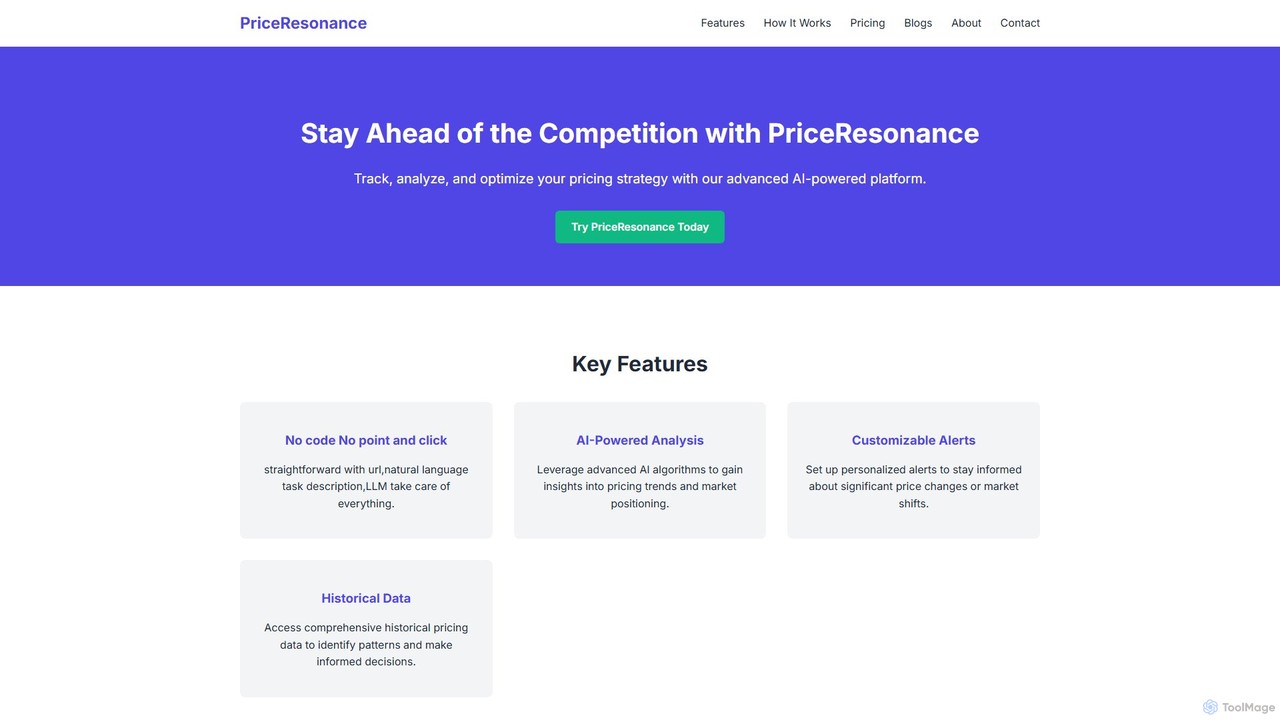
PriceResonance 是一款由人工智慧驅動的競爭情報工具,可簡化價格追蹤和分析。它能自動進行網路爬蟲,監控亞馬遜等電商網站和SaaS平台的競爭對手定價策略,為企業提供可行的見解,以優化定價、保持競爭力並擴大市場份額。
網頁抓取
Scrapybara 是一個為 AI 代理提供雲端虛擬桌面的開發者平台。它支援創建和擴展能夠像人類一樣透過圖形使用者介面(GUI)互動來執行複雜電腦任務的代理。平台提供即時、可擴展的桌面實例(Ubuntu、Windows),配備 Python 和 TypeScript 的 SDK,並支援 OpenAI CUA 等模型。
機器人流程自動化
Bright Data是世界領先的網路數據平台,提供包括代理網路、AI驅動的網路爬蟲和即用型數據集在內的全面工具套件。它使企業能夠為AI訓練、市場研究和競爭情報收集大量公開網路數據。
商業智慧
WebscrapeAI 是一個無需編碼、由人工智能驅動的平台,旨在自動化網路數據收集。只需提供一個URL並指定您需要的數據,人工智能即可處理整個擷取過程。它支援動態網站、批量擷取、代理整合,並為開發人員提供API,使數據提取變得快速、準確且人人可用。
網頁抓取
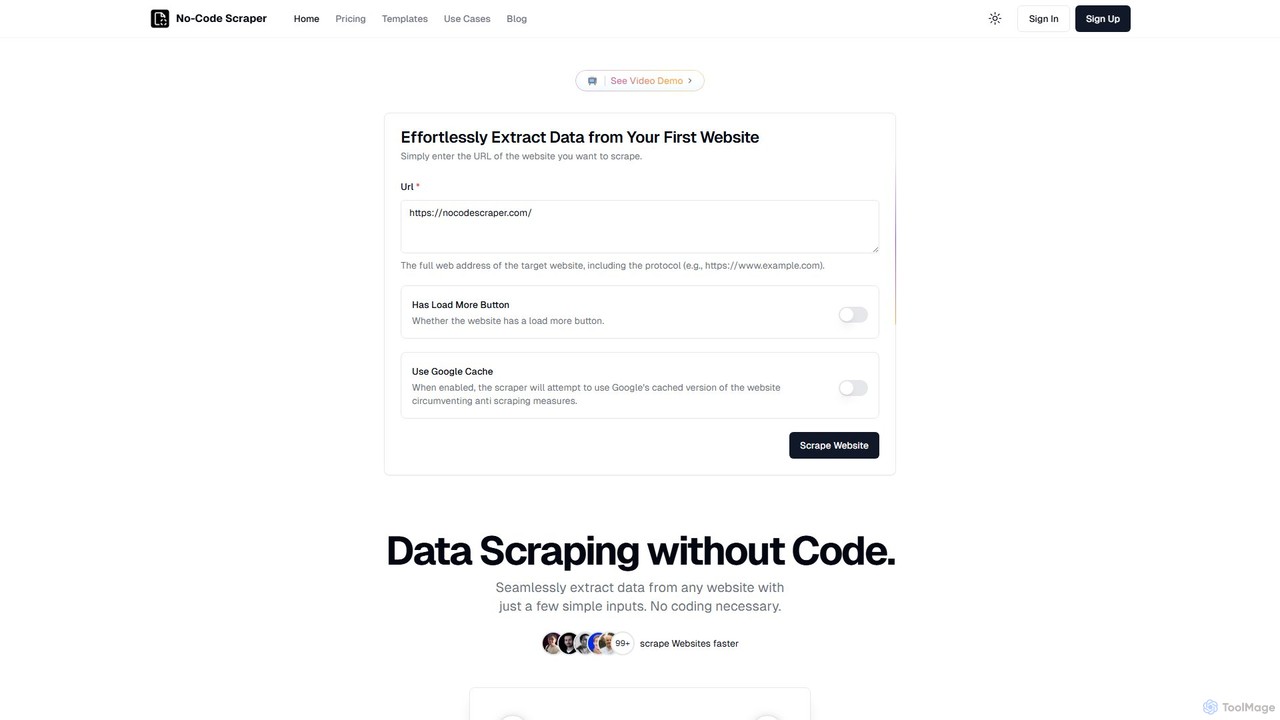
No-Code Scraper 是一個AI驅動的平台,用戶無需編寫任何程式碼即可從任何網站擷取資料。它利用大型語言模型自動進行資料擷取、清理和結構化,使網路爬蟲對每個人來說都變得易於存取、可靠且高效。
網頁抓取
AI網頁抓取工具是一類旨在自動從網站擷取大量資料的應用程式。它們利用AI技術導航複雜的網站結構,處理驗證碼等反抓取措施,並將非結構化的HTML解析為JSON或CSV等結構化格式。這使得企業和研究人員能夠收集即時市場資料、監控競爭對手並彙總資訊,無需人工干預。AI透過適應網站變化和解釋視覺佈局來增強傳統抓取技術,實現更穩健的資料收集。
這些工具廣泛用於電子商務的價格監控、市場行銷的潛在客戶生成、金融領域的另類資料收集以及房地產的市場分析。例如,零售分析師可以使用AI網頁抓取工具每日追蹤數百種競品的價格和庫存水平,並將這些資料直接輸入其定價模型。
選擇工具時,應考慮其處理動態、重JavaScript網站的能力及其對抗反抓取技術的彈性。評估使用者介面——您是需要無程式碼的點選式解決方案,還是功能更強大的面向開發者的API。此外,還需評估其大規模資料擷取的可擴展性,以及定價模式是否符合您的使用頻率和資料需求。
一位電商經理需要為數千種產品維持有競爭力的定價。他們使用AI網頁抓取工具每隔幾小時自動掃描競爭對手的網站。該工具能識別產品頁面,擷取當前價格、庫存狀況和促銷資訊,然後將這些資料結構化並呈現在儀表板中。這個自動化流程取代了數小時的人工檢查,使經理能夠近乎即時地調整自己的定價策略,應對缺貨情況,並最大化銷售機會。
一位銷售開發代表(SDR)的任務是建立特定行業的潛在客戶列表。SDR無需手動瀏覽線上商業目錄或專業網絡,而是配置一個網頁抓取工具來定位這些網站。該工具會擷取公司名稱、聯絡電子郵件、電話號碼以及關鍵決策者的職位。最終生成的結構化列表可以直接匯入CRM系統,為SDR節省超過80%的潛在客戶搜尋時間,使他們能專注於客戶聯繫和互動。
一家消費電子品牌的市場分析師希望了解公眾對新產品發布的情緒反應。他們使用網頁抓取工具從零售網站、科技部落格和社交媒體平台收集數千條客戶評論。該工具的AI功能幫助解析非結構化文本,以識別關鍵主題(如「電池續航」、「螢幕品質」)及相關情緒(正面、負面、中性)。這些匯總的資料提供了一個全面的市場概覽,比人工分析或調查更快地揭示了產品的優缺點。
一家房地產投資公司需要獲取多個城市的最新房產掛牌資訊。他們部署了一個網頁抓取代理,從Zillow、Redfin等各種房地產入口網站和本地仲介網站彙總資料。抓取工具擷取房產地址、價格、面積、臥室數量和上市天數等詳細資訊。這些資料被彙編到一個中央資料庫中,使分析師能夠識別估值偏低的房產、追蹤市場趨勢,並做出資料驅動的投資決策,而無需手動檢查數十個網站。
一家對沖基金的量化分析師尋求另類資料來源以獲得交易優勢。他們使用網頁抓取工具來監控和擷取來自財經新聞網站、監管文件和社交媒體中提及特定股票的資訊。該工具被設定為持續運行,即時捕捉突發新聞和公眾情緒的變化。這個資料流隨後被輸入演算法交易模型,以識別相關性並預測市場動向,提供傳統金融資料來源無法獲得的洞見。
一位大學研究員正在進行一項需要來自數百篇已發表科學研究資料的統合分析。從每篇論文的摘要或表格中手動尋找和擷取資料點將非常耗時。該研究員使用網頁抓取工具自動爬取學術資料庫(如PubMed或Google Scholar),根據關鍵字識別相關論文,並擷取樣本量、研究方法和關鍵發現等特定資訊。這自動化了創建綜合資料集的過程,使得原本不切實際的大規模分析成為可能。
AI網頁抓取是使用經人工智慧增強的自動化工具從網站擷取資料的過程。與依賴固定規則和HTML選擇器的傳統抓取工具不同,AI驅動的工具可以直觀地解釋網頁、理解複雜佈局並適應網站結構的變化。這使得它們更具彈性,能夠從動態、重JavaScript的網站中擷取資料,並處理像驗證碼這樣的反抓取措施。其核心目的是將非結構化的網路內容轉換為結構化的、可用的資料以供分析。
選擇合適的工具取決於您的技術水平和專案複雜性。請考慮以下因素:
主要區別在於資料存取的方式。API(應用程式設計介面)是開發者存取網站資料的結構化、官方途徑。它由網站所有者提供,通常很穩定,並返回乾淨、格式良好的資料(如JSON)。而網頁抓取則是直接從網頁的HTML程式碼中擷取資料——即人類在瀏覽器中看到的內容。當網站沒有為所需資料提供API時,就會使用抓取技術。它更脆弱,因為網站佈局的任何更改都可能導致抓取工具失效。
網頁抓取的合法性很複雜,取決於司法管轄區和被抓取的具體資料。通常,抓取不受版權或個人資料法規保護的公開可用資料通常被認為是允許的。然而,這可能會違反網站的服務條款。至關重要的是要避免抓取個人資料、受版權保護的內容,以及使網站伺服器過載(這可能被視為拒絕服務攻擊)。請始終負責任地、合乎道德地進行抓取。本資訊不構成法律建議;具體情況請諮詢法律專業人士。
幾乎任何在網頁上可見的資料都可以被擷取。常見範例包括:
關鍵在於將這些非結構化資訊轉換為結構化格式,如試算表或資料庫,以便進行分析。