ToolMage
Anmelden

Best 2 Datenorchestrierung AI tools for Entwicklertools

Popular Datenorchestrierung AI tools in Entwicklertools include Dagster und Orchestra, helping you work more efficiently.

Dagster
Freemium

Dagster

Dagster ist ein moderner, Open-Source-Datenorchestrierer, der für das Erstellen, Skalieren und Überwachen von KI- und Datenpipelines entwickelt wurde. Er fungiert als einheitliche Steuerungsebene, die es Teams ermöglicht, Daten-Assets zu modellieren, die Datenherkunft zu verfolgen und die Datenqualität zuverlässig sicherzustellen. Durch die Integration von Best Practices aus der Softwareentwicklung wie lokale Tests und wiederverwendbare Komponenten hilft Dagster Dateningenieuren und ML-Teams, Produkte schneller und zuverlässiger bereitzustellen.

Machine-Learning-Operationen
Visits 161.8KFavorites 158Likes 187
Orchestra
Freemium

Orchestra

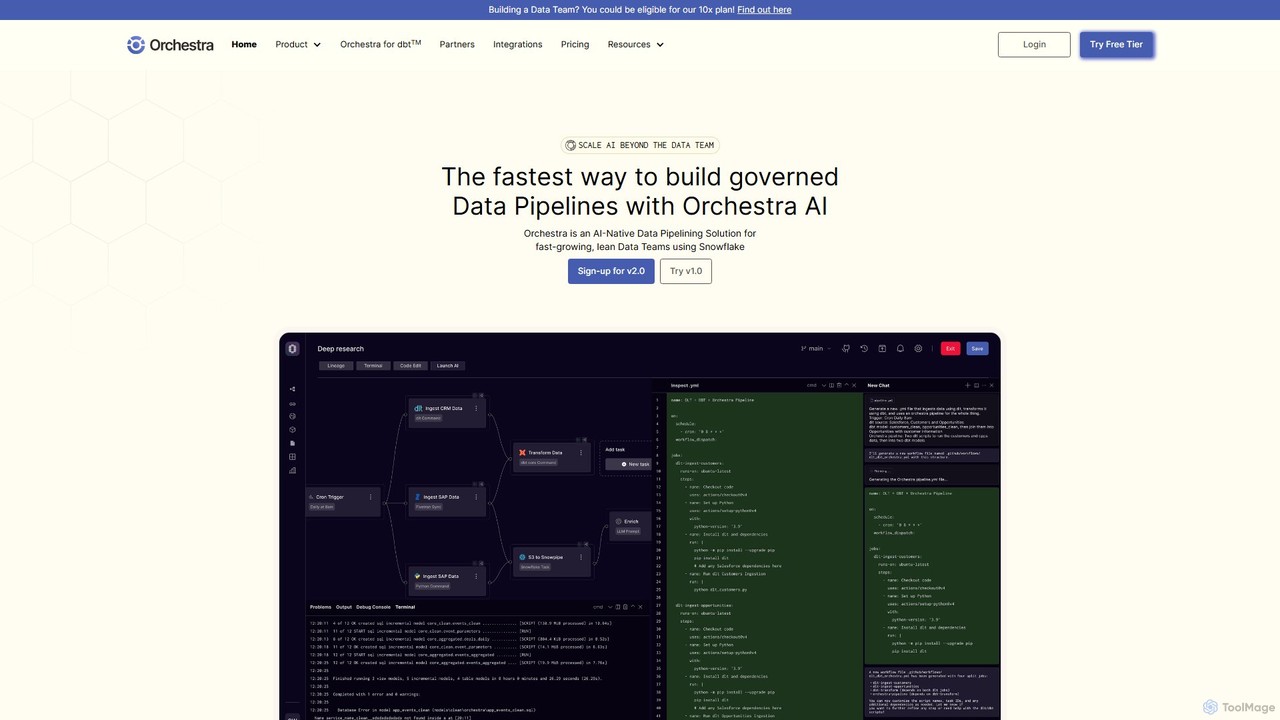
Orchestra ist eine einheitliche Steuerungsebene für Datenorchestrierung und -pipelining, die für schlanke Datenteams entwickelt wurde. Es bietet eine KI-native Lösung zum Erstellen, Überwachen und Verwalten von gesteuerten Datenpipelines mit End-to-End-Beobachtbarkeit, proaktiven Warnungen und umfangreichen Integrationen. Es vereinfacht komplexe Daten-Workflows, reduziert den Wartungsaufwand und stellt sicher, dass Daten zuverlässig und KI-fähig sind.

Business Intelligence
Visits 80.4KFavorites 174Likes 174

About Datenorchestrierung

Datenorchestrierungstools sind eine Klasse von Entwicklertools, die die komplexen Prozesse des Sammelns, Transformierens und Bereitstellens von Daten über verschiedene Systeme hinweg automatisieren. Diese Tools optimieren Datenpipelines und stellen sicher, dass Daten effizient für Analysen, maschinelles Lernen und operative Anforderungen vorbereitet und verschoben werden. Sie bieten eine einheitliche Plattform zur Verwaltung von Datenflüssen, zur Verbesserung der Datenqualität und zur Beschleunigung datengesteuerter Initiativen innerhalb des breiteren Entwickler-Ökosystems.

Kernfunktionen

  • Pipeline-Automatisierung: Automatisiert den gesamten Datenlebenszyklus von der Erfassung bis zur Bereitstellung und reduziert den manuellen Aufwand.
  • Datentransformation: Ermöglicht das Bereinigen, Anreichern und Umstrukturieren von Daten, um den Anforderungen des Zielsystems zu entsprechen.
  • Workflow-Planung: Plant Datenjobs und Abhängigkeiten und gewährleistet eine zeitnahe und geordnete Ausführung.
  • Überwachung & Alarmierung: Bietet Echtzeit-Einblick in den Zustand der Datenpipeline und alarmiert bei Fehlern oder Anomalien.
  • Integrationskonnektoren: Bietet vorgefertigte Konnektoren für verschiedene Datenquellen, Ziele und Verarbeitungs-Engines.

Anwendungsfälle

Datenorchestrierung ist für Organisationen, die große Datenmengen aus unterschiedlichen Quellen verarbeiten, von entscheidender Bedeutung. Sie wird von Dateningenieuren zum Aufbau robuster Datenplattformen, von MLOps-Teams zur Bereitstellung von Trainingsdaten für KI-Modelle und von Business-Intelligence-Analysten zur Sicherstellung aktueller Dashboards eingesetzt.

Auswahlkriterien

Bei der Auswahl eines Datenorchestrierungstools sollten Sie dessen Integrationsfähigkeiten mit Ihrem bestehenden Datenstack, die Skalierbarkeit zur Bewältigung wachsender Datenmengen, die Benutzerfreundlichkeit für die Pipeline-Entwicklung und robuste Überwachungs- und Fehlerbehandlungsfunktionen berücksichtigen. Bewerten Sie die Kosteneffizienz und den Community-Support für eine langfristige Rentabilität.

Datenorchestrierung use cases

1

Automatisierung von Datenpipelines für ML-Modelltraining

Datenwissenschaftler und MLOps-Ingenieure nutzen Datenorchestrierung, um die Extraktion, Transformation und das Laden (ETL) von Rohdaten in für das Training von Machine-Learning-Modellen geeignete Features zu automatisieren. Dies stellt sicher, dass Modelle konsistent mit frischen, hochwertigen Daten trainiert werden, wodurch die manuelle Datenvorbereitungszeit reduziert und die Modellbereitstellungszyklen beschleunigt werden.

2

Erstellung von Echtzeit-Analyse-Dashboards

Business-Intelligence-Teams nutzen Datenorchestrierung, um kontinuierlich Daten aus operativen Datenbanken, Streaming-Quellen und Drittanbieter-APIs zu sammeln, diese dann zu transformieren und in Data Warehouses oder Data Lakes zu laden. Dies ermöglicht die Erstellung von Echtzeit- oder nahezu Echtzeit-Analyse-Dashboards, die aktuelle Einblicke für kritische Geschäftsentscheidungen liefern.

3

Sicherstellung von Datenkonformität und -governance

Datengovernance-Beauftragte und Compliance-Teams nutzen Datenorchestrierung, um automatisierte Datenmaskierungs-, Anonymisierungs- und Auditprozesse über verschiedene Datenspeicher hinweg zu implementieren. Dies stellt sicher, dass sensible Daten während ihres gesamten Lebenszyklus gemäß den gesetzlichen Anforderungen (z. B. DSGVO, CCPA) behandelt werden, wodurch Compliance-Risiken minimiert und die Datenintegrität gewahrt bleiben.

4

Datenmigration zwischen Cloud-Umgebungen

Cloud-Architekten und DevOps-Teams setzen Datenorchestrierung ein, um komplexe Datenmigrationsprojekte zu verwalten, bei denen große Datensätze zwischen verschiedenen Cloud-Anbietern oder zwischen On-Premise- und Cloud-Umgebungen verschoben werden. Diese Tools übernehmen die Datenvalidierung, -transformation und -synchronisation während der Migration, um Datenkonsistenz zu gewährleisten und Ausfallzeiten zu minimieren.

5

Integration unterschiedlicher Geschäftsanwendungen

Unternehmensarchitekten und IT-Manager nutzen Datenorchestrierung, um Daten aus verschiedenen Geschäftsanwendungen wie CRM, ERP und Marketingautomatisierungsplattformen zu integrieren. Durch die Erstellung automatisierter Datenflüsse stellen sie konsistente Daten über Systeme hinweg sicher, ermöglichen eine einheitliche Sicht auf Kunden und Operationen und unterstützen funktionsübergreifende Geschäftsprozesse.

6

Antrieb von KI-gesteuerten Personalisierungs-Engines

Produktmanager und Dateningenieure in E-Commerce- oder Medienunternehmen nutzen Datenorchestrierung, um Benutzerinteraktionsdaten, Produktkataloge und historische Kaufdaten zu sammeln. Diese Daten werden dann verarbeitet und in KI-Personalisierungs-Engines eingespeist, was dynamische Inhaltsempfehlungen, gezielte Werbung und maßgeschneiderte Benutzererlebnisse ermöglicht.

Datenorchestrierung FAQ

Was ist Datenorchestrierung?

Datenorchestrierung ist die automatisierte Verwaltung von Daten-Workflows, die sicherstellt, dass Daten effizient über verschiedene Systeme hinweg verschoben, transformiert und bereitgestellt werden. Sie umfasst die Planung, Überwachung und Verwaltung komplexer Datenpipelines zur Unterstützung von Analysen, maschinellem Lernen und operativen Prozessen.

Wie unterscheidet sich Datenorchestrierung von ETL?

Während ETL (Extrahieren, Transformieren, Laden) eine Kernkomponente ist, ist Datenorchestrierung ein breiteres Konzept. ETL konzentriert sich auf den spezifischen Prozess des Verschiebens und Transformierens von Daten. Orchestrierung umfasst ETL, beinhaltet aber auch die Verwaltung von Abhängigkeiten, die Planung, die Fehlerbehandlung, die Überwachung und die Koordination mehrerer Datenpipelines und Tools über ein gesamtes Datenökosystem hinweg.

Was sind die Hauptvorteile der Verwendung von Datenorchestrierungstools?

Zu den Hauptvorteilen gehören eine erhöhte Effizienz durch Automatisierung, verbesserte Datenqualität und -konsistenz, reduzierte manuelle Fehler, schnellere Erkenntnisgewinnung für Analysen und KI, verbesserte Skalierbarkeit für wachsende Datenmengen und eine bessere Einhaltung von Datengovernance-Richtlinien.

Wer verwendet typischerweise Datenorchestrierungstools?

Datenorchestrierungstools werden hauptsächlich von Dateningenieuren, MLOps-Ingenieuren, Cloud-Architekten und IT-Betriebsteams verwendet. Diese Fachleute sind für den Aufbau, die Wartung und die Überwachung der Datenpipelines verantwortlich, die die datengesteuerten Anwendungen und Analysen eines Unternehmens antreiben.

Was sollte ich bei der Auswahl einer Datenorchestrierungsplattform beachten?

Bei der Auswahl einer Plattform sollten Sie deren Integrationsfähigkeiten mit Ihren bestehenden Datenquellen und Tools, ihre Skalierbarkeit für zukünftiges Wachstum, die Robustheit ihrer Überwachungs- und Alarmierungsfunktionen, ihre Benutzerfreundlichkeit für die Pipeline-Entwicklung und ihre Unterstützung für verschiedene Datentransformationstechniken berücksichtigen. Bewerten Sie auch das Kostenmodell und den Community-Support.