Baseten
Bereitstellung
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
Bereitstellung
Bereitstellung
Baseten ist eine produktionsreife Inferenzplattform für die Bereitstellung, Skalierung und Verwaltung von KI-Modellen. Sie bietet hochleistungsfähige Laufzeitumgebungen, nahtlose Entwickler-Workflows und flexible Bereitstellungsoptionen (Cloud, Self-Hosted, Hybrid). Ideal für Ingenieur- und ML-Teams, die geschäftskritische KI-Anwendungen erstellen.
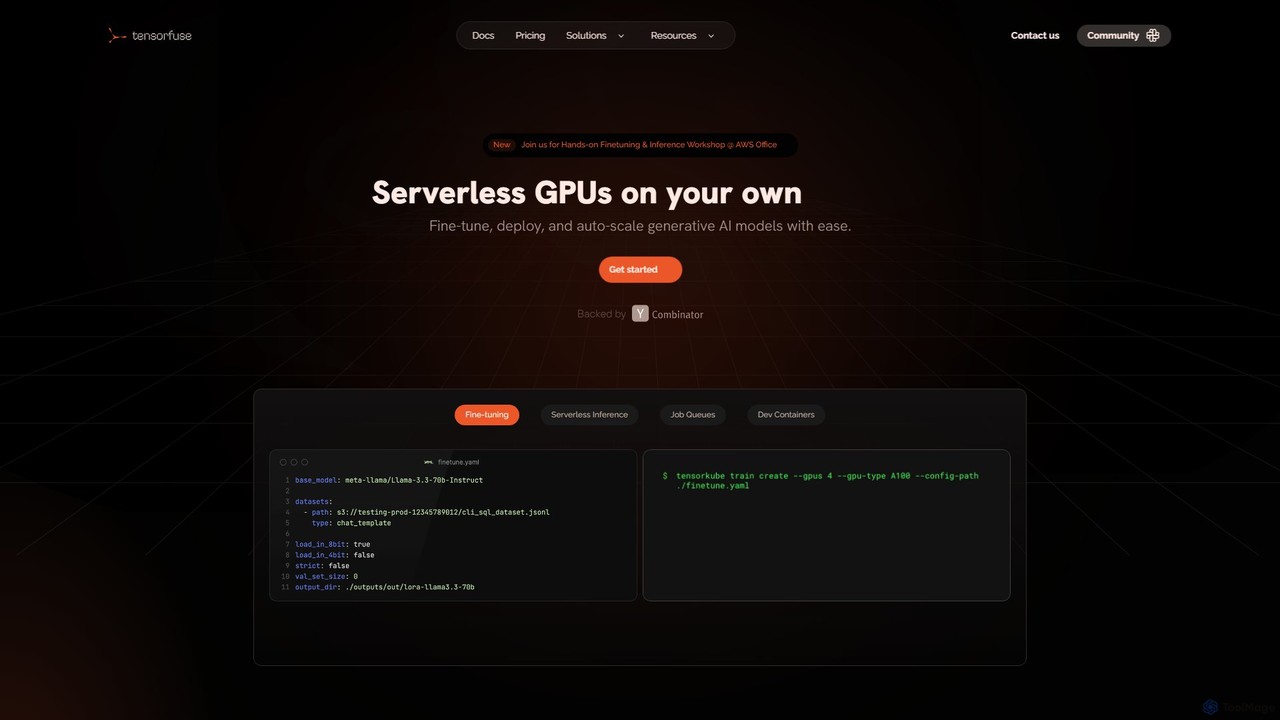
Tensorfuse ist eine serverlose GPU-Plattform, die es Entwicklern ermöglicht, generative KI-Modelle in ihrer eigenen AWS-Cloud zu optimieren, bereitzustellen und automatisch zu skalieren. Sie vereinfacht das Infrastrukturmanagement und bietet Funktionen wie serverlose Inferenz, Job-Warteschlangen und Entwicklungscontainer, um die Entwicklung zu beschleunigen, Kosten zu senken und den DevOps-Aufwand zu eliminieren.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Kerndaten | Baseten | Tensorfuse |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | Bereitstellung | Bereitstellung |
| Zielgruppen und Rollen | KI-Forscher · Chief Technology Officer · Datenwissenschaftler · Machine Learning Ingenieur · Produktmanager · Softwareentwickler | Nicht verifiziert |
| Kategorien | Bereitstellung · Maschinelles Lernen · Cloud Computing | Bereitstellung · MLOps · Cloud Computing |
| Added | 01.11.2025 | 15.08.2025 |
| Aktualisiert | 19.11.2026 | 19.11.2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
Baseten ist eine umfassende Plattform, die für die Bereitstellung, das Servieren und die Skalierung von KI-Modellen in Produktionsumgebungen konzipiert ist. Sie bietet die notwendige Infrastruktur, Werkzeuge und Expertise, um KI-Produkte schnell und effizient auf den Markt zu bringen. Angetrieben durch den Baseten Inference Stack, liefert sie performante Modell-Laufzeitumgebungen, cloudübergreifende Hochverfügbarkeit und eine entwicklerzentrierte Erfahrung für geschäftskritische Inferenz-Workloads.
1. Wählen Sie Ihre Bereitstellungsmethode: Nutzen Sie die Modell-APIs für den sofortigen Zugriff auf voroptimierte Modelle zum Prototyping oder erstellen Sie ein dediziertes Deployment für benutzerdefinierte, feinabgestimmte oder Open-Source-Modelle.
2. Verpacken Sie Ihr Modell mit Truss, dem Open-Source-Standard von Baseten, der jedes Machine-Learning-Framework unterstützt.
3. Stellen Sie Ihr Modell in Ihrer bevorzugten Umgebung bereit: der vollständig verwalteten Cloud von Baseten, Ihrer eigenen VPC für das Self-Hosting oder einem hybriden Setup, das beides kombiniert.
4. Skalieren Sie Ihre Anwendung automatisch basierend auf dem Datenverkehr und profitieren Sie von Funktionen wie schnellen Kaltstarts und 99,99 % Verfügbarkeit.
5. Optional können Sie die für Inferenz optimierte Infrastruktur von Baseten nutzen, um Ihre Modelle für die bestmögliche Produktionsleistung zu trainieren.
Baseten ist ideal für die Erstellung anspruchsvoller Echtzeit-KI-Anwendungen. Anwendungsfälle umfassen die Bereitstellung von KI-Telefonagenten mit geringer Latenz, die Entwicklung generativer KI-Produkte zur Erstellung von Bildern und Texten, das Servieren von Embedding-Modellen mit hohem Durchsatz für Suche und Abruf sowie die Bereitstellung maßgeschneiderter LLMs für spezialisierte Branchen wie Finanzen und Gesundheitswesen.
Die Hauptvorteile von Baseten sind seine außergewöhnliche Leistung, Kosteneffizienz und Skalierbarkeit. Durch die Optimierung des gesamten Inferenz-Stacks reduziert es die Latenz erheblich und erhöht den Durchsatz, wie die Unterstützung von Kunden wie Bland AI bei der Erreichung von Antwortzeiten unter 400 ms zeigt. Sein Pay-per-Use-Modell eliminiert Kosten für Leerlaufzeiten, während die verkehrsbasierte Autoskalierung die Zuverlässigkeit bei schnellem Wachstum gewährleistet. Die Plattform ist zudem SOC 2 Typ II zertifiziert und HIPAA-konform, was unternehmensgerechte Sicherheit gewährleistet.
Baseten bietet eine gestaffelte Preisstruktur, die auf Wachstum ausgelegt ist:
- Basic: Ein Pay-as-you-go-Plan ab 0 $ pro Monat. Er beinhaltet den Zugang zu dedizierten Deployments, Modell-APIs, schnellen Kaltstarts und ist SOC 2 Typ II- und HIPAA-konform.
- Pro: Ein Plan mit individuellem Angebot, der priorisierten Zugang zu stark nachgefragten GPUs, dedizierte Rechenleistung, höhere Ratenbegrenzungen und praktischen Support über Slack und Zoom hinzufügt.
- Enterprise: Ein Plan mit individuellem Angebot für volle Kontrolle, der Self-Hosting in Ihrer VPC, benutzerdefinierte SLAs, erweiterte Sicherheit und die Möglichkeit zur Nutzung bestehender Cloud-Verpflichtungen bietet.
Die Nutzung wird nach zwei Modellen abgerechnet:
- Modell-APIs: Preis pro 1 Million Eingabe- und Ausgabetoken. Zum Beispiel kostet Kimi K2 0,60 $/1 Mio. Eingabetoken und 2,50 $/1 Mio. Ausgabetoken.
- Dedizierte Deployments: Abrechnung pro Minute Rechenzeit. Zum Beispiel kostet eine A10G-GPU-Instanz 0,02012 $ pro Minute und eine H100-GPU 0,10833 $ pro Minute.
Tensorfuse bietet eine leistungsstarke Plattform für Entwickler und Organisationen, um serverlose GPUs direkt in ihrer eigenen AWS-Cloud-Infrastruktur zu verwalten. Es wurde entwickelt, um den gesamten Lebenszyklus von generativen KI-Modellen zu optimieren, von der Feinabstimmung und dem Experimentieren bis hin zur Bereitstellung und automatischen Skalierung in der Produktion. Durch die Abstraktion der Komplexität von Kubernetes, Docker und der Infrastrukturbereitstellung ermöglicht Tensorfuse den Teams, sich auf die Erstellung von KI-Anwendungen zu konzentrieren, was die Markteinführungszeit und die Betriebskosten erheblich reduziert.
Die Plattform wurde entwickelt, um das Beste aus beiden Welten zu bieten: die Einfachheit einer serverlosen Architektur und die Sicherheit und Kontrolle des Betriebs in Ihrer privaten Cloud. Das bedeutet, dass Ihre proprietären Daten und Modellgewichte niemals Ihre privaten S3-Buckets verlassen, was maximale Sicherheit und Compliance gewährleistet. Tensorfuse ist auf Effizienz ausgelegt, mit einer optimierten Container-Laufzeit, die schnelle Kaltstarts für schwere GPU-Workloads ermöglicht, sodass Dienste in Sekunden von null skalieren können.
Der Einstieg in Tensorfuse ist als unkomplizierter Prozess konzipiert:
Tensorfuse ist ideal für eine Vielzahl von KI/ML-Anwendungen:
Benutzer entscheiden sich für Tensorfuse wegen seiner erheblichen Vorteile, darunter eine gemeldete Reduzierung der Cloud-GPU-Ausgaben um 30 % und eine 20-mal schnellere Markteinführungszeit. Es eliminiert die Notwendigkeit komplexer, selbstverwalteter DevOps-Lösungen und setzt so Engineering-Ressourcen frei. Die Plattform bietet die Leistung und Skalierbarkeit eines verwalteten Dienstes mit der Sicherheit und den Kostenvorteilen des Betriebs in der eigenen Cloud. Testimonials heben das außergewöhnliche und reaktionsschnelle Support-Team hervor, das bei der Migration und bei laufenden Problemen hilft und den Onboarding-Prozess reibungslos und effizient gestaltet.
Tensorfuse bietet eine gestaffelte Preisstruktur, um unterschiedlichen Anforderungen gerecht zu werden:
Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.
Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 70.97% | 188.5K |
| 🇨🇦Canada | 8.11% | 21.5K |
| 🇻🇳Vietnam | 7.87% | 20.9K |
| 🇮🇳India | 7% | 18.6K |
| 🇩🇪Germany | 6.05% | 16.1K |
| Source type | Percentage | Estimated visits |
|---|---|---|
| Direkt | 85.63% | 227.4K |
| Verweis | 10.77% | 28.6K |
| 3.6% | 9.6K |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 38.24% | 2.6K |
| 🇻🇳Vietnam | 36.56% | 2.5K |
| 🇮🇳India | 25.2% | 1.7K |
Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.
Sie können sowohl Open-Source- als auch benutzerdefinierte Modelle auf Baseten bereitstellen. Die Plattform unterstützt jedes Modell, das in einem beliebigen Framework erstellt wurde, durch Truss, ihren Open-Source-Standard zum Verpacken und Servieren von Modellen. Sie können auch mit Standardmodellen aus der Baseten-Modellbibliothek beginnen.
Sie haben die volle Kontrolle darüber, welche GPUs Ihre Modelle verwenden. Baseten stellt eine vollständige Liste der derzeit verfügbaren GPUs in seiner Instanztypenreferenz zur Verfügung. Wenn Sie einen bestimmten GPU-Typ benötigen, der nicht aufgeführt ist, können Sie sich an ihr Team wenden, um ihn anzufordern.
Nein, Sie bezahlen nicht für Leerlaufzeiten. Sie bezahlen nur für die Zeit, in der Ihr Modell aktiv Rechenleistung auf Baseten nutzt, was die Bereitstellung, das Hoch- oder Herunterskalieren oder das Erstellen von Vorhersagen einschließt. Sie haben die volle Kontrolle über das Skalierungsverhalten Ihres Modells.
Ja, Baseten ist SOC 2 Typ II zertifiziert und HIPAA-konform, was sicherstellt, dass es hohe Standards für Sicherheit und Datenschutz erfüllt, die für Unternehmens- und Gesundheitsanwendungen geeignet sind.
Ja, mit dem Enterprise-Plan können Sie Baseten in Ihren eigenen VPCs selbst hosten. Dies ermöglicht Ihnen die volle Kontrolle über Sicherheit, Datenresidenz und die Nutzung Ihrer bestehenden Cloud-Verpflichtungen.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.