

Baseten Overview
Baseten ist eine umfassende Plattform, die für die Bereitstellung, das Servieren und die Skalierung von KI-Modellen in Produktionsumgebungen konzipiert ist. Sie bietet die notwendige Infrastruktur, Werkzeuge und Expertise, um KI-Produkte schnell und effizient auf den Markt zu bringen. Angetrieben durch den Baseten Inference Stack, liefert sie performante Modell-Laufzeitumgebungen, cloudübergreifende Hochverfügbarkeit und eine entwicklerzentrierte Erfahrung für geschäftskritische Inferenz-Workloads.
Wie man Baseten verwendet
1. Wählen Sie Ihre Bereitstellungsmethode: Nutzen Sie die Modell-APIs für den sofortigen Zugriff auf voroptimierte Modelle zum Prototyping oder erstellen Sie ein dediziertes Deployment für benutzerdefinierte, feinabgestimmte oder Open-Source-Modelle.
2. Verpacken Sie Ihr Modell mit Truss, dem Open-Source-Standard von Baseten, der jedes Machine-Learning-Framework unterstützt.
3. Stellen Sie Ihr Modell in Ihrer bevorzugten Umgebung bereit: der vollständig verwalteten Cloud von Baseten, Ihrer eigenen VPC für das Self-Hosting oder einem hybriden Setup, das beides kombiniert.
4. Skalieren Sie Ihre Anwendung automatisch basierend auf dem Datenverkehr und profitieren Sie von Funktionen wie schnellen Kaltstarts und 99,99 % Verfügbarkeit.
5. Optional können Sie die für Inferenz optimierte Infrastruktur von Baseten nutzen, um Ihre Modelle für die bestmögliche Produktionsleistung zu trainieren.
Kernfunktionen von Baseten
- Baseten Inference Stack: Eine Hochleistungs-Engine mit benutzerdefinierten Kernels, fortschrittlichem Caching und den neuesten Dekodierungstechniken für geringere Latenz und höheren Durchsatz.
- Flexible Bereitstellungsoptionen: Wählen Sie zwischen Baseten Cloud (vollständig verwaltet), Self-Hosted (in Ihrer VPC) und hybriden Bereitstellungen, um Sicherheits- und Leistungsanforderungen zu erfüllen.
- Breite Modellunterstützung: Stellen Sie jedes benutzerdefinierte, proprietäre oder Open-Source-Modell bereit, einschließlich LLMs, Bildgenerierungsmodelle (wie ComfyUI-Workflows), Transkription und Text-to-Speech.
- Produktionsreife Modell-APIs: Greifen Sie sofort auf eine Bibliothek beliebter Modelle wie DeepSeek, Kimi und Qwen zu und bewerten Sie diese mit produktionsreifer Leistung.
- Cloud-native Infrastruktur: Bietet automatisches Skalieren, globale Regionsunterstützung über jeden Cloud-Anbieter, blitzschnelle Kaltstarts und eine Verfügbarkeitsgarantie von 99,99 %.
- Compound AI Chains: Ermöglicht eine granulare Hardwaresteuerung und Autoskalierung für komplexe KI-Workflows mit mehreren Modellen, was die GPU-Auslastung verbessert und die Latenz reduziert.
- Experten-Engineering-Support: Zugang zu Forward-Deployed-Engineers für praktische Unterstützung vom Prototyp bis zur Produktion.
Anwendungsfälle für Baseten
Baseten ist ideal für die Erstellung anspruchsvoller Echtzeit-KI-Anwendungen. Anwendungsfälle umfassen die Bereitstellung von KI-Telefonagenten mit geringer Latenz, die Entwicklung generativer KI-Produkte zur Erstellung von Bildern und Texten, das Servieren von Embedding-Modellen mit hohem Durchsatz für Suche und Abruf sowie die Bereitstellung maßgeschneiderter LLMs für spezialisierte Branchen wie Finanzen und Gesundheitswesen.
Vorteile von Baseten
Die Hauptvorteile von Baseten sind seine außergewöhnliche Leistung, Kosteneffizienz und Skalierbarkeit. Durch die Optimierung des gesamten Inferenz-Stacks reduziert es die Latenz erheblich und erhöht den Durchsatz, wie die Unterstützung von Kunden wie Bland AI bei der Erreichung von Antwortzeiten unter 400 ms zeigt. Sein Pay-per-Use-Modell eliminiert Kosten für Leerlaufzeiten, während die verkehrsbasierte Autoskalierung die Zuverlässigkeit bei schnellem Wachstum gewährleistet. Die Plattform ist zudem SOC 2 Typ II zertifiziert und HIPAA-konform, was unternehmensgerechte Sicherheit gewährleistet.
Preise und Pläne
Baseten bietet eine gestaffelte Preisstruktur, die auf Wachstum ausgelegt ist:
- Basic: Ein Pay-as-you-go-Plan ab 0 $ pro Monat. Er beinhaltet den Zugang zu dedizierten Deployments, Modell-APIs, schnellen Kaltstarts und ist SOC 2 Typ II- und HIPAA-konform.
- Pro: Ein Plan mit individuellem Angebot, der priorisierten Zugang zu stark nachgefragten GPUs, dedizierte Rechenleistung, höhere Ratenbegrenzungen und praktischen Support über Slack und Zoom hinzufügt.
- Enterprise: Ein Plan mit individuellem Angebot für volle Kontrolle, der Self-Hosting in Ihrer VPC, benutzerdefinierte SLAs, erweiterte Sicherheit und die Möglichkeit zur Nutzung bestehender Cloud-Verpflichtungen bietet.
Die Nutzung wird nach zwei Modellen abgerechnet:
- Modell-APIs: Preis pro 1 Million Eingabe- und Ausgabetoken. Zum Beispiel kostet Kimi K2 0,60 $/1 Mio. Eingabetoken und 2,50 $/1 Mio. Ausgabetoken.
- Dedizierte Deployments: Abrechnung pro Minute Rechenzeit. Zum Beispiel kostet eine A10G-GPU-Instanz 0,02012 $ pro Minute und eine H100-GPU 0,10833 $ pro Minute.
Baseten FAQ
Traffic
Latest traffic
Status
Monthly traffic trend
- 2026-1: 197.3K
- 2026-2: 205.0K
- 2026-3: 246.2K
- 2026-4: 247.6K
- 2026-5: 265.6K
Geography
Top 5 countries / regions
- 🇺🇸Vereinigte Staaten71.0%
- 🇨🇦Kanada8.1%
- 🇻🇳Vietnam7.9%
- 🇮🇳Indien7.0%
- 🇩🇪Deutschland6.0%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 85.6% |
Referral | 10.8% |
Email | 3.6% |
Top keywords
| Keyword | Cost per click |
|---|---|
| baseten | $4.41 |
| baseten careers | $0.29 |
| fireworks ai | $0.00 |
| kimi ai | $0.38 |
| together ai | $3.77 |
Baseten Videos on YouTube

Baseten


Vatsal Bajaj
No Priors: AI, Machine Learning, Tech, & Startups

Google Cloud
Baseten Alternatives
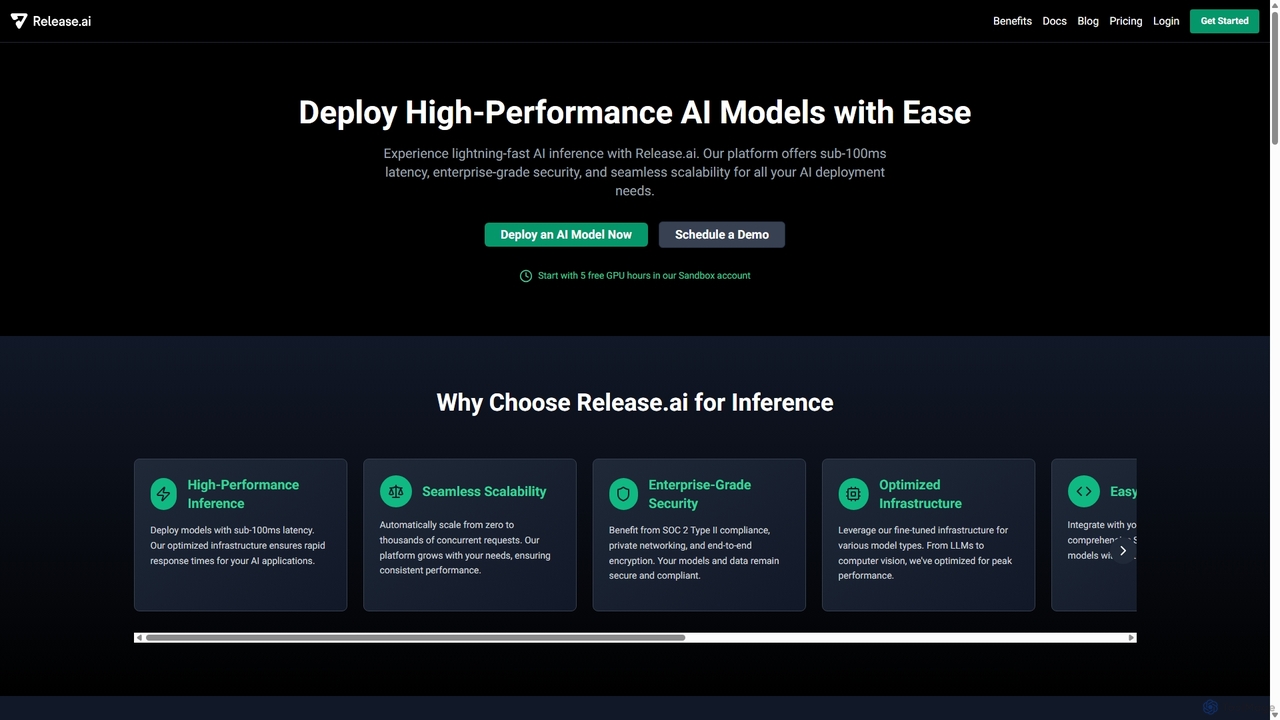
Release.ai
Release.ai ist eine unternehmenstaugliche Plattform für Entwickler zur einfachen Bereitstellung, Verwaltung und Skalierung von Hochleistungs-KI-Modellen. Sie bietet eine Inferenzlatenz von unter 100 ms, nahtloses Auto-Scaling, robuste Sicherheit und eine riesige Bibliothek voroptimierter Modelle, die eine schnelle Integration in jeden Entwicklungsworkflow mit nur wenigen Codezeilen ermöglicht.
Plattform als Dienst (PaaS)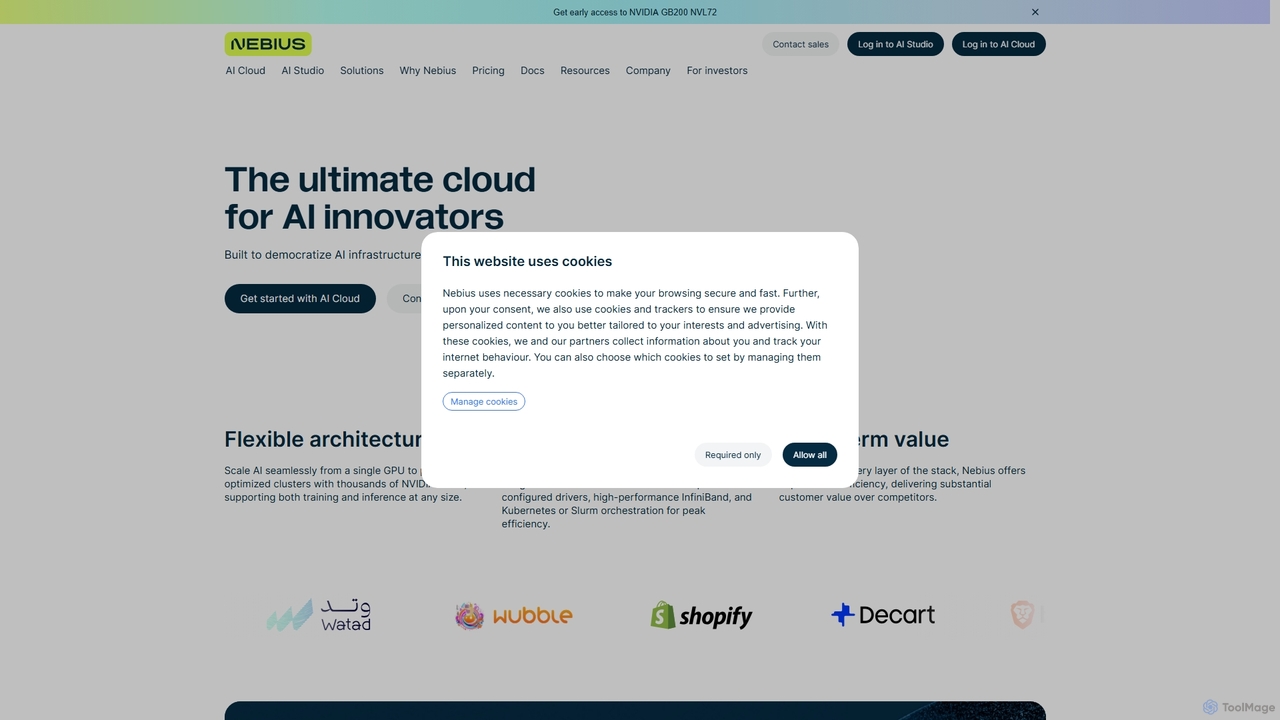
Nebius
Nebius ist eine hochleistungsfähige Cloud-Plattform, die speziell für anspruchsvolle KI- und Machine-Learning-Workloads entwickelt wurde. Sie bietet skalierbaren Zugriff auf die neuesten NVIDIA-GPUs, von einzelnen Instanzen bis hin zu massiven Clustern, ergänzt durch eine Suite von Managed Services und ein integriertes AI Studio, um den gesamten ML-Lebenszyklus vom Training bis zur Inferenz zu optimieren.
GPU-Cloud
Runpod
Runpod ist eine Cloud-Plattform, die für KI und maschinelles Lernen entwickelt wurde und skalierbare GPU-Rechenleistung für die Bereitstellung, das Training und den Betrieb von KI-Modellen bietet. Sie stellt serverlose GPUs, vorgefertigte Vorlagen und kostengünstige Preise zur Verfügung, um den gesamten KI-Entwicklungsworkflow von der Idee bis zur Produktion zu vereinfachen.
Maschinelles Lernen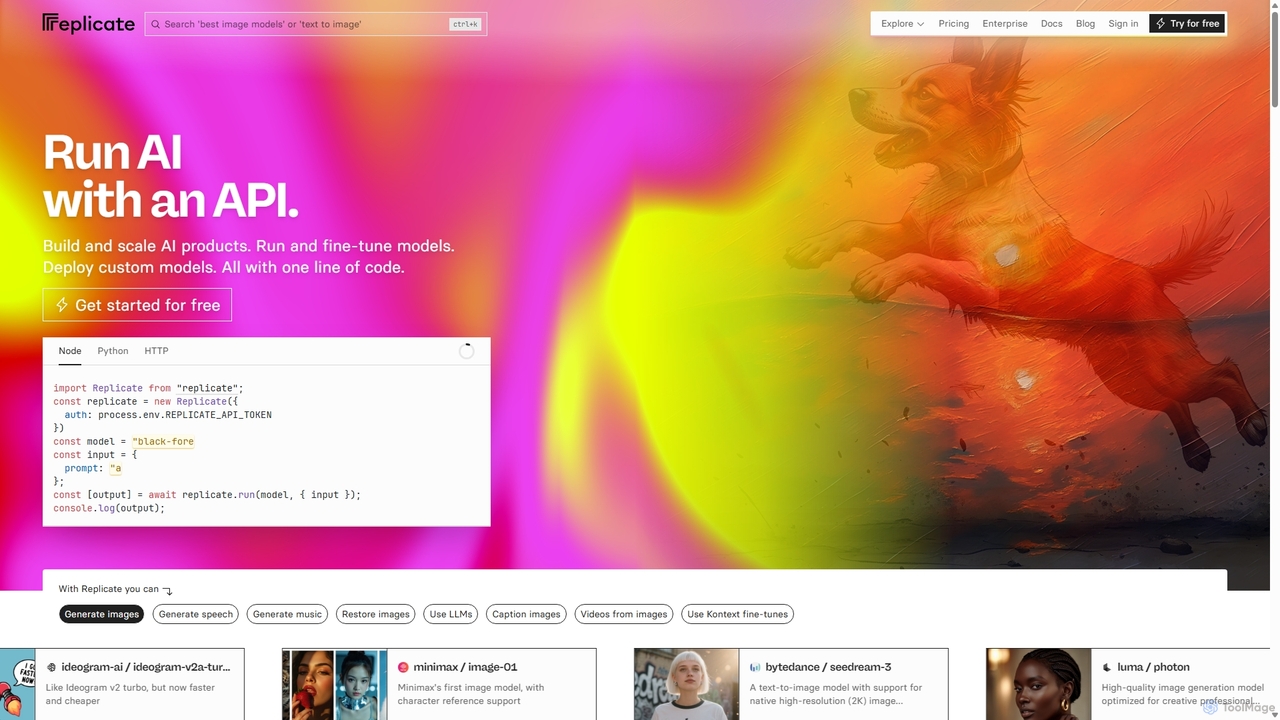
Replicate
Replicate ist eine Cloud-Plattform für Entwickler, um KI-Modelle über eine einfache API auszuführen, zu optimieren und bereitzustellen. Sie eliminiert die Notwendigkeit, komplexe Infrastrukturen zu verwalten, und bietet Zugriff auf Tausende von Modellen mit Pay-per-Use-Preisen und automatischer Skalierung.
Maschinelles Lernen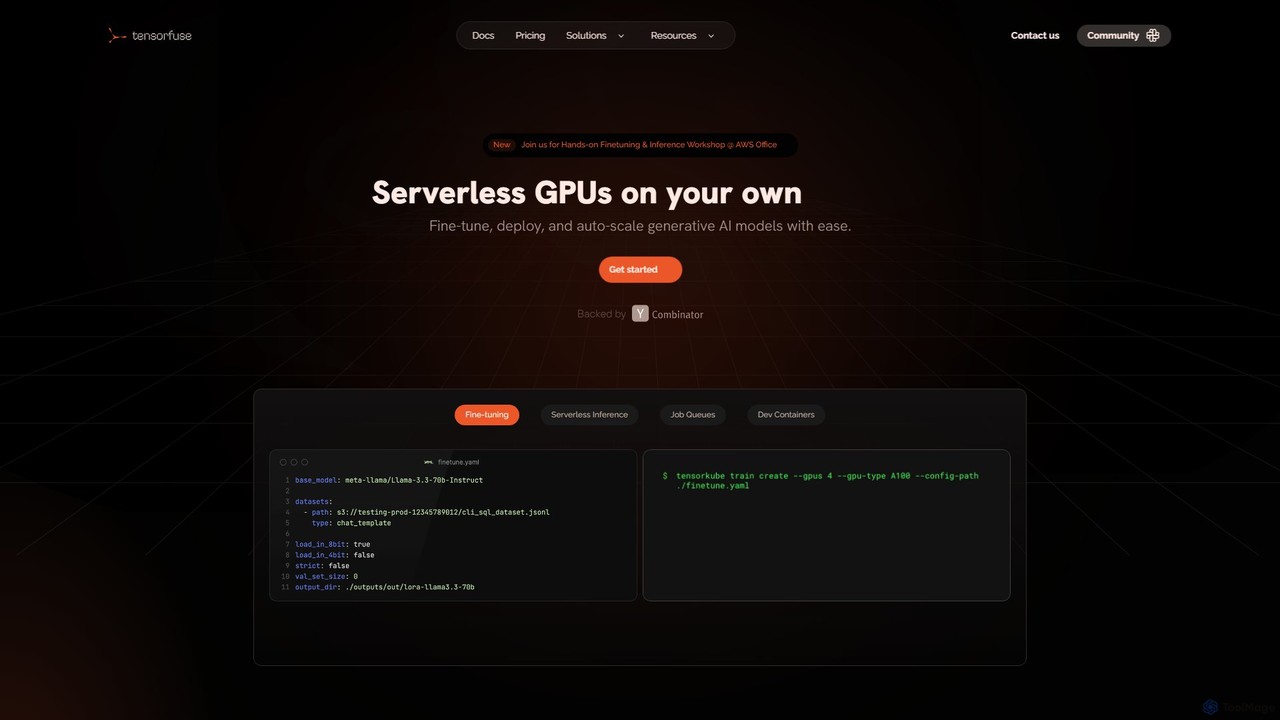
Tensorfuse
Tensorfuse ist eine serverlose GPU-Plattform, die es Entwicklern ermöglicht, generative KI-Modelle in ihrer eigenen AWS-Cloud zu optimieren, bereitzustellen und automatisch zu skalieren. Sie vereinfacht das Infrastrukturmanagement und bietet Funktionen wie serverlose Inferenz, Job-Warteschlangen und Entwicklungscontainer, um die Entwicklung zu beschleunigen, Kosten zu senken und den DevOps-Aufwand zu eliminieren.
BereitstellungBaseten Categories
Baseten Jobs
Baseten Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Release.ai
Release.ai ist eine unternehmenstaugliche Plattform für Entwickler zur einfachen Bereitstellung, Verwaltung und Skalierung von Hochleistungs-KI-Modellen. Sie bietet eine Inferenzlatenz von unter 100 ms, nahtloses Auto-Scaling, robuste Sicherheit und eine riesige Bibliothek voroptimierter Modelle, die eine schnelle Integration in jeden Entwicklungsworkflow mit nur wenigen Codezeilen ermöglicht.
Plattform als Dienst (PaaS)Nebius
Nebius ist eine hochleistungsfähige Cloud-Plattform, die speziell für anspruchsvolle KI- und Machine-Learning-Workloads entwickelt wurde. Sie bietet skalierbaren Zugriff auf die neuesten NVIDIA-GPUs, von einzelnen Instanzen bis hin zu massiven Clustern, ergänzt durch eine Suite von Managed Services und ein integriertes AI Studio, um den gesamten ML-Lebenszyklus vom Training bis zur Inferenz zu optimieren.
GPU-CloudReplicate
Replicate ist eine Cloud-Plattform für Entwickler, um KI-Modelle über eine einfache API auszuführen, zu optimieren und bereitzustellen. Sie eliminiert die Notwendigkeit, komplexe Infrastrukturen zu verwalten, und bietet Zugriff auf Tausende von Modellen mit Pay-per-Use-Preisen und automatischer Skalierung.
Maschinelles Lernen
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung
LangDrive
LangDrive ist eine entwicklerzentrierte Plattform, die eine einheitliche API zum Finetuning, Verwalten und Bereitstellen von Open-Source Large Language Models (LLMs) bietet. Sie vereinfacht die komplexe MLOps-Pipeline und ermöglicht es Unternehmen, leistungsstarke, benutzerdefinierte KI-Modelle für spezielle Aufgaben mit größerer Kontrolle über Daten und Kosten zu erstellen.
API-Management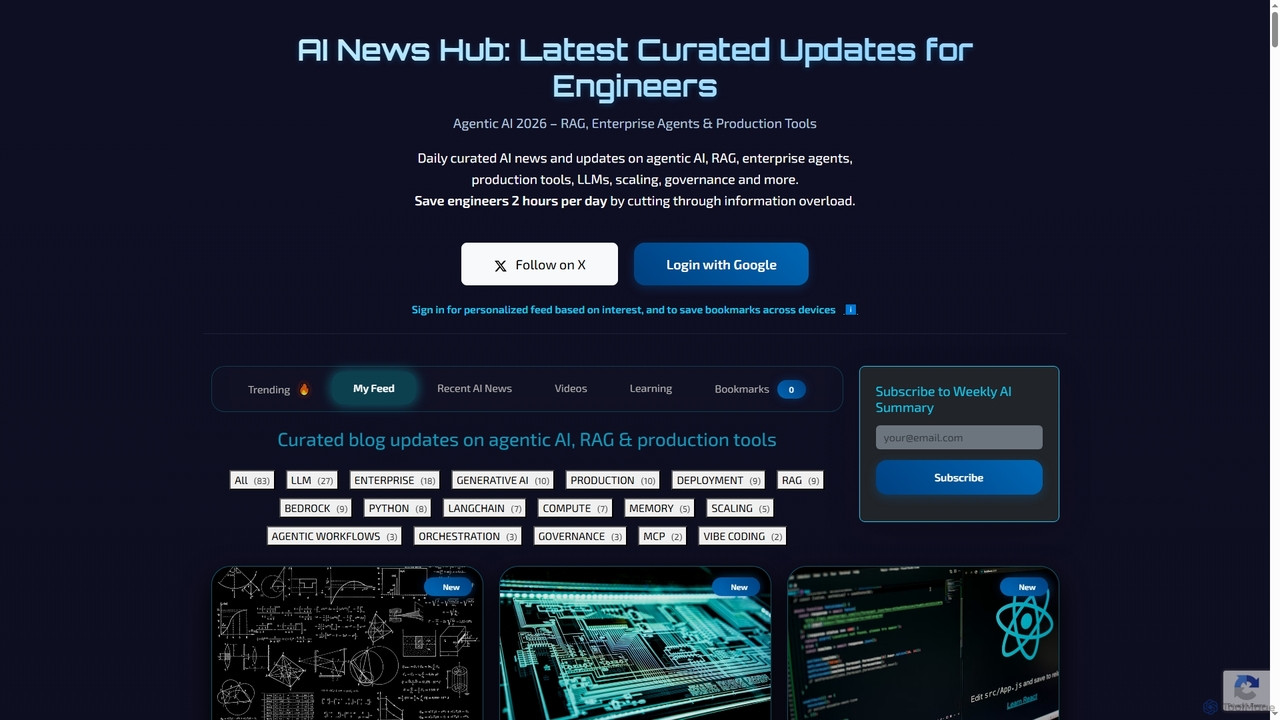
AI News Hub
AI News Hub ist eine umfassende Plattform, die Echtzeit-KI-Ankündigungen, kuratierte Blog-Updates zu agentischer KI, RAG und Produktionstools bereitstellt. Sie bietet einen personalisierten Feed, Lesezeichenfunktionen und eine reichhaltige Sammlung von Lernressourcen, einschließlich Roadmaps, Kursen und Videos, um Entwickler und Enthusiasten in der sich schnell entwickelnden KI-Landschaft auf dem Laufenden und kompetent zu halten.
Aggregation
Ollama
Ollama ist ein leistungsstarkes Open-Source-Framework zum lokalen Ausführen von großen Sprachmodellen (LLMs) wie Llama 3, Mistral und Gemma auf Ihrer eigenen Hardware. Verfügbar für macOS, Windows und Linux, vereinfacht es die Einrichtung und Verwaltung von Open-Source-Modellen und ermöglicht eine private, offline-fähige und kostengünstige KI-Entwicklung und -Nutzung.
Maschinelles LernenRunpod
Runpod ist eine Cloud-Plattform, die für KI und maschinelles Lernen entwickelt wurde und skalierbare GPU-Rechenleistung für die Bereitstellung, das Training und den Betrieb von KI-Modellen bietet. Sie stellt serverlose GPUs, vorgefertigte Vorlagen und kostengünstige Preise zur Verfügung, um den gesamten KI-Entwicklungsworkflow von der Idee bis zur Produktion zu vereinfachen.
Maschinelles LernenTensorfuse
Tensorfuse ist eine serverlose GPU-Plattform, die es Entwicklern ermöglicht, generative KI-Modelle in ihrer eigenen AWS-Cloud zu optimieren, bereitzustellen und automatisch zu skalieren. Sie vereinfacht das Infrastrukturmanagement und bietet Funktionen wie serverlose Inferenz, Job-Warteschlangen und Entwicklungscontainer, um die Entwicklung zu beschleunigen, Kosten zu senken und den DevOps-Aufwand zu eliminieren.
Bereitstellung
Grably
Grably ist ein dezentrales Datenbesitz-Netzwerk (DeDON), das hochwertige, ethisch einwandfreie KI-Trainingsdaten bereitstellt. Es bietet eine riesige Sammlung von Standard-Datensätzen, benutzerdefinierte Datenerfassung, Kuratierung und Annotationsdienste, um die KI-Entwicklung zu beschleunigen und es den Nutzern zu ermöglichen, ihre Daten sicher und transparent zu monetarisieren.
Datenbeschriftung
Avian
Avian ist eine hochleistungsfähige KI-Inferenzplattform, die Weltrekordgeschwindigkeiten für große Sprachmodelle (LLMs) bietet. Sie stellt sowohl eine serverlose API für beliebte Modelle als auch dedizierte GPU-Deployments für benutzerdefinierte Modelle von HuggingFace bereit. Avian ist auf Skalierbarkeit und Produktions-Workloads ausgelegt und liefert 3-10x schnellere Inferenzgeschwindigkeiten als der Branchendurchschnitt, mit unternehmenstauglicher Sicherheit und wettbewerbsfähigen Preisen.
Modellbereitstellung
UltiHash
UltiHash ist eine hochleistungsfähige, Kubernetes-native Objektspeicherplattform, die speziell für KI- und Big-Data-Workloads entwickelt wurde. Sie bietet blitzschnellen Datenzugriff, erhebliche Kosteneinsparungen durch fortschrittliche Deduplizierung auf Byte-Ebene und flexible Bereitstellung in Cloud-, On-Premises- oder Hybrid-Umgebungen. Die S3-kompatible API gewährleistet eine nahtlose Integration in bestehende Daten-Stacks und KI-Workflows.
Machine Learning Operationen
Shakespeare
Shakespeare ist ein Open-Source-KI-Builder, der für Entwickler konzipiert wurde, um maßgeschneiderte KI-Anwendungen zu erstellen. Er bietet eine Plattform zur Auswahl und Nutzung verschiedener KI-Modelle, was die schnelle Entwicklung und Bereitstellung intelligenter Lösungen ermöglicht.
KI-Entwicklung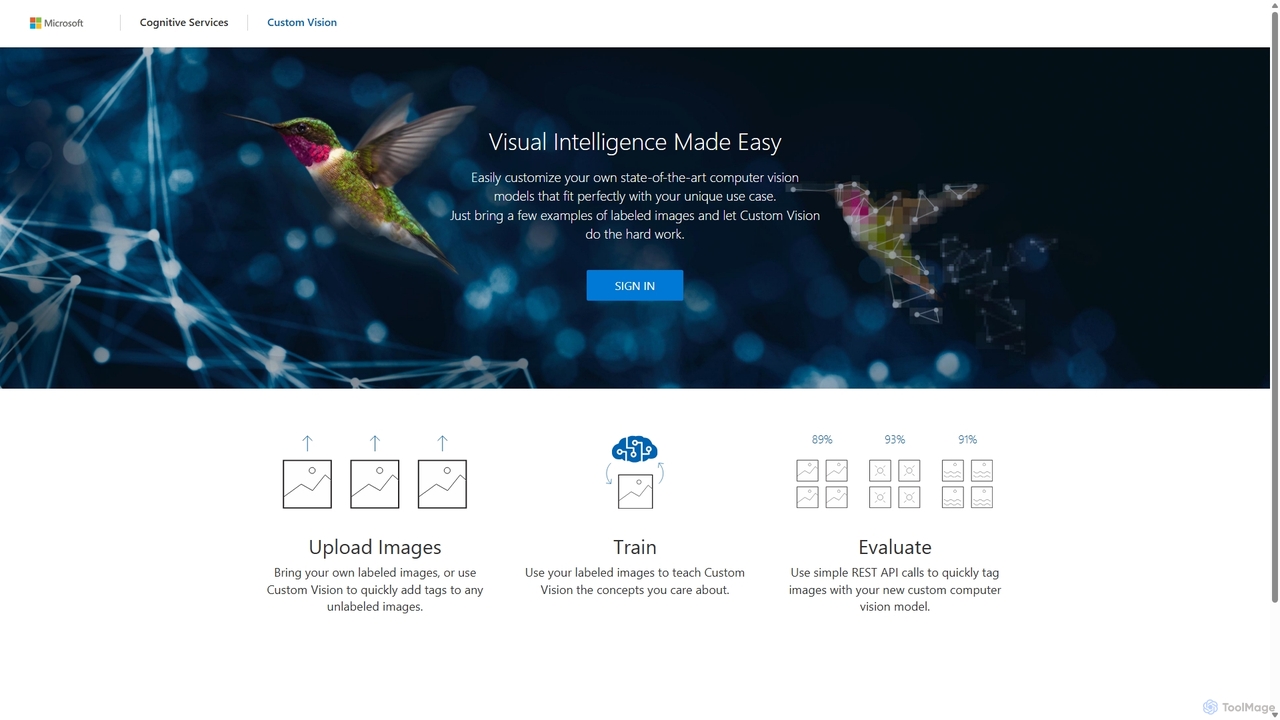
Custom Vision
Ein KI-Dienst von Microsoft Azure, mit dem Sie Ihre eigenen benutzerdefinierten Bildklassifikatoren und Objektdetektoren erstellen, bereitstellen und verbessern können. Erstellen Sie mühelos hochmoderne Computer-Vision-Modelle, die auf Ihre spezifischen Bedürfnisse zugeschnitten sind, mit einer benutzerfreundlichen Oberfläche und einer leistungsstarken REST-API, ohne dass tiefgreifende Kenntnisse im maschinellen Lernen erforderlich sind.
Maschinelles Lernen
AIGoMarket
AIGoMarket ist eine Edge AI Foundry und ein Marktplatz, der darauf abzielt, die Edge AI-Entwicklung zu demokratisieren. Er ermöglicht es Entwicklern, ihre optimierten KI-Modelle hochzuladen und zu monetarisieren, während er Entwicklern eine Plattform bietet, um leistungsstarke KI-Lösungen für verschiedene Edge-Geräte und -Anwendungen zu entdecken, zu lizenzieren und bereitzustellen.
Model Marketplace
Baseten Comments (0)
Sign in to comment.
AnmeldenNo comments yet.