

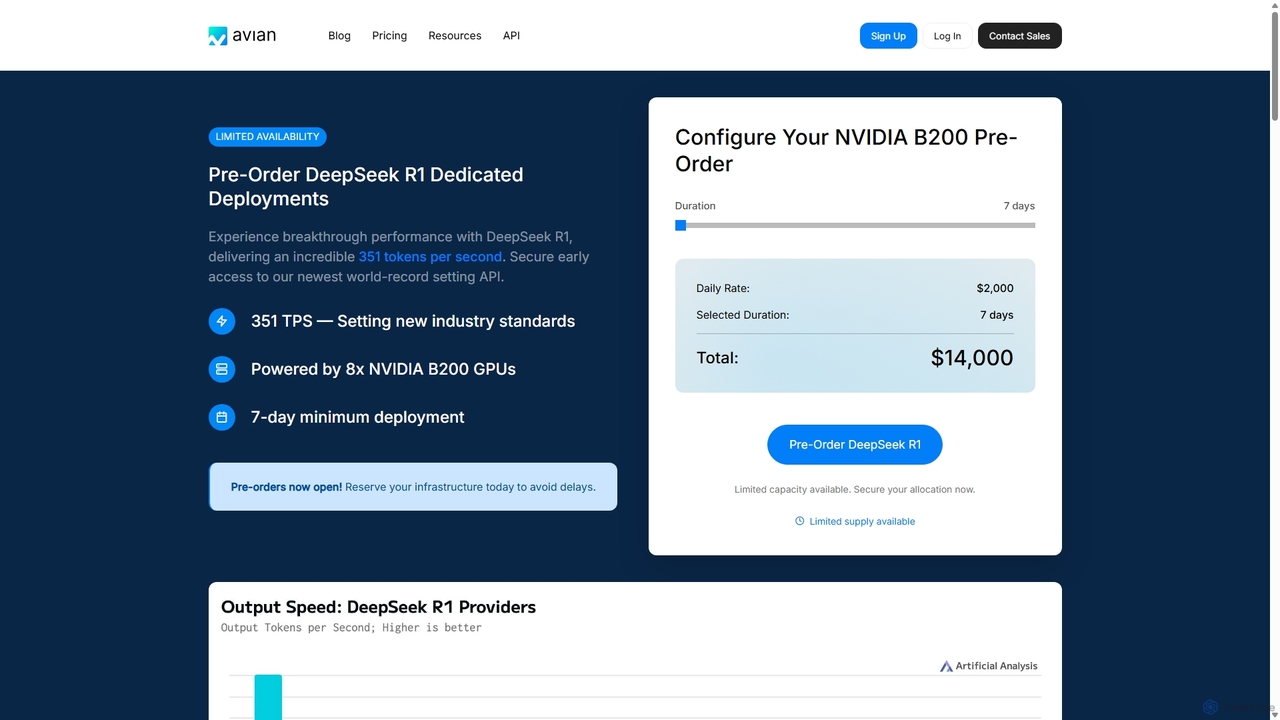
Avian Overview
Avian ist eine hochmoderne KI-Infrastrukturplattform, die entwickelt wurde, um die schnellste und zuverlässigste KI-Inferenz auf dem Markt zu bieten. Sie richtet sich an Entwickler, KI-Ingenieure und Unternehmen, die für ihre KI-Anwendungen einen hohen Durchsatz und eine geringe Latenz benötigen. Durch den Einsatz neuester Hardware wie NVIDIA B200 und H200 GPUs und fortschrittlicher Optimierungstechniken wie spekulativer Dekodierung erreicht Avian branchenführende Geschwindigkeiten und setzt neue Maßstäbe für Modelle wie DeepSeek R1 mit 351 Token pro Sekunde.
Die Plattform bietet zwei Hauptdienste, um unterschiedlichen Anforderungen gerecht zu werden: eine flexible Serverless API und leistungsstarke dedizierte Deployments. Dieser duale Ansatz ermöglicht es den Nutzern, entweder schnell erstklassige Modelle über einen einfachen API-Aufruf in ihre Anwendungen zu integrieren oder die volle Kontrolle über ihre Infrastruktur zu erlangen, um benutzerdefinierte, feinabgestimmte Modelle für spezielle Aufgaben auszuführen. Avian ist auf Skalierbarkeit ausgelegt und arbeitet ohne Ratenbegrenzungen, um Anwendungen beim Wachstum vom Prototyp bis zur vollen Produktion zu unterstützen.
Wie man Avian verwendet
Der Einstieg in Avian ist unkompliziert und auf die Effizienz von Entwicklern ausgelegt. Es gibt zwei Hauptmethoden, um seine Leistungsfähigkeit zu nutzen:
- Verwendung der Avian Serverless API: Dies ist der schnellste Weg, um auf Hochleistungsmodelle zuzugreifen. Entwickler können sich einfach anmelden, einen API-Schlüssel erhalten und Anfragen an verschiedene Modell-Endpunkte (z. B. die Meta Llama 3.1-Serie) stellen. Der Prozess umfasst eine einfache Code-Implementierung, ähnlich wie bei anderen KI-APIs, und ermöglicht eine nahtlose Integration in bestehende Anwendungen, ohne dass eine Infrastruktur verwaltet werden muss.
- Konfiguration dedizierter Deployments: Für Benutzer, die benutzerdefinierte Modelle von HuggingFace ausführen müssen oder dedizierte Ressourcen für einen konstant hohen Durchsatz benötigen, bietet Avian dedizierte GPU-Instanzen. Benutzer können ihren gewünschten GPU-Typ (z. B. NVIDIA H200 SXM) auswählen, die Bereitstellungsdauer konfigurieren und ihr Modell auf der optimierten Infrastruktur von Avian bereitstellen. Dies ist ideal für Produktions-Workloads, die eine garantierte Leistung und Ressourcenzuweisung erfordern.
Kernfunktionen von Avian
- Rekordverdächtige Inferenzgeschwindigkeit: Erreicht Geschwindigkeiten von bis zu 351 Token pro Sekunde, was den Branchendurchschnitt deutlich übertrifft und Echtzeit-KI-Anwendungen ermöglicht.
- Serverless API: Bietet Pay-as-you-go-Zugriff auf eine Reihe von Hochleistungsmodellen wie Meta Llama 3.1 und DeepSeek R1, ohne Ratenbegrenzungen.
- Dedizierte GPU-Deployments: Bietet dedizierte Instanzen mit den neuesten NVIDIA GPUs (B200, H200, H100) zur Bereitstellung jedes Modells von HuggingFace, um maximale Leistung und Kontrolle zu gewährleisten.
- Unternehmenstaugliche Sicherheit: Verfügt über robuste Sicherheitsmaßnahmen, einschließlich SOC2 Typ 2-Konformität (in Arbeit), GDPR-Einhaltung, TLS 1.2+ Verschlüsselung und Multi-Faktor-Authentifizierung (MFA). Daten werden nicht dauerhaft gespeichert, um die Privatsphäre der Benutzer zu gewährleisten.
- Skalierbar und produktionsreif: Entwickelt, um hochvolumige Produktions-Workloads ohne Leistungsabfall zu bewältigen und Unternehmen bei der Skalierung zu unterstützen.
- Datenkonnektoren: Bietet eine Reihe von Konnektoren für Plattformen wie Looker Studio und Google Sheets, die eine nahtlose Datenintegration aus Quellen wie Google Analytics, Facebook Ads und mehr ermöglichen.
Anwendungsfälle für Avian
Die Hochgeschwindigkeitsinfrastruktur von Avian eignet sich für eine Vielzahl anspruchsvoller KI-Anwendungen:
- Echtzeit-Chatbots und KI-Assistenten: Betreiben von Konversations-KI, die sofort reagieren kann und ein natürliches und flüssiges Benutzererlebnis bietet.
- Großangelegte Inhaltserstellung: Ermöglicht Plattformen, Artikel, Marketingtexte und Code in beispiellosem Umfang und mit beispielloser Geschwindigkeit zu generieren.
- Komplexe Datenanalyse und Zusammenfassung: Verarbeitung und Analyse großer Mengen von Textdaten in Echtzeit für Finanzanalysen, Forschung und Business Intelligence.
- Bereitstellung proprietärer Modelle: Unternehmen mit benutzerdefinierten oder feinabgestimmten Modellen können diese auf der dedizierten Infrastruktur von Avian bereitstellen, um eine optimale Leistung in Produktionsumgebungen zu erzielen.
Vorteile von Avian
Avian hebt sich im wettbewerbsintensiven KI-Infrastrukturmarkt durch mehrere entscheidende Vorteile ab:
- Unübertroffene Leistung: Liefert 3-10x schnellere Inferenzgeschwindigkeiten im Vergleich zu anderen großen Cloud-Anbietern und Inferenzdiensten.
- Flexibilität: Unterstützt sowohl Standardmodelle über eine einfache API als auch benutzerdefinierte Modelle auf dedizierter Hardware und bedient damit alle Ebenen der KI-Entwicklung.
- Kosteneffizienz: Bietet wettbewerbsfähige Preise für seine API und dedizierte Instanzen und liefert ein überlegenes Preis-Leistungs-Verhältnis.
- Zuverlässigkeit und Skalierbarkeit: Das Fehlen von Ratenbegrenzungen und die Verwendung von produktionsreifer Infrastruktur stellen sicher, dass Anwendungen nahtlos skalieren können, ohne auf Leistungsengpässe zu stoßen.
- Starke Sicherheitsposition: Ein klares Bekenntnis zur Datensicherheit und zum Datenschutz schafft Vertrauen bei Unternehmenskunden, die mit sensiblen Informationen umgehen.
Preise und Pläne
Avian bietet eine transparente und flexible Preisstruktur, die auf unterschiedliche Nutzungsmuster zugeschnitten ist:
- Avian API (Pay-per-use): Benutzer werden pro Million Token für Eingabe und Ausgabe abgerechnet. Die Preise sind wettbewerbsfähig und variieren je nach Modell. Zum Beispiel:
- Meta Llama 3.1 8B Instruct: 0,10 $ pro Million Eingabe-/Ausgabetoken.
- Meta Llama 3.1 70B Instruct: 0,45 $ pro Million Eingabe-/Ausgabetoken.
- Meta Llama 3.1 405B Instruct: 1,50 $ pro Million Eingabe-/Ausgabetoken.
- Dedizierte Deployments: Abrechnung pro Sekunde für reservierte GPU-Instanzen. Dies ist ideal für Workloads mit hohem Durchsatz. Beispielraten für reservierte Instanzen:
- NVIDIA H100 SXM (80GB HBM3): Ab 0,00139 $/Sekunde.
- NVIDIA H200 SXM (141GB HBM3): Ab 0,00208 $/Sekunde.
- Vorbestellungen für neue Hardware: Avian bietet auch Vorbestellungen für modernste Hardware wie die NVIDIA B200 an, damit Kunden sich den Zugang zur neuesten Technologie sichern können. Zum Beispiel kostet ein 7-tägiges Deployment eines DeepSeek R1 auf einem 8x NVIDIA B200-Setup 14.000 $.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 5.5K
- 2026-1: 7.0K
- 2026-2: 6.8K
- 2026-3: 8.7K
- 2026-4: 10.8K
- 2026-5: 8.3K
Geography
Top 5 countries / regions
- 🇺🇸Vereinigte Staaten32.5%
- 🇬🇧Vereinigtes Königreich26.6%
- 🇮🇳Indien22.6%
- 🇻🇳Vietnam18.3%
Top keywords
| Keyword | Cost per click |
|---|---|
| avian | $1.39 |
| avian ai | $0.00 |
| avian holdings | $0.00 |
| avian key | $0.00 |
| avians | $2.52 |
Avian Alternatives
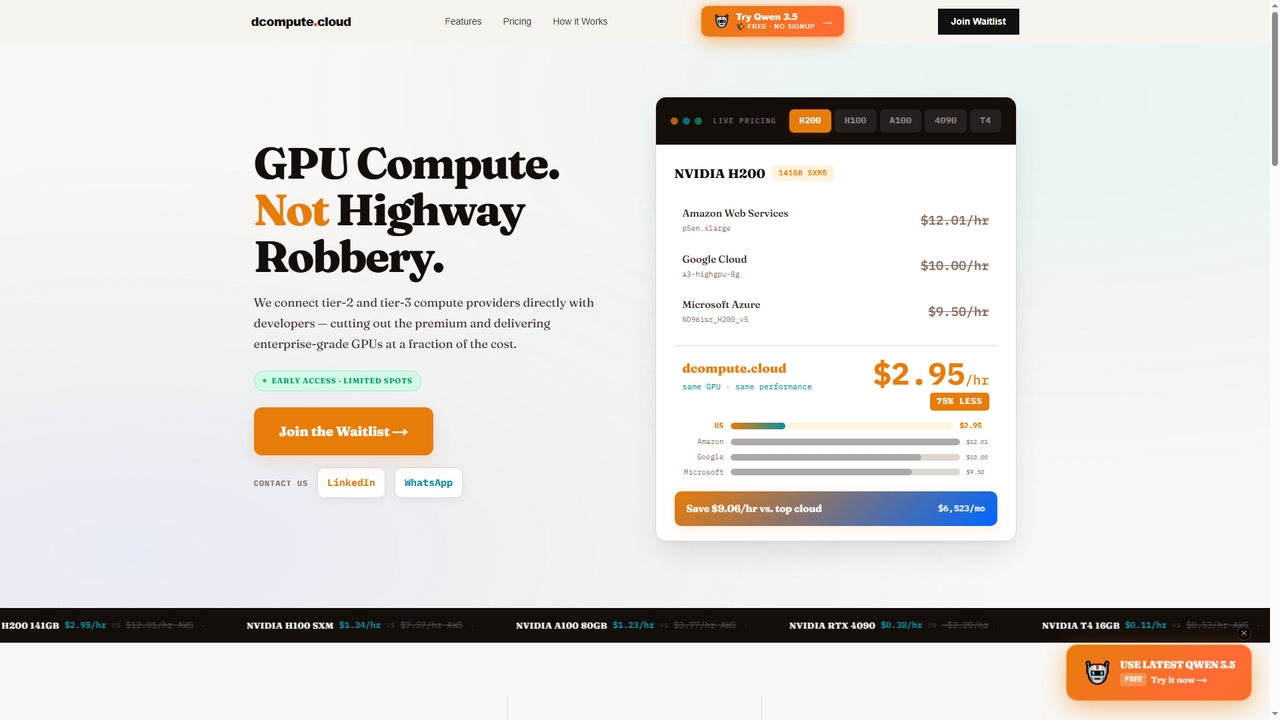
Dcompute
Dcompute ist ein dezentraler GPU-Computing-Marktplatz, der Entwickler direkt mit Tier-2- und Tier-3-Rechenzentrumsanbietern verbindet. Es bietet Enterprise-Grade-NVIDIA-GPUs (H200, H100, A100, RTX 4090, T4) zu einem Bruchteil der Kosten großer Cloud-Anbieter und verspricht Einsparungen von bis zu 90 %. Die Plattform bietet sofortige Bereitstellung, eine einheitliche API/Oberfläche, vollständige Orchestrierung und reine nutzungsabhängige Abrechnung pro Sekunde ohne Mindestgebühren.
GPU
Zetic.ai
Zetic.ai ist eine Plattform, die es Entwicklern ermöglicht, KI-Modelle direkt auf Edge-Geräten bereitzustellen und so die Notwendigkeit teurer GPU-Server zu eliminieren. Die automatisierte Pipeline, ZETIC.MLange, optimiert und konvertiert Modelle für die Ausführung auf dem Gerät, erreicht eine bis zu 60-mal schnellere Leistung durch NPU-Beschleunigung und gewährleistet dabei Datenschutz und reduzierte Latenz.
Edge-Computing
Symphony
Symphony ist eine universelle LLM-Schnittstelle, die eine OpenAI-kompatible API zur Bereitstellung, Verwaltung und Skalierung von KI-Anwendungen bietet. Sie zeichnet sich durch unternehmensgerechte Zuverlässigkeit, bis zu 20 % niedrigere Kosten und die Unterstützung von über 100 wichtigen KI-Modellen wie GPT-5 und Llama 4 aus, was sie zur idealen Lösung für Entwickler und Unternehmen macht, die eine effiziente und robuste KI-Infrastruktur suchen.
API-Verwaltung
Nexlayer
Nexlayer ist die erste agenten-native Cloud-Plattform, die KI-Codierungsagenten befähigt, produktionsreife Anwendungen schnell bereitzustellen. Sie automatisiert komplexe Infrastrukturen und ermöglicht es Entwicklern und Gründern, Full-Stack-Apps, APIs und Datenbanken in Minutenschnelle ohne DevOps-Aufwand zu veröffentlichen.
Application Development
SiliconFlow
SiliconFlow ist eine einheitliche KI-Infrastrukturplattform, die für die hochleistungsfähige Inferenz von Großen Sprachmodellen (LLMs) und multimodalen Modellen entwickelt wurde. Sie bietet Entwicklern und Unternehmen skalierbare, kostengünstige und flexible Bereitstellungsoptionen, einschließlich serverloser APIs, reservierter GPUs und Feinabstimmungsfunktionen, die alle über eine einzige, OpenAI-kompatible API zugänglich sind.
KI und Maschinelles LernenAvian Categories
Avian Jobs
Avian Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Zetic.ai
Zetic.ai ist eine Plattform, die es Entwicklern ermöglicht, KI-Modelle direkt auf Edge-Geräten bereitzustellen und so die Notwendigkeit teurer GPU-Server zu eliminieren. Die automatisierte Pipeline, ZETIC.MLange, optimiert und konvertiert Modelle für die Ausführung auf dem Gerät, erreicht eine bis zu 60-mal schnellere Leistung durch NPU-Beschleunigung und gewährleistet dabei Datenschutz und reduzierte Latenz.
Edge-ComputingSymphony
Symphony ist eine universelle LLM-Schnittstelle, die eine OpenAI-kompatible API zur Bereitstellung, Verwaltung und Skalierung von KI-Anwendungen bietet. Sie zeichnet sich durch unternehmensgerechte Zuverlässigkeit, bis zu 20 % niedrigere Kosten und die Unterstützung von über 100 wichtigen KI-Modellen wie GPT-5 und Llama 4 aus, was sie zur idealen Lösung für Entwickler und Unternehmen macht, die eine effiziente und robuste KI-Infrastruktur suchen.
API-Verwaltung
Baseten
Baseten ist eine produktionsreife Inferenzplattform für die Bereitstellung, Skalierung und Verwaltung von KI-Modellen. Sie bietet hochleistungsfähige Laufzeitumgebungen, nahtlose Entwickler-Workflows und flexible Bereitstellungsoptionen (Cloud, Self-Hosted, Hybrid). Ideal für Ingenieur- und ML-Teams, die geschäftskritische KI-Anwendungen erstellen.
Bereitstellung
Runexo
Runexo ist eine Cloud-GPU-Plattform, die für die KI-Entwicklung, das Training und die Inferenz entwickelt wurde. Sie bietet sofortigen Zugriff auf leistungsstarke Pay-as-you-go-GPUs und sicheren Cloud-Speicher, sodass Entwickler, Forscher und Unternehmen KI-Anwendungen wie Stable Diffusion, ComfyUI und Fooocus in Sekundenschnelle ohne Einrichtung oder Hardwareanforderungen starten können.
GPU als ServiceSiliconFlow
SiliconFlow ist eine einheitliche KI-Infrastrukturplattform, die für die hochleistungsfähige Inferenz von Großen Sprachmodellen (LLMs) und multimodalen Modellen entwickelt wurde. Sie bietet Entwicklern und Unternehmen skalierbare, kostengünstige und flexible Bereitstellungsoptionen, einschließlich serverloser APIs, reservierter GPUs und Feinabstimmungsfunktionen, die alle über eine einzige, OpenAI-kompatible API zugänglich sind.
KI und Maschinelles Lernen
Truefoundry
Truefoundry ist eine unternehmenstaugliche Plattform für die Bereitstellung, Verwaltung und Skalierung von agentenbasierten KI-Anwendungen. Es bietet ein einheitliches KI-Gateway zur Orchestrierung komplexer KI-Workflows, zur Verwaltung von Modellen und zur Gewährleistung von Sicherheit, Governance und Beobachtbarkeit. Entwickelt für Entwickler und MLOps-Teams, unterstützt es On-Premise-, Cloud- und Hybrid-Bereitstellungen, optimiert die GPU-Auslastung und beschleunigt die Markteinführung.
Cloud Computing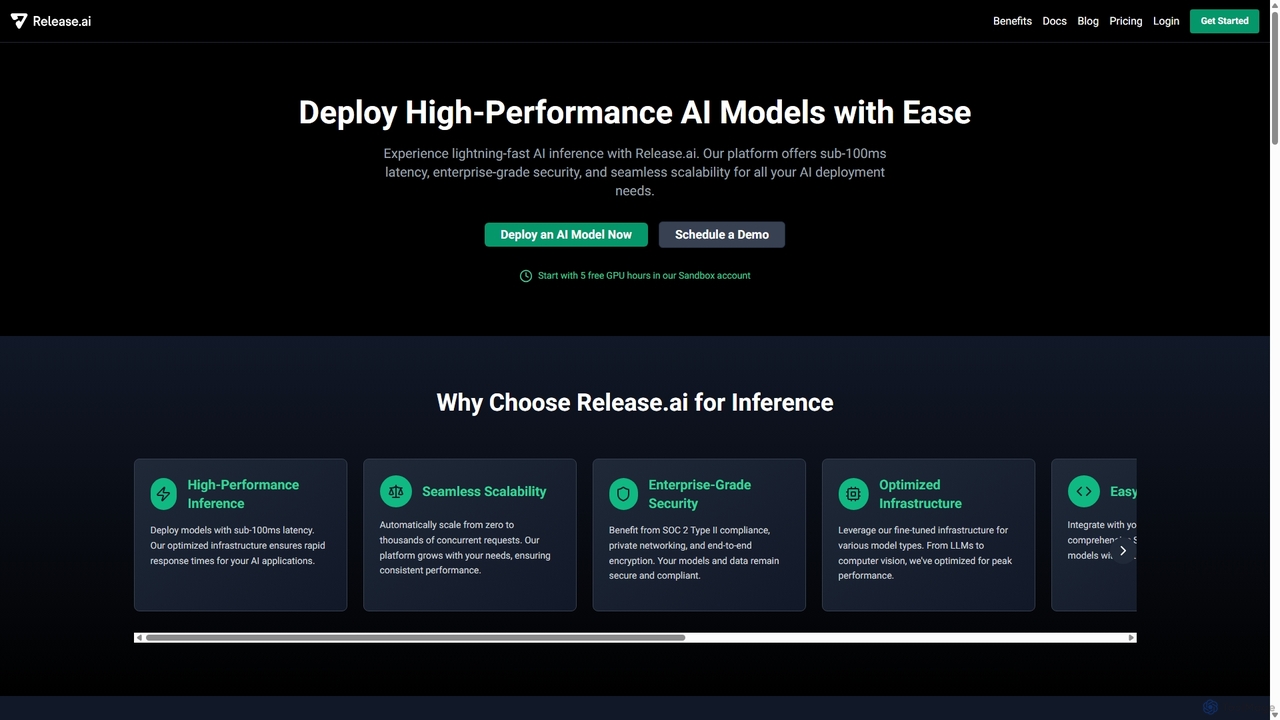
Release.ai
Release.ai ist eine unternehmenstaugliche Plattform für Entwickler zur einfachen Bereitstellung, Verwaltung und Skalierung von Hochleistungs-KI-Modellen. Sie bietet eine Inferenzlatenz von unter 100 ms, nahtloses Auto-Scaling, robuste Sicherheit und eine riesige Bibliothek voroptimierter Modelle, die eine schnelle Integration in jeden Entwicklungsworkflow mit nur wenigen Codezeilen ermöglicht.
Plattform als Dienst (PaaS)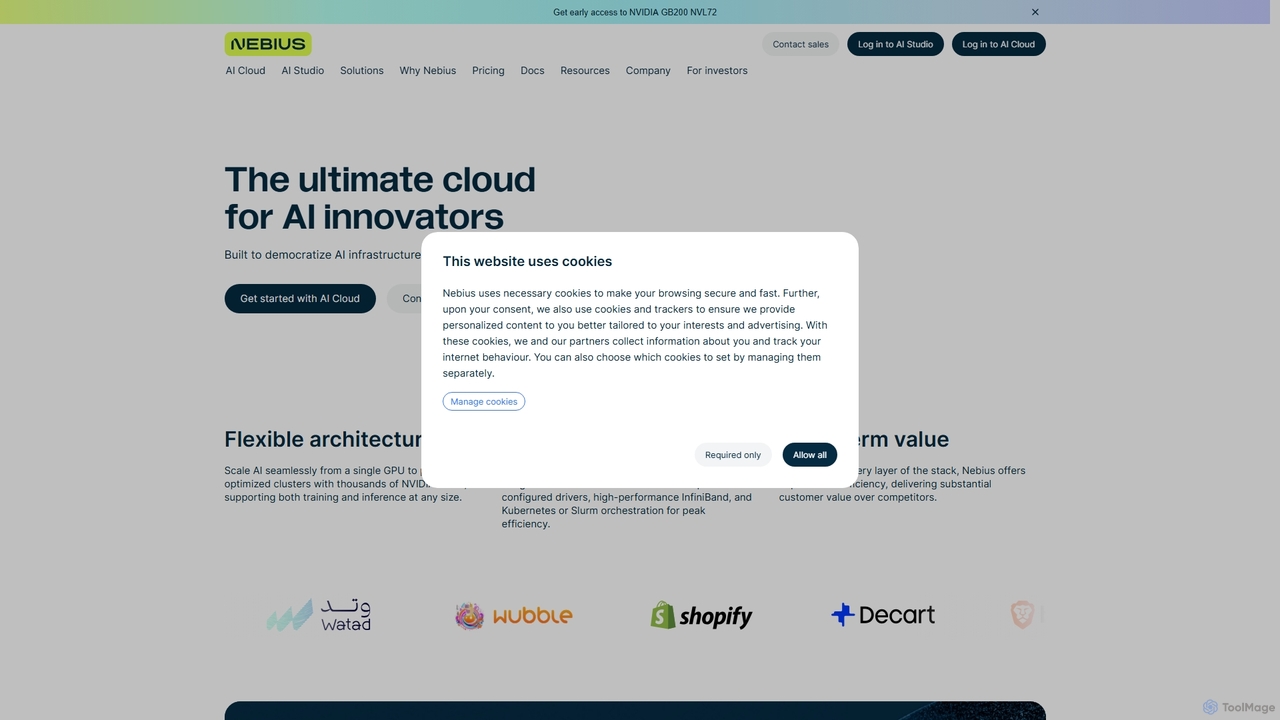
Nebius
Nebius ist eine hochleistungsfähige Cloud-Plattform, die speziell für anspruchsvolle KI- und Machine-Learning-Workloads entwickelt wurde. Sie bietet skalierbaren Zugriff auf die neuesten NVIDIA-GPUs, von einzelnen Instanzen bis hin zu massiven Clustern, ergänzt durch eine Suite von Managed Services und ein integriertes AI Studio, um den gesamten ML-Lebenszyklus vom Training bis zur Inferenz zu optimieren.
GPU-Cloud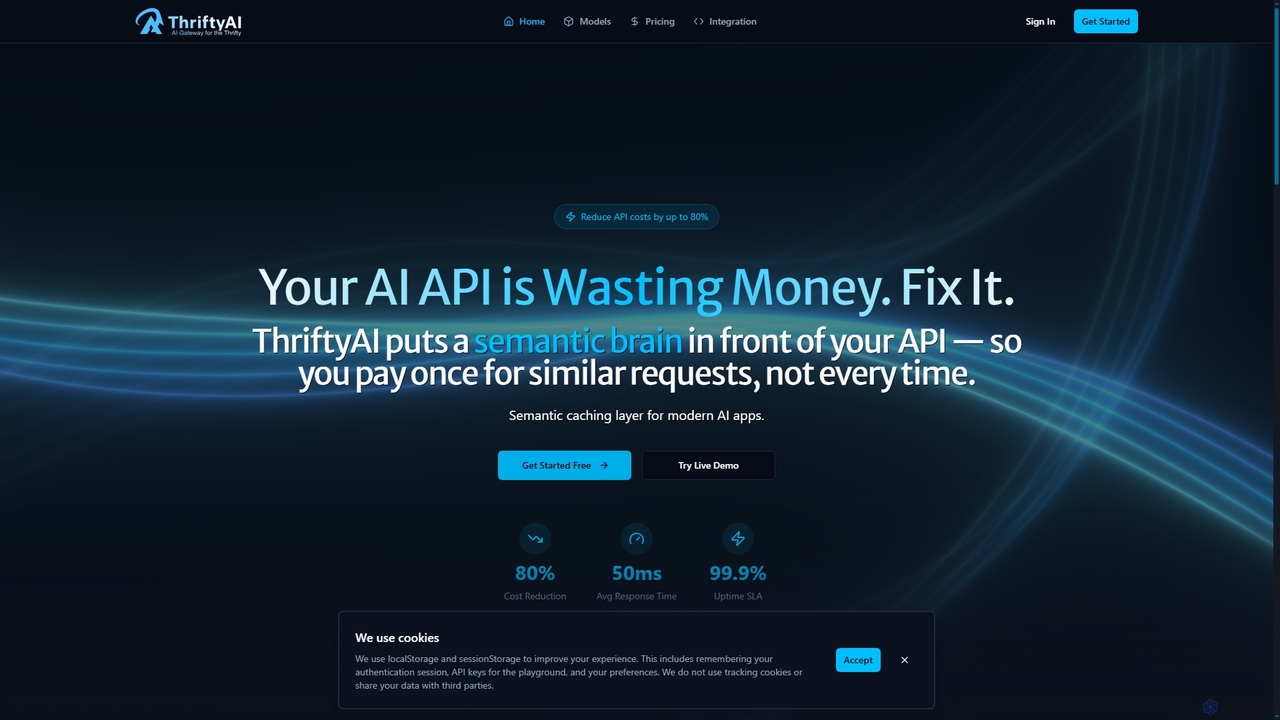
ThriftyAI
ThriftyAI ist ein fortschrittliches KI-Gateway und eine semantische Cache-Schicht, die entwickelt wurde, um KI-API-Kosten um bis zu 80% zu senken und die Antwortzeiten zu beschleunigen. Es speichert ähnliche Anfragen intelligent im Cache, maskiert sensible Daten und bietet robuste Sicherheitsfunktionen, was es ideal für moderne KI-Anwendungen macht, die Effizienz und Sicherheit auf Unternehmensebene suchen.
Gateway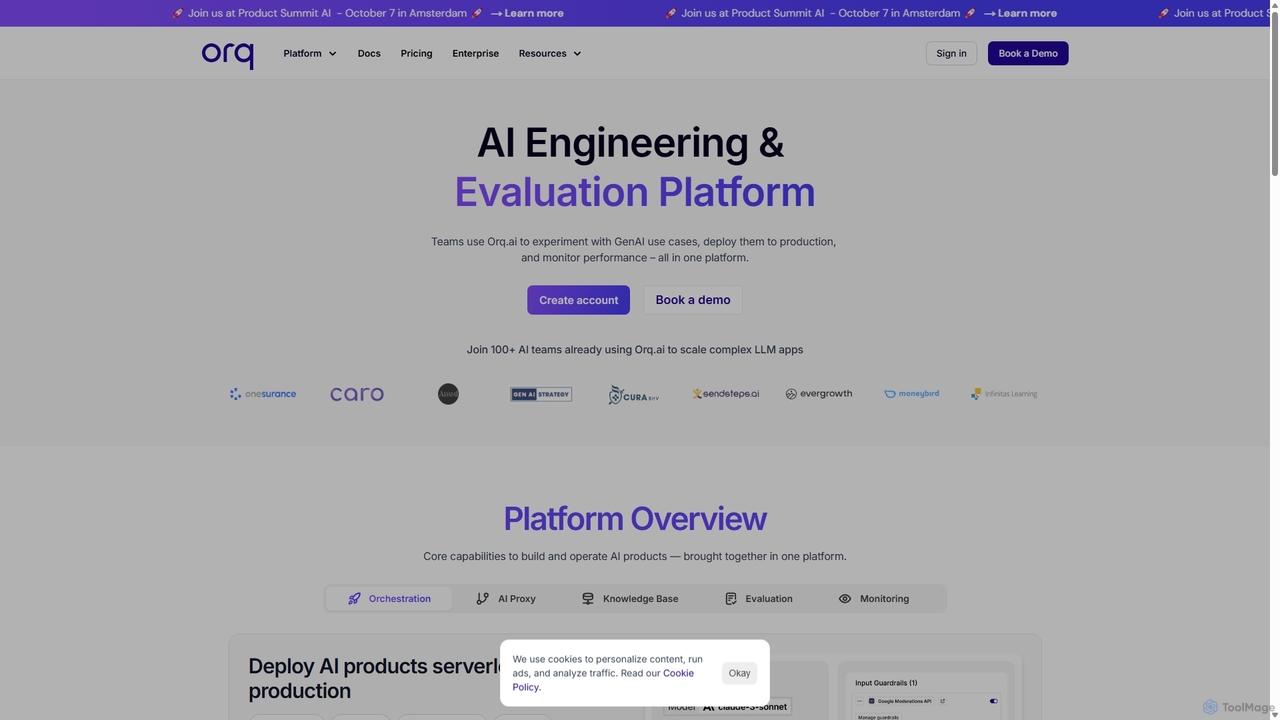
Orq.ai
Orq.ai ist eine End-to-End-Kollaborationsplattform für Generative KI für Ingenieur- und Produktteams. Sie ermöglicht es Benutzern, mit GenAI-Anwendungsfällen zu experimentieren, sie in die Produktion zu überführen und die Leistung zu überwachen – alles in einer einzigen, einheitlichen Umgebung, die den gesamten Lebenszyklus von LLM-Anwendungen unterstützt.
Modellbereitstellung
Vespa.ai
Vespa.ai ist eine hochleistungsfähige KI-Suchplattform zur Erstellung von Großanwendungen. Sie vereint Vektorsuche, Textsuche und maschinelles Lernranking, um fortschrittliche Anwendungsfälle wie Retrieval-Augmented Generation (RAG), Empfehlungssysteme und intelligente Suche zu ermöglichen. Entwickelt für Echtzeit-Inferenz und Skalierbarkeit, wird sie von führenden Unternehmen wie Spotify und Perplexity für die Verarbeitung riesiger Datenmengen mit geringer Latenz geschätzt.
Suche
Portkey AI
Portkey AI ist ein fortschrittliches KI-Gateway und eine LLM-Ops-Plattform für Entwickler. Es vereinfacht die Entwicklung zuverlässiger, skalierbarer und kostengünstiger KI-Anwendungen durch eine einheitliche API für verschiedene LLMs, Echtzeit-Beobachtbarkeit, semantisches Caching und intelligentes Load Balancing.
Infrastruktur
Oneinfer
Oneinfer ist eine hochleistungsfähige KI-Inferenzplattform für Entwickler. Sie bietet eine einheitliche API für den Zugriff auf über 15 LLMs wie GPT-4 und Claude und vereinfacht die KI-Integration. Die Plattform zeichnet sich durch serverlose Bereitstellung, automatische Skalierung, unternehmenstaugliche Sicherheit und Pay-as-you-go-Preise aus. Sie bietet auch einen Marktplatz zum Mieten von GPU-Instanzen für benutzerdefinierte KI-Workloads.
Inferenz
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung
Replicate
Replicate ist eine Cloud-Plattform für Entwickler, um KI-Modelle über eine einfache API auszuführen, zu optimieren und bereitzustellen. Sie eliminiert die Notwendigkeit, komplexe Infrastrukturen zu verwalten, und bietet Zugriff auf Tausende von Modellen mit Pay-per-Use-Preisen und automatischer Skalierung.
Maschinelles Lernen
Avian Comments (0)
Sign in to comment.
AnmeldenNo comments yet.