

Runpod Overview
Runpod ist eine End-to-End-KI-Cloud-Plattform, die entwickelt wurde, um die Komplexität beim Erstellen, Trainieren und Bereitstellen von KI-Modellen zu beseitigen. Sie bietet Entwicklern, Forschern und Unternehmen eine optimierte, leistungsstarke und kostengünstige Lösung für all ihre KI/ML-Rechenanforderungen. Durch den On-Demand-Zugriff auf eine breite Palette von GPUs in einem globalen Netzwerk von Rechenzentren ermöglicht Runpod den Benutzern, von der Idee zur produktionsreifen Anwendung zu gelangen, ohne die typischen Kopfschmerzen bei der Infrastrukturverwaltung, Skalierung und hohen Kosten.
Die Plattform ist für Entwickler konzipiert und konzentriert sich auf Geschwindigkeit, Flexibilität und Effizienz. Ob Sie ein großes Sprachmodell feinabstimmen, Echtzeit-Inferenz für eine Anwendung bereitstellen oder rechenintensive Simulationen durchführen, Runpod bietet die notwendigen Werkzeuge und die Infrastruktur, um dies in großem Maßstab zu tun. Ziel ist es, das rechnerische Rückgrat für die nächste Generation von KI-Unternehmen zu sein, damit diese sich auf Innovation statt auf Infrastruktur konzentrieren können.
Wie man Runpod verwendet
Die Verwendung von Runpod umfasst einen unkomplizierten Workflow, der für eine schnelle Entwicklung und Bereitstellung konzipiert ist:
- Wählen Sie einen Dienst: Wählen Sie zwischen GPU Cloud für interaktive Entwicklung und langlaufende Aufgaben oder Serverless für skalierbare, bedarfsgesteuerte Inferenz-Endpunkte.
- Wählen Sie eine Vorlage: Starten Sie Ihr Projekt, indem Sie aus einer breiten Palette vorgefertigter Vorlagen für beliebte Frameworks und Anwendungen wie PyTorch, TensorFlow, Stable Diffusion und verschiedene LLMs wählen.
- Starten Sie einen Pod: Starten Sie eine GPU-fähige Umgebung, einen sogenannten 'Pod', in weniger als einer Minute. Sie können den GPU-Typ, vCPUs, RAM und Speicher an Ihre spezifischen Bedürfnisse anpassen.
- Verbinden und Erstellen: Greifen Sie über SSH oder Jupyter Lab auf Ihren Pod zu, um Abhängigkeiten zu installieren, Ihren Code hochzuladen und mit dem Training oder der Erstellung Ihrer Anwendung zu beginnen.
- Daten verwalten: Nutzen Sie Persistent Volumes oder S3-kompatible Network Volumes, um Ihre Datensätze, Modelle und Containerdaten zu speichern. Ein entscheidender Vorteil ist das Fehlen von Ingress- oder Egress-Gebühren für die Datenübertragung.
- Bereitstellen und Skalieren: Für Produktions-Workloads stellen Sie Ihr Modell als serverlosen Endpunkt bereit. Die Autoscaling-Funktion von Runpod verwaltet automatisch die Anzahl der GPU-Worker (von 0 bis zu Tausenden) basierend auf der Echtzeit-Nachfrage und stellt sicher, dass Sie nur für die genutzte Rechenleistung bezahlen.
Kernfunktionen von Runpod
- Skalierbare GPU-Rechenleistung: Zugriff auf eine Vielzahl von GPUs, von Consumer-Grade RTX 4090s bis hin zu Enterprise-Level H100s und B200s, verfügbar in einer kostengünstigen Community Cloud und einer hochsicheren Secure Cloud.
- Serverlose GPUs: Stellen Sie Modelle als API-Endpunkte bereit, die automatisch von null skalieren, um jede Arbeitslast zu bewältigen und Leerlaufkosten zu eliminieren.
- FlashBoot-Technologie: Erreichen Sie blitzschnelle Skalierung mit Kaltstartzeiten von unter 200 ms, um sicherzustellen, dass Ihre Anwendung immer reaktionsschnell ist.
- Persistenter Speicher: S3-kompatibler Speicher ohne Ingress/Egress-Gebühren, der es Ihnen ermöglicht, vollständige KI-Pipelines von der Datenaufnahme bis zur Bereitstellung nahtlos auszuführen.
- Vorgefertigte Vorlagen: Eine reichhaltige Bibliothek von Vorlagen, um Umgebungen für Training, Inferenz und mehr sofort einzurichten und die Einrichtungszeit erheblich zu reduzieren.
- Globale Infrastruktur: Stellen Sie Workloads in über 8 Regionen weltweit bereit, um eine geringe Latenz und globale Zuverlässigkeit zu gewährleisten.
- Integrierte Orchestrierung & Überwachung: Die Plattform übernimmt das Task-Queuing und die Verteilung automatisch und bietet Echtzeit-Protokolle, Überwachung und Metriken, ohne dass benutzerdefinierte Frameworks erforderlich sind.
Anwendungsfälle für Runpod
Runpod ist vielseitig und unterstützt eine breite Palette von Anwendungen:
- Inferenz-Serving: Bereitstellung und Bedienung von Inferenz für Bild-, Text- und Audiogenerierungsmodelle in jedem Maßstab mit geringer Latenz.
- Modell-Feinabstimmung: Trainieren und feinabstimmen Sie benutzerdefinierte Modelle auf Ihren spezifischen Datensätzen effizient und kostengünstig.
- KI-Agenten: Erstellen und hosten Sie intelligente, autonome agentenbasierte Systeme und komplexe Workflows.
- Rechenintensive Aufgaben: Führen Sie anspruchsvolle Workloads wie 3D-Rendering, wissenschaftliche Simulationen und groß angelegte Datenverarbeitung aus.
Vorteile von Runpod
Runpod bietet erhebliche Vorteile gegenüber traditionellen Cloud-Anbietern:
- Kosteneffizienz: Mit sekundengenauer Abrechnung, wettbewerbsfähigen GPU-Preisen und null Daten-Egress-Gebühren berichten Benutzer von Einsparungen von bis zu 90% bei ihren Infrastrukturkosten.
- Geschwindigkeit und Agilität: Von der Idee zur Ausführung in Sekunden. Die schnelle Bereitstellung der Plattform, minimale Kaltstarts und Autoscaling-Funktionen beschleunigen den Entwicklungszyklus.
- Einfachheit: Die Abstraktion der Infrastrukturkomplexität ermöglicht es Teams, sich auf ihr Kernprodukt und ihre Funktionen zu konzentrieren, nicht auf DevOps.
- Flexibilität: Hochgradig anpassbare Umgebungen, einschließlich GPU-Modellen, Skalierungsverhalten, Leerlaufzeitlimits und Rechenzentrumsstandorten.
- Zuverlässigkeit: Service auf Unternehmensebene mit 99,9% Verfügbarkeit, integrierten Failover-Mechanismen und robuster Sicherheit (SOC2, HIPAA, GDPR in Vorbereitung).
Preise und Pläne
Die Preisgestaltung von Runpod ist transparent und auf Kosteneffizienz ausgelegt.
- GPU Cloud: Wird pro Stunde abgerechnet, wobei die Preise je nach GPU-Typ und ob sie sich in der Secure Cloud oder der günstigeren Community Cloud befindet, variieren. Zum Beispiel kann eine RTX 4090 nur 0,69 $/h kosten, während eine High-End-H100 SXM etwa 2,69 $/h kostet.
- Serverless (Inferenz): Wird pro Sekunde Verarbeitungszeit abgerechnet. Die Preise sind nach GPU-Leistung gestaffelt, mit separaten Raten für 'Flex' (vorgewärmte) und 'Active' Worker. Dieses Modell ist sehr effizient für variablen Datenverkehr.
- Speicher: Persistenter Pod-Speicher kostet 0,10 $/GB/Monat. S3-kompatibler Network Volume-Speicher ist mit 0,07 $/GB/Monat für unter 1 TB noch günstiger. Es gibt keine Ingress- oder Egress-Gebühren.
- Reservierungen: Für langfristige Workloads können Benutzer Kapazitäten zu einem ermäßigten Preis reservieren, indem sie sich an das Vertriebsteam wenden.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 1.6M
- 2026-1: 1.9M
- 2026-2: 1.9M
- 2026-3: 2.4M
- 2026-4: 2.3M
- 2026-5: 2.3M
Geography
Top 5 countries / regions
- 🇺🇸Vereinigte Staaten58.8%
- 🇮🇳Indien13.6%
- 🇩🇪Deutschland13.6%
- 🇧🇷Brasilien7.4%
- 🇳🇬Nigeria6.6%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 78.8% |
Referral | 20.0% |
Email | 1.2% |
Top keywords
| Keyword | Cost per click |
|---|---|
| run pod | $4.13 |
| runpod | $2.14 |
| runpod password | $0.00 |
| runpod pricing | $4.51 |
| runpod serverless | $15.48 |
Runpod Videos on YouTube


Endangered AI


Runpod Alternatives
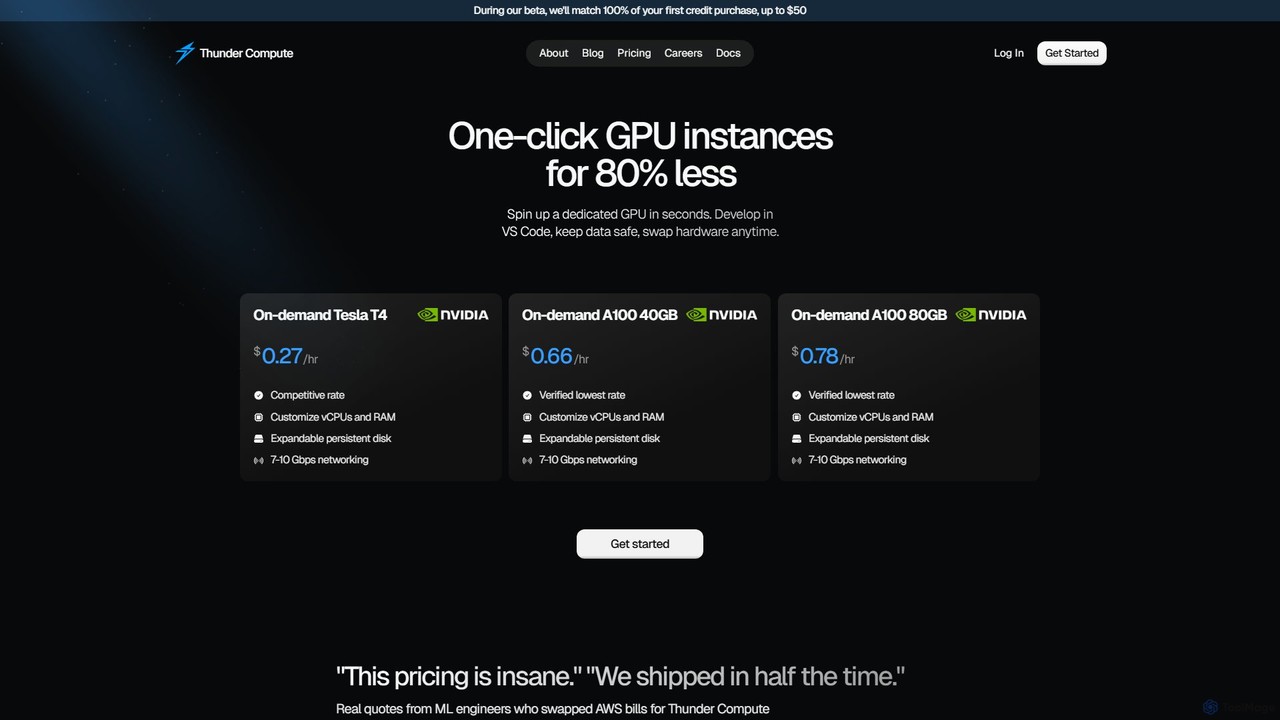
thundercompute
Thunder Compute bietet eine extrem kostengünstige GPU-Cloud-Plattform, die für KI- und Machine-Learning-Entwickler entwickelt wurde. Sie stellt On-Demand-GPU-Instanzen wie die NVIDIA A100 und T4 zu Preisen bereit, die bis zu 80 % niedriger sind als bei großen Cloud-Anbietern. Mit Funktionen wie Ein-Klick-Setup, VS-Code-Integration und nahtloser Skalierbarkeit vereinfacht es den Entwicklungsworkflow vom Prototyping bis zur Produktion drastisch und ermöglicht es Entwicklern, sich auf die Erstellung von Modellen statt auf die Verwaltung der Infrastruktur zu konzentrieren.
Maschinelles Lernen
Baseten
Baseten ist eine produktionsreife Inferenzplattform für die Bereitstellung, Skalierung und Verwaltung von KI-Modellen. Sie bietet hochleistungsfähige Laufzeitumgebungen, nahtlose Entwickler-Workflows und flexible Bereitstellungsoptionen (Cloud, Self-Hosted, Hybrid). Ideal für Ingenieur- und ML-Teams, die geschäftskritische KI-Anwendungen erstellen.
Bereitstellung
Predibase
Predibase ist eine End-to-End-Entwicklerplattform für das effiziente Fine-Tuning und Bereitstellen von Open-Source Large Language Models (LLMs). Sie ermöglicht es Benutzern, benutzerdefinierte KI-Modelle zu erstellen, die große proprietäre Modelle wie GPT-4 bei spezifischen Aufgaben übertreffen und dabei die Kosten und die Inferenzlatenz erheblich reduzieren. Die Plattform bietet fortschrittliche Techniken wie Reinforcement Fine-Tuning (RFT) und LoRAX für Hochgeschwindigkeits-Multi-Modell-Serving.
Maschinelles Lernen
Fluidstack
Fluidstack ist eine führende KI-Cloud-Plattform, die hochleistungsfähige, dedizierte GPU-Cluster für das Training und die Bereitstellung von Frontier-KI-Modellen anbietet. Sie ermöglicht den schnellen Einsatz von Tausenden von GPUs, vollständig verwaltete Dienste mit 24/7-Experten-Support und transparente Preise ohne Egress-Gebühren, um KI-Teams eine reibungslose Skalierung ohne Infrastrukturhürden zu ermöglichen.
Unternehmenslösungen
GPUX
GPUX ist eine serverlose, dezentrale GPU-Cloud-Plattform für schnelle und kostengünstige KI-Modellinferenz. Sie ermöglicht Entwicklern die Ausführung von Modellen über eine API und GPU-Besitzern, durch die Bereitstellung ihrer Hardware in einem P2P-Netzwerk Geld zu verdienen.
ModellbereitstellungRunpod Categories
Runpod Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Beam
Beam ist eine serverlose Cloud-Plattform, die für Entwickler konzipiert wurde, um KI/ML-Modelle und -Anwendungen einfach auf GPUs auszuführen, zu skalieren und bereitzustellen. Sie bietet sofortiges Autoscaling, sekundengenaue Abrechnung und einen optimierten Workflow, der es Ihnen ermöglicht, in wenigen Minuten von Code zu einer skalierbaren API zu gelangen, ohne komplexe Infrastruktur verwalten zu müssen.
Maschinelles Lernen
Modal
Modal ist eine hochleistungsfähige, serverlose Infrastrukturplattform für KI- und ML-Entwickler. Sie ermöglicht es Ihnen, Python-Funktionen mit einer einzigen Codezeile in der Cloud auszuführen und bietet sofortigen Zugriff auf GPUs, automatische Skalierung von null auf Tausende von Containern und sekundengenaue Abrechnung. Beseitigen Sie den Infrastrukturaufwand und konzentrieren Sie sich auf die Erstellung und Bereitstellung rechenintensiver Anwendungen wie generative KI, Batch-Verarbeitung und Datenanalyse.
Modellbereitstellungthundercompute
Thunder Compute bietet eine extrem kostengünstige GPU-Cloud-Plattform, die für KI- und Machine-Learning-Entwickler entwickelt wurde. Sie stellt On-Demand-GPU-Instanzen wie die NVIDIA A100 und T4 zu Preisen bereit, die bis zu 80 % niedriger sind als bei großen Cloud-Anbietern. Mit Funktionen wie Ein-Klick-Setup, VS-Code-Integration und nahtloser Skalierbarkeit vereinfacht es den Entwicklungsworkflow vom Prototyping bis zur Produktion drastisch und ermöglicht es Entwicklern, sich auf die Erstellung von Modellen statt auf die Verwaltung der Infrastruktur zu konzentrieren.
Maschinelles LernenGPUX
GPUX ist eine serverlose, dezentrale GPU-Cloud-Plattform für schnelle und kostengünstige KI-Modellinferenz. Sie ermöglicht Entwicklern die Ausführung von Modellen über eine API und GPU-Besitzern, durch die Bereitstellung ihrer Hardware in einem P2P-Netzwerk Geld zu verdienen.
Modellbereitstellung
novita.ai
Novita AI ist eine entwicklerorientierte Cloud-Plattform, die erschwinglichen, skalierbaren Zugriff auf über 200 KI-Modelle über einfache APIs bietet. Sie stellt serverlose GPUs, dedizierte GPU-Instanzen und die Bereitstellung benutzerdefinierter Modelle zur Verfügung, sodass Entwickler KI-Anwendungen erstellen und skalieren können, ohne die Infrastruktur verwalten zu müssen.
GPUBaseten
Baseten ist eine produktionsreife Inferenzplattform für die Bereitstellung, Skalierung und Verwaltung von KI-Modellen. Sie bietet hochleistungsfähige Laufzeitumgebungen, nahtlose Entwickler-Workflows und flexible Bereitstellungsoptionen (Cloud, Self-Hosted, Hybrid). Ideal für Ingenieur- und ML-Teams, die geschäftskritische KI-Anwendungen erstellen.
Bereitstellung
DigitalOcean
DigitalOcean ist eine entwicklerorientierte Cloud-Infrastrukturplattform, die das Erstellen, Bereitstellen und Skalieren von Anwendungen vereinfacht. Sie bietet eine umfassende Suite von Produkten, einschließlich virtueller Maschinen (Droplets), verwaltetem Kubernetes und der GradientAI-Plattform, die leistungsstarke GPU-Ressourcen und Werkzeuge für die Erstellung und das Hosting von weltverändernden KI-Anwendungen bereitstellt, von Nebenprojekten bis hin zu großen Unternehmen.
Hosting
Replicate
Replicate ist eine Cloud-Plattform für Entwickler, um KI-Modelle über eine einfache API auszuführen, zu optimieren und bereitzustellen. Sie eliminiert die Notwendigkeit, komplexe Infrastrukturen zu verwalten, und bietet Zugriff auf Tausende von Modellen mit Pay-per-Use-Preisen und automatischer Skalierung.
Maschinelles Lernen
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung
Float16.cloud
Float16.cloud ist eine serverlose GPU-Plattform, die entwickelt wurde, um die KI-Entwicklung zu beschleunigen. Sie bietet sofortigen Zugriff auf leistungsstarke H100-GPUs mit sekundengenauer Abrechnung, null Konfiguration und ohne Kaltstarts. Entwickler können Open-Source-LLMs bereitstellen, Modelle trainieren und KI-Workloads direkt aus Python-Skripten ausführen, ohne die Infrastruktur verwalten zu müssen.
Plattform als Dienst (PaaS)
Together AI
Together AI ist eine führende Cloud-Plattform für Entwickler, die eine schnelle und kostengünstige Infrastruktur zum Ausführen, Feinabstimmen und Trainieren von Open-Source-Generative-AI-Modellen bereitstellt. Sie bietet eine umfangreiche Bibliothek mit über 200 Modellen, serverlose Inferenz-APIs, anpassbares Fine-Tuning und dedizierte GPU-Cluster und schafft so eine End-to-End-Lösung für die Erstellung und Skalierung von KI-Anwendungen.
GPU-Infrastruktur
Inferless
Inferless ist eine serverlose GPU-Plattform, die für Entwickler konzipiert wurde, um Machine-Learning-Modelle in Minuten bereitzustellen. Sie eliminiert das Infrastrukturmanagement und bietet automatische Skalierung von Null, um Lastspitzen zu bewältigen. Die Plattform ist für blitzschnelle Kaltstarts und Kosteneffizienz optimiert, sodass Benutzer bis zu 90 % bei den GPU-Rechnungen sparen können, indem sie nur für das bezahlen, was sie nutzen.
Bereitstellung von Maschinellem Lernen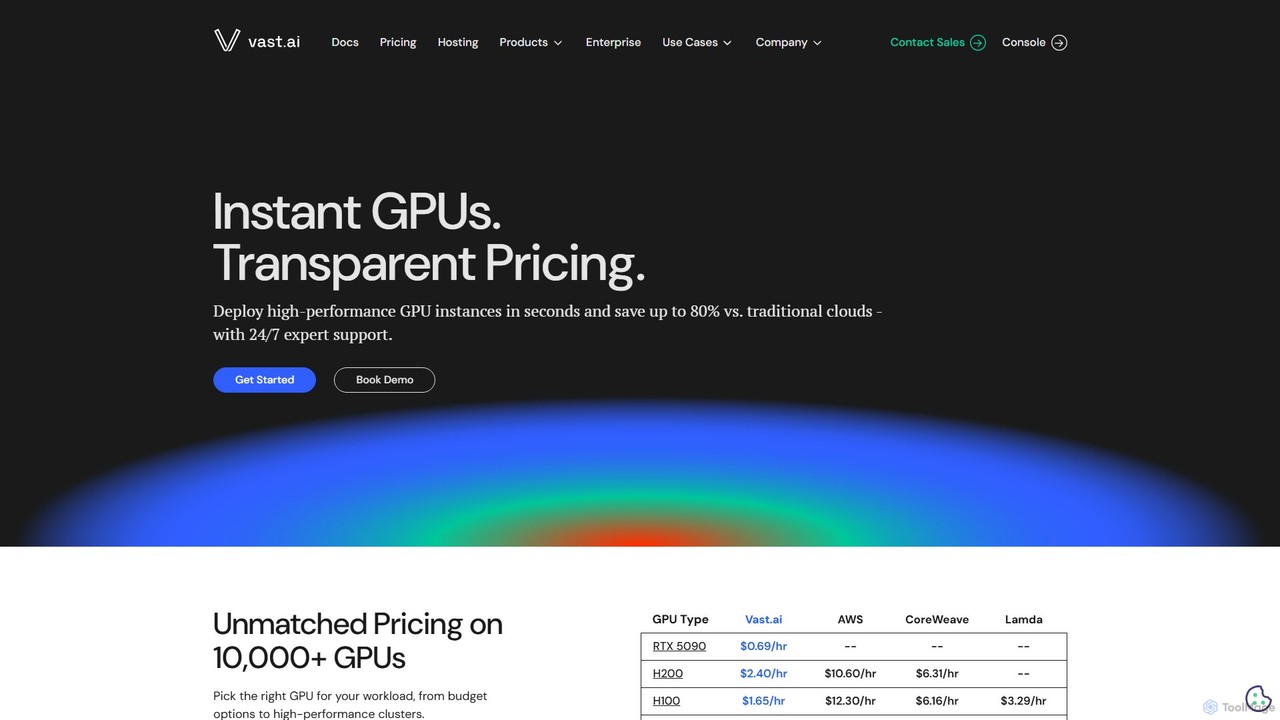
Vast.ai
Vast.ai ist eine führende GPU-Cloud-Plattform, die On-Demand-Zugriff auf ein riesiges Netzwerk von GPUs für KI- und Machine-Learning-Workloads bietet. Sie versorgt Entwickler und Unternehmen mit Hochleistungsrechnen zu deutlich geringeren Kosten – bis zu 80 % günstiger als herkömmliche Cloud-Anbieter – über einen transparenten Pay-as-you-go-Marktplatz.
GPU-Vermietung
Nebius
Nebius ist eine hochleistungsfähige Cloud-Plattform, die speziell für KI und maschinelles Lernen entwickelt wurde. Sie bietet Zugriff auf die neuesten NVIDIA-GPUs, skalierbare Cluster mit InfiniBand-Netzwerk und vollständig verwaltete Dienste wie Kubernetes und Slurm, um nahtloses Training, Feinabstimmung und Inferenz von KI-Modellen jeder Größenordnung zu ermöglichen.
Maschinelles Lernen
Blaxel
Blaxel ist eine serverlose Computing-Plattform für KI-Entwickler, die die Infrastruktur und Werkzeuge zum effizienten Erstellen, Bereitstellen und Skalieren von agentenbasierten KI-Anwendungen bietet. Sie verfügt über gesandboxte VMs, ein einheitliches LLM-Gateway und tiefgehende Beobachtbarkeit.
Cloud Computing
Runpod Comments (0)
Sign in to comment.
AnmeldenNo comments yet.