

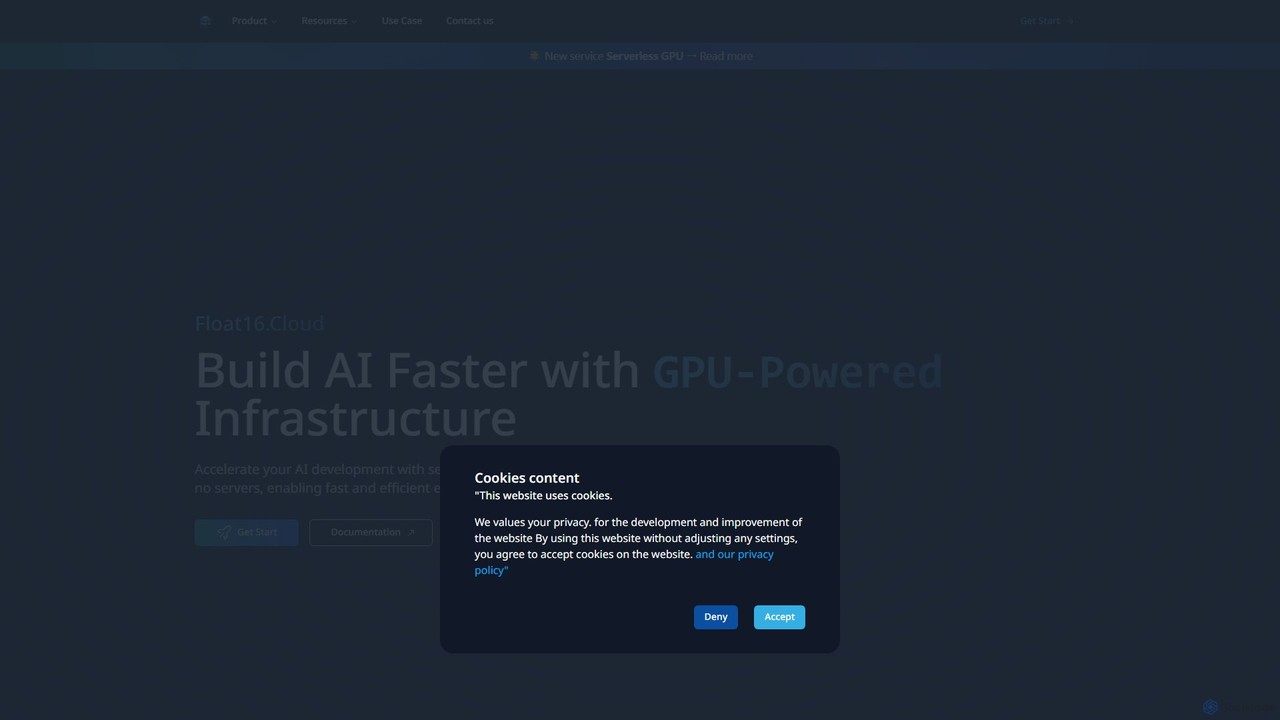
Float16.cloud Overview
Float16.cloud ist eine umfassende, entwicklerorientierte Plattform, die darauf ausgelegt ist, den gesamten Lebenszyklus der KI-Entwicklung zu optimieren und zu beschleunigen. Sie bietet eine leistungsstarke serverlose GPU-Infrastruktur, die es Entwicklern und Datenwissenschaftlern ermöglicht, KI-Modelle mit beispielloser Geschwindigkeit und Effizienz zu erstellen, zu trainieren und bereitzustellen. Das Herzstück der Plattform ist ihr Serverless-GPU-Service, der On-Demand-Zugriff auf hochmoderne NVIDIA H100-GPUs bietet. Dies eliminiert die Komplexität des Infrastrukturmanagements und ermöglicht es den Benutzern, sich ausschließlich auf das Codieren und die Modellentwicklung zu konzentrieren.
Die Plattform ist auf Geschwindigkeit und Einfachheit ausgelegt. Sie rühmt sich der schnellsten GPU-Startzeit in der Cloud und stellt in weniger als einer Sekunde betriebsbereite Recheninstanzen zur Verfügung. Dies wird durch vorgewärmte Container erreicht, die Kaltstarts und Wartezeiten effektiv eliminieren. Mit einer Null-Konfigurations-Umgebung kümmert sich Float16.cloud um alle zugrunde liegenden Komplexitäten, einschließlich Dockerfiles, Startskripten, CUDA-Treibern und Python-Umgebungen, und befreit Entwickler vom DevOps-Aufwand.
Wie man Float16.cloud verwendet
Der Einstieg in Float16.cloud ist für Entwickler intuitiv gestaltet. Die Plattform ist CLI-first, bietet aber auch ein vollständig integriertes webbasiertes Dashboard zur Überwachung und Verwaltung.
- Registrieren: Erstellen Sie ein Konto über GitHub oder Google zur Authentifizierung. Neue Benutzer können mit einer kostenlosen Testversion ohne Kreditkarte starten.
- Wählen Sie einen Dienst: Entscheiden Sie sich zwischen der Serverless-GPU für benutzerdefinierte Aufgaben oder der Ein-Klick-LLM-Bereitstellung für Standardmodelle.
- Für Serverless-GPU: Laden Sie einfach Ihr Python-Skript (.py) über die CLI oder die Web-Benutzeroberfläche hoch. Die Plattform containerisiert und führt Ihren Code automatisch auf einer H100-GPU aus. Sie können Trainingspipelines, Batch-Verarbeitungsjobs ausführen oder einen API-Endpunkt bereitstellen.
- Für die Ein-Klick-LLM-Bereitstellung: Verwenden Sie einen einzigen CLI-Befehl, um Open-Source-Modelle wie LLaMA, Qwen oder Gemma direkt von Hugging Face bereitzustellen. Float16.cloud stellt sofort einen produktionsbereiten, sicheren HTTPS-Endpunkt für Ihr Modell bereit.
- Verwalten und Überwachen: Verwenden Sie das Dashboard oder die CLI, um auf Echtzeitprotokolle zuzugreifen, den Jobverlauf anzuzeigen, Metriken auf Anforderungsebene zu überprüfen und Dateien zu verwalten. Dateien können von einem lokalen Computer oder einem Remote-S3-Bucket hochgeladen werden und werden zur Laufzeit automatisch in den Container eingebunden.
Kernfunktionen von Float16.cloud
- Serverlose H100-GPUs: Sofortiger Zugriff auf NVIDIA H100-GPUs ohne erforderliches Servermanagement.
- Start in unter einer Sekunde: Vorgewärmte Container eliminieren Kaltstarts und stellen Rechenressourcen in weniger als 100 ms bereit.
- Native Python-Ausführung: Führen Sie Python-Skripte direkt aus, ohne Dockerfiles zu erstellen oder Umgebungen zu verwalten.
- Pay-Per-Use-Abrechnung: Echte sekundengenaue Abrechnung stellt sicher, dass Sie nur für die genutzte Rechenzeit bezahlen, ohne Leerlaufkosten.
- Spot-Instanzen: Ein kostengünstiger Spot-Modus für langlaufende Aufgaben wie Modelltraining und Feinabstimmung.
- Ein-Klick-LLM-Bereitstellung: Stellen Sie beliebte Open-Source-LLMs mit einem einzigen Befehl bereit und erhalten Sie sofort einen produktionsbereiten API-Endpunkt.
- Integrierte Entwicklerwerkzeuge: Eine leistungsstarke CLI, ein umfassendes Web-Dashboard, integriertes Datei-I/O (lokal & S3) sowie detaillierte Protokollierung und Nachverfolgung.
- Sicherheit und Compliance: Erreichte SOC 2 Typ I und ISO 29110 Zertifizierungen, mit Datenverschlüsselung im Ruhezustand und während der Übertragung.
- LLM-Playgrounds: Eine Suite von Werkzeugen, einschließlich eines Prompt-Playgrounds, Quantisierungs-Benchmarks, Chatbots, Text2SQL und Tokenizern zum Experimentieren und Optimieren von Modellen.
Anwendungsfälle für Float16.cloud
Die Plattform unterstützt eine breite Palette von KI-Anwendungen:
- LLM-Inferenz-Serving: Stellen Sie Open-Source-LLMs als skalierbare API-Endpunkte mit geringer Latenz für Produktionsanwendungen bereit.
- Modelltraining & Feinabstimmung: Führen Sie Trainingspipelines auf kostengünstigen Spot-GPUs mit Ihrer vorhandenen Python-Codebasis aus.
- Schnelles Prototyping (Google Colab-Alternative): Nutzen Sie den Entwicklungsmodus für Proof-of-Concepts, Tests und Experimente mit Zugriff auf leistungsstarke H100-GPUs.
- Semantische Suche: Erstellen und beschleunigen Sie semantische Suchpipelines, einschließlich Embedding, Vektorsuche und Reranking auf GPUs für Hochleistungsergebnisse.
- Wissensagenten: Entwickeln Sie intelligente Agenten, die mit Dokumenten (PDFs) und Datenbanken (SQL) interagieren können, um Erkenntnisse zu gewinnen und Daten zu visualisieren.
Vorteile von Float16.cloud
Float16.cloud bietet erhebliche Vorteile gegenüber herkömmlichen Cloud-Anbietern. Sein Hauptvorteil ist die Kombination aus extremer Einfachheit und roher Leistung. Das serverlose Modell ohne Konfiguration verkürzt die Markteinführungszeit für KI-Anwendungen drastisch. Die sekundengenaue Abrechnung und die erschwinglichen Spot-Instanzen machen leistungsstarkes GPU-Computing für Einzelpersonen und Unternehmen zugänglich und kosteneffizient. Darüber hinaus sorgt der Fokus auf die Entwicklererfahrung mit robusten CLI- und Überwachungswerkzeugen für einen reibungslosen und produktiven Arbeitsablauf. Die Spezialisierung der Plattform auf Modelle für südostasiatische Sprachen bietet Entwicklern, die auf diese Region abzielen, ebenfalls einen einzigartigen Vorteil.
Preise und Pläne
Float16.cloud bietet ein transparentes und flexibles Pay-per-Use-Preismodell, das sich an Ihre Bedürfnisse anpasst. Es gibt keine Vorabverpflichtungen oder Leerlaufgebühren.
- Serverless-GPU (NVIDIA H100)
- On-Demand: 0,006 $ pro Sekunde (21,60 $ pro Stunde)
- Spot: 0,0012 $ pro Sekunde (4,32 $ pro Stunde)
Beide Preismodelle beinhalten CPU, Speicher und kostenlosen Speicherplatz. Die Plattform bietet eine kostenlose Testversion für neue Benutzer, die 500 kostenlose Läufe oder Anfragen zum Einstieg enthält. Für größere Anforderungen sind auf Anfrage Enterprise-, selbst gehostete oder vollständig verwaltete Servicepläne erhältlich.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 2.3K
- 2026-1: 2.1K
- 2026-2: 2.1K
- 2026-3: 5.9K
- 2026-4: 10.2K
- 2026-5: 13.8K
Geography
Top 5 countries / regions
- 🇹🇭Thailand37.3%
- 🇺🇸Vereinigte Staaten30.7%
- 🇮🇩Indonesien14.8%
- 🇧🇷Brasilien9.0%
- 🇮🇳Indien8.3%
Top keywords
| Keyword | Cost per click |
|---|---|
| ai benchmark gpus | $0.00 |
| ai gpu benchmarks 2026 | $0.00 |
| one h100 vs one ngx spark | $0.00 |
| rtx h100 comparison 5090 ti | $0.00 |
| tokenspeed | $0.00 |
Float16.cloud Alternatives
DigitalOcean
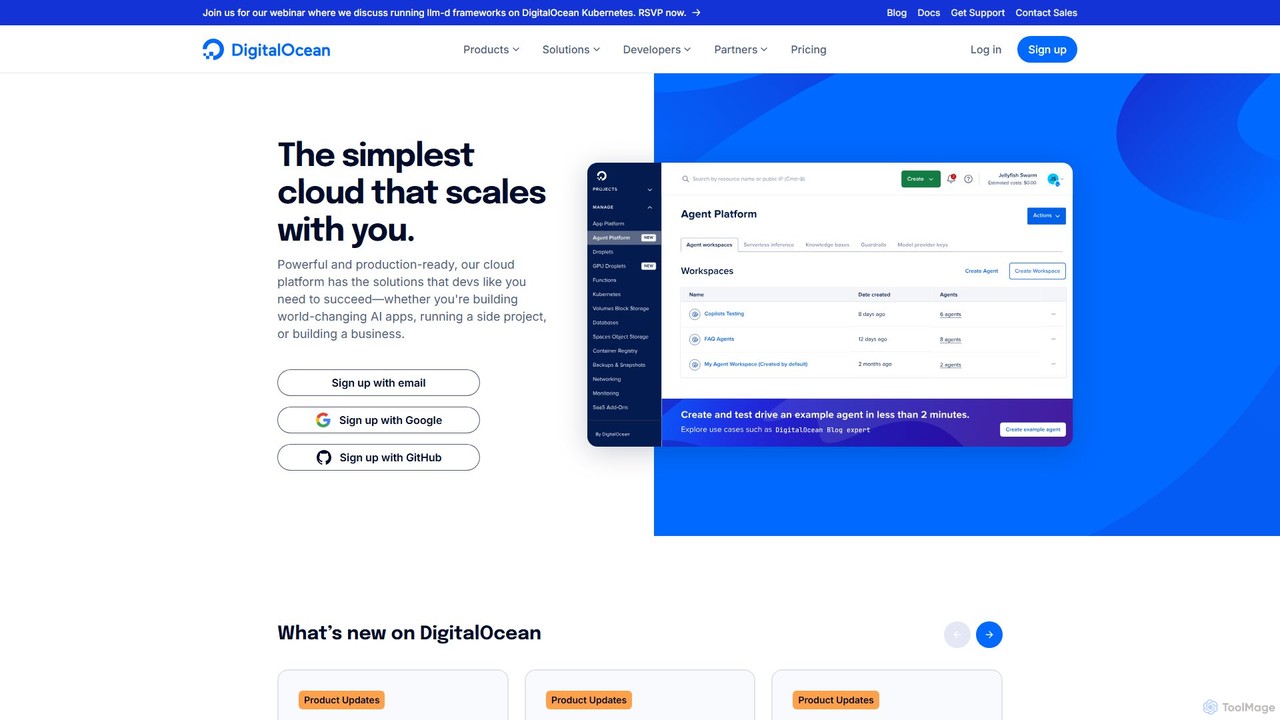
DigitalOcean ist eine entwicklerorientierte Cloud-Infrastrukturplattform, die das Erstellen, Bereitstellen und Skalieren von Anwendungen vereinfacht. Sie bietet eine umfassende Suite von Produkten, einschließlich virtueller Maschinen (Droplets), verwaltetem Kubernetes und der GradientAI-Plattform, die leistungsstarke GPU-Ressourcen und Werkzeuge für die Erstellung und das Hosting von weltverändernden KI-Anwendungen bereitstellt, von Nebenprojekten bis hin zu großen Unternehmen.
Hosting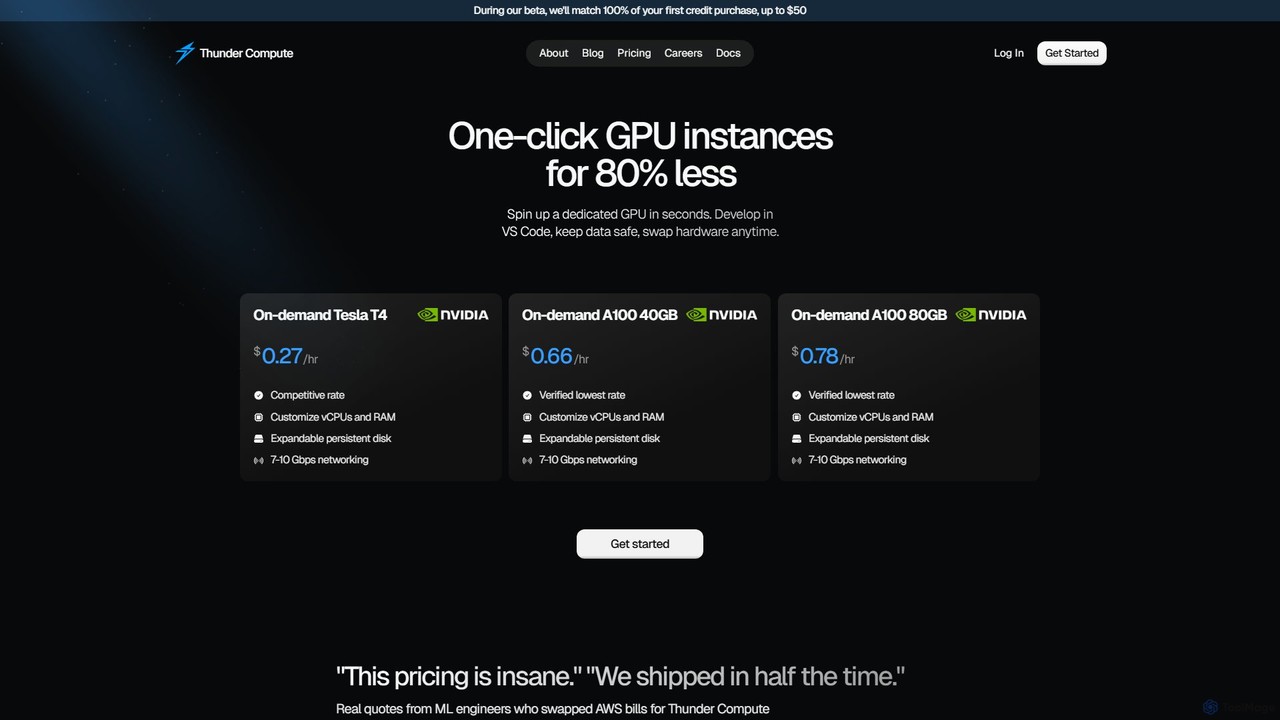
thundercompute
Thunder Compute bietet eine extrem kostengünstige GPU-Cloud-Plattform, die für KI- und Machine-Learning-Entwickler entwickelt wurde. Sie stellt On-Demand-GPU-Instanzen wie die NVIDIA A100 und T4 zu Preisen bereit, die bis zu 80 % niedriger sind als bei großen Cloud-Anbietern. Mit Funktionen wie Ein-Klick-Setup, VS-Code-Integration und nahtloser Skalierbarkeit vereinfacht es den Entwicklungsworkflow vom Prototyping bis zur Produktion drastisch und ermöglicht es Entwicklern, sich auf die Erstellung von Modellen statt auf die Verwaltung der Infrastruktur zu konzentrieren.
Maschinelles Lernen
OctoAI
OctoAI ist eine Hochleistungs-Rechenplattform für Entwickler, um generative KI-Modelle effizient auszuführen, anzupassen und zu skalieren. Sie bietet optimierte, produktionsreife API-Endpunkte für beliebte Open-Source-Modelle wie Llama, Mixtral und Stable Diffusion. Durch die Konzentration auf tiefgreifende Systemoptimierungen bietet OctoAI schnellere Inferenzgeschwindigkeiten und niedrigere Kosten, sodass Unternehmen skalierbare KI-Anwendungen erstellen und bereitstellen können, ohne komplexe Infrastrukturen verwalten zu müssen.
API
Runpod
Runpod ist eine Cloud-Plattform, die für KI und maschinelles Lernen entwickelt wurde und skalierbare GPU-Rechenleistung für die Bereitstellung, das Training und den Betrieb von KI-Modellen bietet. Sie stellt serverlose GPUs, vorgefertigte Vorlagen und kostengünstige Preise zur Verfügung, um den gesamten KI-Entwicklungsworkflow von der Idee bis zur Produktion zu vereinfachen.
Maschinelles Lernen
Google Cloud
Google Cloud ist eine umfassende Suite von Cloud-Computing-Diensten, die Infrastruktur, Plattform und serverlose Umgebungen bereitstellt. Sie zeichnet sich durch KI/ML mit Vertex AI und Gemini sowie Datenanalyse mit BigQuery aus und bietet eine skalierbare, sichere Infrastruktur für Unternehmen jeder Größe, von Start-ups bis zu globalen Konzernen.
Maschinelles LernenFloat16.cloud Categories
Float16.cloud Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
DigitalOcean
DigitalOcean ist eine entwicklerorientierte Cloud-Infrastrukturplattform, die das Erstellen, Bereitstellen und Skalieren von Anwendungen vereinfacht. Sie bietet eine umfassende Suite von Produkten, einschließlich virtueller Maschinen (Droplets), verwaltetem Kubernetes und der GradientAI-Plattform, die leistungsstarke GPU-Ressourcen und Werkzeuge für die Erstellung und das Hosting von weltverändernden KI-Anwendungen bereitstellt, von Nebenprojekten bis hin zu großen Unternehmen.
Hostingthundercompute
Thunder Compute bietet eine extrem kostengünstige GPU-Cloud-Plattform, die für KI- und Machine-Learning-Entwickler entwickelt wurde. Sie stellt On-Demand-GPU-Instanzen wie die NVIDIA A100 und T4 zu Preisen bereit, die bis zu 80 % niedriger sind als bei großen Cloud-Anbietern. Mit Funktionen wie Ein-Klick-Setup, VS-Code-Integration und nahtloser Skalierbarkeit vereinfacht es den Entwicklungsworkflow vom Prototyping bis zur Produktion drastisch und ermöglicht es Entwicklern, sich auf die Erstellung von Modellen statt auf die Verwaltung der Infrastruktur zu konzentrieren.
Maschinelles Lernen
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung
Modal
Modal ist eine hochleistungsfähige, serverlose Infrastrukturplattform für KI- und ML-Entwickler. Sie ermöglicht es Ihnen, Python-Funktionen mit einer einzigen Codezeile in der Cloud auszuführen und bietet sofortigen Zugriff auf GPUs, automatische Skalierung von null auf Tausende von Containern und sekundengenaue Abrechnung. Beseitigen Sie den Infrastrukturaufwand und konzentrieren Sie sich auf die Erstellung und Bereitstellung rechenintensiver Anwendungen wie generative KI, Batch-Verarbeitung und Datenanalyse.
Modellbereitstellung
Beam
Beam ist eine serverlose Cloud-Plattform, die für Entwickler konzipiert wurde, um KI/ML-Modelle und -Anwendungen einfach auf GPUs auszuführen, zu skalieren und bereitzustellen. Sie bietet sofortiges Autoscaling, sekundengenaue Abrechnung und einen optimierten Workflow, der es Ihnen ermöglicht, in wenigen Minuten von Code zu einer skalierbaren API zu gelangen, ohne komplexe Infrastruktur verwalten zu müssen.
Maschinelles LernenRunpod
Runpod ist eine Cloud-Plattform, die für KI und maschinelles Lernen entwickelt wurde und skalierbare GPU-Rechenleistung für die Bereitstellung, das Training und den Betrieb von KI-Modellen bietet. Sie stellt serverlose GPUs, vorgefertigte Vorlagen und kostengünstige Preise zur Verfügung, um den gesamten KI-Entwicklungsworkflow von der Idee bis zur Produktion zu vereinfachen.
Maschinelles Lernen
Replicate
Replicate ist eine Cloud-Plattform für Entwickler, um KI-Modelle über eine einfache API auszuführen, zu optimieren und bereitzustellen. Sie eliminiert die Notwendigkeit, komplexe Infrastrukturen zu verwalten, und bietet Zugriff auf Tausende von Modellen mit Pay-per-Use-Preisen und automatischer Skalierung.
Maschinelles Lernen
novita.ai
Novita AI ist eine entwicklerorientierte Cloud-Plattform, die erschwinglichen, skalierbaren Zugriff auf über 200 KI-Modelle über einfache APIs bietet. Sie stellt serverlose GPUs, dedizierte GPU-Instanzen und die Bereitstellung benutzerdefinierter Modelle zur Verfügung, sodass Entwickler KI-Anwendungen erstellen und skalieren können, ohne die Infrastruktur verwalten zu müssen.
GPU
Anyscale
Anyscale ist eine vollständig verwaltete Rechenplattform zur Skalierung von KI- und Python-Workloads. Sie wurde von den ursprünglichen Entwicklern des Open-Source-Frameworks Ray entwickelt und ermöglicht es Entwicklern, verteilte Anwendungen – vom LLM-Training bis zur Datenverarbeitung – mit optimierter Leistung und Kosteneffizienz in jeder Cloud zu erstellen, auszuführen und zu skalieren.
MLOpsGoogle Cloud
Google Cloud ist eine umfassende Suite von Cloud-Computing-Diensten, die Infrastruktur, Plattform und serverlose Umgebungen bereitstellt. Sie zeichnet sich durch KI/ML mit Vertex AI und Gemini sowie Datenanalyse mit BigQuery aus und bietet eine skalierbare, sichere Infrastruktur für Unternehmen jeder Größe, von Start-ups bis zu globalen Konzernen.
Maschinelles Lernen
Together AI
Together AI ist eine führende Cloud-Plattform für Entwickler, die eine schnelle und kostengünstige Infrastruktur zum Ausführen, Feinabstimmen und Trainieren von Open-Source-Generative-AI-Modellen bereitstellt. Sie bietet eine umfangreiche Bibliothek mit über 200 Modellen, serverlose Inferenz-APIs, anpassbares Fine-Tuning und dedizierte GPU-Cluster und schafft so eine End-to-End-Lösung für die Erstellung und Skalierung von KI-Anwendungen.
GPU-Infrastruktur
massedcompute
Massed Compute ist eine Cloud-Plattform, die bedarfsgesteuerte, hochleistungsfähige NVIDIA GPUs und CPUs bereitstellt. Sie bietet flexible, skalierbare und erschwingliche Rechenleistung für KI-Entwicklung, maschinelles Lernen und Big-Data-Analyse ohne langfristige Verträge und richtet sich an Innovatoren und Entwickler.
Maschinelles Lernen
GPUX
GPUX ist eine serverlose, dezentrale GPU-Cloud-Plattform für schnelle und kostengünstige KI-Modellinferenz. Sie ermöglicht Entwicklern die Ausführung von Modellen über eine API und GPU-Besitzern, durch die Bereitstellung ihrer Hardware in einem P2P-Netzwerk Geld zu verdienen.
Modellbereitstellung
AWS
Amazon Web Services (AWS) ist die weltweit umfassendste und am weitesten verbreitete Cloud-Plattform und bietet über 200 voll funktionsfähige Dienste aus Rechenzentren weltweit. Es bietet eine breite Palette von KI- und Machine-Learning-Tools, darunter Amazon Bedrock zum Erstellen generativer KI-Anwendungen mit führenden Foundation Models, Amazon SageMaker für den gesamten ML-Lebenszyklus und die leistungsstarken Amazon Nova-Modelle für fortgeschrittene Text-, Bild- und Videogenerierung.
Maschinelles Lernen
Lightning AI
Lightning AI ist eine Cloud-Plattform, die entwickelt wurde, um KI-Modelle in großem Maßstab zu erstellen, zu trainieren und bereitzustellen. Sie kombiniert das beliebte Open-Source-Framework PyTorch Lightning mit dem Lightning AI Studio, einer kollaborativen, browserbasierten Umgebung ohne jegliche Einrichtung. Greifen Sie auf leistungsstarke GPUs zu, skalieren Sie nahtlos von einem Laptop in die Cloud und beschleunigen Sie Ihren gesamten KI-Entwicklungsworkflow.
Plattform als Dienst (PaaS)
Float16.cloud Comments (0)
Sign in to comment.
AnmeldenNo comments yet.