ToolMage
Anmelden

AI TOOL COMPARISON

Runpod vs Tensorfuse

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

Runpod Produktübersicht

Runpod ist eine Cloud-Plattform, die für KI und maschinelles Lernen entwickelt wurde und skalierbare GPU-Rechenleistung für die Bereitstellung, das Training und den Betrieb von KI-Modellen bietet. Sie stellt serverlose GPUs, vorgefertigte Vorlagen und kostengünstige Preise zur Verfügung, um den gesamten KI-Entwicklungsworkflow von der Idee bis zur Produktion zu vereinfachen.

Preview

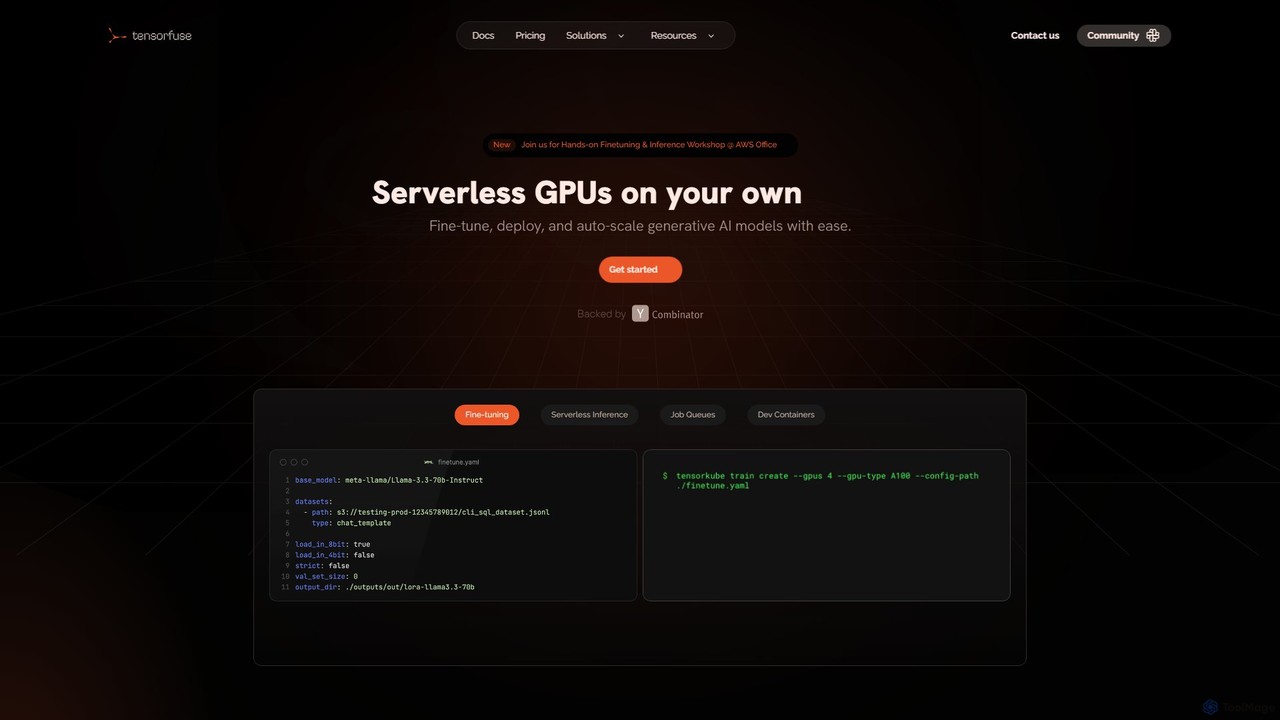
Tensorfuse Produktübersicht

Tensorfuse ist eine serverlose GPU-Plattform, die es Entwicklern ermöglicht, generative KI-Modelle in ihrer eigenen AWS-Cloud zu optimieren, bereitzustellen und automatisch zu skalieren. Sie vereinfacht das Infrastrukturmanagement und bietet Funktionen wie serverlose Inferenz, Job-Warteschlangen und Entwicklungscontainer, um die Entwicklung zu beschleunigen, Kosten zu senken und den DevOps-Aufwand zu eliminieren.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Runpod VS Tensorfuse — Kerndaten
KerndatenRunpodTensorfuse
Pricing modelPaidFreemium
Product typeWebWeb
Primary focusMaschinelles LernenBereitstellung
Zielgruppen und RollenNicht verifiziertNicht verifiziert
KategorienMaschinelles Lernen · Cloud Computing · AutomatisierungBereitstellung · MLOps · Cloud Computing
Added06.08.202515.08.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Runpod

Runpod ist eine End-to-End-KI-Cloud-Plattform, die entwickelt wurde, um die Komplexität beim Erstellen, Trainieren und Bereitstellen von KI-Modellen zu beseitigen. Sie bietet Entwicklern, Forschern und Unternehmen eine optimierte, leistungsstarke und kostengünstige Lösung für all ihre KI/ML-Rechenanforderungen. Durch den On-Demand-Zugriff auf eine breite Palette von GPUs in einem globalen Netzwerk von Rechenzentren ermöglicht Runpod den Benutzern, von der Idee zur produktionsreifen Anwendung zu gelangen, ohne die typischen Kopfschmerzen bei der Infrastrukturverwaltung, Skalierung und hohen Kosten.

Die Plattform ist für Entwickler konzipiert und konzentriert sich auf Geschwindigkeit, Flexibilität und Effizienz. Ob Sie ein großes Sprachmodell feinabstimmen, Echtzeit-Inferenz für eine Anwendung bereitstellen oder rechenintensive Simulationen durchführen, Runpod bietet die notwendigen Werkzeuge und die Infrastruktur, um dies in großem Maßstab zu tun. Ziel ist es, das rechnerische Rückgrat für die nächste Generation von KI-Unternehmen zu sein, damit diese sich auf Innovation statt auf Infrastruktur konzentrieren können.

Wie man Runpod verwendet

Die Verwendung von Runpod umfasst einen unkomplizierten Workflow, der für eine schnelle Entwicklung und Bereitstellung konzipiert ist:

  1. Wählen Sie einen Dienst: Wählen Sie zwischen GPU Cloud für interaktive Entwicklung und langlaufende Aufgaben oder Serverless für skalierbare, bedarfsgesteuerte Inferenz-Endpunkte.
  2. Wählen Sie eine Vorlage: Starten Sie Ihr Projekt, indem Sie aus einer breiten Palette vorgefertigter Vorlagen für beliebte Frameworks und Anwendungen wie PyTorch, TensorFlow, Stable Diffusion und verschiedene LLMs wählen.
  3. Starten Sie einen Pod: Starten Sie eine GPU-fähige Umgebung, einen sogenannten 'Pod', in weniger als einer Minute. Sie können den GPU-Typ, vCPUs, RAM und Speicher an Ihre spezifischen Bedürfnisse anpassen.
  4. Verbinden und Erstellen: Greifen Sie über SSH oder Jupyter Lab auf Ihren Pod zu, um Abhängigkeiten zu installieren, Ihren Code hochzuladen und mit dem Training oder der Erstellung Ihrer Anwendung zu beginnen.
  5. Daten verwalten: Nutzen Sie Persistent Volumes oder S3-kompatible Network Volumes, um Ihre Datensätze, Modelle und Containerdaten zu speichern. Ein entscheidender Vorteil ist das Fehlen von Ingress- oder Egress-Gebühren für die Datenübertragung.
  6. Bereitstellen und Skalieren: Für Produktions-Workloads stellen Sie Ihr Modell als serverlosen Endpunkt bereit. Die Autoscaling-Funktion von Runpod verwaltet automatisch die Anzahl der GPU-Worker (von 0 bis zu Tausenden) basierend auf der Echtzeit-Nachfrage und stellt sicher, dass Sie nur für die genutzte Rechenleistung bezahlen.

Kernfunktionen von Runpod

  • Skalierbare GPU-Rechenleistung: Zugriff auf eine Vielzahl von GPUs, von Consumer-Grade RTX 4090s bis hin zu Enterprise-Level H100s und B200s, verfügbar in einer kostengünstigen Community Cloud und einer hochsicheren Secure Cloud.
  • Serverlose GPUs: Stellen Sie Modelle als API-Endpunkte bereit, die automatisch von null skalieren, um jede Arbeitslast zu bewältigen und Leerlaufkosten zu eliminieren.
  • FlashBoot-Technologie: Erreichen Sie blitzschnelle Skalierung mit Kaltstartzeiten von unter 200 ms, um sicherzustellen, dass Ihre Anwendung immer reaktionsschnell ist.
  • Persistenter Speicher: S3-kompatibler Speicher ohne Ingress/Egress-Gebühren, der es Ihnen ermöglicht, vollständige KI-Pipelines von der Datenaufnahme bis zur Bereitstellung nahtlos auszuführen.
  • Vorgefertigte Vorlagen: Eine reichhaltige Bibliothek von Vorlagen, um Umgebungen für Training, Inferenz und mehr sofort einzurichten und die Einrichtungszeit erheblich zu reduzieren.
  • Globale Infrastruktur: Stellen Sie Workloads in über 8 Regionen weltweit bereit, um eine geringe Latenz und globale Zuverlässigkeit zu gewährleisten.
  • Integrierte Orchestrierung & Überwachung: Die Plattform übernimmt das Task-Queuing und die Verteilung automatisch und bietet Echtzeit-Protokolle, Überwachung und Metriken, ohne dass benutzerdefinierte Frameworks erforderlich sind.

Anwendungsfälle für Runpod

Runpod ist vielseitig und unterstützt eine breite Palette von Anwendungen:

  • Inferenz-Serving: Bereitstellung und Bedienung von Inferenz für Bild-, Text- und Audiogenerierungsmodelle in jedem Maßstab mit geringer Latenz.
  • Modell-Feinabstimmung: Trainieren und feinabstimmen Sie benutzerdefinierte Modelle auf Ihren spezifischen Datensätzen effizient und kostengünstig.
  • KI-Agenten: Erstellen und hosten Sie intelligente, autonome agentenbasierte Systeme und komplexe Workflows.
  • Rechenintensive Aufgaben: Führen Sie anspruchsvolle Workloads wie 3D-Rendering, wissenschaftliche Simulationen und groß angelegte Datenverarbeitung aus.

Vorteile von Runpod

Runpod bietet erhebliche Vorteile gegenüber traditionellen Cloud-Anbietern:

  • Kosteneffizienz: Mit sekundengenauer Abrechnung, wettbewerbsfähigen GPU-Preisen und null Daten-Egress-Gebühren berichten Benutzer von Einsparungen von bis zu 90% bei ihren Infrastrukturkosten.
  • Geschwindigkeit und Agilität: Von der Idee zur Ausführung in Sekunden. Die schnelle Bereitstellung der Plattform, minimale Kaltstarts und Autoscaling-Funktionen beschleunigen den Entwicklungszyklus.
  • Einfachheit: Die Abstraktion der Infrastrukturkomplexität ermöglicht es Teams, sich auf ihr Kernprodukt und ihre Funktionen zu konzentrieren, nicht auf DevOps.
  • Flexibilität: Hochgradig anpassbare Umgebungen, einschließlich GPU-Modellen, Skalierungsverhalten, Leerlaufzeitlimits und Rechenzentrumsstandorten.
  • Zuverlässigkeit: Service auf Unternehmensebene mit 99,9% Verfügbarkeit, integrierten Failover-Mechanismen und robuster Sicherheit (SOC2, HIPAA, GDPR in Vorbereitung).

Preise und Pläne

Die Preisgestaltung von Runpod ist transparent und auf Kosteneffizienz ausgelegt.

  • GPU Cloud: Wird pro Stunde abgerechnet, wobei die Preise je nach GPU-Typ und ob sie sich in der Secure Cloud oder der günstigeren Community Cloud befindet, variieren. Zum Beispiel kann eine RTX 4090 nur 0,69 $/h kosten, während eine High-End-H100 SXM etwa 2,69 $/h kostet.
  • Serverless (Inferenz): Wird pro Sekunde Verarbeitungszeit abgerechnet. Die Preise sind nach GPU-Leistung gestaffelt, mit separaten Raten für 'Flex' (vorgewärmte) und 'Active' Worker. Dieses Modell ist sehr effizient für variablen Datenverkehr.
  • Speicher: Persistenter Pod-Speicher kostet 0,10 $/GB/Monat. S3-kompatibler Network Volume-Speicher ist mit 0,07 $/GB/Monat für unter 1 TB noch günstiger. Es gibt keine Ingress- oder Egress-Gebühren.
  • Reservierungen: Für langfristige Workloads können Benutzer Kapazitäten zu einem ermäßigten Preis reservieren, indem sie sich an das Vertriebsteam wenden.

Tensorfuse

Tensorfuse bietet eine leistungsstarke Plattform für Entwickler und Organisationen, um serverlose GPUs direkt in ihrer eigenen AWS-Cloud-Infrastruktur zu verwalten. Es wurde entwickelt, um den gesamten Lebenszyklus von generativen KI-Modellen zu optimieren, von der Feinabstimmung und dem Experimentieren bis hin zur Bereitstellung und automatischen Skalierung in der Produktion. Durch die Abstraktion der Komplexität von Kubernetes, Docker und der Infrastrukturbereitstellung ermöglicht Tensorfuse den Teams, sich auf die Erstellung von KI-Anwendungen zu konzentrieren, was die Markteinführungszeit und die Betriebskosten erheblich reduziert.

Die Plattform wurde entwickelt, um das Beste aus beiden Welten zu bieten: die Einfachheit einer serverlosen Architektur und die Sicherheit und Kontrolle des Betriebs in Ihrer privaten Cloud. Das bedeutet, dass Ihre proprietären Daten und Modellgewichte niemals Ihre privaten S3-Buckets verlassen, was maximale Sicherheit und Compliance gewährleistet. Tensorfuse ist auf Effizienz ausgelegt, mit einer optimierten Container-Laufzeit, die schnelle Kaltstarts für schwere GPU-Workloads ermöglicht, sodass Dienste in Sekunden von null skalieren können.

Wie man Tensorfuse verwendet

Der Einstieg in Tensorfuse ist als unkomplizierter Prozess konzipiert:

  1. Anmelden & AWS verbinden: Beginnen Sie mit der Anmeldung für einen Plan (einschließlich einer kostenlosen 'Hacker'-Stufe) und verbinden Sie Ihr AWS-Konto. Tensorfuse richtet dann die notwendigen Ressourcen in Ihrer Cloud-Umgebung ein.
  2. Entwicklungscontainer für Experimente verwenden: Verbinden Sie Ihre lokale IDE (wie VS Code) direkt mit einer Cloud-GPU über die Entwicklungscontainer von Tensorfuse. Dies eliminiert die Notwendigkeit von SSH, Code-Kopieren und Abhängigkeitsmanagement. Alle Änderungen an Ihrem lokalen Code werden sofort synchronisiert, was schnelle Echtzeit-Experimente ermöglicht.
  3. Modelle feinabstimmen: Nutzen Sie beliebte Trainingsbibliotheken wie Axolotl, Unsloth oder Hugging Face, um Open-Source-Modelle auf Ihren proprietären Datensätzen feinabzustimmen. Sie können auch benutzerdefinierte Trainingsschleifen schreiben. Die Plattform kümmert sich um die zugrunde liegende GPU-Bereitstellung und -Verwaltung.
  4. Für Inferenz bereitstellen: Stellen Sie Ihre trainierten oder vortrainierten Modelle als serverlose Endpunkte bereit. Diese Endpunkte skalieren automatisch basierend auf dem eingehenden Datenverkehr, von null bis zur Bewältigung hoher Gleichzeitigkeit, und gewährleisten so Kosteneffizienz und Leistung. Modelle können als OpenAI-kompatible APIs bereitgestellt werden.
  5. Mit Job-Warteschlangen verwalten: Für asynchrone Aufgaben wie Batch-Verarbeitung oder Offline-Inferenz verwenden Sie die Funktion für Job-Warteschlangen. Sie können Jobs programmatisch in die Warteschlange stellen, minimale und maximale Skalierungsparameter für eine effiziente Ressourcenzuweisung definieren und ihren Status über einen einfachen CLI-Befehl überwachen.

Kernfunktionen von Tensorfuse

  • Serverlose Inferenz: Skaliert GPU-Bereitstellungen automatisch als Reaktion auf den Datenverkehr, mit schnellen Kaltstarts (Starten von Containern in Sekunden) und der Möglichkeit, zur Kosteneinsparung auf null zu skalieren.
  • Effiziente Feinabstimmung: Stimmen Sie Modelle sicher auf Ihren privaten Daten ab, indem Sie das S3 Ihrer Cloud verwenden. Es bietet eine flexible Integration mit beliebten Frameworks wie Axolotl und Huggingface.
  • Job-Warteschlangen: Stellen Sie Jobs programmatisch für die Batch-Verarbeitung bereit und reihen Sie sie in die Warteschlange ein, mit effizienter Ressourcenzuweisung und Kostenkontrolle durch konfigurierbare Skalierung.
  • Entwicklungscontainer: Verbinden Sie lokalen Code ohne SSH mit Cloud-GPUs für eine schnelle, iterative Entwicklung und Experimente direkt von Ihrer bevorzugten IDE aus.
  • Multi-LoRA-Inferenz: Sofort einsatzbereite Unterstützung zum Trainieren und Hot-Swapping von Tausenden von LoRA-Adaptern auf einer einzigen GPU, um die Hardwareauslastung zu maximieren und die Inferenzkosten zu senken.
  • Breite Hardware-Unterstützung: Führen Sie Workloads auf einer Vielzahl von Hardware aus, einschließlich NVIDIA GPUs (A10G, A100, H100), AWS Trainium/Inferentia-Chips, TPUs und FPGAs.
  • Private Cloud-Sicherheit: Alle Daten, Datensätze und Modellgewichte verbleiben in Ihren privaten AWS S3-Buckets und gewährleisten so volle Kontrolle und Sicherheit.

Anwendungsfälle für Tensorfuse

Tensorfuse ist ideal für eine Vielzahl von KI/ML-Anwendungen:

  • Startups und kleine Teams: Schnelles Erstellen und Bereitstellen von KI-gestützten Funktionen ohne ein dediziertes DevOps-Team, wodurch der Weg von der Idee zur Produktion 20-mal schneller wird.
  • Groß angelegte Inferenz: Bereitstellung von generativen KI-Modellen für Anwendungen mit sprunghaftem oder unvorhersehbarem Datenverkehr, wobei nur für die genutzte Rechenleistung bezahlt wird.
  • Benutzerdefinierte Modell-Feinabstimmung: Unternehmen können Basismodelle wie Llama oder Mistral auf ihren proprietären Daten feinabstimmen, um spezialisierte, leistungsstarke Modelle für spezifische Geschäftsanforderungen zu erstellen.
  • Batch-Verarbeitungs-Workloads: Effizientes Ausführen von Nicht-Echtzeit-Aufgaben wie Datenanalyse, Berichterstellung oder groß angelegter Offline-Inferenz mit dem kostengünstigen Job-Warteschlangensystem.
  • ML-Forschung und Experimente: Forscher und ML-Ingenieure können Entwicklungscontainer verwenden, um Modelle schnell zu iterieren, ohne auf die Einrichtung der Infrastruktur warten zu müssen.

Vorteile von Tensorfuse

Benutzer entscheiden sich für Tensorfuse wegen seiner erheblichen Vorteile, darunter eine gemeldete Reduzierung der Cloud-GPU-Ausgaben um 30 % und eine 20-mal schnellere Markteinführungszeit. Es eliminiert die Notwendigkeit komplexer, selbstverwalteter DevOps-Lösungen und setzt so Engineering-Ressourcen frei. Die Plattform bietet die Leistung und Skalierbarkeit eines verwalteten Dienstes mit der Sicherheit und den Kostenvorteilen des Betriebs in der eigenen Cloud. Testimonials heben das außergewöhnliche und reaktionsschnelle Support-Team hervor, das bei der Migration und bei laufenden Problemen hilft und den Onboarding-Prozess reibungslos und effizient gestaltet.

Preise und Pläne

Tensorfuse bietet eine gestaffelte Preisstruktur, um unterschiedlichen Anforderungen gerecht zu werden:

  • Hacker (Kostenlos): Für Indie-Entwickler und Nebenprojekte. Beinhaltet 100 Managed GPU Hours (MGH), serverlose Inferenz, Entwicklungscontainer und Community-Support.
  • Starter (249 $/Monat): Für kleine Teams. Beinhaltet 2.000 MGH, alle Hacker-Funktionen, plus Feinabstimmung, GitHub Actions, benutzerdefinierte Domains und privaten Slack-Support. Eine 14-tägige kostenlose Testversion ist verfügbar.
  • Growth (799 $/Monat): Für wachsende Startups. Beinhaltet 5.000 MGH, alle Starter-Funktionen, plus Batch-Jobs & Job-Warteschlangen, Umgebungen, Multi-LoRA-Inferenz und Premium-Support. Eine 14-tägige kostenlose Testversion ist verfügbar.
  • Enterprise (Benutzerdefiniert): Für große Organisationen, die erweiterte Funktionen benötigen. Beinhaltet benutzerdefinierte MGH mit Mengenrabatten, alle Growth-Funktionen, plus rollenbasierte Zugriffskontrolle (RBAC), SSO, unternehmenstaugliche Sicherheit (SOC2, HIPAA) und dedizierten Engineering-Support.
  • Startup-Deal: Frühphasen-Startups mit weniger als 500.000 $ an Finanzierung können sich für 10.000 Stunden kostenloses GPU-Compute-Management für 6 Monate qualifizieren.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
Cloud Computing
Nur Runpod
Maschinelles LernenAutomatisierung
Nur Tensorfuse
BereitstellungMLOps

Tags

Gemeinsam
KI-Modell-BereitstellungCloud ComputingFeinabstimmungInferenz
Nur Runpod
AutoscalingEntwicklerwerkzeugeGPUInfrastrukturmaschinelles LernenServerless
Nur Tensorfuse
AWSDockerGenerative KIKubernetesMLOpsServerlose GPU

Zielgruppen und Rollen

Gemeinsam
Keine verifizierten Daten
Nur Runpod
Keine verifizierten Daten
Nur Tensorfuse
Keine verifizierten Daten

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Runpod monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
2.3M
Ø Besuchsdauer
9:26
Seiten pro Besuch
7.98
Absprungrate
31.98%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 1.6M
  • 2026-01: 1.9M
  • 2026-02: 1.9M
  • 2026-03: 2.4M
  • 2026-04: 2.3M
  • 2026-05: 2.3M

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States58.83%1.4M
🇮🇳India13.6%317.4K
🇩🇪Germany13.56%316.5K
🇧🇷Brazil7.44%173.7K
🇳🇬Nigeria6.57%153.3K

Traffic-Quellen

Source typePercentageEstimated visits
Direkt78.77%1.8M
Verweis20.03%467.5K
E-Mail1.2%28K

Suchbegriffe

run podrunpodrunpod passwordrunpod pricingrunpod serverless

Tensorfuse monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
6.7K
Ø Besuchsdauer
1:01
Seiten pro Besuch
1.8
Absprungrate
44.71%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 10.1K
  • 2026-01: 5.4K
  • 2026-02: 4.2K
  • 2026-03: 4.9K
  • 2026-04: 5.3K
  • 2026-05: 6.7K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States38.24%2.6K
🇻🇳Vietnam36.56%2.5K
🇮🇳India25.2%1.7K

Suchbegriffe

aws serverless gpubrew install aws clillama.cpp serverlessllm inference servers compared: vllm vs tgi vs sglang vs tritontensorfuse

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

Runpod

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
146
Likes
166

Tensorfuse

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
170
Likes
144

Runpod vs Tensorfuse · Vergleichs-FAQ

What do Runpod and Tensorfuse have in common?
Both tools are listed under Cloud Computing. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Runpod and Tensorfuse free?
Listed pricing models: Runpod — Paid; Tensorfuse — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Runpod and Tensorfuse?
The primary listed category is Maschinelles Lernen for Runpod, and Bereitstellung for Tensorfuse. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche