Bright Data
Business Intelligence
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
Business Intelligence
Web Scraping
Bright Data ist die weltweit führende Web-Datenplattform und bietet eine umfassende Suite von Tools, einschließlich Proxy-Netzwerken, KI-gestützten Web-Scrapern und sofort einsatzbereiten Datensätzen. Sie ermöglicht es Unternehmen, große Mengen öffentlicher Web-Daten für KI-Training, Marktforschung und Wettbewerbsanalyse zu sammeln.
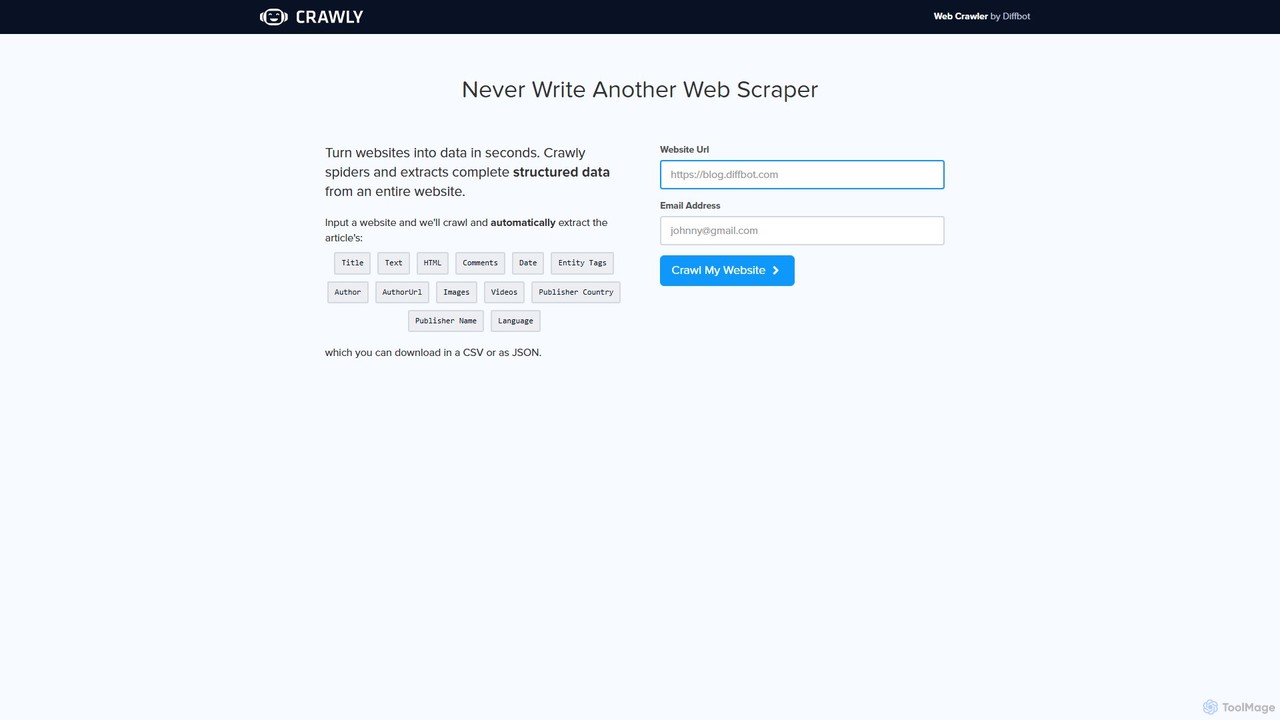
Crawly ist ein KI-gesteuerter Web-Crawler von Diffbot, der automatisch strukturierte Daten von ganzen Websites extrahiert. Geben Sie einfach eine URL ein, und Crawly durchsucht die Seite, um wichtige Informationen wie Artikel, Produkte und Diskussionen zu extrahieren und sie ohne Programmierung in saubere JSON- oder CSV-Daten umzuwandeln.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Kerndaten | Bright Data | Crawly |
|---|---|---|
| Pricing model | Paid | Freemium |
| Product type | Web | Web |
| Primary focus | Business Intelligence | Web Scraping |
| Zielgruppen und Rollen | Nicht verifiziert | Nicht verifiziert |
| Kategorien | Business Intelligence · Web Scraping · API · Marktforschung | Web Scraping · API · Marktforschung · Automatisierung |
| Added | 12.08.2025 | 10.08.2025 |
| Aktualisiert | 19.11.2026 | 19.11.2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
Bright Data ist die weltweit führende Web-Datenplattform und wird von über 20.000 Organisationen in nahezu jeder Branche genutzt. Sie bietet eine robuste All-in-One-Lösung zum Entdecken, Zugreifen und Extrahieren öffentlicher Web-Daten in jedem Maßstab. Ob Sie Echtzeit- oder historische Daten benötigen, die Infrastruktur von Bright Data ist darauf ausgelegt, strukturierte, zuverlässige Informationen zu liefern, die für jedes Modell, jede Pipeline oder jeden Workflow bereit sind. Die Plattform wurde entwickelt, um die KI-Entwicklung voranzutreiben, die Marktforschung zu unterstützen, Online-Assets zu überwachen und datengesteuerte Entscheidungen zu ermöglichen.
Bright Data bietet eine flexible Plattform, die je nach Ihren Bedürfnissen auf verschiedene Weisen genutzt werden kann:
Die Lösungen von Bright Data sind vielseitig und eignen sich für eine breite Palette von Anwendungen:
Die Wahl von Bright Data bietet einen erheblichen Wettbewerbsvorteil. Die All-in-One-Plattform konsolidiert den Bedarf an mehreren Anbietern, indem sie Proxys, Scraper und Datensätze unter einem Dach anbietet. Die Qualität und Zuverlässigkeit der Daten sind dank robuster Validierungsprozesse unübertroffen. Die immense Skalierbarkeit und globale Reichweite der Plattform bedeuten, dass kein Ziel unerreichbar ist. Entscheidend ist, dass das starke Engagement von Bright Data für eine ethische und konforme Datenerfassung Unternehmen, die in einer komplexen regulatorischen Landschaft tätig sind, Sicherheit bietet. Die entwicklerfreundlichen Tools und der dedizierte Support gewährleisten eine reibungslose Erfahrung vom Onboarding bis zur Produktion.
Bright Data bietet ein flexibles Pay-as-you-go-Preismodell sowie monatliche und jährliche Abonnementpläne, die auf unterschiedliche Bedürfnisse und Skalierungen zugeschnitten sind.
Für detaillierte und individuelle Preise wird empfohlen, das Vertriebsteam von Bright Data zu kontaktieren oder deren offizielle Preisseite zu besuchen.
Crawly ist ein leistungsstarker und intelligenter Web-Crawler, der von Diffbot, einem führenden Anbieter von KI-gestützter Datenextraktion, entwickelt wurde. Er wurde entwickelt, um die manuellen und technischen Herausforderungen des Web-Scrapings vollständig zu beseitigen. Anstatt komplexen Code zu schreiben oder fragile Selektoren zu verwenden, die bei Website-Updates brechen, nutzt Crawly fortschrittliche künstliche Intelligenz, einschließlich Computer Vision und Natural Language Processing, um Webseiten wie ein Mensch zu verstehen und zu interpretieren. Dies ermöglicht es, automatisch vollständige, strukturierte Daten von einer gesamten Website mit nur einer URL als Eingabe zu identifizieren und zu extrahieren.
Das Kernversprechen von Crawly lautet: 'Websites in Sekundenschnelle in Daten verwandeln'. Es navigiert durch eine Website, folgt Links und analysiert die Struktur jeder Seite, um zwischen verschiedenen Inhaltstypen wie Artikeln, Produkten, Diskussionen und Bildergalerien zu unterscheiden. Die extrahierten Daten werden dann in einem sauberen, strukturierten Format organisiert, das sofort für Anwendungen, Datenanalysen oder maschinelle Lernmodelle bereitsteht.
Die Verwendung von Crawly ist so konzipiert, dass sie für jeden unglaublich einfach und zugänglich ist, unabhängig von den technischen Fähigkeiten. Der Prozess umfasst nur wenige Schritte:
Crawly ist ein vielseitiges Werkzeug, das für eine breite Palette von Anwendungen geeignet ist:
Der Hauptvorteil von Crawly liegt in seiner Einfachheit und Leistungsfähigkeit. Es demokratisiert die Webdatenextraktion und ermöglicht es Nicht-Entwicklern, Aufgaben auszuführen, die normalerweise ein Team von Ingenieuren erfordern würden. Es spart immense Mengen an Zeit und Ressourcen, indem es den gesamten Scraping-Prozess automatisiert. Darüber hinaus gewährleistet sein KI-gesteuerter Ansatz eine höhere Genauigkeit und größere Widerstandsfähigkeit als herkömmliche Methoden und liefert einen zuverlässigen Strom hochwertiger Daten. Als Produkt von Diffbot wird es von unternehmenstauglicher Technologie unterstützt, der große Konzerne weltweit vertrauen.
Crawly bietet einen kostenlosen Test-Crawl direkt von seiner Homepage an, der es den Benutzern ermöglicht, seine Fähigkeiten durch Eingabe einer URL und einer E-Mail-Adresse zu testen. Dies soll eine Probe der strukturierten Daten liefern, die das Tool produzieren kann. Für umfangreichere Anforderungen, wie z. B. groß angelegtes Crawling, häufige Datenextraktion oder API-Zugriff für die programmatische Nutzung, würden Benutzer normalerweise die gesamte Suite von Tools abonnieren, die von seiner Muttergesellschaft Diffbot angeboten wird. Die Preisgestaltung von Diffbot ist gestaffelt, mit Plänen für Startups, Unternehmen und große Konzerne, die unterschiedliche Stufen von API-Aufrufen und Funktionen bieten.
Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.
Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 46.92% | 380.5K |
| 🇨🇳China | 21.71% | 176.1K |
| 🇮🇳India | 13.14% | 106.6K |
| 🇬🇧United Kingdom | 10.78% | 87.4K |
| 🇻🇳Vietnam | 7.45% | 60.4K |
| Source type | Percentage | Estimated visits |
|---|---|---|
| Direkt | 86.27% | 699.6K |
| Verweis | 10.39% | 84.3K |
| 3.34% | 27.1K |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇳🇬Nigeria | 82.43% | 1.5K |
| 🇩🇪Germany | 9.9% | 177 |
| 🇨🇦Canada | 7.67% | 137 |
Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.