ToolMage
Anmelden

AI TOOL COMPARISON

Crawly vs Simplescraper

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

Crawly Produktübersicht

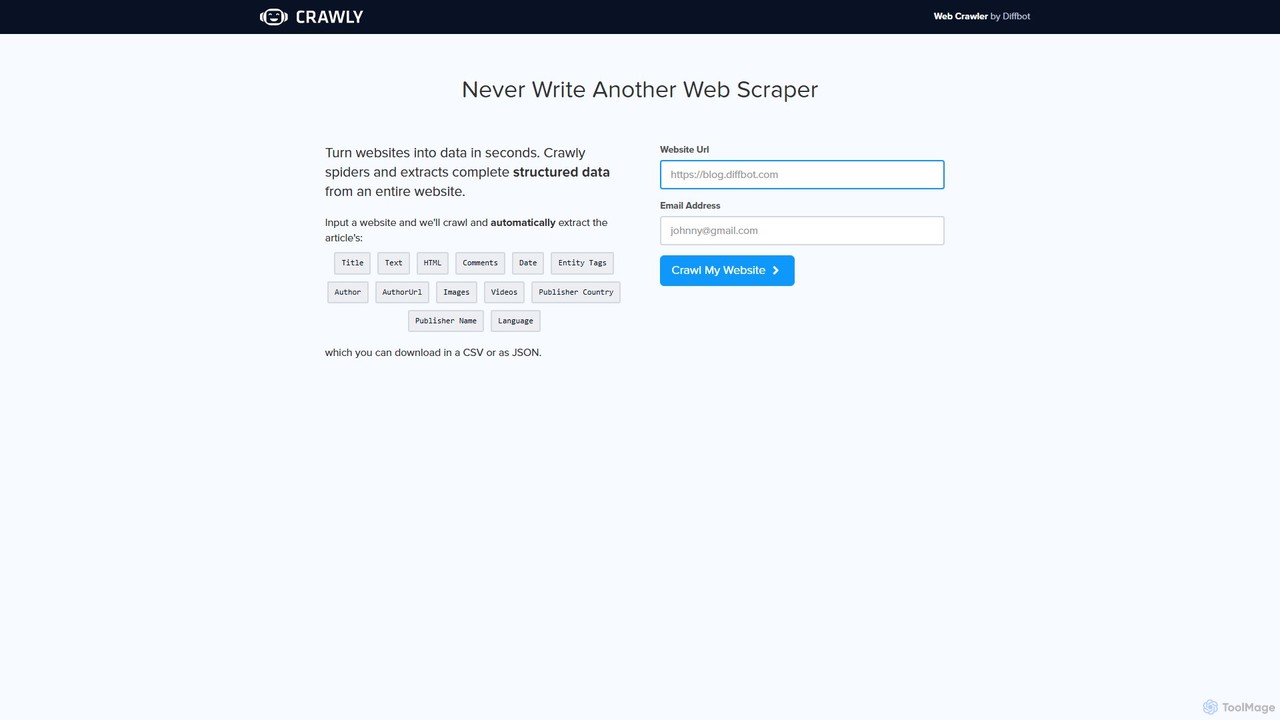
Crawly ist ein KI-gesteuerter Web-Crawler von Diffbot, der automatisch strukturierte Daten von ganzen Websites extrahiert. Geben Sie einfach eine URL ein, und Crawly durchsucht die Seite, um wichtige Informationen wie Artikel, Produkte und Diskussionen zu extrahieren und sie ohne Programmierung in saubere JSON- oder CSV-Daten umzuwandeln.

Preview

Simplescraper Produktübersicht

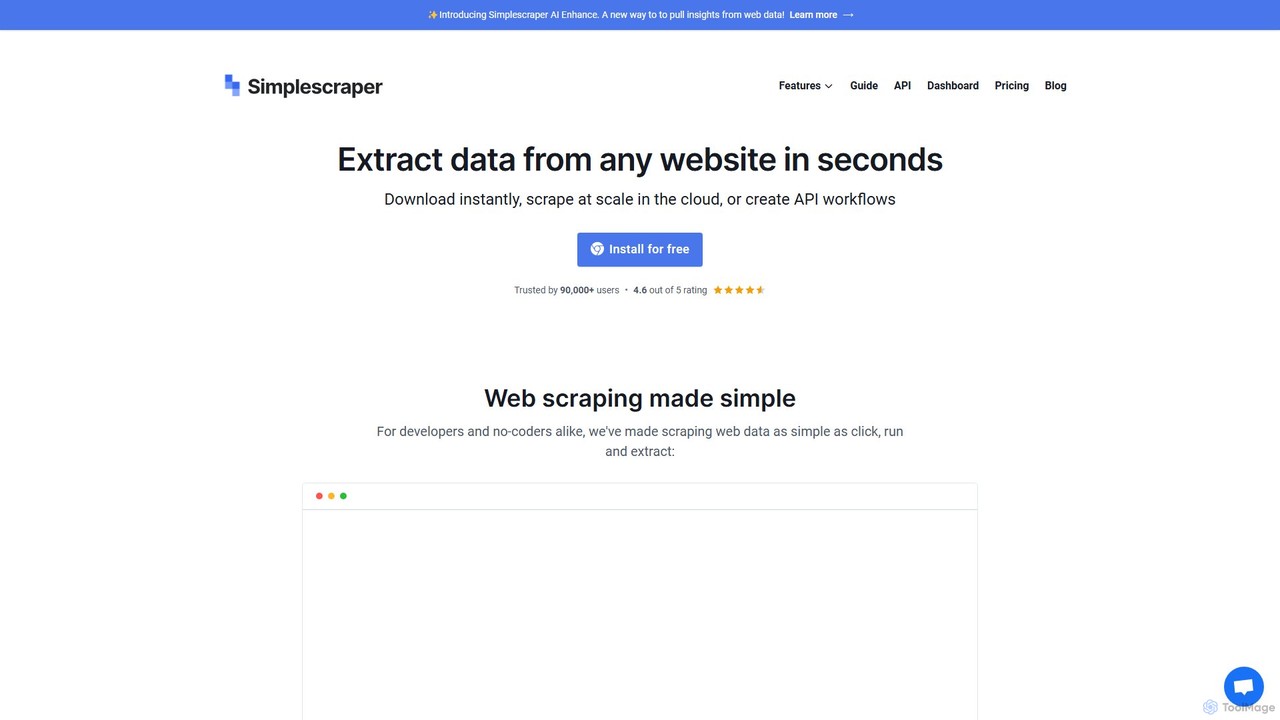
Simplescraper ist ein leistungsstarkes Web-Scraping-Tool, das in Sekundenschnelle Daten von jeder Website extrahiert. Es bietet eine benutzerfreundliche Chrome-Erweiterung für die Datenauswahl ohne Code, cloudbasierte Automatisierung für groß angelegtes Scraping und eine innovative KI-Enhance-Funktion, um mit einfachen Anweisungen Erkenntnisse zu gewinnen. Verwandeln Sie Websites in strukturierte Daten (CSV, JSON) oder sofortige APIs und integrieren Sie sie mit Tools wie Google Sheets und Airtable.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Crawly VS Simplescraper — Kerndaten
KerndatenCrawlySimplescraper
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusWeb ScrapingWeb Scraping
Zielgruppen und RollenNicht verifiziertNicht verifiziert
KategorienWeb Scraping · API · Marktforschung · AutomatisierungWeb Scraping · API · Lead-Generierung · Automatisierung
Added10.08.202517.08.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Crawly

Crawly ist ein leistungsstarker und intelligenter Web-Crawler, der von Diffbot, einem führenden Anbieter von KI-gestützter Datenextraktion, entwickelt wurde. Er wurde entwickelt, um die manuellen und technischen Herausforderungen des Web-Scrapings vollständig zu beseitigen. Anstatt komplexen Code zu schreiben oder fragile Selektoren zu verwenden, die bei Website-Updates brechen, nutzt Crawly fortschrittliche künstliche Intelligenz, einschließlich Computer Vision und Natural Language Processing, um Webseiten wie ein Mensch zu verstehen und zu interpretieren. Dies ermöglicht es, automatisch vollständige, strukturierte Daten von einer gesamten Website mit nur einer URL als Eingabe zu identifizieren und zu extrahieren.

Das Kernversprechen von Crawly lautet: 'Websites in Sekundenschnelle in Daten verwandeln'. Es navigiert durch eine Website, folgt Links und analysiert die Struktur jeder Seite, um zwischen verschiedenen Inhaltstypen wie Artikeln, Produkten, Diskussionen und Bildergalerien zu unterscheiden. Die extrahierten Daten werden dann in einem sauberen, strukturierten Format organisiert, das sofort für Anwendungen, Datenanalysen oder maschinelle Lernmodelle bereitsteht.

Wie man Crawly verwendet

Die Verwendung von Crawly ist so konzipiert, dass sie für jeden unglaublich einfach und zugänglich ist, unabhängig von den technischen Fähigkeiten. Der Prozess umfasst nur wenige Schritte:

  1. URL eingeben: Navigieren Sie zur Crawly-Website. Geben Sie im dafür vorgesehenen Eingabefeld die vollständige URL der Website ein, die Sie crawlen möchten.
  2. E-Mail angeben: Geben Sie Ihre E-Mail-Adresse ein. Diese wird verwendet, um Sie zu benachrichtigen und die Ergebnisse zu liefern, sobald der Crawl abgeschlossen ist.
  3. Crawl starten: Klicken Sie auf die Schaltfläche 'Crawl My Website'. Die KI-Engine von Crawly beginnt dann, die gesamte Website zu durchsuchen, Seiten zu analysieren und Informationen zu extrahieren.
  4. Daten herunterladen: Sobald der Vorgang abgeschlossen ist, erhalten Sie die extrahierten Daten. Sie können sie in praktischen, strukturierten Formaten wie JSON oder CSV herunterladen, was den Import in Datenbanken, Tabellenkalkulationen oder andere Software erleichtert.

Kernfunktionen von Crawly

  • KI-gestützte automatische Extraktion: Nutzt die fortschrittliche KI von Diffbot, um Daten aus Artikeln, Produkten, Diskussionen und mehr automatisch zu erkennen und zu extrahieren, ohne manuelle Konfiguration.
  • Umfassende Datenfelder: Extrahiert einen reichen Satz von Datenpunkten, einschließlich Titel, Text, HTML, Kommentare, Datum, Autor, Autor-URL, Bilder, Videos, Herausgeberinformationen (Land, Name) und Sprache.
  • Entitätserkennung: Identifiziert und markiert automatisch Entitäten im Text, wie Personen, Organisationen und Orte, und fügt eine weitere Ebene wertvoller Metadaten hinzu.
  • Vollständiges Website-Crawling: Im Gegensatz zu Einzelseiten-Scrapern navigiert Crawly durch eine gesamte Website, um Daten umfassend zu sammeln.
  • Strukturierte Datenausgabe: Liefert saubere, gut strukturierte Daten in den Formaten JSON oder CSV, wodurch die Notwendigkeit der Nachbearbeitung und Datenbereinigung entfällt.
  • No-Code-Lösung: Erfordert keine Programmierkenntnisse oder Wissen über Web-Scraping-Technologien, was es für Vermarkter, Forscher und Geschäftsanalysten zugänglich macht.
  • Robust und widerstandsfähig: Da es die semantische Struktur des Inhalts versteht, wird es nicht leicht durch Änderungen am Website-Layout beeinträchtigt, ein häufiges Problem bei herkömmlichen Scrapern.

Anwendungsfälle für Crawly

Crawly ist ein vielseitiges Werkzeug, das für eine breite Palette von Anwendungen geeignet ist:

  • Marktforschung: Sammeln Sie automatisch Produktinformationen, Preise, Kundenbewertungen und Erwähnungen in den Nachrichten von Wettbewerbern, um einen Wettbewerbsvorteil zu erzielen.
  • Lead-Generierung: Extrahieren Sie Kontaktdaten, Unternehmensinformationen und Schlüsselpersonal von Unternehmenswebsites und Online-Verzeichnissen.
  • Content-Aggregation: Erstellen Sie einen benutzerdefinierten Newsfeed oder eine Content-Plattform, indem Sie Artikel, Blog-Posts und Videos aus mehreren Quellen aggregieren.
  • Daten für maschinelles Lernen: Erstellen Sie große, hochwertige Datensätze für das Training von maschinellen Lernmodellen, wie z. B. Sentiment-Analysen von Produktbewertungen oder Trendanalysen aus Nachrichtenartikeln.
  • Markenüberwachung: Verfolgen Sie in Echtzeit, wie Ihre Marke, Produkte oder Führungskräfte im Web erwähnt werden.

Vorteile von Crawly

Der Hauptvorteil von Crawly liegt in seiner Einfachheit und Leistungsfähigkeit. Es demokratisiert die Webdatenextraktion und ermöglicht es Nicht-Entwicklern, Aufgaben auszuführen, die normalerweise ein Team von Ingenieuren erfordern würden. Es spart immense Mengen an Zeit und Ressourcen, indem es den gesamten Scraping-Prozess automatisiert. Darüber hinaus gewährleistet sein KI-gesteuerter Ansatz eine höhere Genauigkeit und größere Widerstandsfähigkeit als herkömmliche Methoden und liefert einen zuverlässigen Strom hochwertiger Daten. Als Produkt von Diffbot wird es von unternehmenstauglicher Technologie unterstützt, der große Konzerne weltweit vertrauen.

Preise und Pläne

Crawly bietet einen kostenlosen Test-Crawl direkt von seiner Homepage an, der es den Benutzern ermöglicht, seine Fähigkeiten durch Eingabe einer URL und einer E-Mail-Adresse zu testen. Dies soll eine Probe der strukturierten Daten liefern, die das Tool produzieren kann. Für umfangreichere Anforderungen, wie z. B. groß angelegtes Crawling, häufige Datenextraktion oder API-Zugriff für die programmatische Nutzung, würden Benutzer normalerweise die gesamte Suite von Tools abonnieren, die von seiner Muttergesellschaft Diffbot angeboten wird. Die Preisgestaltung von Diffbot ist gestaffelt, mit Plänen für Startups, Unternehmen und große Konzerne, die unterschiedliche Stufen von API-Aufrufen und Funktionen bieten.

Simplescraper

Simplescraper ist ein umfassender Web-Scraping-Dienst, der die Datenextraktion für jedermann zugänglich machen soll, von Laien ohne Programmierkenntnisse bis hin zu erfahrenen Entwicklern. Über 90.000 Benutzer vertrauen darauf, jede Website in eine Quelle strukturierter, verwertbarer Daten zu verwandeln. Mit seiner intuitiven Chrome-Erweiterung können Sie einfach auf die benötigten Daten klicken, und mit seiner Cloud-Plattform können Sie groß angelegte, automatisierte Scraping-Aufgaben nach einem Zeitplan ausführen. Das herausragende Merkmal, Simplescraper AI Enhance, ermöglicht es Ihnen, natürliche Sprachanweisungen zu verwenden, um Webinhalte zu extrahieren, zusammenzufassen und zu analysieren, wodurch komplexe Konfigurationen oder CSS-Selektoren überflüssig werden.

Wie man Simplescraper verwendet

Der Einstieg in Simplescraper ist unkompliziert und bietet je nach Bedarf mehrere Wege:

  1. Verwendung der Chrome-Erweiterung (empfohlen): Installieren Sie die kostenlose Erweiterung aus dem Chrome Store. Navigieren Sie zu der Website, die Sie scrapen möchten, klicken Sie auf das Erweiterungssymbol und beginnen Sie mit der Auswahl der Datenelemente (wie Text, Links oder Bilder), die Sie extrahieren möchten. Sie können die Ergebnisse sofort anzeigen und als CSV- oder JSON-Datei herunterladen.
  2. Speichern eines „Rezepts“ für Cloud-Scraping: Für wiederkehrende oder groß angelegte Aufgaben speichern Sie Ihre Auswahl als „Rezept“. Dieses Rezept kann dann in der Cloud ausgeführt werden, sodass Sie Tausende von Seiten scrapen, Paginierung und unendliches Scrollen bewältigen und Scrapes zur automatischen Ausführung planen können.
  3. Verwendung von Smart Extract: Für einen noch einfacheren KI-gesteuerten Ansatz gehen Sie zur Funktion „Smart Extract“ im Dashboard. Geben Sie einfach eine URL an und beschreiben Sie die benötigten Daten (z. B. „Produktname, Preis und Kundenbewertung“). Die KI analysiert die Seite und generiert automatisch ein wiederverwendbares Scraping-Rezept für Sie.
  4. Nutzung von AI Enhance: Nach dem Ausführen eines Scrapes gehen Sie zum Tab „AI Enhance“ für dieses Rezept. Sie können vordefinierte oder benutzerdefinierte Anweisungen auf Ihre gescrapten Daten anwenden, um Aufgaben wie die Stimmungsanalyse von Bewertungen, das Zusammenfassen von Artikeln oder das Formatieren von Adressen durchzuführen.
  5. API-Integration: Jedes von Ihnen erstellte Scraping-Rezept wird sofort zu einem API-Endpunkt. Sie können diese API aufrufen, um bei Bedarf aktuelle Daten zu erhalten, was sie perfekt für dynamische Anwendungen und Workflows macht.

Kernfunktionen von Simplescraper

  • KI-gestützte Extraktion: Nutzt KI durch „Smart Extract“, um Daten anhand einfacher Beschreibungen zu identifizieren, und „AI Enhance“, um gescrapte Inhalte mit natürlichen Sprachanweisungen zu verarbeiten und zu analysieren.
  • No-Code-Oberfläche & Chrome-Erweiterung: Eine intuitive Point-and-Click-Oberfläche, die es jedem leicht macht, Daten ohne eine einzige Zeile Code auszuwählen und zu extrahieren.
  • Skalierbares Cloud-Scraping: Führen Sie unbegrenzt Scraping-Aufgaben jeder Größe aus. Die Plattform bewältigt komplexe Szenarien wie JavaScript-basierte Websites (Single Page Apps), Paginierung, unendliches Scrollen und Login-Barrieren.
  • Sofortige API-Generierung: Verwandelt jede von Ihnen gescrapte Website automatisch in eine strukturierte API und ermöglicht den programmatischen Zugriff auf aktuelle Daten.
  • Umfassende Integrationen: Senden Sie Ihre Daten nahtlos an Google Sheets, Airtable, Zapier oder jede andere Anwendung über Webhooks und ermöglichen Sie so automatisierte Workflows.
  • Erweitertes Scraping-Toolkit: Zu den Funktionen gehören Proxy-Rotation zur Vermeidung von Sperren, reCaptcha-Lösung, Deep Scraping (Crawlen von Links, um Daten von Folgeseiten zu extrahieren) und die Möglichkeit, nur eindeutige Einträge zu scrapen, um Duplikate zu vermeiden.
  • Geplantes Scraping: Stellen Sie Ihre Scrapes so ein, dass sie in jedem von Ihnen gewählten Intervall ausgeführt werden, von jeder Minute bis einmal im Monat, um sicherzustellen, dass Ihre Daten immer auf dem neuesten Stand sind.

Anwendungsfälle für Simplescraper

Simplescraper ist vielseitig und kann in verschiedenen Branchen für zahlreiche Zwecke eingesetzt werden:

  • E-Commerce: Verfolgen Sie die Preise der Konkurrenz, überwachen Sie die Produktverfügbarkeit, sammeln Sie Kundenbewertungen und erfassen Sie Produktkatalogdaten.
  • Immobilien: Scrapen Sie Immobilienangebote von Websites wie Zillow, um Daten zu Preisen, Standorten, Quadratmeterzahlen und Maklerdetails für die Marktanalyse zu sammeln.
  • Lead-Generierung: Extrahieren Sie Kontaktinformationen aus Online-Verzeichnissen, beruflichen Netzwerken und Unternehmenswebsites, um Vertriebs-Lead-Listen zu erstellen.
  • Marktforschung: Sammeln Sie Daten zu Markttrends, analysieren Sie die öffentliche Meinung aus sozialen Medien oder Foren und sammeln Sie Daten für akademische oder geschäftliche Forschung.
  • Finanzdienstleistungen: Sammeln Sie Börsendaten, Finanznachrichten und Wirtschaftsindikatoren aus verschiedenen Online-Quellen.
  • Personalbeschaffung: Sammeln Sie Stellenangebote von mehreren Jobbörsen, um Talente zu finden oder den Arbeitsmarkt zu analysieren.

Vorteile von Simplescraper

Simplescraper zeichnet sich durch seine Kombination aus Einfachheit und Leistung aus. Sein Hauptvorteil ist das benutzerfreundliche Design, das Web-Scraping für nicht-technische Benutzer demokratisiert. Die KI-Funktionen senken die Einstiegshürde erheblich, da Benutzer keine HTML-Struktur oder CSS-Selektoren mehr verstehen müssen. Für Entwickler bietet es ein robustes, skalierbares Backend und eine leistungsstarke API, die Hunderte von Entwicklungsstunden spart. Die Zuverlässigkeit der Cloud-Infrastruktur, komplett mit Proxy-Rotation und CAPTCHA-Lösung, gewährleistet hohe Erfolgsraten bei Scraping-Aufgaben.

Preise und Pläne

Simplescraper bietet ein Freemium-Modell mit Plänen, die auf Ihre Bedürfnisse zugeschnitten sind:

  • Kostenlos: Beinhaltet die Nutzung der Browser-Erweiterung für manuelles Scraping und 100 kostenlose Starter-Credits für automatisiertes Cloud-Scraping.
  • Plus-Plan: 39 $/Monat für 6.000 Credits, Zeitplanung, Google Sheet- & Airtable-Integration, Webhooks und Zugang zu AI Enhance.
  • Pro-Plan: 70 $/Monat für 15.000 Credits, einschließlich aller Plus-Funktionen sowie SERP (Search Engine Results Page)-Scraping-Funktionen.
  • Premium-Plan: 150 $/Monat für 40.000 Credits und alle Pro-Funktionen.
  • Scale-Plan: 249 $/Monat für 100.000 Credits, der auch einen Rezept-Einrichtungsservice und Live-Datenfeeds beinhaltet.

Alle kostenpflichtigen Pläne beinhalten dedizierten Einzel-Support. Credits werden für Cloud-Scraping-Aufgaben verwendet, wobei eine Standardseite 1 Credit und eine JavaScript-lastige Seite 2 Credits kostet. Die Nutzung von AI Enhance wird separat mit 1 Credit pro 800 verarbeiteten Wörtern abgerechnet.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
Web ScrapingAPIAutomatisierung
Nur Crawly
Marktforschung
Nur Simplescraper
Lead-Generierung

Tags

Gemeinsam
APIAutomatisierungDatenextraktionLead-GenerierungMarktforschungNo-CodeWeb Scraping
Nur Crawly
DiffbotJSONstrukturierte DatenWeb-Crawler
Nur Simplescraper
KI-DatenextraktionData MiningPreisverfolgung

Zielgruppen und Rollen

Gemeinsam
Keine verifizierten Daten
Nur Crawly
Keine verifizierten Daten
Nur Simplescraper
Keine verifizierten Daten

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Crawly monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
1.8K
Ø Besuchsdauer
0:31
Seiten pro Besuch
1.15
Absprungrate
93.85%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 2.6K
  • 2026-01: 784
  • 2026-02: 640
  • 2026-03: 1K
  • 2026-04: 475
  • 2026-05: 1.8K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇳🇬Nigeria82.43%1.5K
🇩🇪Germany9.9%177
🇨🇦Canada7.67%137

Suchbegriffe

crawl urlcrawlyonline web crawlerwebsite crawlerwebsite crawler online

Simplescraper monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
104.7K
Ø Besuchsdauer
0:28
Seiten pro Besuch
1.75
Absprungrate
48.21%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 93.6K
  • 2026-01: 112.3K
  • 2026-02: 106.1K
  • 2026-03: 101.8K
  • 2026-04: 116.8K
  • 2026-05: 104.7K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States47.86%50.1K
🇮🇳India28.08%29.4K
🇧🇷Brazil8.48%8.9K
🇬🇧United Kingdom8.15%8.5K
🇫🇷France7.43%7.8K

Traffic-Quellen

Source typePercentageEstimated visits
Direkt88.2%92.4K
Verweis11.73%12.3K
E-Mail0.07%73

Suchbegriffe

extract urllink extractorsimplescraperurl extractorwebsite url extractor

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

Crawly

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
162
Likes
160

Simplescraper

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
172
Likes
172

Crawly vs Simplescraper · Vergleichs-FAQ

What do Crawly and Simplescraper have in common?
Both tools are listed under Web Scraping、API、Automatisierung. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Crawly and Simplescraper free?
Listed pricing models: Crawly — Freemium; Simplescraper — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Crawly and Simplescraper?
The primary listed category is Web Scraping for Crawly, and Web Scraping for Simplescraper. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche