ToolMage
Anmelden

AI TOOL COMPARISON

Crawly vs MrScraper

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

Crawly Produktübersicht

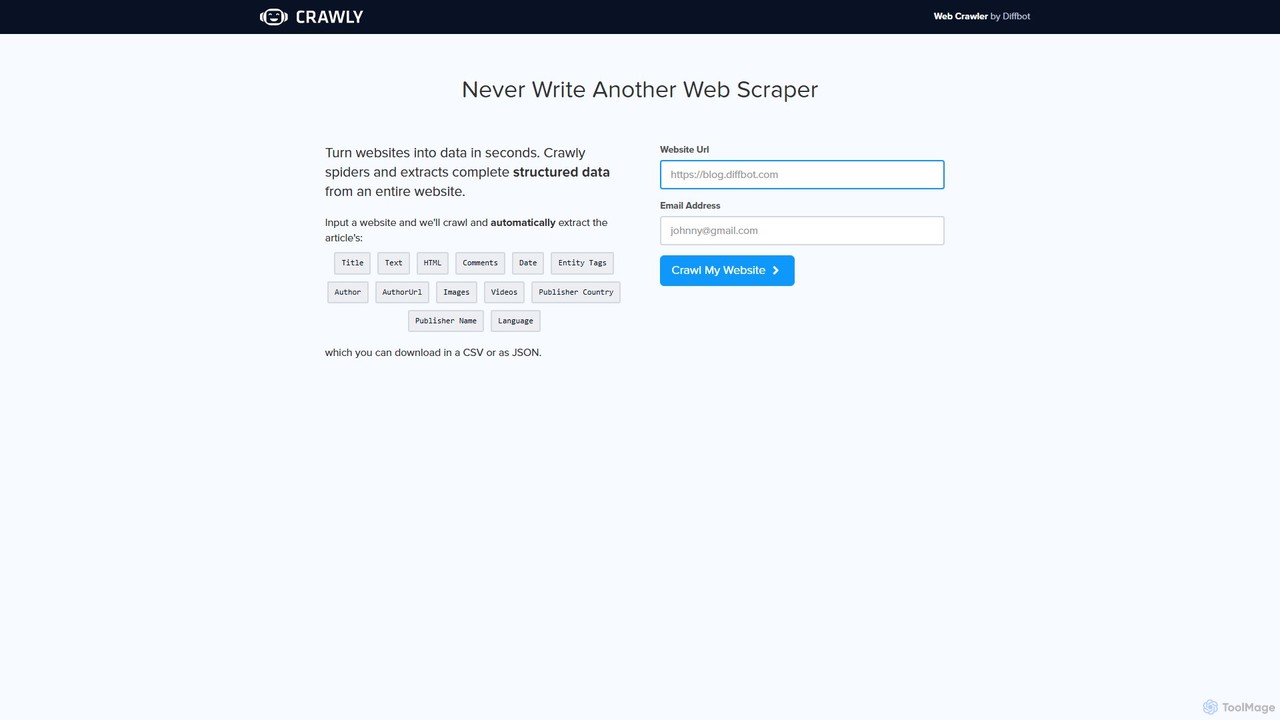
Crawly ist ein KI-gesteuerter Web-Crawler von Diffbot, der automatisch strukturierte Daten von ganzen Websites extrahiert. Geben Sie einfach eine URL ein, und Crawly durchsucht die Seite, um wichtige Informationen wie Artikel, Produkte und Diskussionen zu extrahieren und sie ohne Programmierung in saubere JSON- oder CSV-Daten umzuwandeln.

Preview

MrScraper Produktübersicht

MrScraper ist ein KI-gestütztes No-Code-Web-Scraping-Tool, mit dem Benutzer mühelos strukturierte Daten von jeder Website extrahieren können. Es automatisiert den Datenerfassungsprozess, umgeht Anti-Bot-Maßnahmen wie CAPTCHAs und IP-Sperren und ist somit ideal für Preisintelligenz, Marktforschung und Lead-Generierung.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Crawly VS MrScraper — Kerndaten
KerndatenCrawlyMrScraper
Pricing modelFreemiumPaid
Product typeWebWeb
Primary focusWeb ScrapingWeb Scraping
Zielgruppen und RollenNicht verifiziertNicht verifiziert
KategorienWeb Scraping · API · Marktforschung · AutomatisierungWeb Scraping · Ohne Code · Marktforschung · Automatisierung
Added10.08.202516.08.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Crawly

Crawly ist ein leistungsstarker und intelligenter Web-Crawler, der von Diffbot, einem führenden Anbieter von KI-gestützter Datenextraktion, entwickelt wurde. Er wurde entwickelt, um die manuellen und technischen Herausforderungen des Web-Scrapings vollständig zu beseitigen. Anstatt komplexen Code zu schreiben oder fragile Selektoren zu verwenden, die bei Website-Updates brechen, nutzt Crawly fortschrittliche künstliche Intelligenz, einschließlich Computer Vision und Natural Language Processing, um Webseiten wie ein Mensch zu verstehen und zu interpretieren. Dies ermöglicht es, automatisch vollständige, strukturierte Daten von einer gesamten Website mit nur einer URL als Eingabe zu identifizieren und zu extrahieren.

Das Kernversprechen von Crawly lautet: 'Websites in Sekundenschnelle in Daten verwandeln'. Es navigiert durch eine Website, folgt Links und analysiert die Struktur jeder Seite, um zwischen verschiedenen Inhaltstypen wie Artikeln, Produkten, Diskussionen und Bildergalerien zu unterscheiden. Die extrahierten Daten werden dann in einem sauberen, strukturierten Format organisiert, das sofort für Anwendungen, Datenanalysen oder maschinelle Lernmodelle bereitsteht.

Wie man Crawly verwendet

Die Verwendung von Crawly ist so konzipiert, dass sie für jeden unglaublich einfach und zugänglich ist, unabhängig von den technischen Fähigkeiten. Der Prozess umfasst nur wenige Schritte:

  1. URL eingeben: Navigieren Sie zur Crawly-Website. Geben Sie im dafür vorgesehenen Eingabefeld die vollständige URL der Website ein, die Sie crawlen möchten.
  2. E-Mail angeben: Geben Sie Ihre E-Mail-Adresse ein. Diese wird verwendet, um Sie zu benachrichtigen und die Ergebnisse zu liefern, sobald der Crawl abgeschlossen ist.
  3. Crawl starten: Klicken Sie auf die Schaltfläche 'Crawl My Website'. Die KI-Engine von Crawly beginnt dann, die gesamte Website zu durchsuchen, Seiten zu analysieren und Informationen zu extrahieren.
  4. Daten herunterladen: Sobald der Vorgang abgeschlossen ist, erhalten Sie die extrahierten Daten. Sie können sie in praktischen, strukturierten Formaten wie JSON oder CSV herunterladen, was den Import in Datenbanken, Tabellenkalkulationen oder andere Software erleichtert.

Kernfunktionen von Crawly

  • KI-gestützte automatische Extraktion: Nutzt die fortschrittliche KI von Diffbot, um Daten aus Artikeln, Produkten, Diskussionen und mehr automatisch zu erkennen und zu extrahieren, ohne manuelle Konfiguration.
  • Umfassende Datenfelder: Extrahiert einen reichen Satz von Datenpunkten, einschließlich Titel, Text, HTML, Kommentare, Datum, Autor, Autor-URL, Bilder, Videos, Herausgeberinformationen (Land, Name) und Sprache.
  • Entitätserkennung: Identifiziert und markiert automatisch Entitäten im Text, wie Personen, Organisationen und Orte, und fügt eine weitere Ebene wertvoller Metadaten hinzu.
  • Vollständiges Website-Crawling: Im Gegensatz zu Einzelseiten-Scrapern navigiert Crawly durch eine gesamte Website, um Daten umfassend zu sammeln.
  • Strukturierte Datenausgabe: Liefert saubere, gut strukturierte Daten in den Formaten JSON oder CSV, wodurch die Notwendigkeit der Nachbearbeitung und Datenbereinigung entfällt.
  • No-Code-Lösung: Erfordert keine Programmierkenntnisse oder Wissen über Web-Scraping-Technologien, was es für Vermarkter, Forscher und Geschäftsanalysten zugänglich macht.
  • Robust und widerstandsfähig: Da es die semantische Struktur des Inhalts versteht, wird es nicht leicht durch Änderungen am Website-Layout beeinträchtigt, ein häufiges Problem bei herkömmlichen Scrapern.

Anwendungsfälle für Crawly

Crawly ist ein vielseitiges Werkzeug, das für eine breite Palette von Anwendungen geeignet ist:

  • Marktforschung: Sammeln Sie automatisch Produktinformationen, Preise, Kundenbewertungen und Erwähnungen in den Nachrichten von Wettbewerbern, um einen Wettbewerbsvorteil zu erzielen.
  • Lead-Generierung: Extrahieren Sie Kontaktdaten, Unternehmensinformationen und Schlüsselpersonal von Unternehmenswebsites und Online-Verzeichnissen.
  • Content-Aggregation: Erstellen Sie einen benutzerdefinierten Newsfeed oder eine Content-Plattform, indem Sie Artikel, Blog-Posts und Videos aus mehreren Quellen aggregieren.
  • Daten für maschinelles Lernen: Erstellen Sie große, hochwertige Datensätze für das Training von maschinellen Lernmodellen, wie z. B. Sentiment-Analysen von Produktbewertungen oder Trendanalysen aus Nachrichtenartikeln.
  • Markenüberwachung: Verfolgen Sie in Echtzeit, wie Ihre Marke, Produkte oder Führungskräfte im Web erwähnt werden.

Vorteile von Crawly

Der Hauptvorteil von Crawly liegt in seiner Einfachheit und Leistungsfähigkeit. Es demokratisiert die Webdatenextraktion und ermöglicht es Nicht-Entwicklern, Aufgaben auszuführen, die normalerweise ein Team von Ingenieuren erfordern würden. Es spart immense Mengen an Zeit und Ressourcen, indem es den gesamten Scraping-Prozess automatisiert. Darüber hinaus gewährleistet sein KI-gesteuerter Ansatz eine höhere Genauigkeit und größere Widerstandsfähigkeit als herkömmliche Methoden und liefert einen zuverlässigen Strom hochwertiger Daten. Als Produkt von Diffbot wird es von unternehmenstauglicher Technologie unterstützt, der große Konzerne weltweit vertrauen.

Preise und Pläne

Crawly bietet einen kostenlosen Test-Crawl direkt von seiner Homepage an, der es den Benutzern ermöglicht, seine Fähigkeiten durch Eingabe einer URL und einer E-Mail-Adresse zu testen. Dies soll eine Probe der strukturierten Daten liefern, die das Tool produzieren kann. Für umfangreichere Anforderungen, wie z. B. groß angelegtes Crawling, häufige Datenextraktion oder API-Zugriff für die programmatische Nutzung, würden Benutzer normalerweise die gesamte Suite von Tools abonnieren, die von seiner Muttergesellschaft Diffbot angeboten wird. Die Preisgestaltung von Diffbot ist gestaffelt, mit Plänen für Startups, Unternehmen und große Konzerne, die unterschiedliche Stufen von API-Aufrufen und Funktionen bieten.

MrScraper

MrScraper positioniert sich als „ChatGPT für Scraping“, eine fortschrittliche, KI-gesteuerte Web-Scraping-Plattform, die die Datenextraktion für jedermann zugänglich machen soll, unabhängig von technischem Fachwissen. Es ermöglicht Unternehmen, Forschern, Entwicklern und Vermarktern, wertvolle Informationen aus dem Web zu sammeln, ohne eine einzige Zeile Code zu schreiben. Das Tool ist darauf ausgelegt, die Komplexität moderner Websites zu bewältigen, einschließlich dynamischer JavaScript-Inhalte, CAPTCHAs und ausgeklügelter Anti-Bot-Systeme, um eine hohe Erfolgsquote bei der Datenerfassung zu gewährleisten.

Mit einer Nutzerbasis von über 8.000 hat MrScraper seine Leistungsfähigkeit durch die Extraktion von Milliarden von Datenzeilen unter Beweis gestellt. Seine Kernphilosophie ist es, den gesamten Scraping-Workflow von der Ersteinrichtung bis zur Datenlieferung zu vereinfachen. Die No-Code-Oberfläche der Plattform ermöglicht es den Benutzern, einfach auf die Datenfelder zu zeigen und zu klicken, die sie extrahieren möchten, während die KI-Engine, ScrapeGPT, die zugrunde liegende Scraping-Logik intelligent handhabt. Dies macht es zu einem unglaublich effizienten Werkzeug für jeden, der Webdaten für strategische Entscheidungen nutzen möchte.

Wie man MrScraper verwendet

Die Verwendung von MrScraper ist als intuitiver, dreistufiger Prozess konzipiert, der die technischen Hürden beseitigt, die typischerweise mit Web-Scraping verbunden sind:

  1. URL eingeben und Daten auswählen: Beginnen Sie, indem Sie die URL der Website einfügen, die Sie scrapen möchten. Die benutzerfreundliche Oberfläche von MrScraper lädt die Seite, sodass Sie einfach auf die benötigten Datenfelder wie Produktnamen, Preise, Beschreibungen oder Benutzerbewertungen klicken können. Die KI hilft dabei, Muster für die Extraktion von Listen oder Tabellen zu erkennen.
  2. Den Scraper ausführen: Sobald Sie Ihre gewünschten Daten ausgewählt haben, können Sie den Scraping-Job konfigurieren. Dies kann die Einrichtung von Zeitplänen für wiederkehrende Extraktionen umfassen. Klicken Sie auf „Ausführen“, und das leistungsstarke Backend von MrScraper übernimmt die Arbeit, indem es Headless-Browser, intelligente rotierende Residential-Proxys und CAPTCHA-Löser einsetzt, um die Website zu navigieren und die Daten zu sammeln, ohne blockiert zu werden.
  3. Auf Ihre Daten zugreifen: Nach Abschluss des Scraping-Prozesses werden die Daten sauber in einem strukturierten Format (wie CSV oder JSON) organisiert. Sie können die Daten direkt herunterladen, im Dashboard anzeigen oder ihre Lieferung an andere Anwendungen über die integrierte API oder die Zapier-Integration automatisieren.

Kernfunktionen von MrScraper

  • KI-gestütztes Scraping (ScrapeGPT): Nutzt KI, um Website-Strukturen zu verstehen und Daten mit minimalem Benutzereingriff zu extrahieren.
  • No-Code-Oberfläche: Ein intuitives Point-and-Click-System, das keine Programmierkenntnisse erfordert.
  • Fortschrittliche Anti-Bot-Umgehung: Behandelt automatisch CAPTCHAs, WAF (Web Application Firewall), Fingerprinting und andere Bot-Erkennungsmechanismen.
  • Intelligente rotierende Residential-Proxys: Verwendet einen riesigen Pool von privaten IP-Adressen, um IP-Sperren zu vermeiden und auf geografisch eingeschränkte Inhalte zuzugreifen.
  • JavaScript-Rendering: Kann Daten aus dynamischen Single-Page-Anwendungen (SPAs) scrapen, die mit Frameworks wie React, Angular oder Vue.js erstellt wurden.
  • Strukturierte Datenextraktion: Extrahiert Daten und liefert sie in sauberen, strukturierten Formaten wie JSON und CSV.
  • API- und Zapier-Integration: Verbinden und senden Sie gescrapte Daten nahtlos an über 5.000 andere Anwendungen für automatisierte Arbeitsabläufe.
  • Skalierbarkeit: Gebaut, um große Datenextraktionsprojekte zu bewältigen, von wenigen Seiten bis zu Millionen.
  • Dedizierter Support: Bietet umfassenden Kundensupport, einschließlich Live-Chat und einer Community auf Slack.

Anwendungsfälle für MrScraper

MrScraper ist ein vielseitiges Werkzeug, das in verschiedenen Branchen und Funktionen anwendbar ist:

  • E-Commerce & Preisintelligenz: Scrapen Sie Produktdetails, Preise, Lagerbestände und Kundenbewertungen von Wettbewerber-Websites oder Marktplätzen wie Amazon und AppSumo, um Preisstrategien zu informieren.
  • Marktforschung: Aggregieren Sie Daten von Bewertungsseiten wie G2, Capterra oder Product Hunt, um Markttrends, Wettbewerbsmerkmale und Kundenstimmung zu analysieren.
  • Lead-Generierung: Extrahieren Sie Kontaktinformationen und Firmendetails aus Branchenverzeichnissen, beruflichen Netzwerken oder Plattformen wie Pipedrive.
  • Content-Aggregation: Sammeln Sie Artikel, Nachrichten oder Einträge aus verschiedenen Quellen. Zum Beispiel das Scrapen von Filmdaten von TMDB und Rotten Tomatoes oder Stellenangeboten von Recruiting-Websites.
  • Finanzdatenanalyse: Scrapen Sie Echtzeit-Börsendaten, Rohstoffpreise und Finanznachrichten von Plattformen wie Investing.com.
  • Immobilien: Sammeln Sie Immobilienangebote, Preise und Maklerdetails von Immobilien-Websites zur Marktanalyse.

Vorteile von MrScraper

Der Hauptvorteil von MrScraper ist seine Fähigkeit, den Datenzugriff zu demokratisieren. Es verwandelt eine technisch anspruchsvolle Aufgabe in einen einfachen, automatisierten Prozess. Benutzer sparen erhebliche Zeit und Ressourcen, die sonst für die Entwicklung und Wartung benutzerdefinierter Scraping-Skripte aufgewendet würden. Seine robuste Infrastruktur zur Umgehung von Anti-Scraping-Technologien gewährleistet eine zuverlässige und konsistente Datenlieferung. Die Kombination aus einer benutzerfreundlichen Front-End und einem leistungsstarken, KI-gesteuerten Back-End macht es zu einem Game-Changer für datengesteuerte Entscheidungen.

Preise und Pläne

MrScraper arbeitet nach einem kostenpflichtigen Modell, wobei die Preispläne wahrscheinlich auf der Nutzung basieren, wie z. B. der Anzahl der gescrapten Seiten, dem Datenvolumen oder den Parallelitätsanforderungen. Die Website betont, dass alle wichtigen Funktionen, einschließlich Anti-Bot-Umgehung, rotierende Proxys und CAPTCHA-Lösung, im Preis inbegriffen sind, um versteckte Kosten zu vermeiden. Obwohl spezifische Preisstufen im bereitgestellten Inhalt nicht detailliert sind, werden potenzielle Benutzer ermutigt, die offizielle Website zu besuchen oder einen Anruf mit ihrem Team zu buchen, um ein individuelles Angebot zu erhalten, das ihren spezifischen Datenextraktionsanforderungen entspricht.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
Web ScrapingMarktforschungAutomatisierung
Nur Crawly
API
Nur MrScraper
Ohne Code

Tags

Gemeinsam
AutomatisierungDatenextraktionLead-GenerierungMarktforschungNo-CodeWeb Scraping
Nur Crawly
APIDiffbotJSONstrukturierte DatenWeb-Crawler
Nur MrScraper
KI-ScraperCAPTCHA-UmgehungData MiningPreisintelligenz

Zielgruppen und Rollen

Gemeinsam
Keine verifizierten Daten
Nur Crawly
Keine verifizierten Daten
Nur MrScraper
Keine verifizierten Daten

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Crawly monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
1.8K
Ø Besuchsdauer
0:31
Seiten pro Besuch
1.15
Absprungrate
93.85%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 2.6K
  • 2026-01: 784
  • 2026-02: 640
  • 2026-03: 1K
  • 2026-04: 475
  • 2026-05: 1.8K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇳🇬Nigeria82.43%1.5K
🇩🇪Germany9.9%177
🇨🇦Canada7.67%137

Suchbegriffe

crawl urlcrawlyonline web crawlerwebsite crawlerwebsite crawler online

MrScraper monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
33.7K
Ø Besuchsdauer
0:47
Seiten pro Besuch
2.63
Absprungrate
40.82%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 48.6K
  • 2026-01: 40.7K
  • 2026-02: 26.5K
  • 2026-03: 23.6K
  • 2026-04: 23.8K
  • 2026-05: 33.7K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇮🇩Indonesia44.46%15K
🇺🇸United States25.6%8.6K
🇳🇬Nigeria13.84%4.7K
🇮🇳India9.27%3.1K
🇻🇳Vietnam6.83%2.3K

Traffic-Quellen

Source typePercentageEstimated visits
Direkt76.79%25.9K
Verweis23.21%7.8K

Suchbegriffe

mr scrapermrscrapermrscraper careerproxyiumtmdb movie scraper

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

Crawly

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
162
Likes
160

MrScraper

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
207
Likes
198

Crawly vs MrScraper · Vergleichs-FAQ

What do Crawly and MrScraper have in common?
Both tools are listed under Web Scraping、Marktforschung、Automatisierung. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Crawly and MrScraper free?
Listed pricing models: Crawly — Freemium; MrScraper — Paid. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Crawly and MrScraper?
The primary listed category is Web Scraping for Crawly, and Web Scraping for MrScraper. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche