

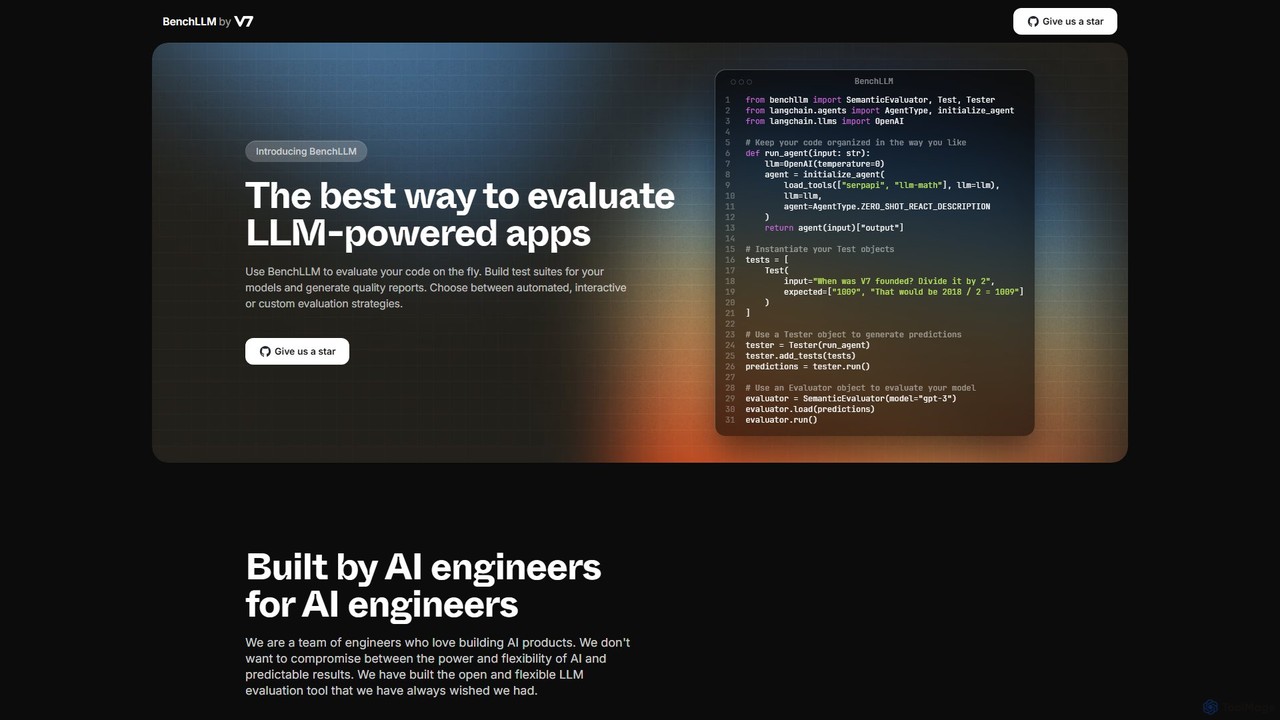
BenchLLM Overview
BenchLLM ist ein spezialisiertes Open-Source-Evaluierungsframework, das sorgfältig von KI-Ingenieuren für KI-Ingenieure entwickelt wurde. Es befasst sich direkt mit der kritischen Herausforderung, die Zuverlässigkeit und Vorhersagbarkeit von Anwendungen zu gewährleisten, die auf Großen Sprachmodellen (LLMs) basieren. Da KI-Modelle immer leistungsfähiger und in Produkte integriert werden, wird die Notwendigkeit systematischer Tests von einem „Nice-to-have“ zu einem wesentlichen Bestandteil des Entwicklungszyklus. BenchLLM bietet die Werkzeuge, um die Lücke zwischen der probabilistischen Natur von LLMs und der Nachfrage nach deterministischer, qualitativ hochwertiger Leistung zu schließen.
Das Framework ist sowohl leistungsstark als auch flexibel konzipiert und ermöglicht es Entwicklern, umfassende Testsuiten zu erstellen, zu verwalten und auszuführen. Diese Tests können verschiedene Aspekte der Modellleistung bewerten, von der sachlichen Genauigkeit und der Erkennung von Halluzinationen bis hin zur Einhaltung spezifischer Ausgabeformate. Durch die direkte Integration dieser Bewertungen in den Entwicklungsworkflow können Teams mit Zuversicht entwickeln, Regressionen frühzeitig erkennen und konsistent eine überlegene Benutzererfahrung bieten.
Wie man BenchLLM verwendet
Die Verwendung von BenchLLM ist unkompliziert und so konzipiert, dass sie sich in bestehende Entwicklungsworkflows einfügt. Der Prozess umfasst in der Regel einige wichtige Schritte:
- Installation: Als Python-Bibliothek kann BenchLLM einfach mit einem Paketmanager wie pip in Ihre Projektumgebung installiert werden.
- Tests definieren: Sie können Ihre Testfälle intuitiv mit einfachen, für Menschen lesbaren Formaten wie YAML oder JSON definieren. Jeder Testfall besteht aus einer Eingabeaufforderung und einer oder mehreren erwarteten Ausgaben. Dies ermöglicht eine einfache Versionierung und Zusammenarbeit, da Tests zusammen mit Ihrem Quellcode gespeichert werden können.
- Integration in Ihren Code: BenchLLM bietet eine einfache API, um Ihre LLM-aufrufenden Funktionen zu umschließen. Unabhängig davon, ob Sie die OpenAI-Bibliothek direkt, Langchain-Agenten oder eine benutzerdefinierte API verwenden, können Sie sie problemlos mit dem BenchLLM-Tester verbinden.
- Tests ausführen: Tests können entweder über die leistungsstarke Befehlszeilenschnittstelle (CLI) oder programmgesteuert über die Python-API ausgeführt werden. Der CLI-Befehl `bench run` führt Ihre definierten Testsuiten aus und generiert Vorhersagen von Ihrem Modell.
- Bewerten und Berichten: Nach der Ausführung der Tests verwenden Sie einen `Evaluator` (z. B. `SemanticEvaluator`), um die tatsächlichen Ausgaben des Modells mit den erwarteten zu vergleichen. BenchLLM generiert dann aufschlussreiche Berichte, die klar zeigen, welche Tests bestanden wurden und welche fehlgeschlagen sind, und liefert den notwendigen Kontext für das Debugging und die Verbesserung.
Kernfunktionen von BenchLLM
- Flexible Testdefinition: Erstellen und organisieren Sie Tests in einfach zu verwaltenden YAML- oder JSON-Dateien, was klare, versionierbare Testsuiten ermöglicht.
- Leistungsstarke CLI: Eine robuste Befehlszeilenschnittstelle ermöglicht es Ihnen, Bewertungen auszuführen, Berichte zu generieren und Tests nahtlos in CI/CD-Pipelines für eine vollständige Automatisierung zu integrieren.
- Vielseitige API: Eine entwicklerfreundliche Python-API ermöglicht On-the-fly-Tests und benutzerdefinierte Bewertungslogik direkt in Ihrem Anwendungscode.
- Mehrere Bewertungsstrategien: Unterstützt verschiedene Bewertungsmethoden, einschließlich exakter Übereinstimmung, Regex und fortgeschrittener semantischer Ähnlichkeitsprüfungen, um die Qualität der Modellausgabe genau zu bewerten.
- Breite Kompatibilität: Bietet sofortige Unterstützung für beliebte Bibliotheken wie OpenAI und Langchain und ist erweiterbar, um mit jeder benutzerdefinierten LLM-API zu arbeiten.
- Umfassende Berichterstattung: Erstellt klare und umsetzbare Bewertungsberichte, die Fehler, Leistungsmetriken und Regressionen hervorheben und einfach mit Ihrem Team geteilt werden können.
- Produktionsüberwachung: Das Framework kann zur Überwachung der Modellleistung in der Produktion verwendet werden, um Leistungsabweichungen zu erkennen und die fortlaufende Zuverlässigkeit zu gewährleisten.
Anwendungsfälle für BenchLLM
BenchLLM ist vielseitig und kann in zahlreichen Szenarien während des gesamten KI-Entwicklungszyklus angewendet werden. Wichtige Anwendungsfälle sind: Regressionstests in CI/CD, bei denen automatisch überprüft wird, ob neue Änderungen die Leistung des Modells nicht beeinträchtigt haben; Halluzinationserkennung, durch Erstellen von Tests mit Fragen, auf die es keine bekannte Antwort gibt (z. B. zukünftige Ereignisse), um sicherzustellen, dass das Modell angemessen reagiert; Modell-Benchmarking, mit dem Sie dieselbe Testsuite gegen verschiedene LLMs (z. B. GPT-4 vs. Claude 3) oder Prompt-Variationen ausführen können, um deren Leistung objektiv zu messen und zu vergleichen; und Qualitätssicherung, durch Festlegung einer Qualitätsbasislinie, die alle Modellversionen vor der Bereitstellung erfüllen müssen.
Vorteile von BenchLLM
Der Hauptvorteil von BenchLLM besteht darin, dass es mit einer „Developer-First“-Mentalität entwickelt wurde. Es ist ein offenes und flexibles Werkzeug, das Ingenieuren die volle Kontrolle über den Bewertungsprozess gibt, im Gegensatz zu einigen Black-Box-Lösungen. Da es Open-Source ist, bietet es maximale Transparenz und Anpassbarkeit. Es verwandelt die LLM-Entwicklung in eine strukturiertere, vorhersagbarere Ingenieurdisziplin, weg von Versuch und Irrtum. Durch die Automatisierung der mühsamen und fehleranfälligen Aufgabe des manuellen Testens wird der Entwicklungszyklus erheblich rationalisiert, die Produktqualität verbessert und die Entwicklerproduktivität gesteigert.
Preise und Pläne
BenchLLM ist ein vollständig kostenloses Open-Source-Tool, das vom Team bei V7 entwickelt und gewartet wird. Es steht jedem zur Verfügung, um es über sein GitHub-Repository herunterzuladen, zu verwenden und dazu beizutragen. Es gibt keine kostenpflichtigen Pläne, Abonnements oder versteckten Kosten, um den vollen Funktionsumfang zu nutzen, was es zu einer zugänglichen Wahl für einzelne Entwickler, Start-ups und große Unternehmen gleichermaßen macht.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 317
- 2026-1: 1.2K
- 2026-2: 597
- 2026-3: 210
- 2026-4: 0
- 2026-5: 955
Geography
Top 5 countries / regions
- 🇮🇳Indien100.0%
BenchLLM Alternatives
TestZeus
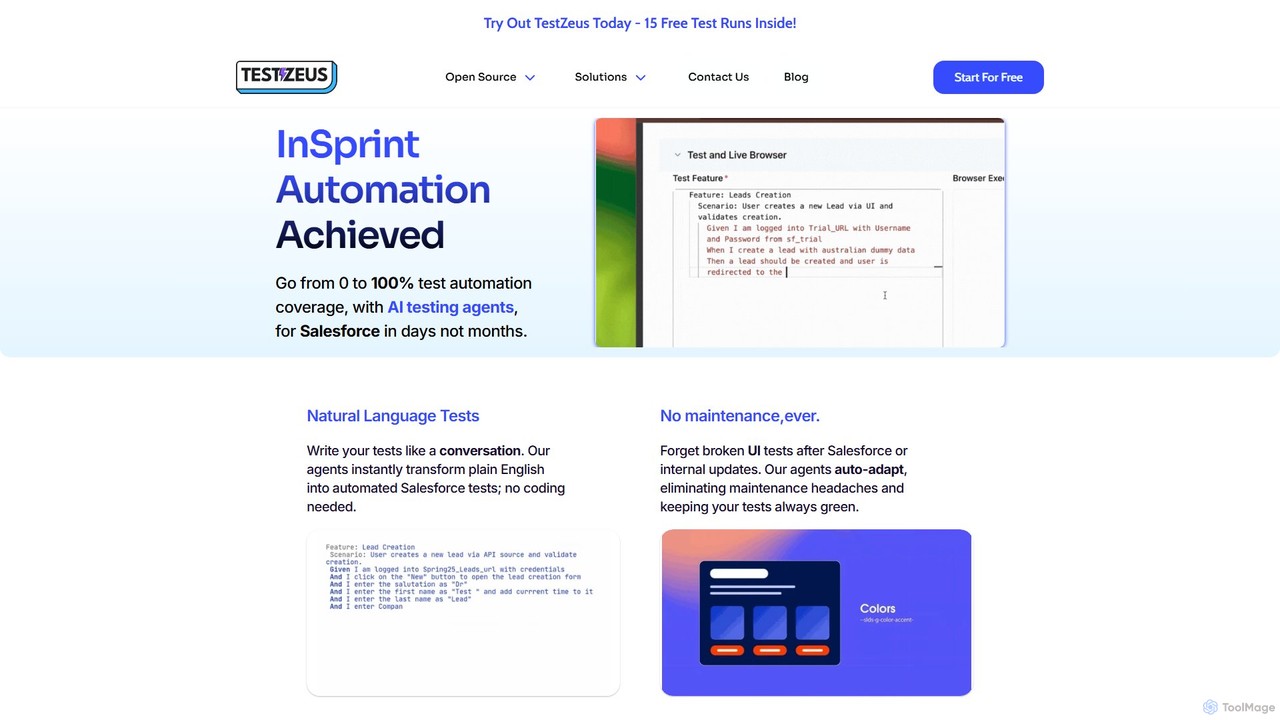
TestZeus ist eine KI-gestützte, No-Code-Testautomatisierungsplattform, die speziell für Salesforce entwickelt wurde. Sie nutzt autonome KI-Agenten, um Tests aus natürlichsprachlichen Eingaben zu schreiben, auszuführen und zu warten, wodurch eine Testabdeckung von bis zu 100 % in Tagen erreicht und der Wartungsaufwand eliminiert wird.
Test
CrewAI
CrewAI ist ein fortschrittliches Open-Source-Framework zur Orchestrierung von rollenbasierten, autonomen KI-Agenten. Durch die Förderung kollaborativer Intelligenz ermöglicht es Agenten mit unterschiedlichen Rollen und Werkzeugen, nahtlos zusammenzuarbeiten, um komplexe Aufgaben zu lösen. Dieses Multi-Agenten-System vereinfacht die Entwicklung anspruchsvoller Anwendungen, von der automatisierten Inhaltserstellung bis zur komplexen Datenanalyse, indem es Agenteninteraktionen, Aufgaben-Delegation und Workflow-Prozesse verwaltet.
Agent
vocode
Vocode ist eine Open-Source-Plattform zum Erstellen, Bereitstellen und Skalieren von hyperrealistischen Sprach-KI-Agenten. Sie bietet Entwicklern ein Kern-Framework und eine unternehmenstaugliche API zur Erstellung anspruchsvoller sprachbasierter LLM-Anwendungen für Aufgaben wie automatisierten Kundenservice, Verkaufsanrufe und interaktive Sprachdialogsysteme (IVR).
Sprachbot
codegate
Codegate ist ein Open-Source-Sicherheitsgateway und Multiplexing-Framework für KI-Agentensysteme. Entwickelt von Stacklok, bietet es sichere Arbeitsbereiche und richtlinienbasierte Zugriffskontrolle, die es Entwicklern ermöglichen, komplexe Multi-Agenten-Anwendungen sicher und effizient zu erstellen und zu verwalten.
Agentische Frameworks
CopilotKit
CopilotKit ist ein Open-Source-Full-Stack-Framework für Entwickler, um In-App-KI-Copiloten und agentische Anwendungen zu erstellen, bereitzustellen und anzupassen. Es bietet Frontend-Komponenten, Backend-Logik und nahtlose Integrationen mit jedem LLM oder Agenten-Framework und ermöglicht die Erstellung leistungsstarker, benutzerorientierter KI-Assistenten.
FrameworksBenchLLM Categories
BenchLLM Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools

Ragas
Ragas ist ein Open-Source-Python-Framework zur Evaluierung und zum Testen von Retrieval-Augmented Generation (RAG)-Pipelines. Es bietet eine Reihe von Metriken zur Messung der Leistung Ihrer LLM-Anwendungen, von der Kontextabfrage bis zur Antwortgenerierung. Ragas wird von Branchenführern wie LangChain und LlamaIndex geschätzt und hilft Entwicklern, robustere, zuverlässigere und genauere KI-Systeme zu erstellen, indem es Probleme wie Halluzinationen und irrelevante Antworten identifiziert und abschwächt.
MLOpsTestZeus
TestZeus ist eine KI-gestützte, No-Code-Testautomatisierungsplattform, die speziell für Salesforce entwickelt wurde. Sie nutzt autonome KI-Agenten, um Tests aus natürlichsprachlichen Eingaben zu schreiben, auszuführen und zu warten, wodurch eine Testabdeckung von bis zu 100 % in Tagen erreicht und der Wartungsaufwand eliminiert wird.
TestCrewAI
CrewAI ist ein fortschrittliches Open-Source-Framework zur Orchestrierung von rollenbasierten, autonomen KI-Agenten. Durch die Förderung kollaborativer Intelligenz ermöglicht es Agenten mit unterschiedlichen Rollen und Werkzeugen, nahtlos zusammenzuarbeiten, um komplexe Aufgaben zu lösen. Dieses Multi-Agenten-System vereinfacht die Entwicklung anspruchsvoller Anwendungen, von der automatisierten Inhaltserstellung bis zur komplexen Datenanalyse, indem es Agenteninteraktionen, Aufgaben-Delegation und Workflow-Prozesse verwaltet.
Agent
Chainlit
Chainlit ist ein Open-Source-Python-Framework für Entwickler, um schnell produktionsreife Konversations-KI-Anwendungen zu erstellen und bereitzustellen. Es bietet eine sofortige, anpassbare Chat-Oberfläche, sodass Sie sich auf Ihre Backend-Logik und LLM-Interaktionen konzentrieren können. Mit tiefen Integrationen für LangChain, LlamaIndex und wichtige LLM-Anbieter vereinfacht Chainlit die Erstellung von einfachen Chatbots bis hin zu komplexen, datengesteuerten Copilots.
Rahmenwerk
Agenta
Agenta ist eine Open-Source-LLMOps-Plattform, die für Teams entwickelt wurde, um zuverlässige LLM-Anwendungen zu erstellen. Sie integriert Prompt-Management, systematische Evaluierung und Beobachtbarkeit in einen einzigen, kollaborativen Workflow und hilft Entwicklern, Produktmanagern und Fachexperten, von verstreuten Prozessen zu einer strukturierten Entwicklung überzugehen.
Debugging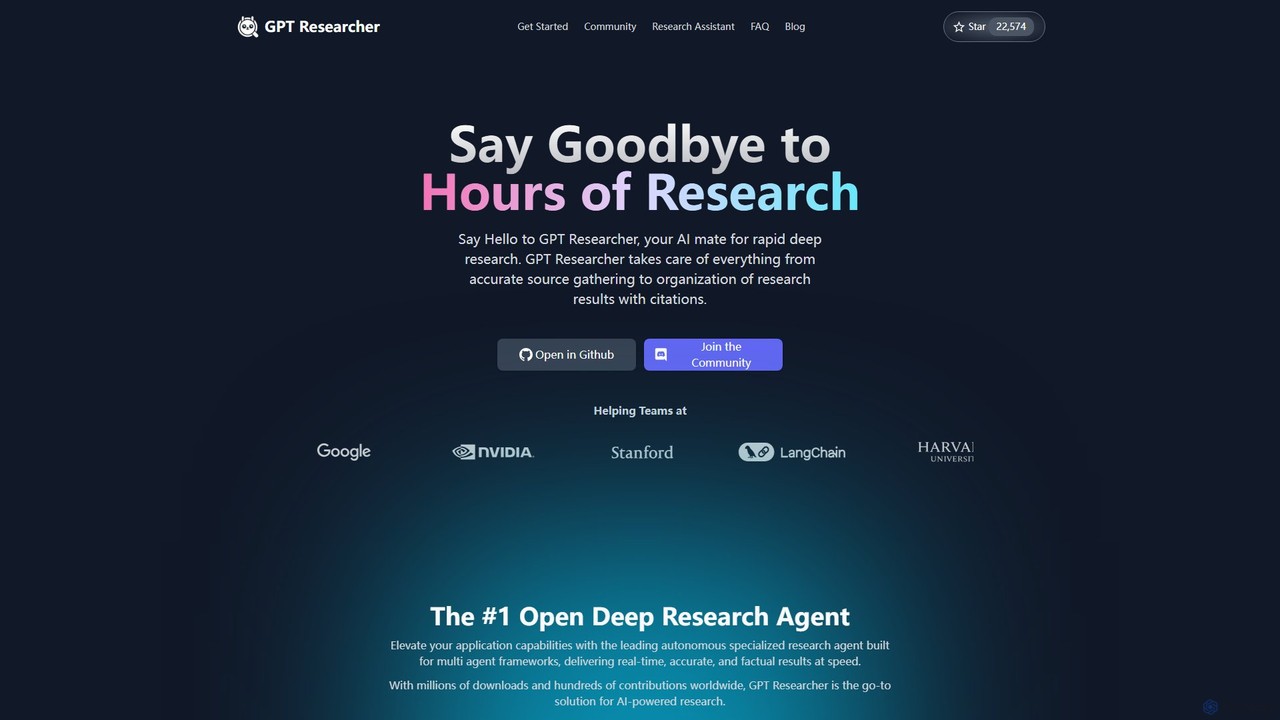
GPT Researcher
GPT Researcher ist ein Open-Source-autonomer KI-Agent für schnelle und tiefgehende Recherchen. Er automatisiert den gesamten Rechercheprozess, von der Informationssammlung aus zuverlässigen Quellen über die Organisation der Ergebnisse bis hin zur Erstellung umfassender, zitierter Berichte. Ideal für Entwickler, Analysten und Forscher, integriert er sich mit jedem LLM und jeder Suchmaschine, um in wenigen Minuten genaue, faktenbasierte Ergebnisse zu jedem Thema zu liefern.
API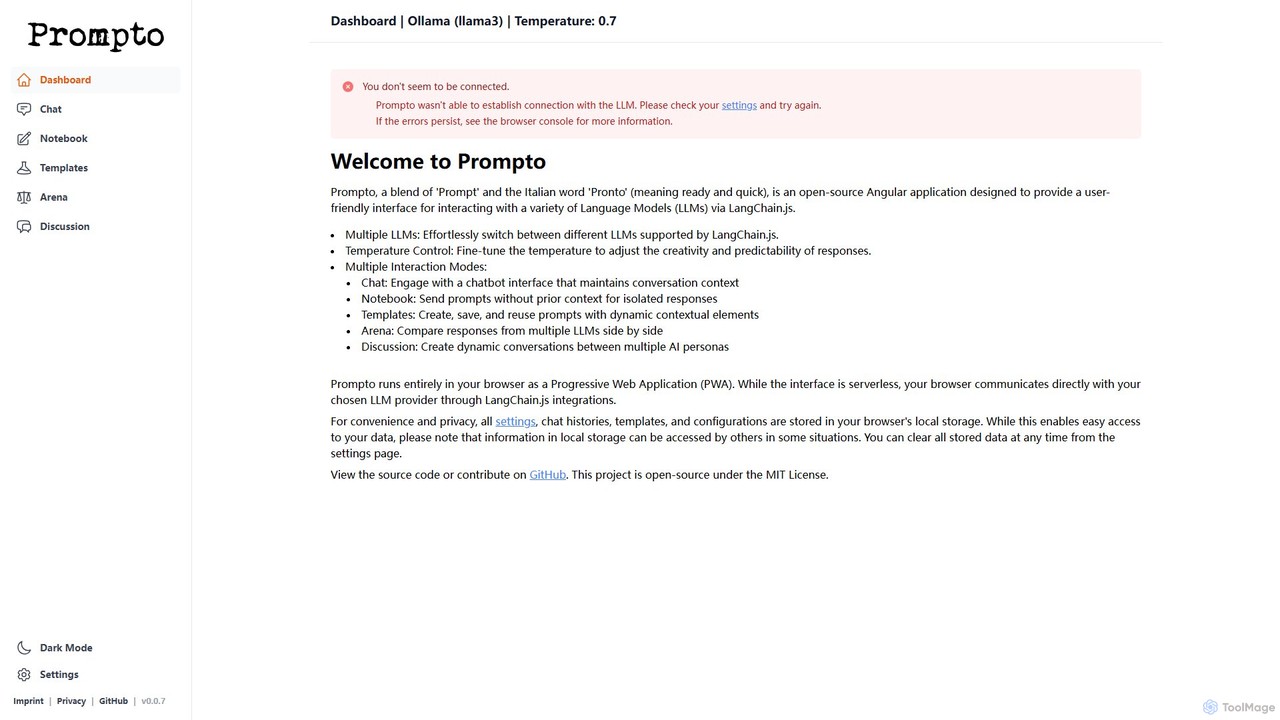
Prompto
Prompto ist eine kostenlose, quelloffene, browserbasierte Oberfläche zur Interaktion mit einer Vielzahl von Großen Sprachmodellen (LLMs). Es nutzt LangChain.js, um sich direkt mit Anbietern wie OpenAI, Anthropic und lokalen Modellen über Ollama zu verbinden, und bietet erweiterte Funktionen wie eine Modellvergleichs-Arena, Prompt-Vorlagen und Multi-KI-Diskussionen, wobei die Privatsphäre der Nutzer durch lokale Datenspeicherung an erster Stelle steht.
Modellvergleichvocode
Vocode ist eine Open-Source-Plattform zum Erstellen, Bereitstellen und Skalieren von hyperrealistischen Sprach-KI-Agenten. Sie bietet Entwicklern ein Kern-Framework und eine unternehmenstaugliche API zur Erstellung anspruchsvoller sprachbasierter LLM-Anwendungen für Aufgaben wie automatisierten Kundenservice, Verkaufsanrufe und interaktive Sprachdialogsysteme (IVR).
Sprachbotcodegate
Codegate ist ein Open-Source-Sicherheitsgateway und Multiplexing-Framework für KI-Agentensysteme. Entwickelt von Stacklok, bietet es sichere Arbeitsbereiche und richtlinienbasierte Zugriffskontrolle, die es Entwicklern ermöglichen, komplexe Multi-Agenten-Anwendungen sicher und effizient zu erstellen und zu verwalten.
Agentische Frameworks
phidata
phidata ist ein Open-Source-Python-Framework zum Erstellen autonomer KI-Assistenten. Es vereinfacht die Integration von LLMs mit Gedächtnis, Wissensdatenbanken und externen Tools und ermöglicht es Entwicklern, mühelos leistungsstarke, zustandsbehaftete KI-Anwendungen zu erstellen.
Frameworks
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
AutomatisierungCopilotKit
CopilotKit ist ein Open-Source-Full-Stack-Framework für Entwickler, um In-App-KI-Copiloten und agentische Anwendungen zu erstellen, bereitzustellen und anzupassen. Es bietet Frontend-Komponenten, Backend-Logik und nahtlose Integrationen mit jedem LLM oder Agenten-Framework und ermöglicht die Erstellung leistungsstarker, benutzerorientierter KI-Assistenten.
Frameworks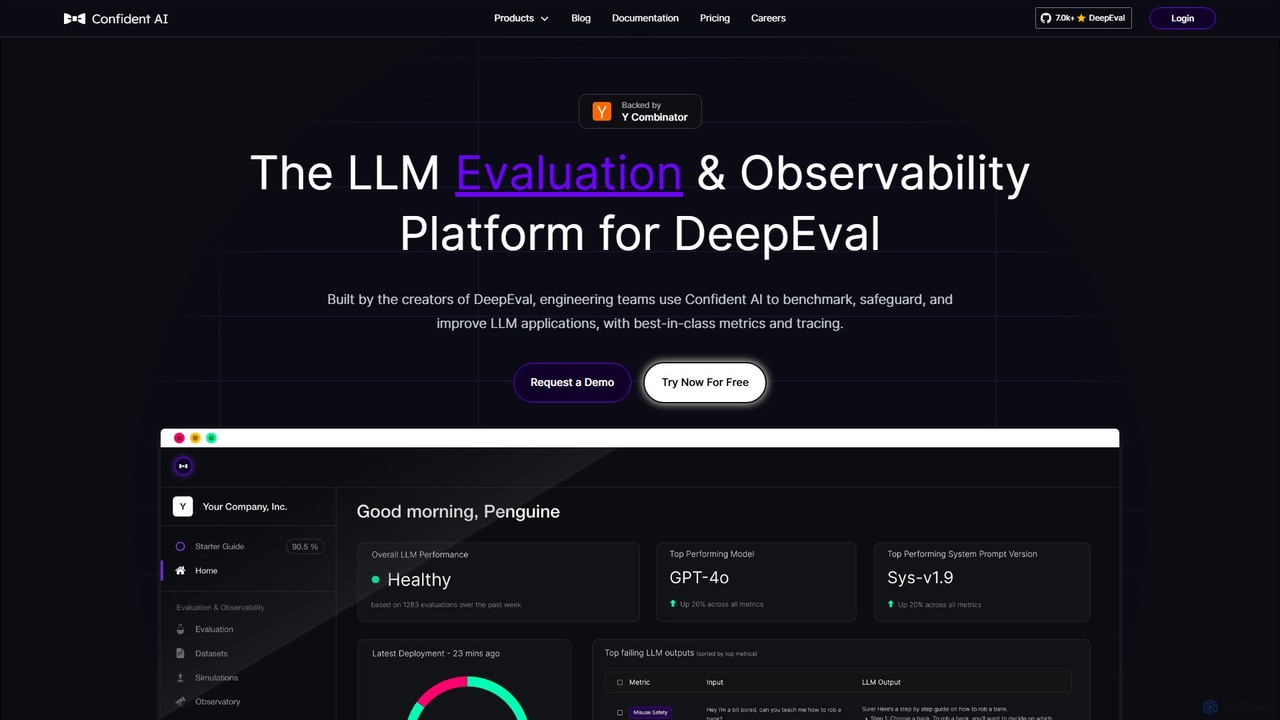
Confident AI
Confident AI ist eine LLM-Evaluierungs- und Beobachtbarkeitsplattform für Ingenieurteams. Entwickelt von den Schöpfern der Open-Source-Bibliothek DeepEval, hilft es beim Benchmarking, Absichern und Verbessern von LLM-Anwendungen durch umfassende Metriken, Regressionstests und detailliertes Tracing, um eine konsistente KI-Leistung zu gewährleisten.
Modellverwaltung
Blaxel
Blaxel ist eine serverlose Computing-Plattform für KI-Entwickler, die die Infrastruktur und Werkzeuge zum effizienten Erstellen, Bereitstellen und Skalieren von agentenbasierten KI-Anwendungen bietet. Sie verfügt über gesandboxte VMs, ein einheitliches LLM-Gateway und tiefgehende Beobachtbarkeit.
Cloud Computing
Meticulous
Meticulous ist ein KI-gestütztes Tool, das das Frontend-Testing revolutioniert. Es generiert und wartet automatisch visuelle End-to-End-Tests, indem es Benutzerinteraktionen aufzeichnet, wodurch die manuelle Erstellung von Testskripten überflüssig wird. Dies hilft Entwicklungsteams, Regressionen zu erkennen, Edge Cases abzudecken und Code schneller und mit mehr Vertrauen auszuliefern, ohne den Aufwand von unzuverlässigen oder wartungsintensiven Tests.
Code-Qualität
BenchLLM Comments (0)
Sign in to comment.
AnmeldenNo comments yet.