
Braintrust Overview
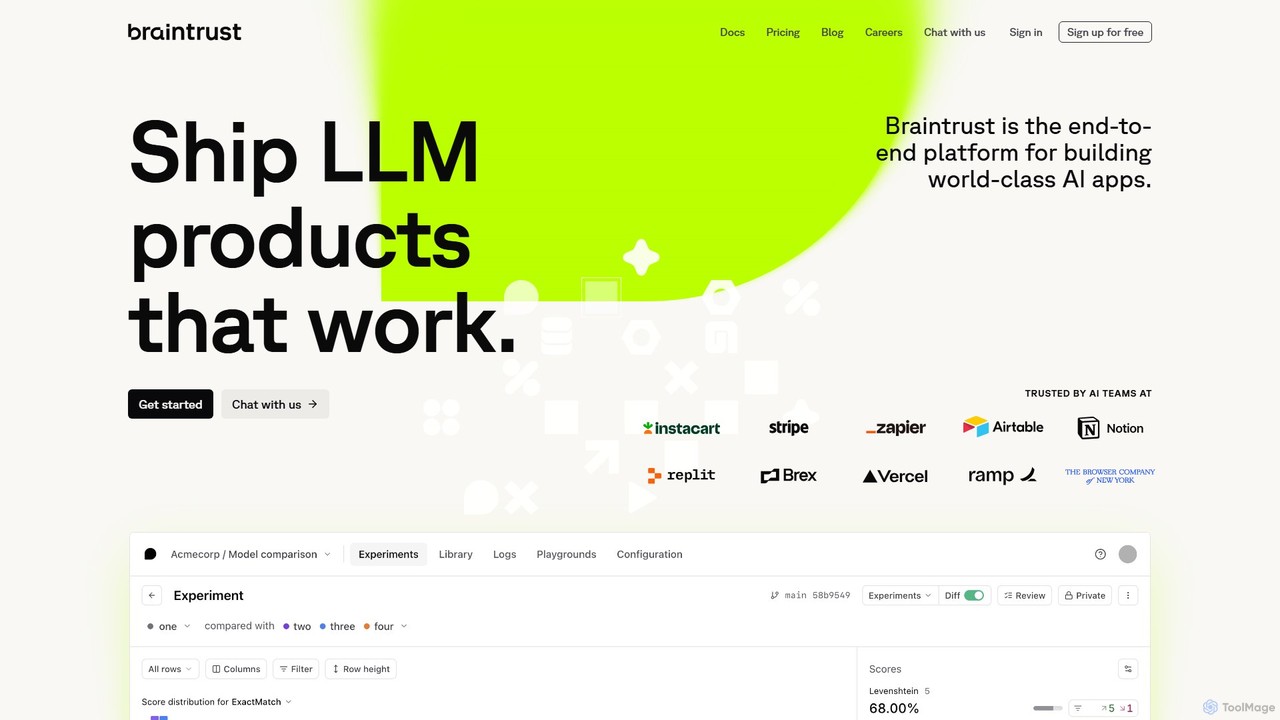
Braintrust ist eine umfassende End-to-End-Plattform, die Teams dabei unterstützt, erstklassige KI- und LLM-gestützte Anwendungen selbstbewusst zu erstellen, zu bewerten und auszuliefern. In einer Ära, in der KI-Modelle nicht-deterministisch und unvorhersehbar sein können, bietet Braintrust die wesentliche Infrastruktur, um rigorose Tests, Überwachung und iterative Verbesserungen in den KI-Entwicklungslebenszyklus einzuführen. Führende KI-Teams vertrauen darauf, die kritische Lücke zwischen Entwicklung und zuverlässiger Produktionsbereitstellung zu schließen und die KI-Entwicklung in eine strukturiertere und vorhersagbarere Ingenieurdisziplin zu verwandeln.
Die Plattform basiert auf dem Kernkonzept der 'Evals' (Evaluationen), das es Teams ermöglicht, Änderungen an Prompts, Modellen oder anderen Teilen ihres KI-Systems systematisch zu testen. Durch die Erstellung von Datensätzen mit Beispielen und die Definition von Scorern können Entwickler objektive Metriken zur Leistung erhalten, Regressionen verhindern und sicherstellen, dass jede Änderung eine Verbesserung darstellt. Dies erleichtert die Beantwortung kritischer Fragen wie „Welche Beispiele haben sich verschlechtert, als wir den Prompt geändert haben?“ oder „Was passiert, wenn ich dieses neue Modell ausprobiere?“.
Wie man Braintrust verwendet
Die Verwendung von Braintrust beinhaltet die Integration in Ihren bestehenden KI-Entwicklungsworkflow. Der Prozess ist so gestaltet, dass er für das gesamte Team intuitiv ist:
- Instrumentieren Sie Ihren Code: Beginnen Sie mit der Integration des Braintrust SDK (verfügbar für Python und TypeScript) in Ihre Anwendung. Dies ermöglicht es Ihnen, alle LLM-Interaktionen, Eingaben und Ausgaben auf der Braintrust-Plattform zu protokollieren.
- Erstellen & Verwalten von Prompts: Verwenden Sie die Braintrust-Benutzeroberfläche oder definieren Sie Prompts direkt in Ihrem Code. Die Plattform bietet ein zentrales, versioniertes Repository für alle Ihre Prompts, die einfach getestet und aktualisiert werden können.
- Erstellen von Testdatensätzen: Erfassen Sie interessante oder problematische Beispiele aus Ihren Produktionsprotokollen, um 'goldene' Datensätze zu erstellen. Diese Datensätze dienen als Ground Truth für die Bewertung zukünftiger Änderungen.
- Definieren und Ausführen von Evaluationen (Evals): Kombinieren Sie Ihre Prompts, Modelle und Datensätze, um eine 'Eval' zu erstellen. Führen Sie Experimente durch, um verschiedene Modellanbieter (wie GPT-4o, Claude 3.5 Sonnet, Llama 3), Prompt-Versionen oder andere Parameter nebeneinander zu vergleichen.
- Debuggen mit Tracing: Wenn sich eine Anwendung fehlerhaft verhält, verwenden Sie die Tracing-Funktion von Braintrust, um den gesamten Ausführungspfad eines LLM-Aufrufs zu visualisieren. Dies hilft, die genaue Ursache von Fehlern oder unerwarteten Ausgaben zu ermitteln.
- Überwachen in der Produktion: Nach der Bereitstellung verwenden Sie die Überwachungs-Dashboards, um die reale Leistung, die Kosten und die Qualität Ihrer KI-Anwendung zu verfolgen. Richten Sie Warnungen für Anomalien oder Leistungsabfälle ein.
- Iterieren und Verbessern: Nutzen Sie Erkenntnisse aus Evaluationen, menschlichen Überprüfungen und der Produktionsüberwachung, um Ihre Prompts und Datensätze kontinuierlich zu verfeinern und so eine leistungsstarke Feedback-Schleife für Verbesserungen zu schaffen.
Kernfunktionen von Braintrust
- LLM-Evaluation (Evals): Systematisches Testen und Vergleichen von Prompts, Modellen und Konfigurationen unter Verwendung einer breiten Palette von vorgefertigten oder benutzerdefinierten Scorern (z. B. Levenshtein-Distanz, Ähnlichkeit, Halluzinationsprüfungen).
- Prompt-Management: Ein zentralisiertes und versioniertes System zum Erstellen, Testen und Bereitstellen von Prompts, die nahtlos zwischen der Benutzeroberfläche und Ihrer Codebasis synchronisiert werden.
- Echtzeit-Tracing & Debugging: Visualisieren Sie den vollständigen End-to-End-Ausführungsfluss Ihrer KI-Anwendungen, um Engpässe, Fehler und Optimierungsmöglichkeiten schnell zu identifizieren.
- Produktionsüberwachung: Gewinnen Sie tiefe Einblicke in die reale Leistung, Kosten, Latenz und Benutzerinteraktionen, um sicherzustellen, dass Ihre Modelle in einer Live-Umgebung optimal funktionieren.
- Kollaborativer Playground: Eine IDE-ähnliche Umgebung, in der technische und nicht-technische Teammitglieder in Echtzeit mit Prompts, Modellen und Daten experimentieren können.
- Goldene Datensätze: Erstellen, verwalten und versionieren Sie kuratierte Datensätze aus realen Daten für robuste Regressionstests und Evaluationen.
- Self-Hosting-Option: Stellen Sie Braintrust in Ihrer eigenen Infrastruktur bereit, um die volle Kontrolle über Ihre Daten zu haben und strenge Sicherheits- und Compliance-Anforderungen zu erfüllen.
- AI-Proxy: Eine einheitliche Schnittstelle zur Interaktion mit verschiedenen LLM-Anbietern, die API-Aufrufe, die Verwaltung von Anmeldeinformationen und den Modellwechsel vereinfacht.
- Workflow für menschliche Überprüfung: Ein integriertes System, das es menschlichen Experten ermöglicht, KI-Ausgaben zu bewerten und wertvolles Feedback zu liefern, das in Ihre Datensätze und Evaluationen integriert werden kann.
Anwendungsfälle für Braintrust
Braintrust ist vielseitig und kann in verschiedenen Szenarien der KI-Entwicklung angewendet werden:
- A/B-Testing von LLM-Prompts: Ein Entwickler kann zwei Versionen eines Prompts erstellen und eine Evaluation auf einem goldenen Datensatz durchführen, um objektiv festzustellen, welche Version bei Metriken wie Genauigkeit, Relevanz oder Ton besser abschneidet.
- Modell-Benchmarking und -Migration: Wenn ein neues Modell wie Claude 3.5 Sonnet veröffentlicht wird, kann ein Team Braintrust verwenden, um dessen Leistung und Kosten im Vergleich zum aktuellen Modell (z. B. GPT-4o) bei wichtigen Geschäftsaufgaben zu bewerten, bevor es eine Migrationsentscheidung trifft.
- Debuggen komplexer KI-Agenten: Bei einem Agenten, der mehrere sequenzielle LLM-Aufrufe tätigt, visualisiert das Tracing von Braintrust die gesamte Gedankenkette, was es einfach macht, zu erkennen, wo die Logik versagt hat oder ein falsches Ergebnis erzeugt wurde.
- Qualitätssicherung für RAG-Systeme: Teams können Datensätze mit Fragen und erwarteten Antworten erstellen, um ihr Retrieval-Augmented Generation (RAG)-System kontinuierlich zu testen und sicherzustellen, dass es nicht an Qualität verliert oder zu halluzinieren beginnt.
- Kosten- und Latenzoptimierung: Ein Produktmanager kann das Überwachungs-Dashboard verwenden, um die Kosten und die Reaktionszeit einer KI-Funktion in der Produktion zu verfolgen und teure Abfragen oder Leistungsengpässe zu identifizieren, die technische Aufmerksamkeit erfordern.
Vorteile von Braintrust
Braintrust bietet einen signifikanten Wettbewerbsvorteil für Teams, die mit KI bauen:
- End-to-End-Lösung: Es deckt einzigartig den gesamten Lebenszyklus von KI-Anwendungen ab, von der ersten Experimentierphase und Evaluation bis zur Produktionsüberwachung und kontinuierlichen Verbesserung.
- Verwaltet die Nicht-Determinismus der KI: Es bringt strukturierte Tests und objektive Metriken in die unvorhersehbare Welt der LLMs und hilft Teams, robuste und zuverlässige Produkte zu bauen.
- Fördert die Teamzusammenarbeit: Die intuitive Benutzeroberfläche ist sowohl für Ingenieure als auch für nicht-technische Stakeholder wie Produktmanager konzipiert, sodass jeder zur Verbesserung des KI-Produkts beitragen kann.
- Synergie von Code & UI: Es synchronisiert Konfigurationen wie Prompts nahtlos zwischen einer benutzerfreundlichen Oberfläche und der Produktionscodebasis und überbrückt so die Lücke zwischen Experiment und Bereitstellung.
- Flexibel und erweiterbar: Mit Unterstützung für benutzerdefinierte Scorer, benutzerdefinierte Funktionen und Self-Hosting kann es an die spezifischen Bedürfnisse und die Infrastruktur jeder Organisation angepasst werden.
Preise und Pläne
Braintrust bietet eine gestaffelte Preisstruktur, die mit Ihren Bedürfnissen wachsen soll:
- Kostenloser Plan: $0/Monat. Dieser Plan ist perfekt für Einzelpersonen und kleine Teams, die anfangen. Er beinhaltet 1 Million Trace Spans, 1 GB verarbeitete Daten, 10.000 Scores, 14 Tage Datenaufbewahrung und unbegrenzte Benutzer.
- Pro-Plan: $249/Monat. Dieser Plan richtet sich an wachsende Teams und Produktionsanwendungen und bietet unbegrenzte Trace Spans, 5 GB verarbeitete Daten (danach $3/GB), 50.000 Scores (danach $1.50/1.000), 1 Monat Datenaufbewahrung und unbegrenzte Benutzer.
- Enterprise-Plan: Individuelle Preise. Dieser Plan ist für große Organisationen oder solche mit hohem Datenvolumen oder datenschutzsensiblen Daten. Er beinhaltet Premium-Support, dedizierte Infrastruktur und die Option für eine On-Premise- oder Private-Cloud-Bereitstellung.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 155.6K
- 2026-1: 187.1K
- 2026-2: 204.2K
- 2026-3: 229.5K
- 2026-4: 231.6K
- 2026-5: 227.8K
Geography
Top 5 countries / regions
- 🇺🇸Vereinigte Staaten76.1%
- 🇮🇳Indien14.9%
- 🇧🇷Brasilien3.1%
- 🇨🇦Kanada3.0%
- 🇬🇧Vereinigtes Königreich2.9%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 84.1% |
Referral | 13.0% |
Email | 3.0% |
Top keywords
| Keyword | Cost per click |
|---|---|
| brain trust | $9.01 |
| braintrust | $3.29 |
| braintrust ai | $18.14 |
| braintrust careers | $2.70 |
| braintrust mcp | $3.30 |
Braintrust Videos on YouTube


Braintrust

Braintrust


Braintrust Alternatives
Langfuse
Langfuse ist eine Open-Source LLM-Engineering-Plattform, die umfassende Werkzeuge zum Debuggen, Evaluieren und Verbessern von LLM-Anwendungen bietet. Sie umfasst Funktionen wie Tracing, Prompt-Management, Evaluierungs-Frameworks und Metriken, um den gesamten Entwicklungszyklus für Teams, die mit großen Sprachmodellen arbeiten, zu optimieren.
Analysen
Parea AI
Parea AI ist eine End-to-End-Plattform für die Entwicklung, das Testen und die Überwachung von LLM-Anwendungen. Sie bietet Werkzeuge für Experiment-Tracking, Beobachtbarkeit, Evaluierung und menschliche Annotation, um Teams dabei zu helfen, KI-Systeme selbstbewusst in die Produktion zu bringen.
Modelltraining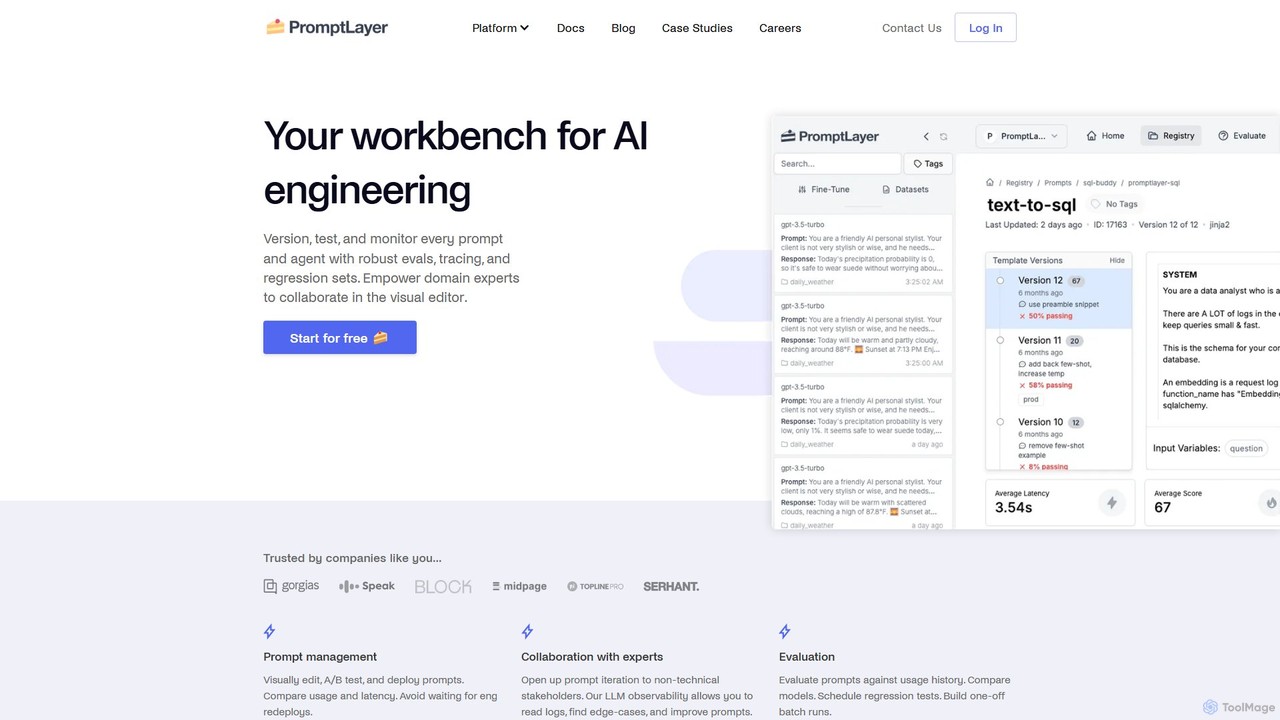
PromptLayer
PromptLayer ist Ihre umfassende Werkbank für KI-Engineering und bietet eine einheitliche Plattform für Prompt-Management, Evaluierung und LLM-Observability. Es ermöglicht Teams, jeden Prompt und Agenten zu versionieren, zu testen und zu überwachen und fördert die Zusammenarbeit zwischen technischen und nicht-technischen Stakeholdern, um produktionsreife KI-Anwendungen effizient zu erstellen und zu skalieren.
Modellverwaltung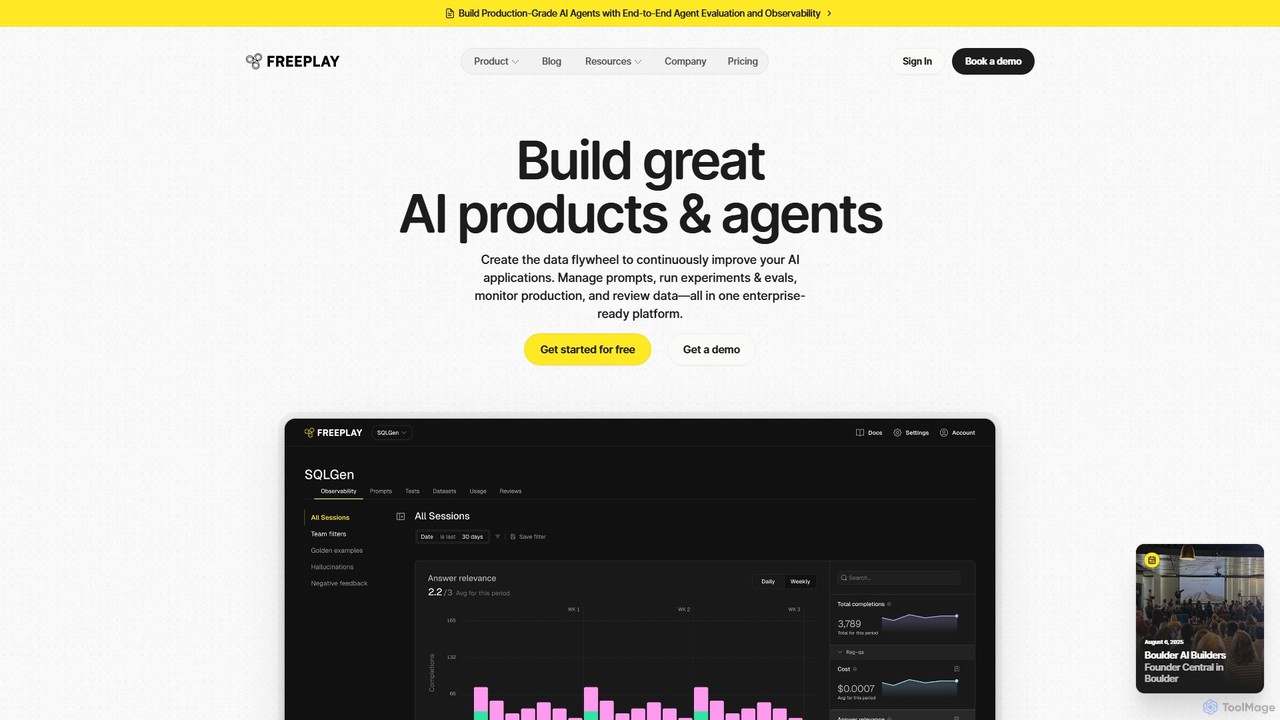
Freeplay
Freeplay ist eine unternehmenstaugliche Plattform, die für KI-Teams entwickelt wurde, um KI-Produkte und -Agenten zu erstellen, zu testen und kontinuierlich zu verbessern. Sie vereint Prompt-Management, Experimente, LLM-Beobachtbarkeit und Datenüberprüfung in einem einzigen Workflow und schafft so ein leistungsstarkes Daten-Schwungrad zur Beschleunigung der Produktqualität und Entwicklungsgeschwindigkeit.
Analysen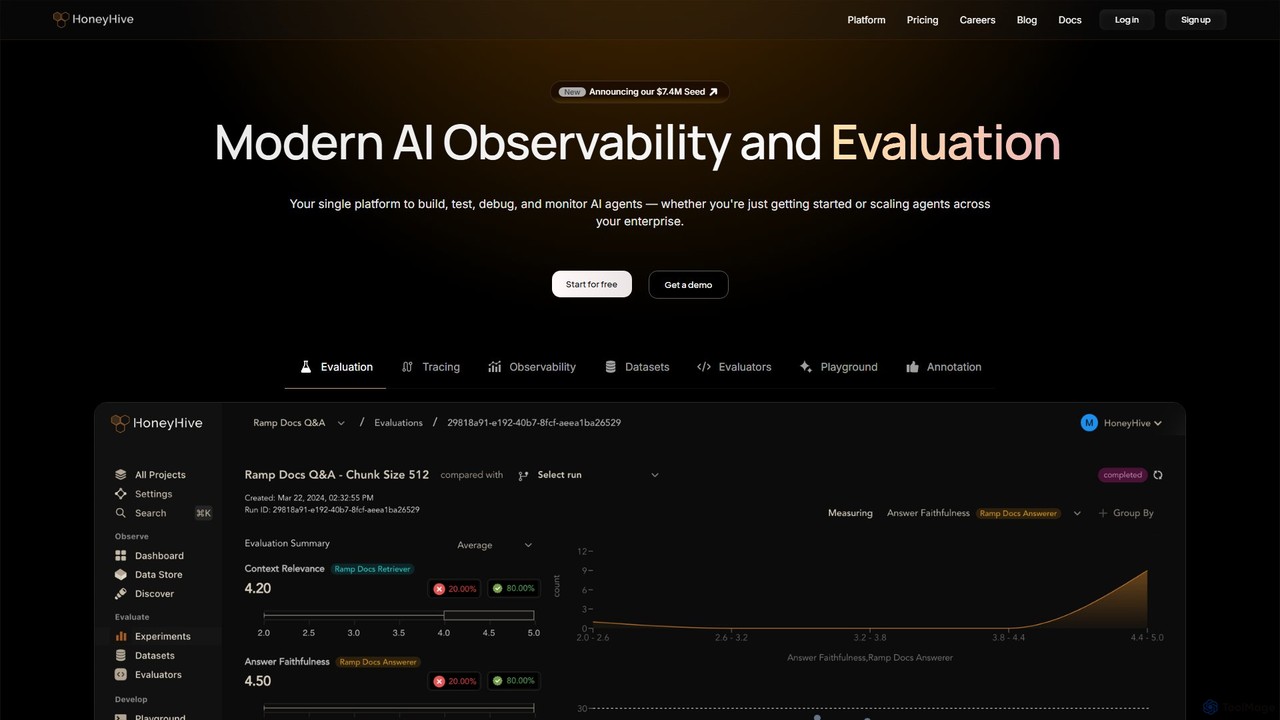
HoneyHive
HoneyHive ist eine All-in-One-Plattform für KI-Beobachtbarkeit und -Evaluierung für Entwickler, die mit LLMs und KI-Agenten arbeiten. Sie bietet eine einheitliche Lösung zum Erstellen, Testen, Debuggen und Überwachen von KI-Anwendungen, von ersten Experimenten bis hin zum unternehmensweiten Einsatz. Die Plattform hilft Teams, die KI-Qualität systematisch zu messen, tiefe Einblicke in Agenteninteraktionen zu gewinnen, Leistungsmetriken wie Kosten und Latenz zu überwachen und an wichtigen Assets wie Prompts und Datensätzen zusammenzuarbeiten, um die zuverlässige Auslieferung von KI-Produkten zu gewährleisten.
DebuggingBraintrust Categories
Braintrust Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
HoneyHive
HoneyHive ist eine All-in-One-Plattform für KI-Beobachtbarkeit und -Evaluierung für Entwickler, die mit LLMs und KI-Agenten arbeiten. Sie bietet eine einheitliche Lösung zum Erstellen, Testen, Debuggen und Überwachen von KI-Anwendungen, von ersten Experimenten bis hin zum unternehmensweiten Einsatz. Die Plattform hilft Teams, die KI-Qualität systematisch zu messen, tiefe Einblicke in Agenteninteraktionen zu gewinnen, Leistungsmetriken wie Kosten und Latenz zu überwachen und an wichtigen Assets wie Prompts und Datensätzen zusammenzuarbeiten, um die zuverlässige Auslieferung von KI-Produkten zu gewährleisten.
Debugging
Teammately
Teammately ist eine fortschrittliche KI-Agenten-Plattform für KI-Ingenieure. Sie automatisiert und beschleunigt den gesamten KI-Entwicklungszyklus, von der Prompt-Generierung und dem RAG-Aufbau bis hin zur multidimensionalen Evaluierung und Produktions-Beobachtbarkeit. Erstellen Sie zuverlässige, skalierbare und sichere KI-Anwendungen, die schwer ausfallen, in einem Bruchteil der Zeit.
MLOpsLangfuse
Langfuse ist eine Open-Source LLM-Engineering-Plattform, die umfassende Werkzeuge zum Debuggen, Evaluieren und Verbessern von LLM-Anwendungen bietet. Sie umfasst Funktionen wie Tracing, Prompt-Management, Evaluierungs-Frameworks und Metriken, um den gesamten Entwicklungszyklus für Teams, die mit großen Sprachmodellen arbeiten, zu optimieren.
AnalysenParea AI
Parea AI ist eine End-to-End-Plattform für die Entwicklung, das Testen und die Überwachung von LLM-Anwendungen. Sie bietet Werkzeuge für Experiment-Tracking, Beobachtbarkeit, Evaluierung und menschliche Annotation, um Teams dabei zu helfen, KI-Systeme selbstbewusst in die Produktion zu bringen.
Modelltraining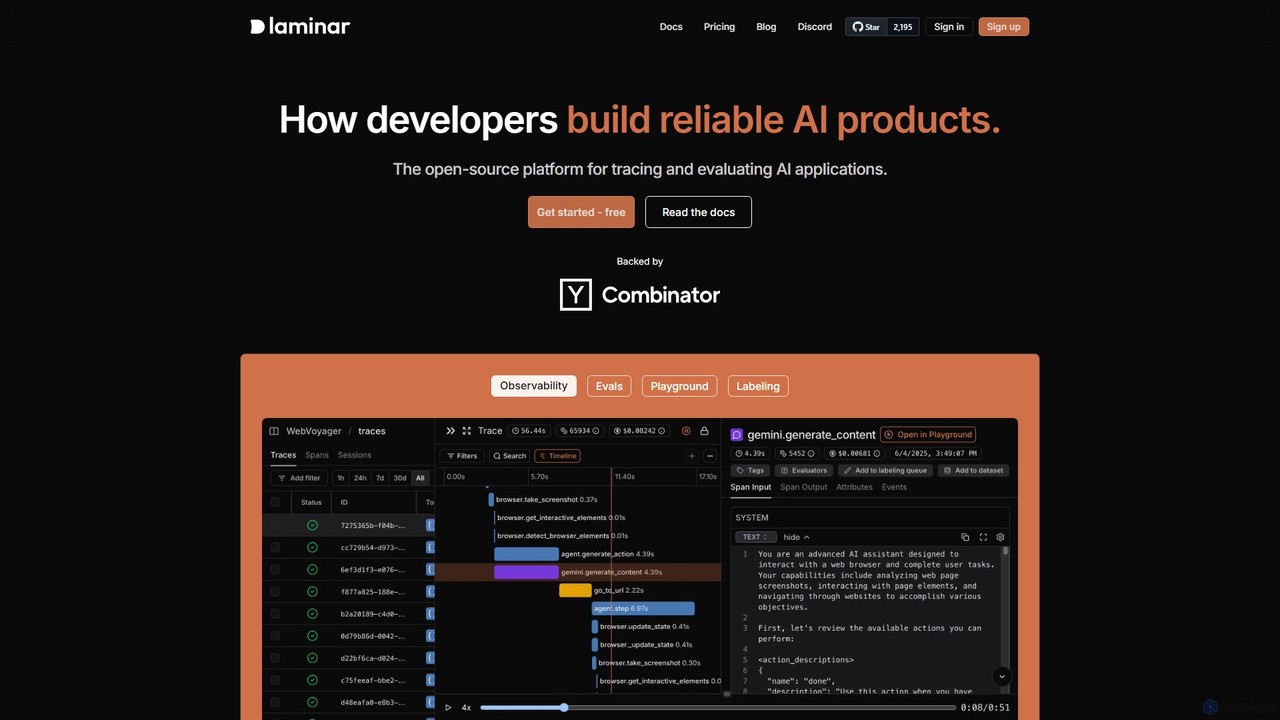
Laminar
Laminar ist eine Open-Source-Plattform für Observability und Evaluierung, die für Entwickler konzipiert wurde, die zuverlässige KI-Anwendungen erstellen. Sie bietet umfassende Werkzeuge zum Tracing, Evaluieren und Debuggen von LLM-gestützten Systemen. Zu den Hauptmerkmalen gehören Echtzeit-Tracing, Browser-Agent-Observability, ein interaktiver Playground und integriertes Dataset-Management, was den gesamten MLOps-Lebenszyklus von der Entwicklung bis zur Produktion vereinfacht.
DebuggingPromptLayer
PromptLayer ist Ihre umfassende Werkbank für KI-Engineering und bietet eine einheitliche Plattform für Prompt-Management, Evaluierung und LLM-Observability. Es ermöglicht Teams, jeden Prompt und Agenten zu versionieren, zu testen und zu überwachen und fördert die Zusammenarbeit zwischen technischen und nicht-technischen Stakeholdern, um produktionsreife KI-Anwendungen effizient zu erstellen und zu skalieren.
ModellverwaltungFreeplay
Freeplay ist eine unternehmenstaugliche Plattform, die für KI-Teams entwickelt wurde, um KI-Produkte und -Agenten zu erstellen, zu testen und kontinuierlich zu verbessern. Sie vereint Prompt-Management, Experimente, LLM-Beobachtbarkeit und Datenüberprüfung in einem einzigen Workflow und schafft so ein leistungsstarkes Daten-Schwungrad zur Beschleunigung der Produktqualität und Entwicklungsgeschwindigkeit.
Analysen
Pydantic
Pydantic ist eine umfassende Plattform für Entwickler, die leistungsstarke Datenvalidierung, KI-Entwicklungstools und eine Full-Stack-Observability-Lösung bietet. Sie ermöglicht eine schnellere und robustere Anwendungsentwicklung in Python und anderen Sprachen, indem sie Typ-Hinweise für die Laufzeit-Datenvalidierung nutzt und tiefe Einblicke von der lokalen Entwicklung bis zur Produktion liefert.
Debugging & Tests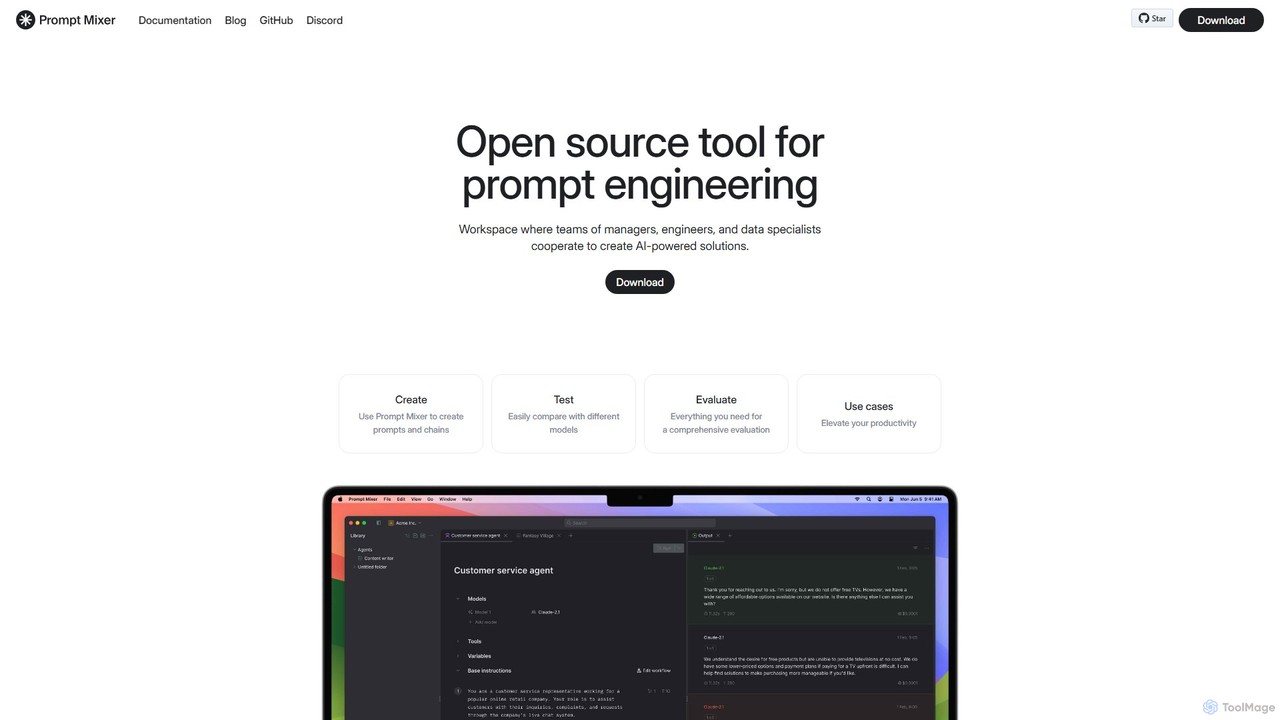
Prompt Mixer
Prompt Mixer ist ein leistungsstarkes Open-Source-Tool für Prompt-Engineering, das einen kollaborativen Arbeitsbereich für Teams bietet. Es ermöglicht Benutzern, KI-gestützte Lösungen zu erstellen, zu testen, zu bewerten und bereitzustellen, indem es Prompt-Ketten verwaltet, verschiedene LLMs vergleicht und fortschrittliche Bewertungsmetriken nutzt.
Prompt Engineering
gpt_sdk
Eine entwicklerorientierte Plattform zur Verwaltung von Prompts für große Sprachmodelle (LLMs) mit Git-basierter Versionskontrolle. Optimieren Sie Ihren Prompt-Engineering-Workflow, arbeiten Sie im Team zusammen und stellen Sie Änderungen nahtlos bereit, ohne den Code zu ändern.
MLOps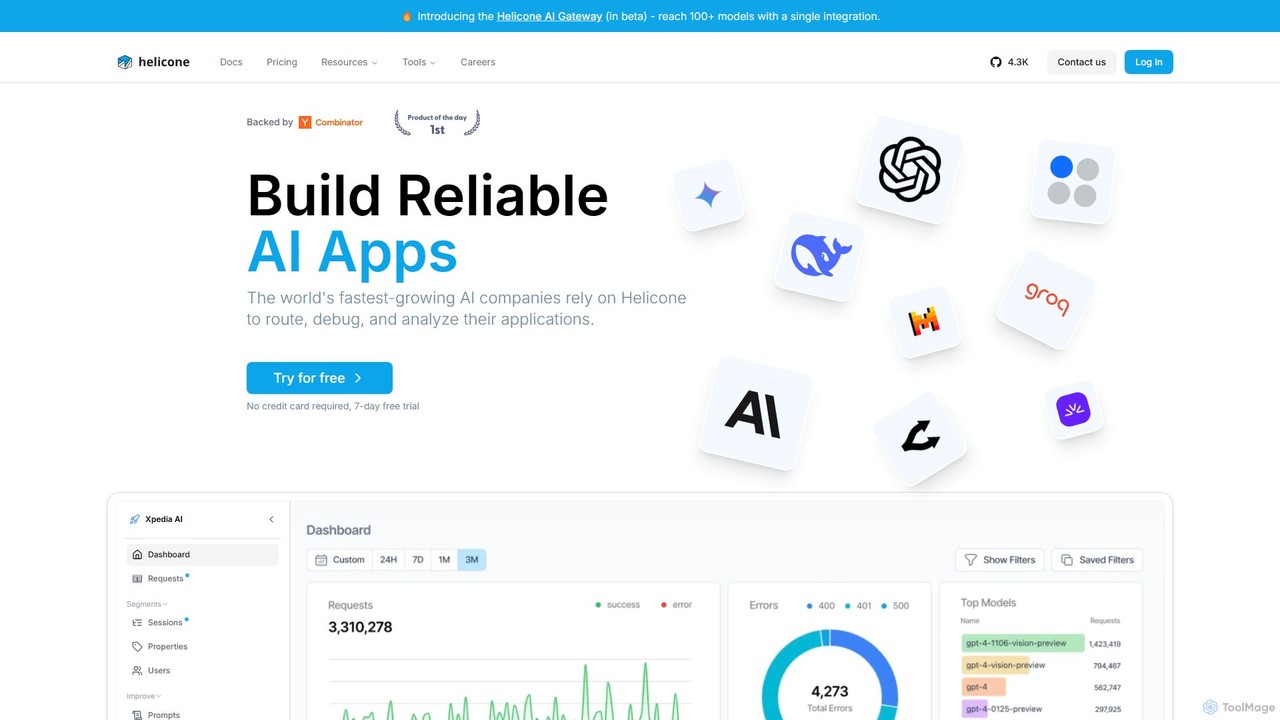
Valyr
Valyr (ehemals Helicone) ist eine Open-Source-Plattform für LLM-Observability und ein KI-Gateway. Es hilft Entwicklern, ihre KI-Anwendungen zu überwachen, zu debuggen und zu analysieren, bietet eine einzige Integration für den Zugriff auf über 100 Modelle, Kostenmanagement und verbesserte Zuverlässigkeit durch Funktionen wie Caching und Ratenbegrenzung.
API-Management
PromptPilot
PromptPilot von Volcengine ist eine unternehmenstaugliche Plattform für Prompt-Engineering und -Management. Sie ermöglicht Teams das Erstellen, Testen, Verwalten und Bereitstellen von LLM-Prompts mit Funktionen wie Versionskontrolle, A/B-Tests, Leistungsanalysen und nahtloser Zusammenarbeit. Optimieren Sie Ihre KI-Anwendungsentwicklung, indem Sie die Prompt-Logik vom Anwendungscode entkoppeln, Konsistenz gewährleisten und die Leistung über verschiedene große Sprachmodelle hinweg optimieren.
Unternehmenslösungen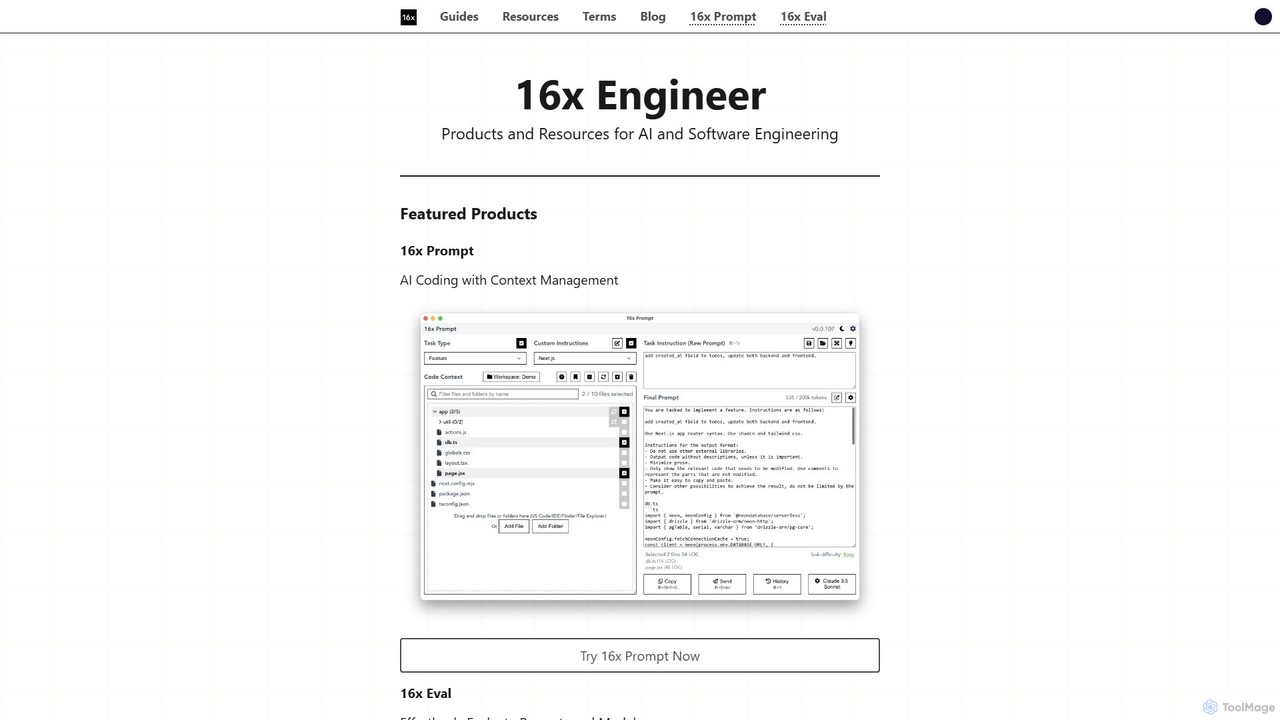
16x Engineer
16x Engineer ist eine umfassende Plattform für Software- und KI-Ingenieure, die eine Reihe spezialisierter Tools und tiefgehender Ressourcen bietet. Sie umfasst '16x Prompt' für fortgeschrittenes Kontextmanagement beim KI-gestützten Codieren und '16x Eval' zur Bewertung von Prompts und Modellen. Von Ingenieuren für Ingenieure entwickelt, zielt es darauf ab, die Produktivität zu steigern und die Karriereentwicklung durch praktische Werkzeuge und Expertenleitfäden zu technischen Fähigkeiten und beruflicher Weiterentwicklung zu beschleunigen.
KI
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung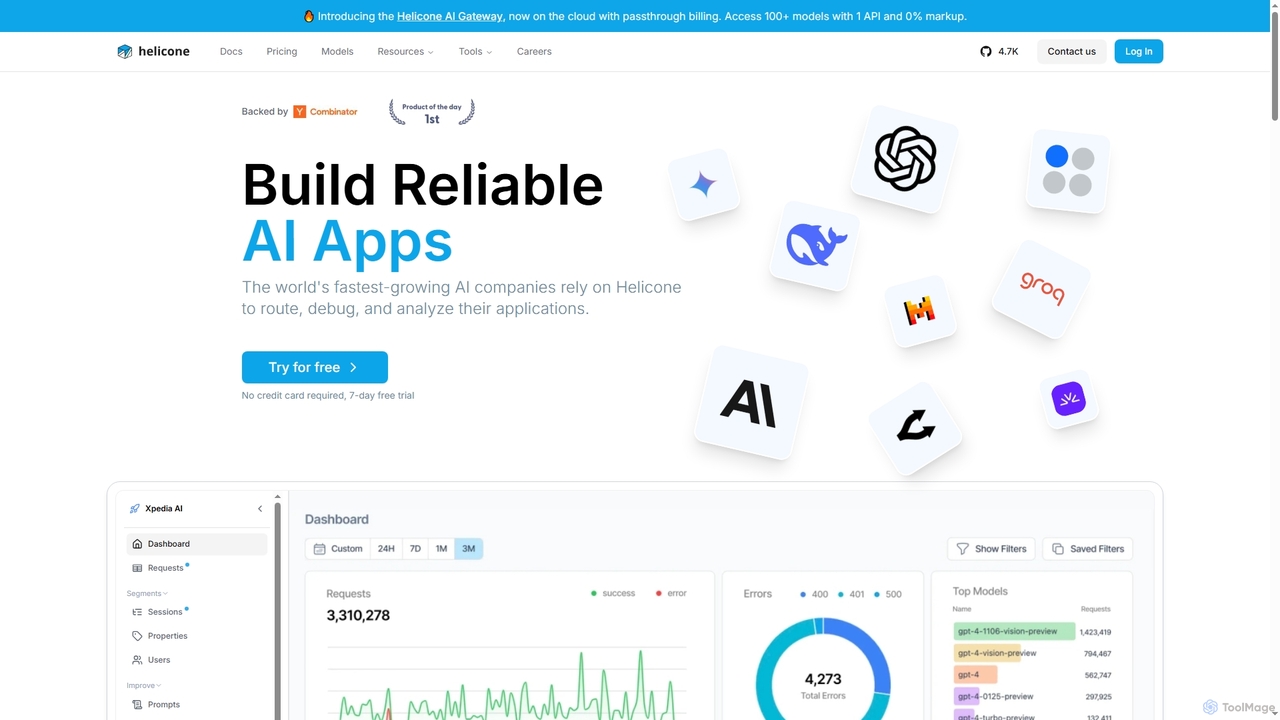
Helicone
Helicone ist eine Open-Source-Plattform, die ein KI-Gateway und LLM-Observability für Entwickler bietet. Sie hilft bei der Erstellung zuverlässiger KI-Anwendungen durch Tools zum Routen, Überwachen, Debuggen und Analysieren der LLM-Nutzung. Zu den Hauptmerkmalen gehören eine einheitliche API für über 100 Modelle, intelligentes Caching, Ratenbegrenzung, Prompt-Management und detaillierte Leistungsanalysen.
API-Management
Braintrust Comments (0)
Sign in to comment.
AnmeldenNo comments yet.