
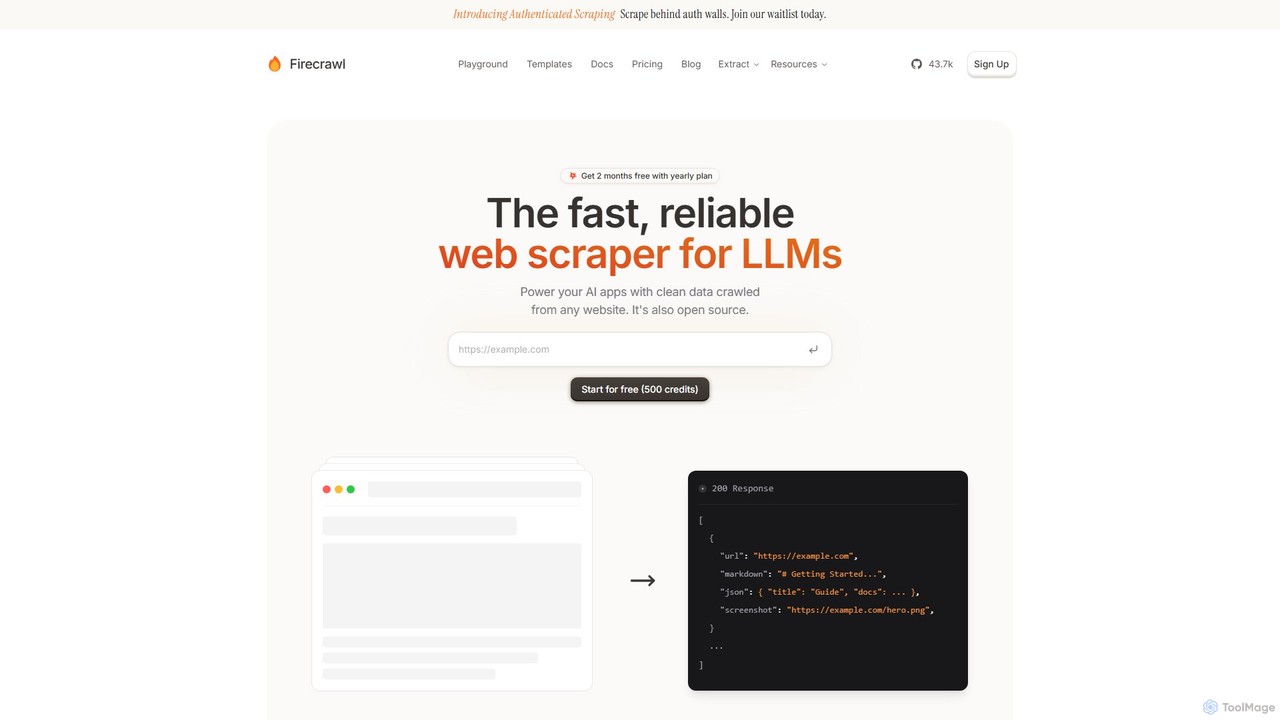
Firecrawl Overview
Firecrawl ist eine leistungsstarke, entwicklerzentrierte Plattform, die den Prozess der Webdatenextraktion für KI-Anwendungen vereinfachen soll. Es fungiert als All-in-One-API, die Websites scrapen, crawlen und durchsuchen kann und unstrukturierte Webinhalte in saubere, strukturierte und LLM-fähige Datenformate wie Markdown und JSON umwandelt. Als Open-Source-Tool fördert es Transparenz und Community-Zusammenarbeit, während seine gehostete Version eine robuste, skalierbare Infrastruktur für Produktionsanforderungen bietet.
Die Kernmission von Firecrawl ist es, die traditionellen Komplexitäten des Web-Scrapings zu beseitigen. Es verwaltet automatisch rotierende Proxys, handhabt JavaScript-lastige Single-Page-Anwendungen (SPAs), umgeht Blocker und verwaltet intelligent Ratenbegrenzungen. Dies ermöglicht es Entwicklern und KI-Ingenieuren, sich auf die Erstellung ihrer Anwendungen zu konzentrieren, anstatt eine komplexe Scraping-Infrastruktur zu verwalten. Firecrawl wird von Top-Unternehmen vertraut und lässt sich nahtlos in beliebte KI-Frameworks und Workflows integrieren.
Wie man Firecrawl verwendet
Die Verwendung von Firecrawl ist unkompliziert und für eine schnelle Integration konzipiert. Hier ist ein typischer Arbeitsablauf:
- API-Schlüssel erhalten: Melden Sie sich auf der Firecrawl-Website an, um einen kostenlosen API-Schlüssel zu erhalten. Der kostenlose Plan enthält 500 Credits für den Einstieg.
- SDK installieren: Firecrawl bietet benutzerfreundliche SDKs für gängige Sprachen. In Node.js können Sie es beispielsweise über npm installieren:
npm install @mendable/firecrawl-js. SDKs für Python und Rust sind ebenfalls verfügbar. - Einen Endpunkt wählen: Firecrawl bietet mehrere API-Endpunkte für verschiedene Aufgaben:
/scrape: Um den Inhalt einer einzelnen URL zu erhalten./crawl: Um alle zugänglichen Seiten einer Website rekursiv zu crawlen./search: Um eine Websuche durchzuführen und den vollständigen Inhalt der Ergebnisse zu erhalten./extract: Um strukturierte Daten von einer Seite mit einem KI-gestützten Prompt zu extrahieren.
- Einen API-Aufruf tätigen: Verwenden Sie das SDK oder stellen Sie eine direkte HTTP-Anfrage an den gewünschten Endpunkt. Zum Beispiel, um eine URL zu scrapen:
await app.scrapeUrl('example.com'); - Die Ausgabe verarbeiten: Die API gibt eine saubere JSON-Antwort zurück, die die Daten in Ihrem angegebenen Format (z. B. Markdown) sowie Metadaten und einen optionalen Screenshot enthält.
- Integrieren und Skalieren: Integrieren Sie die Daten in Ihre KI-Anwendung, wie z. B. eine RAG-Pipeline, einen KI-Agenten oder einen Datenanreicherungsworkflow. Sie können Ihre Nutzung mit ihren flexiblen Preisplänen leicht skalieren. Die Plattform verfügt auch über einen Playground zum Testen von API-Aufrufen ohne Code zu schreiben.
Kernfunktionen von Firecrawl
- Umfassendes Scraping & Crawling: Scrapt einzelne Seiten oder crawlt ganze Websites, auch solche ohne Sitemap.
- LLM-fähige Daten: Wandelt unordentliches HTML in sauberes Markdown um, was die Token-Anzahl erheblich reduziert und die Datenqualität für LLMs verbessert. Es kann auch strukturiertes JSON ausgeben.
- Integrierte Such-API: Ein einziger API-Aufruf, um das Web zu durchsuchen und den Inhalt jedes Ergebnisses zu scrapen, perfekt für KI-Agenten und Recherche-Tools.
- Infrastruktur ohne Konfiguration: Verwaltet automatisch rotierende Proxys, Browser-Management, Ratenbegrenzung und JavaScript-Rendering, sodass Sie sich nicht darum kümmern müssen.
- Authentifiziertes Scraping: Eine neue Funktion (derzeit auf der Warteliste), um Inhalte zu scrapen, die sich hinter Anmelde-Wänden befinden.
- KI-gestützte Extraktion (`/extract`): Verwendet einen einfachen Prompt, um strukturierte Daten von Webseiten zu extrahieren und Websites in APIs zu verwandeln.
- Medien-Parsing: Kann Inhalte aus web-gehosteten Dateien wie PDFs und DOCX parsen und extrahieren.
- Entwicklerorientiert & Open Source: Bietet SDKs für Node.js, Python und Rust, umfangreiche Dokumentation und ein transparentes, von der Community betriebenes Open-Source-Repository.
Anwendungsfälle für Firecrawl
Firecrawl ist vielseitig und treibt eine breite Palette von Anwendungen an:
- KI-Chatbots & Assistenten: Unternehmen wie Zapier und Botpress verwenden Firecrawl, um ihre KI-Assistenten mit Echtzeit-, genauen Web-Inhalten für Retrieval-Augmented Generation (RAG) zu versorgen.
- Tiefgehende Recherche & Analyse: KI-Agenten können die Such- und Crawl-APIs verwenden, um umfassende Recherchen zu jedem Thema durchzuführen, Marktinformationen zu sammeln oder Wettbewerber zu überwachen.
- Lead-Anreicherung & Vertriebsautomatisierung: Verbessern Sie Vertriebsdaten durch automatisches Scrapen von Unternehmenswebsites für aktuelle Informationen, Kontakte und Geschäftsdetails.
- Entwicklung von KI-Plattformen: Ermöglichen Sie den Kunden Ihrer Plattform, ihre eigenen KI-Anwendungen mit Webdaten zu erstellen, wie bei Stack AI und Gamma zu sehen ist.
- Website- & Inhaltsüberwachung: Verfolgen Sie Änderungen auf jeder Website, erhalten Sie visuelle Vergleiche und KI-gestützte Analysen der Updates.
- Erstellung benutzerdefinierter Tools: Entwickler haben verschiedene Tools erstellt, darunter Job-Matching-Apps, Preisüberwachungssysteme und Startup-Ideen-Validatoren, die die Datenextraktionsfähigkeiten von Firecrawl nutzen.
Vorteile von Firecrawl
- Zuverlässigkeit und Skalierbarkeit: Entwickelt für die Bewältigung großer Datenextraktionsprojekte, die täglich Hunderttausende von Anfragen mit hoher Zuverlässigkeit verarbeiten.
- Geschwindigkeit und Effizienz: In Benchmarks als deutlich schneller als viele Alternativen nachgewiesen, was einen schnellen Zugriff auf Webdaten ermöglicht.
- Kosteneffizienz: Durch die Bereitstellung von sauberem Markdown können bis zu 2/3 der LLM-Token-Kosten eingespart werden, was die Verwendung kostengünstigerer Modelle ohne Qualitätseinbußen ermöglicht.
- Einfachheit: Eine einzige, einheitliche API vereinfacht den Entwicklungsprozess und ersetzt die Notwendigkeit komplexer Scraping-Setups mit mehreren Tools.
- Nahtlose Integrationen: Vollständig integriert mit wichtigen Tools und Frameworks wie LangChain, LangFlow, n8n, CrewAI und mehr, und passt sich leicht in bestehende Workflows ein.
Preise und Pläne
Firecrawl bietet ein flexibles Freemium-Preismodell, das mit Ihren Bedürfnissen wächst:
- Kostenloser Plan: 0 $ für eine einmalige Gutschrift von 500 Credits. Perfekt zum Testen und für kleine Projekte. Keine Kreditkarte erforderlich.
- Hobby-Plan: 19 $/Monat (oder 16 $/Monat bei jährlicher Abrechnung) für 3.000 Credits pro Monat.
- Standard-Plan: 99 $/Monat (oder 83 $/Monat bei jährlicher Abrechnung) für 100.000 Credits pro Monat. Dies ist der beliebteste Plan.
- Growth-Plan: 399 $/Monat (oder 333 $/Monat bei jährlicher Abrechnung) für 500.000 Credits pro Monat, mit priorisiertem Support.
- Enterprise-Plan: Individuelle Preise für unbegrenzte Credits, benutzerdefinierte Ratenbegrenzungen, SLAs und erweiterte Sicherheitsfunktionen.
Credits-System: Credits werden pro API-Aufruf verbraucht. Ein Standard-/scrape- oder /crawl-Aufruf kostet beispielsweise 1 Credit pro Seite. Der /search-Endpunkt kostet 1 Credit pro Ergebnis. Add-ons wie Credit Packs und Auto Recharge sind für kostenpflichtige Pläne verfügbar.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 675.7K
- 2026-1: 892.8K
- 2026-2: 902.3K
- 2026-3: 1.3M
- 2026-4: 1.5M
- 2026-5: 1.5M
Geography
Top 5 countries / regions
- 🇺🇸Vereinigte Staaten52.4%
- 🇮🇳Indien20.0%
- 🇨🇳China12.6%
- 🇩🇪Deutschland8.2%
- 🇧🇷Brasilien6.7%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 87.0% |
Referral | 10.3% |
Email | 2.7% |
Top keywords
| Keyword | Cost per click |
|---|---|
| apify | $0.89 |
| fire crawl | $4.05 |
| firecrawl | $2.34 |
| firecrawl api | $7.39 |
| firecrawl mcp | $3.93 |
Firecrawl Videos on YouTube
Vashishtha Kapoor

Kenil Barochia | AI & TECH


Grayson Ho | AI Builders Lab


Firecrawl Alternatives
NoCaptcha AI
NoCaptcha AI ist ein KI-gestützter CAPTCHA-Lösungsdienst, der Entwicklern und Unternehmen hilft, CAPTCHAs automatisch zu umgehen. Er bietet eine schnelle, zuverlässige und skalierbare API-Lösung zur Bewältigung verschiedener CAPTCHA-Typen, einschließlich reCAPTCHA, Geetest und OCR, um die RPA-Effizienz zu steigern und den Webzugriff freizuschalten.
Web Scraping
NextCaptcha
NextCaptcha ist ein KI-gestützter CAPTCHA-Lösungsdienst für Entwickler und Unternehmen. Er bietet eine schnelle, stabile und kostengünstige Lösung zum Umgehen verschiedener CAPTCHAs, einschließlich Googles reCAPTCHA V2, V3 und Enterprise, mit einer Erfolgsquote von 99 %. Der Dienst bietet eine einfache API für eine nahtlose Integration und unterstützt Aufgaben mit hoher Parallelität für Web Scraping, Datenextraktion und Automatisierung.
Web Scraping
Smithery
Smithery ist ein Register und Protokoll für KI-Agenten, das ein Gateway zu Tausenden von von der Community erstellten Fähigkeiten und Erweiterungen bietet. Es ermöglicht Entwicklern, externe Tools wie Webbrowser, Datenbanken und APIs einfach in ihre KI-Anwendungen zu integrieren und so deren Fähigkeiten und Kontextbewusstsein zu verbessern.
Datenbank
Browserbase
Browserbase bietet eine skalierbare Cloud-Infrastruktur zum Ausführen und Verwalten von Headless-Browsern. Es wurde für Entwickler konzipiert, um KI-Agenten zu unterstützen, komplexe Web-Workflows zu automatisieren und groß angelegtes Daten-Scraping durchzuführen, ohne die zugrunde liegende Infrastruktur verwalten zu müssen.
Web Scraping
supermemory
supermemory ist eine Speicher-API und Infrastruktur für das KI-Zeitalter, die für Entwickler konzipiert wurde, um LLMs mit einem langlebigen, persistenten Gedächtnis zu erstellen. Es überwindet die Begrenzung des endlichen Kontextfensters und ermöglicht die Erstellung intelligenter, kontextbewusster KI-Agenten, Chatbots und Anwendungen, die sich an vergangene Interaktionen und Informationen über verschiedene Plattformen hinweg erinnern.
LLMFirecrawl Categories
Firecrawl Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Langflow
Langflow ist eine visuelle Open-Source-Benutzeroberfläche zum Erstellen und Bereitstellen von KI-Anwendungen. Es verfügt über eine Drag-and-Drop-Oberfläche, um LLMs, Agenten und Tools zu verketten, was ein schnelles Prototyping und die Bereitstellung komplexer Workflows wie RAG und Multi-Agenten-Systeme ermöglicht. Es unterstützt umfangreiche Integrationen und bietet sowohl selbst gehostete als auch Cloud-Optionen.
Low-Code No-Code
ScrapeGraphAI
ScrapeGraphAI ist eine KI-gestützte Web-Scraping-API, die unstrukturierte Websites mit einfachen Anweisungen in natürlicher Sprache in saubere, strukturierte JSON-Daten umwandelt. Entwickelt für Entwickler, KI-Agenten und automatisierte Workflows, vereinfacht es die Datenextraktion ohne komplexen Code.
Analysen
UseScraper
UseScraper ist eine leistungsstarke Web-Crawler- und Scraper-API, die für Entwickler und KI-Anwendungen konzipiert wurde. Sie extrahiert effizient Daten von jeder Website und bietet vollständiges JavaScript-Rendering, eine automatisch skalierende Infrastruktur und saubere Ausgabeformate wie Markdown, ideal zur Einspeisung von Daten in LLMs wie ChatGPT.
Datenextraktion
Skrape
Skrape ist eine LLM-gestützte Web-Scraping-API, die entwickelt wurde, um jede Website in saubere, strukturierte und LLM-fähige Daten umzuwandeln. Es vereinfacht die Datenextraktion, indem es Webseiten in strukturiertes JSON oder sauberes Markdown konvertiert, was es ideal für KI-Training, RAG-Systeme und Datenanalyse macht. Mit Funktionen wie der Handhabung dynamischer Inhalte und intelligentem Crawling bietet Skrape eine zuverlässige Lösung für Entwickler und Unternehmen zur Automatisierung ihrer Datenerfassungspipelines.
ScrapingSmithery
Smithery ist ein Register und Protokoll für KI-Agenten, das ein Gateway zu Tausenden von von der Community erstellten Fähigkeiten und Erweiterungen bietet. Es ermöglicht Entwicklern, externe Tools wie Webbrowser, Datenbanken und APIs einfach in ihre KI-Anwendungen zu integrieren und so deren Fähigkeiten und Kontextbewusstsein zu verbessern.
DatenbankBrowserbase
Browserbase bietet eine skalierbare Cloud-Infrastruktur zum Ausführen und Verwalten von Headless-Browsern. Es wurde für Entwickler konzipiert, um KI-Agenten zu unterstützen, komplexe Web-Workflows zu automatisieren und groß angelegtes Daten-Scraping durchzuführen, ohne die zugrunde liegende Infrastruktur verwalten zu müssen.
Web Scrapingsupermemory
supermemory ist eine Speicher-API und Infrastruktur für das KI-Zeitalter, die für Entwickler konzipiert wurde, um LLMs mit einem langlebigen, persistenten Gedächtnis zu erstellen. Es überwindet die Begrenzung des endlichen Kontextfensters und ermöglicht die Erstellung intelligenter, kontextbewusster KI-Agenten, Chatbots und Anwendungen, die sich an vergangene Interaktionen und Informationen über verschiedene Plattformen hinweg erinnern.
LLM
Hyperbrowser
Hyperbrowser ist eine Browser-as-a-Service (BaaS)-Plattform, die für KI-Agenten und Entwickler konzipiert wurde. Sie bietet skalierbare, blitzschnelle Cloud-Browser zur Automatisierung von Web-Aufgaben, zur Datenextraktion und zur Ermöglichung von KI-gesteuerten Web-Interaktionen. Mit Funktionen wie Stealth-Browsing, automatischer Captcha-Lösung und entwicklerfreundlichen APIs ermöglicht sie komplexe Arbeitsabläufe ohne Grenzen.
Web Scraping
Crawlbase
Crawlbase ist eine KI-gestützte Web-Scraping- und Crawling-Plattform für Entwickler und Unternehmen. Sie vereinfacht die Datenextraktion durch die Handhabung von Proxys, CAPTCHAs und Anti-Bot-Systemen und ermöglicht es Ihnen, jede Website anonym zu crawlen und saubere, strukturierte Daten in großem Umfang abzurufen. Sie bietet eine Reihe von Tools, darunter eine Crawling-API, einen Smart Proxy und Cloud-Speicher.
Datenerfassung
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung
Apify
Apify ist eine Full-Stack-Web-Scraping- und Automatisierungsplattform, die es Entwicklern ermöglicht, Datenextraktionstools, sogenannte 'Actors', zu erstellen, bereitzustellen und zu veröffentlichen. Sie bietet einen riesigen Marktplatz mit vorgefertigten Scrapern für beliebte Websites wie Google Maps, Instagram und TikTok sowie eine robuste Cloud-Infrastruktur zur Erstellung benutzerdefinierter Lösungen. Mit Unterstützung für Python und JavaScript, Open-Source-Bibliotheken und nahtlosen Integrationen vereinfacht Apify die Erfassung von Webdaten in jedem Maßstab.
Datenerfassung
Mastra
Mastra ist ein Open-Source-TypeScript-Framework, das für Entwickler konzipiert wurde, um anspruchsvolle KI-Agenten und komplexe Workflows zu erstellen, bereitzustellen und zu verwalten. Es bietet ein entwicklerfreundliches SDK mit Funktionen wie persistentem Speicher, Tool-Aufrufen, Retrieval-Augmented Generation (RAG) und deterministischen Workflow-Graphen. Entwickelt vom Team hinter Gatsby, vereinfacht Mastra die Erstellung von produktionsreifen KI-Anwendungen im JavaScript-Ökosystem.
Agenten-Builder
phidata
phidata ist ein Open-Source-Python-Framework zum Erstellen autonomer KI-Assistenten. Es vereinfacht die Integration von LLMs mit Gedächtnis, Wissensdatenbanken und externen Tools und ermöglicht es Entwicklern, mühelos leistungsstarke, zustandsbehaftete KI-Anwendungen zu erstellen.
Frameworks
Skyvern
Skyvern ist eine KI-gestützte Browser-Automatisierungsplattform, die Computer Vision und natürliche Sprache nutzt, um komplexe Web-Workflows zu automatisieren. Sie kann Datenextraktion, Formularübermittlungen, Rechnungsabruf und mehr auf jeder Website bewältigen und passt sich dynamisch an Änderungen an, ohne traditionelles Scripting.
API
Linkup
Linkup ist eine fortschrittliche KI-gestützte Such-API, die entwickelt wurde, um KI-Anwendungen, Agenten und LLMs mit genauen, überprüfbaren Echtzeitdaten aus vertrauenswürdigen Webquellen zu versorgen. Sie verbessert die Faktenbasiertheit und Leistung von KI für verschiedene Geschäfts- und Forschungsanwendungsfälle.
Vertrieb
Firecrawl Comments (0)
Sign in to comment.
AnmeldenNo comments yet.