

Crawlbase Overview
Crawlbase ist eine umfassende, KI-gesteuerte Datenextraktionsplattform, die Entwicklern und Unternehmen den freien und anonymen Zugriff auf Webdaten ermöglicht. Basierend auf dem Prinzip der „Datenfreiheit“ bietet Crawlbase eine robuste Suite von Tools, die entwickelt wurden, um die üblichen Herausforderungen des Web-Scrapings wie IP-Sperren, CAPTCHAs und geografische Beschränkungen zu überwinden. Mit einer massiven Infrastruktur von Millionen rotierender Wohn- und Rechenzentrums-Proxys garantiert es hohe Erfolgsraten und Zuverlässigkeit für jedes Datensammlungsprojekt.
Die Plattform ist auf Skalierbarkeit ausgelegt und bedient sowohl kleine Projekte als auch große Unternehmensanforderungen, wie die Nutzung durch große Unternehmen wie Intel beweist. Die Kernphilosophie von Crawlbase besteht darin, den komplexen Prozess des Web-Crawlings zu vereinfachen, sodass sich die Benutzer auf die Datenanalyse statt auf das Infrastrukturmanagement konzentrieren können. Seine KI-Fähigkeiten sind besonders nützlich für das Training von Sprachmodellen, da die API intelligent Websites navigieren, relevante Informationen extrahieren und sie in einem strukturierten, maschinenlesbaren Format bereitstellen kann.
Wie man Crawlbase verwendet
Der Einstieg in Crawlbase ist schnell und unkompliziert und dauert in der Regel nur wenige Minuten. Zuerst müssen Sie ein kostenloses Konto auf der Crawlbase-Website erstellen, für das keine Kreditkarte erforderlich ist und das 1.000 kostenlose Anfragen zum Einstieg enthält. Nach der Registrierung erhalten Sie einen API-Token. Um den Dienst zu nutzen, tätigen Sie einfach einen API-Aufruf an einen der Endpunkte von Crawlbase, wie die Crawling-API oder den Smart Proxy. Für die Crawling-API übergeben Sie Ihren Token und die Ziel-URL, die Sie scrapen möchten. Die API kümmert sich um den gesamten Prozess der Proxy-Rotation, des Header-Managements und der Umgehung von Sperren und gibt den rohen HTML-Code der Seite zurück. Für eine erweiterte Nutzung können Sie Parameter für JavaScript-Rendering, Geotargeting und mehr angeben.
Kernfunktionen von Crawlbase
- Crawling-API: Eine leistungsstarke API, die den HTML-Code von jeder Webseite abruft und dabei automatisch Headless-Browser, Proxy-Rotation und CAPTCHA-Lösung handhabt.
- Smart Proxy: Eine intelligente Proxy-Lösung, mit der Sie Ihre Anfragen über das riesige Netzwerk von Crawlbase mit über 140 Millionen Wohn- und Rechenzentrums-Proxys leiten können, um hohe Anonymität und Erfolgsraten zu gewährleisten.
- KI-gestützte Datenextraktion: Nutzt fortschrittliche KI, um rohen HTML-Code zu parsen und saubere, strukturierte Daten im JSON-Format zu extrahieren, ideal zur Einspeisung in Datenbanken oder zum Training von Machine-Learning-Modellen.
- Groß angelegter Crawler: Eine dedizierte Lösung für massive Datenextraktionsprojekte, die darauf ausgelegt ist, große Datenmengen effizient direkt an Ihre Server zu liefern.
- Cloud-Speicher: Eine sichere und bequeme Cloud-Speicherlösung, die speziell zum Speichern Ihrer gecrawlten Daten entwickelt wurde und Ihre Datenpipeline vereinfacht.
- Globales Proxy-Netzwerk: Zugriff auf einen riesigen Pool von Proxys aus zahlreichen Ländern, was präzises Geotargeting und die Umgehung regionaler Beschränkungen ermöglicht.
- Garantierte Betriebszeit: Bietet eine Betriebszeitgarantie von 99,99 %, die sicherstellt, dass Ihre Datensammlungsprozesse ununterbrochen laufen.
Anwendungsfälle für Crawlbase
Crawlbase ist vielseitig und kann für eine breite Palette von datengesteuerten Aufgaben eingesetzt werden. Für E-Commerce-Unternehmen wird es zur Preisintelligenz, zur Überwachung der Preise von Wettbewerbern und zur Verfolgung der Produktverfügbarkeit verwendet. Im Marketing ist es für die SEO-Überwachung, die Verfolgung von Keyword-Rankings und die Sammlung von Marktforschungsdaten unerlässlich. Finanzinstitute nutzen es, um Finanzdaten aus verschiedenen Quellen für Analysen und Handel zu aggregieren. Ein bedeutender Anwendungsfall liegt im Bereich der künstlichen Intelligenz, wo Unternehmen Crawlbase nutzen, um riesige Datensätze aus dem Web zu sammeln, um große Sprachmodelle (LLMs) und andere KI-Systeme zu trainieren. Es wird auch zur Lead-Generierung, zur Aggregation von Immobiliendaten und zur akademischen Forschung verwendet.
Vorteile von Crawlbase
Der Hauptvorteil von Crawlbase ist seine Fähigkeit, die Komplexität des Web-Scrapings zu abstrahieren. Benutzer müssen nicht mehr ihre eigene Proxy-Infrastruktur verwalten, sich mit rotierenden IP-Adressen befassen oder Lösungen zur Umgehung ausgeklügelter Anti-Bot-Maßnahmen entwickeln. Dies führt zu erheblichen Einsparungen bei Zeit, Entwicklungsressourcen und Betriebskosten. Seine hohe Skalierbarkeit stellt sicher, dass es mit Ihren Anforderungen wachsen kann, von einigen tausend Anfragen bis zu Milliarden. Der 24/7-Experten-Support bietet zuverlässige Unterstützung, und sein Engagement für die Einhaltung von DSGVO und CCPA sorgt für Sicherheit. Der innovative Ansatz und die bewährte Zuverlässigkeit der Plattform haben sie zu einem führenden Anbieter auf dem Datenextraktionsmarkt gemacht.
Preise und Pläne
Crawlbase arbeitet nach einem Freemium-Modell. Neue Benutzer können sich für eine kostenlose Testversion anmelden, die 1.000 erfolgreiche Anfragen ohne Kreditkarte enthält. Dies ermöglicht ein gründliches Testen der API-Funktionen. Nach der Testphase bietet Crawlbase eine Vielzahl von kostenpflichtigen Plänen an, deren Preise sich nach der Anzahl der Anfragen und den spezifischen erforderlichen Funktionen richten. Die Pläne sind flexibel gestaltet und richten sich an eine breite Palette von Benutzern, von einzelnen Entwicklern bis hin zu großen Unternehmen. Für detaillierte und aktuelle Preisinformationen wird empfohlen, die offizielle Website von Crawlbase zu besuchen.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 2.8K
- 2026-1: 707
- 2026-2: 551
- 2026-3: 236
- 2026-4: 532
- 2026-5: 131
Geography
Top 5 countries / regions
- 🇹🇼Taiwan100.0%
Top keywords
| Keyword | Cost per click |
|---|---|
| agoda 酒店搜索数据爬取 | $0.00 |
| crawlbase | $2.99 |
| crawlbase api | $0.00 |
| scrapingbot | $2.17 |
| scrapireddit | $0.00 |
Crawlbase Alternatives
ScrapingBee
ScrapingBee ist eine leistungsstarke Web-Scraping-API, die Headless-Browser und Proxy-Rotation handhabt, um Blockierungen zu vermeiden. Sie verfügt über einen innovativen KI-gestützten Extraktor, mit dem Sie die benötigten Daten in einfachem Englisch beschreiben können, wodurch komplexe CSS-Selektoren überflüssig werden. Ideal für Entwickler, Vermarkter und Datenanalysten für Aufgaben wie Preisüberwachung, Lead-Generierung und SERP-Analyse.
Datenextraktion
FetchFox
FetchFox ist ein KI-gestütztes Web-Scraping-Tool, das es Benutzern ermöglicht, Daten von jeder Website mit einfachen Textanweisungen zu extrahieren. Es eliminiert die Notwendigkeit komplexer Codierung oder CSS-Selektoren und handhabt automatisch Anti-Bot-Maßnahmen. Verfügbar als API, JavaScript-Bibliothek und Chrome-Erweiterung, ist es sowohl für Entwickler als auch für nicht-technische Benutzer konzipiert, um die Datenerfassung mühelos zu automatisieren.
Datenextraktion
WebScraping.AI
WebScraping.AI ist eine fortschrittliche API für Entwickler, die das Web-Scraping mit KI vereinfacht. Sie bietet rotierende Proxys, JavaScript-Rendering und Geotargeting, um Blockaden zu umgehen und auf dynamische Inhalte zuzugreifen. Ihre Kernstärke liegt in den LLM-gestützten Werkzeugen, die unstrukturierte Daten extrahieren, Zusammenfassungen erstellen und Fragen direkt von Webseiten beantworten können, was die Datenerfassung für jedes Projekt optimiert.
Datenextraktion
Scrappey
Scrappey ist eine fortschrittliche Web-Scraping-API, die für Entwickler entwickelt wurde, um mühelos Daten von jeder Website zu extrahieren. Sie bewältigt alle Komplexitäten wie rotierende Proxys, Headless-Browser und die Umgehung von Anti-Bot-Maßnahmen wie Cloudflare und CAPTCHAs. Mit einer hohen Erfolgsquote und einem einfachen Pay-as-you-go-Modell optimiert Scrappey die Datenerfassung für verschiedene Anwendungen.
Datenextraktion
Apify
Apify ist eine Full-Stack-Web-Scraping- und Automatisierungsplattform, die es Entwicklern ermöglicht, Datenextraktionstools, sogenannte 'Actors', zu erstellen, bereitzustellen und zu veröffentlichen. Sie bietet einen riesigen Marktplatz mit vorgefertigten Scrapern für beliebte Websites wie Google Maps, Instagram und TikTok sowie eine robuste Cloud-Infrastruktur zur Erstellung benutzerdefinierter Lösungen. Mit Unterstützung für Python und JavaScript, Open-Source-Bibliotheken und nahtlosen Integrationen vereinfacht Apify die Erfassung von Webdaten in jedem Maßstab.
DatenerfassungCrawlbase Categories
Crawlbase Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Scrappey
Scrappey ist eine fortschrittliche Web-Scraping-API, die für Entwickler entwickelt wurde, um mühelos Daten von jeder Website zu extrahieren. Sie bewältigt alle Komplexitäten wie rotierende Proxys, Headless-Browser und die Umgehung von Anti-Bot-Maßnahmen wie Cloudflare und CAPTCHAs. Mit einer hohen Erfolgsquote und einem einfachen Pay-as-you-go-Modell optimiert Scrappey die Datenerfassung für verschiedene Anwendungen.
DatenextraktionFetchFox
FetchFox ist ein KI-gestütztes Web-Scraping-Tool, das es Benutzern ermöglicht, Daten von jeder Website mit einfachen Textanweisungen zu extrahieren. Es eliminiert die Notwendigkeit komplexer Codierung oder CSS-Selektoren und handhabt automatisch Anti-Bot-Maßnahmen. Verfügbar als API, JavaScript-Bibliothek und Chrome-Erweiterung, ist es sowohl für Entwickler als auch für nicht-technische Benutzer konzipiert, um die Datenerfassung mühelos zu automatisieren.
DatenextraktionWebScraping.AI
WebScraping.AI ist eine fortschrittliche API für Entwickler, die das Web-Scraping mit KI vereinfacht. Sie bietet rotierende Proxys, JavaScript-Rendering und Geotargeting, um Blockaden zu umgehen und auf dynamische Inhalte zuzugreifen. Ihre Kernstärke liegt in den LLM-gestützten Werkzeugen, die unstrukturierte Daten extrahieren, Zusammenfassungen erstellen und Fragen direkt von Webseiten beantworten können, was die Datenerfassung für jedes Projekt optimiert.
Datenextraktion
BestProxy
BestProxy ist ein führender Anbieter von Residential- und ISP-Proxy-Diensten und bietet einen riesigen Pool von über 80 Millionen ethisch einwandfrei beschafften IPs. Es ist für KI, groß angelegtes Daten-Scraping, Marktforschung und die Verwaltung mehrerer Konten optimiert und zeichnet sich durch hohe Geschwindigkeiten, 99,99 % Betriebszeit, unbegrenzte gleichzeitige Anfragen und präzises Geo-Targeting aus.
Web Scraping
instantapi
instantapi ist eine KI-gestützte Web-Scraping-API, die auf Einfachheit und Geschwindigkeit ausgelegt ist. Sie ermöglicht es Benutzern, strukturierte Daten von jeder Website mit einem einzigen API-Aufruf zu extrahieren, ohne dass komplexe Programmierung oder manuelle Einrichtung erforderlich ist. Ideal für Entwickler, Datenanalysten und Unternehmen, die eine schnelle, kostengünstige und zuverlässige Datenextraktion ohne den Aufwand herkömmlicher Web-Scraper benötigen.
Datenextraktion
Bright Data
Bright Data ist die weltweit führende Web-Datenplattform und bietet eine umfassende Suite von Tools, einschließlich Proxy-Netzwerken, KI-gestützten Web-Scrapern und sofort einsatzbereiten Datensätzen. Sie ermöglicht es Unternehmen, große Mengen öffentlicher Web-Daten für KI-Training, Marktforschung und Wettbewerbsanalyse zu sammeln.
Business Intelligence
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
AutomatisierungApify
Apify ist eine Full-Stack-Web-Scraping- und Automatisierungsplattform, die es Entwicklern ermöglicht, Datenextraktionstools, sogenannte 'Actors', zu erstellen, bereitzustellen und zu veröffentlichen. Sie bietet einen riesigen Marktplatz mit vorgefertigten Scrapern für beliebte Websites wie Google Maps, Instagram und TikTok sowie eine robuste Cloud-Infrastruktur zur Erstellung benutzerdefinierter Lösungen. Mit Unterstützung für Python und JavaScript, Open-Source-Bibliotheken und nahtlosen Integrationen vereinfacht Apify die Erfassung von Webdaten in jedem Maßstab.
Datenerfassung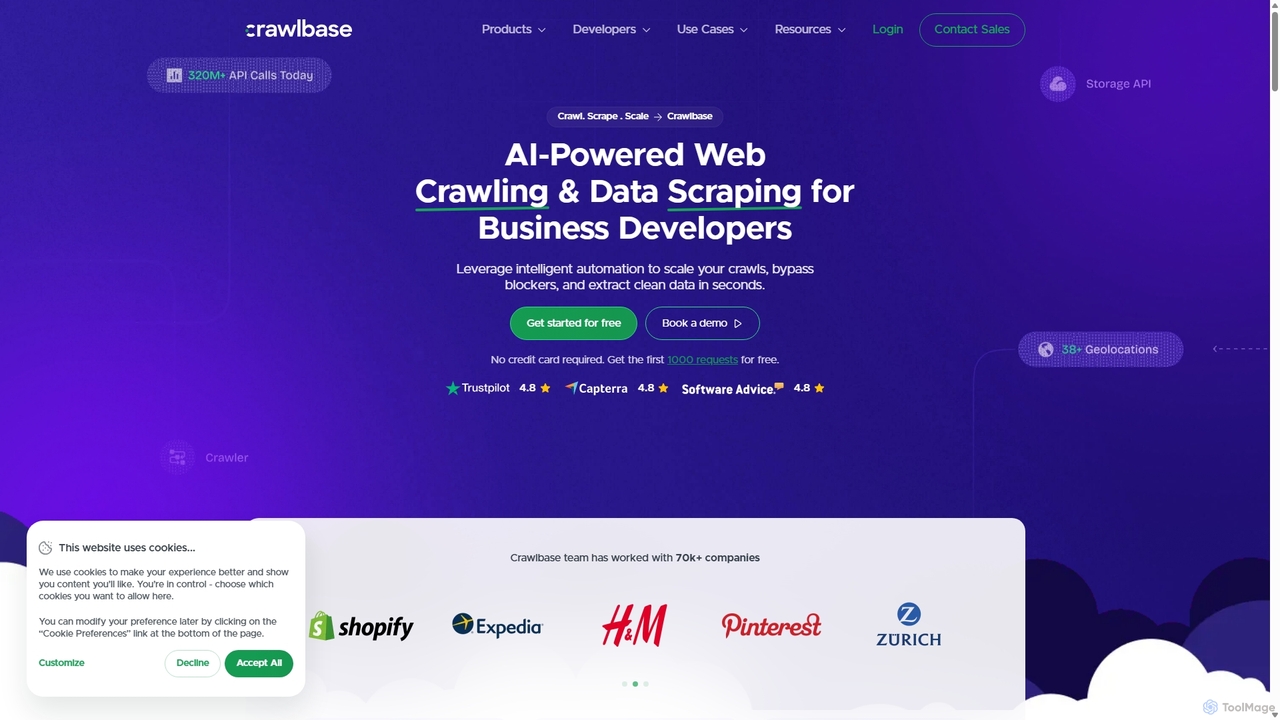
Crawlbase
Crawlbase ist eine KI-gestützte Web-Crawling- und Daten-Scraping-Plattform für Entwickler und Unternehmen. Sie bietet eine Reihe von Tools, einschließlich einer Crawling-API und eines Smart Proxy, um anonym Daten von jeder Website in großem Maßstab zu extrahieren und dabei Blockaden und CAPTCHAs mit hoher Erfolgsquote zu umgehen. Sie vereinfacht die Datenerfassung für SEO, Marktforschung, E-Commerce-Intelligenz und das Training von KI-Modellen.
Datenextraktion
Firecrawl
Firecrawl ist eine Open-Source, entwicklerorientierte API, die jede Website in saubere, LLM-fähige Daten umwandelt. Es bewältigt alle Komplexitäten des Web-Scrapings, einschließlich JavaScript-Rendering, Proxy-Rotation und Ratenbegrenzungen, und ermöglicht es Ihnen, KI-Anwendungen, Agenten und RAG-Systeme mit zuverlässigen Web-Inhalten zu versorgen. Es bietet Scraping-, Crawling- und Suchfunktionen über eine einfache API.
Datenerfassung
CapMonster Cloud
CapMonster Cloud ist ein KI-gestützter Dienst zur automatischen Lösung verschiedener CAPTCHAs, einschließlich reCAPTCHA, Cloudflare und GeeTest. Er bietet Hochgeschwindigkeits- und kostengünstige Lösungen für Entwickler, SEO-Spezialisten und Datenanalysten über eine einfache API und Browser-Erweiterungen, um Web-Automatisierung und Datenextraktionsaufgaben zu optimieren.
API & Integration
UseScraper
UseScraper ist eine leistungsstarke Web-Crawler- und Scraper-API, die für Entwickler und KI-Anwendungen konzipiert wurde. Sie extrahiert effizient Daten von jeder Website und bietet vollständiges JavaScript-Rendering, eine automatisch skalierende Infrastruktur und saubere Ausgabeformate wie Markdown, ideal zur Einspeisung von Daten in LLMs wie ChatGPT.
Datenextraktion
922proxy
922proxy ist ein führender Anbieter von Residential-Proxy-Diensten und bietet über 200 Millionen echte private IP-Adressen in mehr als 190 Ländern. Das Unternehmen ist spezialisiert auf die Bereitstellung hochreiner, stabiler und anonymer SOCKS5-Proxys für verschiedene Geschäftsanforderungen, einschließlich Web-Scraping, E-Commerce-Management, Anzeigenüberprüfung, SEO-Überwachung und Social-Media-Marketing. Mit Unterstützung für alle gängigen Betriebssysteme und nahtloser Integration in Anti-Detect-Browser gewährleistet 922proxy einen zuverlässigen und sicheren Datenzugriff.
Web Scraping
Crawlora
Crawlora ist eine KI-gestützte No-Code-Web-Scraping-Plattform, die es Benutzern ermöglicht, mühelos Daten von jeder Website zu extrahieren. Die intelligente Point-and-Click-Oberfläche vereinfacht die Datenextraktion und ermöglicht es Ihnen, Webseiten in strukturierte Daten (CSV, JSON) umzuwandeln, ohne eine einzige Zeile Code zu schreiben. Ideal für Marktforschung, Lead-Generierung und Preisüberwachung.
DatenextraktionScrapingBee
ScrapingBee ist eine leistungsstarke Web-Scraping-API, die Headless-Browser und Proxy-Rotation handhabt, um Blockierungen zu vermeiden. Sie verfügt über einen innovativen KI-gestützten Extraktor, mit dem Sie die benötigten Daten in einfachem Englisch beschreiben können, wodurch komplexe CSS-Selektoren überflüssig werden. Ideal für Entwickler, Vermarkter und Datenanalysten für Aufgaben wie Preisüberwachung, Lead-Generierung und SERP-Analyse.
Datenextraktion
Crawlbase Comments (0)
Sign in to comment.
AnmeldenNo comments yet.