
Fireworks AI Overview
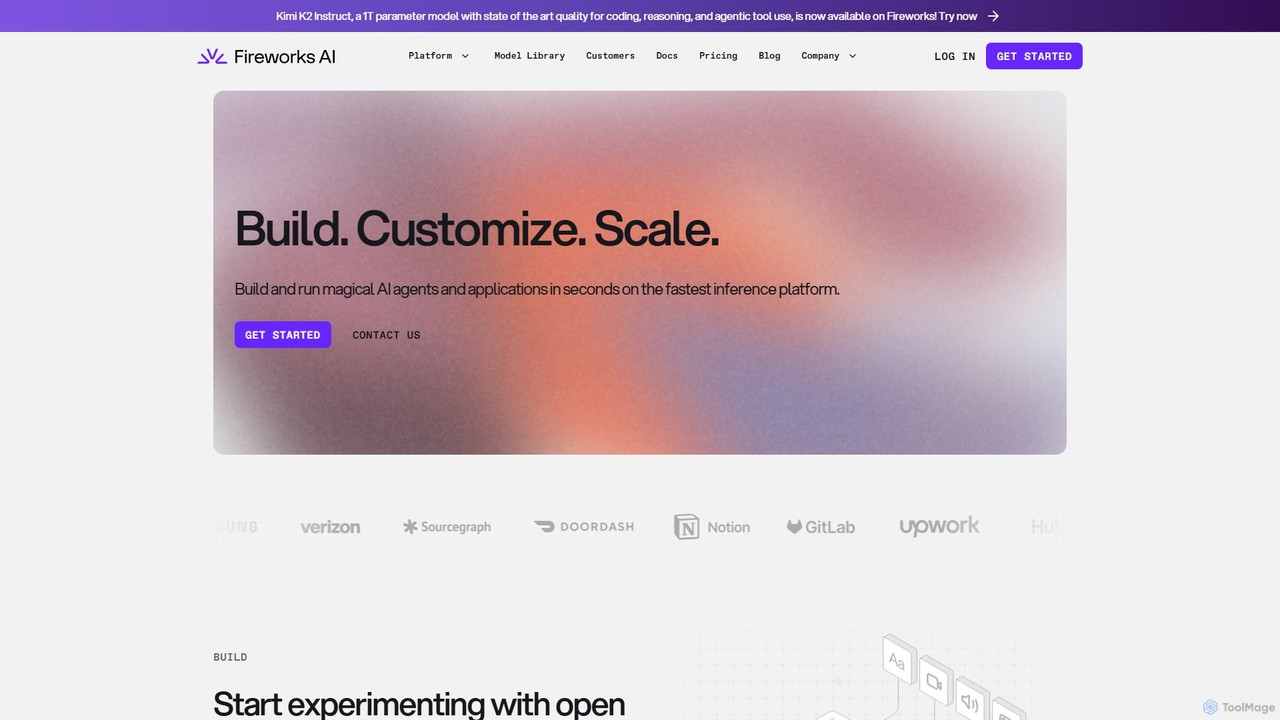
Fireworks AI ist eine hochmoderne Entwicklerplattform, die darauf ausgelegt ist, generative KI-Anwendungen mit beispielloser Geschwindigkeit und Effizienz zu erstellen, anzupassen und zu skalieren. Sie positioniert sich als die schnellste Inferenzplattform und befähigt Entwickler und Unternehmen, Open-Source-KI-Modelle wie Llama, Mistral, DeepSeek und Qwen mit nur wenigen Codezeilen auszuführen und feinabzustimmen. Die Plattform basiert auf einer hochoptimierten Inferenz-Engine, FireAttention, die Echtzeitleistung, minimale Latenz und hohen Durchsatz liefert und somit ideal für geschäftskritische Anwendungen ist. Fireworks AI abstrahiert die Komplexität des GPU-Managements, sodass sich Benutzer auf die Entwicklung innovativer KI-Produkte konzentrieren können.
Wie man Fireworks AI verwendet
Die Verwendung von Fireworks AI ist ein optimierter Prozess für Entwickler. Zuerst melden Sie sich auf der Website an, um Zugang zur Plattform zu erhalten und anfängliche kostenlose Guthaben zu bekommen. Anschließend können Sie die intuitiven SDKs verwenden oder direkte API-Aufrufe tätigen, um mit Hunderten von vorab unterstützten offenen Modellen zu experimentieren. Die Plattform ist OpenAI-kompatibel, was die Migration erleichtert. Für benutzerdefinierte Anforderungen können Sie Ihre Daten hochladen, um ein Modell mit fortschrittlichen Techniken wie Supervised Fine-Tuning (SFT) oder Reinforcement Fine-Tuning (RFT) feinabzustimmen. Sobald Ihr Modell fertig ist, können Sie es mit einer der flexiblen Bereitstellungsoptionen bereitstellen: Serverless für eine einfache, Pay-per-Token-Nutzung ohne Kaltstarts oder On-Demand-Deployments für dedizierte GPU-Ressourcen, die höhere Ratenlimits und niedrigere Kosten bei Skalierung bieten.
Kernfunktionen von Fireworks AI
- Blitzschnelle Inferenz-Engine: Angetrieben von der proprietären FireAttention-Engine, bietet sie branchenführende Geschwindigkeit, niedrige Latenz und hohen Durchsatz und übertrifft Standard-Inferenz-Engines wie vLLM deutlich.
- Umfangreiche Open-Model-Bibliothek: Sofortiger Zugriff auf Hunderte beliebter Open-Source-Modelle für Text, Vision, Audio und Bildgenerierung, einschließlich Llama 3.1, Mixtral, Qwen und DeepSeek. Benutzer können auch benutzerdefinierte Modelle hochladen.
- Erweiterte Feinabstimmung & Anpassung: Bietet anspruchsvolle Werkzeuge zur Modellanpassung, einschließlich Supervised Fine-Tuning (SFT), Reinforcement Fine-Tuning (RFT) und quantisierungsbewusstem Tuning, um maximale Qualität für spezifische Anwendungsfälle zu erzielen.
- Multi-LoRA-Serving: Stellen Sie Hunderte von feinabgestimmten LoRA-Adaptern auf einer einzigen Bereitstellung ohne zusätzliche Serving-Kosten bereit, was eine effiziente Massenpersonalisierung und Experimente ermöglicht.
- Flexible Bereitstellungsoptionen: Bietet Serverless (Pay-per-Token), On-Demand (Pay-per-GPU-Sekunde) und Enterprise Reserved Kapazitäten, um verschiedenen Skalen und Anforderungen gerecht zu werden, vom Prototyping bis zur groß angelegten Produktion.
- Multimodale Fähigkeiten: Unterstützt eine breite Palette von KI-Aufgaben, einschließlich Textgenerierung, Sprache-zu-Text-Transkription, Bildgenerierung und Sprach-Bild-Verständnis.
- Compound AI & Strukturierte Ausgaben: Funktionen wie Function Calling, JSON-Modus und Grammatikmodus ermöglichen den Aufbau komplexer, zuverlässiger KI-Systeme, die mit anderen Werkzeugen und APIs interagieren können.
- Unternehmenssicherheit & Skalierbarkeit: SOC2 Typ II, DSGVO und HIPAA-konform, mit globaler Bereitstellung in über 10 Clouds und 15 Regionen für hohe Verfügbarkeit und nahtlose Skalierung.
Anwendungsfälle für Fireworks AI
Führende Unternehmen wie Notion, Sourcegraph und Quora vertrauen für verschiedene Anwendungen auf Fireworks AI. Häufige Anwendungsfälle sind:
- Echtzeit-KI-Agenten: Erstellung hochreaktiver Sprachagenten und Chatbots mit minimaler Latenz.
- KI-gestützte Entwicklerwerkzeuge: Erstellung fortschrittlicher Codierungsassistenten wie Sourcegraphs Cody mit schneller Code-Vervollständigung und KI-gestützter Suche.
- Enterprise RAG-Systeme: Betreiben von groß angelegten Retrieval-Augmented Generation (RAG)-Workflows, wie bei Notion, um genaue, kontextbezogene Antworten zu liefern.
- Personalisierte KI im großen Maßstab: Bereitstellung von Tausenden von benutzerdefinierten Modellen für verschiedene Benutzer oder Domänen, wie z. B. die domänenspezifischen Grundlagenmodelle von Quora.
- Hochdurchsatz-Medienverarbeitung: Durchführung schneller Audio-Transkription und Bildgenerierung für Content-Erstellungs- und Analyseplattformen.
Vorteile von Fireworks AI
Der Hauptvorteil von Fireworks AI ist seine extreme Leistung. Testimonials heben signifikante Latenzreduzierungen hervor (z. B. von 2 Sekunden auf 350 ms bei Notion), die Echtzeit-Benutzererlebnisse ermöglichen. Die Kosteneffizienz ist ein weiterer wichtiger Vorteil, der durch eine optimierte Engine und innovative Funktionen wie Multi-LoRA-Serving erreicht wird. Die Plattform bietet tiefgreifende Anpassungsmöglichkeiten ohne die übliche Komplexität und macht fortschrittliche KI zugänglich. Schließlich ermöglicht der entwicklerzentrierte Ansatz mit robusten SDKs, umfangreicher Dokumentation und nahtloser Skalierbarkeit den Teams, schnell und zuverlässig von der Idee zur Produktion zu gelangen.
Preise und Pläne
Fireworks AI arbeitet nach einem Freemium-, Pay-as-you-go-Modell, beginnend mit 1 $ kostenlosem Guthaben für neue Benutzer. Die Preisgestaltung ist nach Dienstleistungen aufgeschlüsselt:
- Serverless-Inferenz: Abrechnung pro 1 Million Token, wobei die Raten je nach Modellgröße variieren (z. B. 0,20 $ für 4B-16B-Modelle, 0,90 $ für >16B-Modelle).
- Feinabstimmung: Abrechnung pro 1 Million Trainings-Token (z. B. 0,50 $ für Modelle mit bis zu 16B Parametern). Das Servieren von feinabgestimmten Modellen kostet dasselbe wie die Basismodelle.
- Sprache-zu-Text: Preis pro Audiominute (z. B. Whisper-v3-large für 0,0015 $/min).
- Bildgenerierung: Abrechnung pro Schritt oder pro Bild, je nach Modell.
- On-Demand-Deployments: Bezahlung pro GPU-Sekunde für dedizierte Hardware wie NVIDIA H100 (5,80 $/Stunde) oder A100 (2,90 $/Stunde), was einen höheren Durchsatz und keine Ratenlimits bietet.
Diese flexible Struktur ermöglicht es den Benutzern, die Kosten basierend auf ihren spezifischen Nutzungsmustern und ihrer Skalierung zu optimieren.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 284.6K
- 2026-1: 355.9K
- 2026-2: 323.2K
- 2026-3: 438.1K
- 2026-4: 720.8K
- 2026-5: 610.7K
Geography
Top 5 countries / regions
- 🇺🇸Vereinigte Staaten55.9%
- 🇻🇳Vietnam15.8%
- 🇮🇳Indien11.5%
- 🇷🇺Russland9.3%
- 🇨🇳China7.5%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 90.6% |
Referral | 7.1% |
Email | 2.3% |
Top keywords
| Keyword | Cost per click |
|---|---|
| baseten | $4.41 |
| fireworks | $0.00 |
| fireworks ai | $0.00 |
| fireworks ai careers | $0.00 |
| kimi ai | $0.38 |
Fireworks AI Videos on YouTube




Fireworks AI

Fireworks AI
Fireworks AI Alternatives
thundercompute
Thunder Compute bietet eine extrem kostengünstige GPU-Cloud-Plattform, die für KI- und Machine-Learning-Entwickler entwickelt wurde. Sie stellt On-Demand-GPU-Instanzen wie die NVIDIA A100 und T4 zu Preisen bereit, die bis zu 80 % niedriger sind als bei großen Cloud-Anbietern. Mit Funktionen wie Ein-Klick-Setup, VS-Code-Integration und nahtloser Skalierbarkeit vereinfacht es den Entwicklungsworkflow vom Prototyping bis zur Produktion drastisch und ermöglicht es Entwicklern, sich auf die Erstellung von Modellen statt auf die Verwaltung der Infrastruktur zu konzentrieren.
Maschinelles Lernen
Predibase
Predibase ist eine End-to-End-Entwicklerplattform für das effiziente Fine-Tuning und Bereitstellen von Open-Source Large Language Models (LLMs). Sie ermöglicht es Benutzern, benutzerdefinierte KI-Modelle zu erstellen, die große proprietäre Modelle wie GPT-4 bei spezifischen Aufgaben übertreffen und dabei die Kosten und die Inferenzlatenz erheblich reduzieren. Die Plattform bietet fortschrittliche Techniken wie Reinforcement Fine-Tuning (RFT) und LoRAX für Hochgeschwindigkeits-Multi-Modell-Serving.
Maschinelles Lernen
Unsloth
Unsloth ist eine leistungsstarke Open-Source-Bibliothek, die entwickelt wurde, um das Fine-Tuning von Großen Sprachmodellen (LLMs) drastisch zu beschleunigen. Sie ermöglicht ein bis zu 30x schnelleres Training bei bis zu 90% weniger Speicherverbrauch und macht so die fortgeschrittene Anpassung von KI-Modellen auf Standardhardware zugänglich.
Maschinelles Lernen
Paperspace
Paperspace ist eine hochleistungsfähige Cloud-Computing-Plattform für KI und maschinelles Lernen. Sie bietet mühelosen Zugriff auf leistungsstarke Cloud-GPUs, verwaltete Jupyter-Notebooks und eine vollständige MLOps-Plattform (Gradient) zum Erstellen, Trainieren und Bereitstellen von Modellen. Ideal für Entwickler, Datenwissenschaftler und Unternehmen, die ihre KI-Workflows ohne die Komplexität der Infrastrukturverwaltung beschleunigen möchten.
Maschinelles Lernen
FinetuneDB
FinetuneDB ist eine All-in-One-KI-Fine-Tuning-Plattform für Entwickler. Sie vereinfacht den gesamten Workflow zur Erstellung benutzerdefinierter Large Language Models (LLMs), von der Erstellung hochwertiger Datensätze und dem Fine-Tuning von Modellen wie Llama 3 und GPT-4o mini bis hin zur Bereitstellung und kontinuierlichen Evaluierung auf einer einzigen, sicheren Plattform.
LlmopsFireworks AI Categories
Fireworks AI Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Predibase
Predibase ist eine End-to-End-Entwicklerplattform für das effiziente Fine-Tuning und Bereitstellen von Open-Source Large Language Models (LLMs). Sie ermöglicht es Benutzern, benutzerdefinierte KI-Modelle zu erstellen, die große proprietäre Modelle wie GPT-4 bei spezifischen Aufgaben übertreffen und dabei die Kosten und die Inferenzlatenz erheblich reduzieren. Die Plattform bietet fortschrittliche Techniken wie Reinforcement Fine-Tuning (RFT) und LoRAX für Hochgeschwindigkeits-Multi-Modell-Serving.
Maschinelles Lernen
Together AI
Together AI ist eine führende Cloud-Plattform für Entwickler, die eine schnelle und kostengünstige Infrastruktur zum Ausführen, Feinabstimmen und Trainieren von Open-Source-Generative-AI-Modellen bereitstellt. Sie bietet eine umfangreiche Bibliothek mit über 200 Modellen, serverlose Inferenz-APIs, anpassbares Fine-Tuning und dedizierte GPU-Cluster und schafft so eine End-to-End-Lösung für die Erstellung und Skalierung von KI-Anwendungen.
GPU-Infrastruktur
MonsterAPI
MonsterAPI ist eine entwicklerzentrierte Plattform, die das Finetuning und die Bereitstellung von Open-Source-Generative-AI-Modellen vereinfacht. Sie bietet eine No-Code-Chat-Schnittstelle, MonsterGPT, zur Verwaltung komplexer Aufgaben und unterstützt Modelle wie Llama, SDXL und Whisper. Die Plattform stellt skalierbare API-Endpunkte und GPU-Infrastruktur auf Unternehmensebene zu einem Bruchteil der üblichen Kosten und Zeit zur Verfügung und macht fortschrittliche KI für alle Entwickler zugänglich.
Plattform als Dienst (PaaS)Unsloth
Unsloth ist eine leistungsstarke Open-Source-Bibliothek, die entwickelt wurde, um das Fine-Tuning von Großen Sprachmodellen (LLMs) drastisch zu beschleunigen. Sie ermöglicht ein bis zu 30x schnelleres Training bei bis zu 90% weniger Speicherverbrauch und macht so die fortgeschrittene Anpassung von KI-Modellen auf Standardhardware zugänglich.
Maschinelles LernenFinetuneDB
FinetuneDB ist eine All-in-One-KI-Fine-Tuning-Plattform für Entwickler. Sie vereinfacht den gesamten Workflow zur Erstellung benutzerdefinierter Large Language Models (LLMs), von der Erstellung hochwertiger Datensätze und dem Fine-Tuning von Modellen wie Llama 3 und GPT-4o mini bis hin zur Bereitstellung und kontinuierlichen Evaluierung auf einer einzigen, sicheren Plattform.
Llmops
Mistral AI
Mistral AI ist ein führendes KI-Unternehmen, das Open-Source- und hochleistungsfähige große Sprachmodelle (LLMs) anbietet. Es bietet einen vielseitigen KI-Assistenten, Le Chat, und eine leistungsstarke Entwicklerplattform, La Plateforme, die sich auf Konfigurierbarkeit, Effizienz und Datenschutz für Einzelpersonen und Unternehmen konzentriert.
Unternehmenslösungen
fal.ai
Eine generative Medienplattform für Entwickler, die blitzschnelle APIs zum Ausführen und Feinabstimmen fortschrittlicher KI-Modelle für Bilder, Videos und 3D bereitstellt. Greifen Sie auf hochmoderne Modelle mit bis zu 4x schnelleren Inferenzgeschwindigkeiten zu.
API & Infrastruktur
Scale AI
Scale AI ist eine Full-Stack-Plattform, die die KI-Entwicklung durch die Bereitstellung hochwertiger Daten, Modellbewertung und Feinabstimmungsdienste beschleunigt. Sie richtet sich an führende KI-Labore, Unternehmen und Regierungsbehörden und bietet eine umfassende Daten-Engine für RLHF, Datenkennzeichnung und -generierung, um fortschrittliche generative KI und LLMs zu betreiben.
Beschriftung
Cohere
Cohere ist eine sichere, unternehmenstaugliche KI-Plattform, die Entwicklern und Unternehmen Zugang zu fortschrittlichen großen Sprachmodellen bietet. Sie ist spezialisiert auf Textgenerierung, Zusammenfassung, semantische Suche und Retrieval-Augmented Generation (RAG), mit einem starken Fokus auf Datenschutz, Anpassbarkeit durch Feinabstimmung und flexible Bereitstellungsoptionen, einschließlich On-Premises und Private Cloud.
Unternehmenslösungen
AI SDK
Das AI SDK von Vercel ist ein kostenloses, quelloffenes TypeScript-Toolkit zur Erstellung von KI-gestützten Anwendungen. Es bietet eine einheitliche API zur nahtlosen Integration verschiedener großer Sprachmodelle (LLMs) wie OpenAI, Google und Anthropic. Es vereinfacht die Entwicklung mit Funktionen wie Streaming-Antworten, generativen UI-Komponenten und Tool-Aufrufen, sodass Entwickler KI-Funktionen schneller in Frameworks wie Next.js, React und Svelte erstellen und bereitstellen können.
Bibliothek
Muapi
Muapi ist eine leistungsstarke API-Plattform, die entwickelt wurde, um die KI-gestützte Bild- und Videogenerierung zu beschleunigen. Sie bietet Entwicklern und Kreativen einen einheitlichen Zugang zu einer vielfältigen Palette hochmoderner KI-Modelle. Mit Muapi können Sie Funktionen wie Text-zu-Video, Bild-zu-Video, konsistente Charaktererstellung und Stilübertragung einfach in Ihre Anwendungen integrieren. Die Plattform vereinfacht den Entwicklungsprozess, indem sie einen einzigen API-Endpunkt für mehrere fortschrittliche generative KI-Aufgaben bietet, unterstützt durch eine klare Pay-as-you-go-Preisstruktur.
API
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung
Runware
Runware bietet eine leistungsstarke, kostengünstige API für Entwickler zur Integration von generativer KI für die Erstellung von Bildern und Videos. Durch den Einsatz von benutzerdefinierter Hardware und erneuerbarer Energie bietet es branchenführende Inferenzgeschwindigkeiten für über 300.000 Modelle, einschließlich Stable Diffusion, FLUX.1 und Kling. Es ist eine skalierbare, einfach zu bedienende Plattform, die keine ML-Expertise erfordert und für die Entwicklung der nächsten Generation von KI-nativen Anwendungen konzipiert ist.
API-Plattform
Xunfei Spark Agent Development Platform
Eine umfassende One-Stop-Plattform von iFlytek zum Erstellen, Debuggen und Bereitstellen von KI-Agenten. Angetrieben durch das Spark Large Language Model, ermöglicht sie Entwicklern, intelligente Anwendungen über eine Low-Code-Schnittstelle, einen umfangreichen Plugin-Marktplatz und robuste Verwaltungstools zu erstellen, die den gesamten Lebenszyklus des Agenten abdecken.
Agenten-Builder
Astria
Eine auf Entwickler ausgerichtete API-Plattform zur Erstellung benutzerdefinierter generativer KI-Bildmodelle. Astria ist auf Fine-Tuning spezialisiert und ermöglicht es Benutzern, KI auf bestimmte Motive wie Personen, Objekte oder Stile zu trainieren, um hochgradig personalisierte, qualitativ hochwertige Bilder für verschiedene Anwendungen wie KI-Fotoshootings, virtuelle Anproben und Produktfotografie zu erstellen.
API
Fireworks AI Comments (0)
Sign in to comment.
AnmeldenNo comments yet.