
Tensorlake Overview
Tensorlake ist eine umfassende KI-Daten-Cloud, die entwickelt wurde, um die Lücke zwischen rohen, unstrukturierten Daten und fortschrittlichen KI-Anwendungen zu schließen. Sie dient als einheitliche Plattform für Entwickler und Unternehmen, um komplexe Daten aus verschiedenen Quellen – einschließlich PDFs, Bildern, handschriftlichen Notizen und Tabellenkalkulationen – zuverlässig in strukturierte, aufnahmebereite Formate wie JSON oder Markdown umzuwandeln. Dieser Prozess ist entscheidend für die Versorgung von Großen Sprachmodellen (LLMs), die Verbesserung von Retrieval-Augmented Generation (RAG)-Systemen und die Automatisierung kritischer Geschäftsworkflows.
Die Plattform basiert auf zwei Kernsäulen: der Document Ingestion API und den Serverless Workflows. Die Document Ingestion API bietet menschenähnliche Parsing-Fähigkeiten, die das ursprüngliche Layout und die Lesereihenfolge von Dokumenten beibehalten und gleichzeitig Informationen mit hoher Genauigkeit extrahieren. Die Serverless Workflows ermöglichen es Benutzern, vollständig verwaltete End-to-End-Datenverarbeitungspipelines mit Python zu erstellen und bereitzustellen. Diese Workflows sind hoch skalierbar, können Millionen von Dokumenten verarbeiten und sind kosteneffizient, da sie bei Inaktivität auf null herunterskalieren.
Wie man Tensorlake verwendet
Die Verwendung von Tensorlake umfasst einen unkomplizierten, entwicklerzentrierten Workflow:
- Daten hochladen oder verbinden: Beginnen Sie, indem Sie Dateien direkt über die API hochladen oder Ihre vorhandenen Datenquellen verbinden. Die Plattform unterstützt eine Vielzahl von Dateitypen.
- API zur Verarbeitung aufrufen: Verwenden Sie die Document Ingestion API, um Ihre Dateien zu verarbeiten. Sie können entweder den 'Parse'-Endpunkt für die allgemeine Dokumentenkonvertierung oder den 'Extract'-Endpunkt mit einem definierten Pydantic-Schema verwenden, um spezifische, strukturierte Daten in ein JSON-Format zu extrahieren.
- Benutzerdefinierte Workflows erstellen (Optional): Für komplexere Datentransformationen verwenden Sie die Serverless Workflows von Tensorlake. Schreiben Sie Python-Funktionen, um die Schritte Ihrer Datenpipeline zu definieren, wie z. B. das Bereinigen, Anreichern und Weiterleiten der extrahierten Daten an Ihre Datenbanken oder andere Systeme.
- Verarbeitete Daten abrufen: Greifen Sie sofort nach Abschluss des Auftrags auf die transformierten, strukturierten Daten zu oder richten Sie einen Webhook für asynchrone Benachrichtigungen ein. Die Ausgabe ist für die Verwendung in KI-Anwendungen optimiert.
- Mit KI/LLMs integrieren: Speisen Sie die hochwertigen, strukturierten Daten in Ihre RAG-Pipelines, KI-Agenten oder andere maschinelle Lernmodelle ein, um deren Genauigkeit und Fähigkeiten zu verbessern.
Kernfunktionen von Tensorlake
- Document Ingestion API: Parst jeden Dateityp, von handschriftlichen Notizen bis zu komplexen Tabellenkalkulationen, unter Beibehaltung von Layout und Kontext.
- Strukturierte Datenextraktion: Wandelt unstrukturierten Inhalt mit benutzerdefinierten Python-Schemata in saubere JSON- oder Markdown-Chunks um, um eine hochpräzise Extraktion zu ermöglichen.
- Serverless Workflows: Erstellen, bereitstellen und skalieren Sie Python-basierte Datenverarbeitungspipelines, ohne eine Infrastruktur verwalten zu müssen. Workflows skalieren automatisch je nach Bedarf.
- RAG-Optimierung: Erzeugt strukturierte, mit Metadaten angereicherte Datenchunks, die speziell zur Verbesserung der Genauigkeit und Relevanz von Retrieval-Augmented Generation-Systemen optimiert sind.
- Massive Skalierbarkeit: Entwickelt, um über 100.000 Dokumente pro Kunde pro Tag zu verarbeiten und 10.000 Ereignisse pro Sekunde mit extrem niedriger Latenz zu bewältigen.
- Signaturerkennung: Eine integrierte Funktion zur automatischen Erkennung des Vorhandenseins oder Fehlens von Signaturen in Dokumenten, die intelligente Automatisierungsauslöser ermöglicht.
- Sicher und kollaborativ: Bietet rollenbasierte Zugriffskontrolle (RBAC), Namespaces für den Datenschutz und detaillierte Protokolle für volle Transparenz und Compliance.
Anwendungsfälle für Tensorlake
Tensorlake ist ideal für hochriskante Anwendungen, bei denen die Datengenauigkeit von größter Bedeutung ist:
- Fortgeschrittene RAG-Systeme: Erstellen Sie anspruchsvolle Retrieval-Pipelines für LLMs, indem Sie semantische Suche mit strukturierten Filtern aus dem Dokumenteninhalt (z. B. Tabellen, Abbildungen, Metadaten) kombinieren.
- Automatisierung von Finanzdienstleistungen: Verarbeiten Sie Kreditanträge, Steuerprüfungsunterlagen und Finanzberichte, um wichtige Informationen zu extrahieren und die Entscheidungsfindung zu automatisieren.
- Gesundheitsdatenmanagement: Digitalisieren und strukturieren Sie Patientenakten, Laborberichte und medizinische Forschungsarbeiten für Analyse und Compliance.
- Recht und Compliance: Analysieren Sie Verträge, Eigentumsurkunden und rechtliche Einreichungen, um Klauseln zu extrahieren, Risiken zu identifizieren und die Einhaltung sicherzustellen.
- Lieferkette und Logistik: Verarbeiten Sie globale Handelspapiere, Rechnungen und Frachtbriefe, um den Betrieb zu rationalisieren und die Transparenz zu verbessern.
Vorteile von Tensorlake
Tensorlake bietet einen signifikanten Wettbewerbsvorteil:
- Unvergleichliche Genauigkeit: Seine menschenähnlichen Parsing- und strukturierten Extraktionsfähigkeiten liefern qualitativ hochwertige Daten und minimieren Fehler in KI-Modellen.
- Vereinfachte Entwicklung: Der Code-First-, API-gesteuerte Ansatz vereinfacht die Erstellung komplexer Datenpipelines und ermöglicht es Teams, schneller zu bauen.
- Kosteneffiziente Skalierbarkeit: Die serverlose Architektur und die transparente Pay-as-you-go-Preisgestaltung stellen sicher, dass Sie nur für das bezahlen, was Sie nutzen, was die Skalierung wirtschaftlich macht.
- End-to-End-Plattform: Bietet eine einzige, einheitliche Lösung für die Aufnahme, Strukturierung und Orchestrierung und macht fragile Pipelines mit mehreren Werkzeugen überflüssig.
- Flexibilität: Integriert sich nahtlos in beliebte Tools wie LangChain und Qdrant, um bestehende KI-Stacks zu verbessern.
Preise und Pläne
Tensorlake bietet ein transparentes, nutzungsbasiertes Preismodell ohne versteckte Gebühren für Speicher oder Bandbreite.
- Document Ingestion: Ein einfacher On-Demand-Tarif von $0.01 pro Seite.
- Serverless Workflows: Wird pro Sekunde basierend auf den verbrauchten Rechenressourcen abgerechnet:
- Nvidia H100: $0.0009/s
- Nvidia A100: $0.0005/s
- CPU (1 vCPU): $0.00004/s
- Speicher (DDR4): $0.00009/GB/s
- On-Premise: Kundenspezifische Unternehmenspläne sind für die Bereitstellung in Ihrem eigenen Netzwerk verfügbar. Kontaktieren Sie den Vertrieb für Details.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 6.9K
- 2026-1: 50.0K
- 2026-2: 61.4K
- 2026-3: 46.7K
- 2026-4: 46.4K
- 2026-5: 31.5K
Geography
Top 5 countries / regions
- 🇺🇸Vereinigte Staaten55.2%
- 🇳🇬Nigeria15.5%
- 🇻🇳Vietnam11.4%
- 🇮🇩Indonesien9.3%
- 🇮🇳Indien8.5%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 85.3% |
Referral | 8.3% |
Email | 6.3% |
Top keywords
| Keyword | Cost per click |
|---|---|
| opencode omo claude ekvivalent | $0.00 |
| opencode with everything claude code, direct use | $0.00 |
| tensorlaek | $0.00 |
| tensorlake | $6.31 |
| tensorlake documentation | $0.00 |
Tensorlake Alternatives
ScrapeGraphAI
ScrapeGraphAI ist eine KI-gestützte Web-Scraping-API, die unstrukturierte Websites mit einfachen Anweisungen in natürlicher Sprache in saubere, strukturierte JSON-Daten umwandelt. Entwickelt für Entwickler, KI-Agenten und automatisierte Workflows, vereinfacht es die Datenextraktion ohne komplexen Code.
Analysen
boundaryml
boundaryml (BAML) ist eine spezialisierte Programmiersprache und ein Toolkit für Entwickler, um zuverlässig strukturierte Daten aus großen Sprachmodellen (LLMs) zu extrahieren. Es verwandelt komplexes Prompt-Engineering in einen optimierten, codeähnlichen Prozess und gewährleistet typsichere, fehlerkorrigierte Ausgaben über verschiedene LLMs und Programmiersprachen wie Python und TypeScript hinweg. Es wurde entwickelt, um die Zuverlässigkeit zu erhöhen, Kosten zu senken und Entwicklungszyklen für KI-Anwendungen zu beschleunigen.
API
Eventual
Eventual gestaltet die Zukunft der Dateninfrastruktur mit Daft, einer hochleistungsfähigen Open-Source-Abfrage-Engine für multimodale Daten. Sie ermöglicht es Ingenieuren, Bilder, Videos, Audio und Text im Petabyte-Maßstab mit der Einfachheit von SQL zu verarbeiten und so KI- und ML-Workflows drastisch zu beschleunigen, ohne dass tiefgreifende Kenntnisse in verteilten Systemen erforderlich sind.
Maschinelles Lernen
Apify
Apify ist eine Full-Stack-Web-Scraping- und Automatisierungsplattform, die es Entwicklern ermöglicht, Datenextraktionstools, sogenannte 'Actors', zu erstellen, bereitzustellen und zu veröffentlichen. Sie bietet einen riesigen Marktplatz mit vorgefertigten Scrapern für beliebte Websites wie Google Maps, Instagram und TikTok sowie eine robuste Cloud-Infrastruktur zur Erstellung benutzerdefinierter Lösungen. Mit Unterstützung für Python und JavaScript, Open-Source-Bibliotheken und nahtlosen Integrationen vereinfacht Apify die Erfassung von Webdaten in jedem Maßstab.
Datenerfassung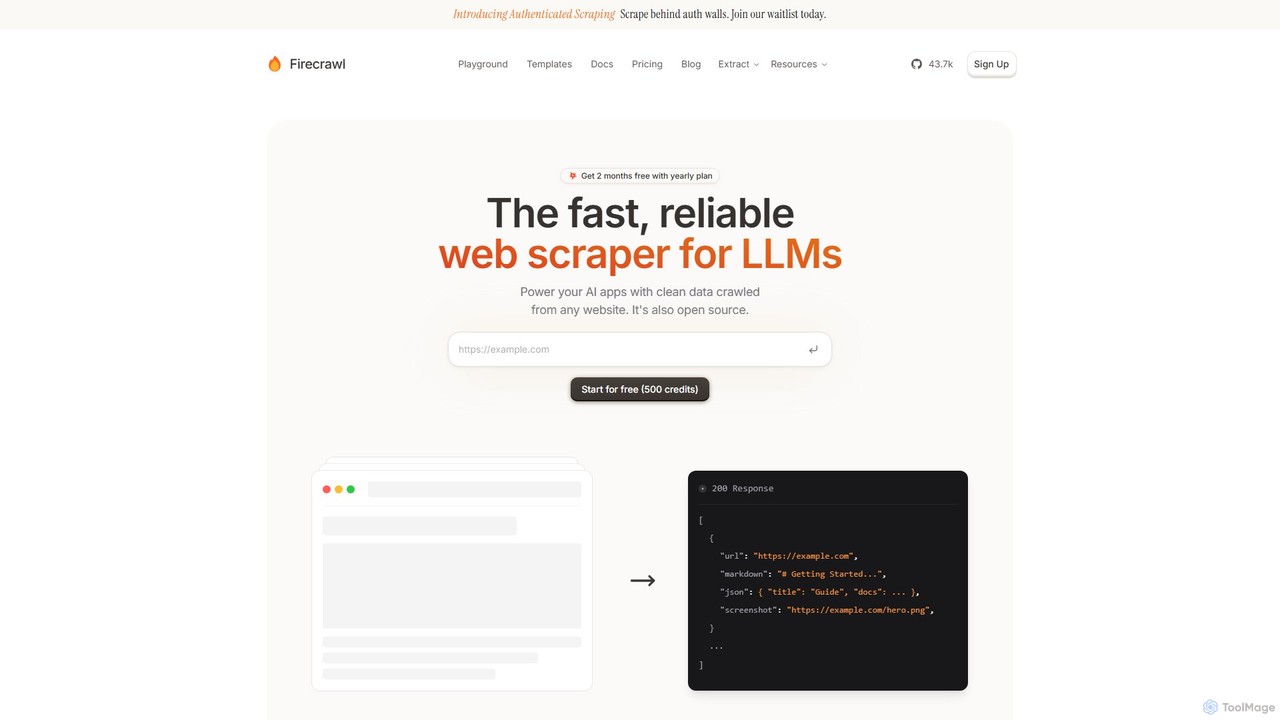
Firecrawl
Firecrawl ist eine Open-Source, entwicklerorientierte API, die jede Website in saubere, LLM-fähige Daten umwandelt. Es bewältigt alle Komplexitäten des Web-Scrapings, einschließlich JavaScript-Rendering, Proxy-Rotation und Ratenbegrenzungen, und ermöglicht es Ihnen, KI-Anwendungen, Agenten und RAG-Systeme mit zuverlässigen Web-Inhalten zu versorgen. Es bietet Scraping-, Crawling- und Suchfunktionen über eine einfache API.
DatenerfassungTensorlake Categories
Tensorlake Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
ScrapeGraphAI
ScrapeGraphAI ist eine KI-gestützte Web-Scraping-API, die unstrukturierte Websites mit einfachen Anweisungen in natürlicher Sprache in saubere, strukturierte JSON-Daten umwandelt. Entwickelt für Entwickler, KI-Agenten und automatisierte Workflows, vereinfacht es die Datenextraktion ohne komplexen Code.
Analysenboundaryml
boundaryml (BAML) ist eine spezialisierte Programmiersprache und ein Toolkit für Entwickler, um zuverlässig strukturierte Daten aus großen Sprachmodellen (LLMs) zu extrahieren. Es verwandelt komplexes Prompt-Engineering in einen optimierten, codeähnlichen Prozess und gewährleistet typsichere, fehlerkorrigierte Ausgaben über verschiedene LLMs und Programmiersprachen wie Python und TypeScript hinweg. Es wurde entwickelt, um die Zuverlässigkeit zu erhöhen, Kosten zu senken und Entwicklungszyklen für KI-Anwendungen zu beschleunigen.
APIApify
Apify ist eine Full-Stack-Web-Scraping- und Automatisierungsplattform, die es Entwicklern ermöglicht, Datenextraktionstools, sogenannte 'Actors', zu erstellen, bereitzustellen und zu veröffentlichen. Sie bietet einen riesigen Marktplatz mit vorgefertigten Scrapern für beliebte Websites wie Google Maps, Instagram und TikTok sowie eine robuste Cloud-Infrastruktur zur Erstellung benutzerdefinierter Lösungen. Mit Unterstützung für Python und JavaScript, Open-Source-Bibliotheken und nahtlosen Integrationen vereinfacht Apify die Erfassung von Webdaten in jedem Maßstab.
DatenerfassungFirecrawl
Firecrawl ist eine Open-Source, entwicklerorientierte API, die jede Website in saubere, LLM-fähige Daten umwandelt. Es bewältigt alle Komplexitäten des Web-Scrapings, einschließlich JavaScript-Rendering, Proxy-Rotation und Ratenbegrenzungen, und ermöglicht es Ihnen, KI-Anwendungen, Agenten und RAG-Systeme mit zuverlässigen Web-Inhalten zu versorgen. Es bietet Scraping-, Crawling- und Suchfunktionen über eine einfache API.
Datenerfassung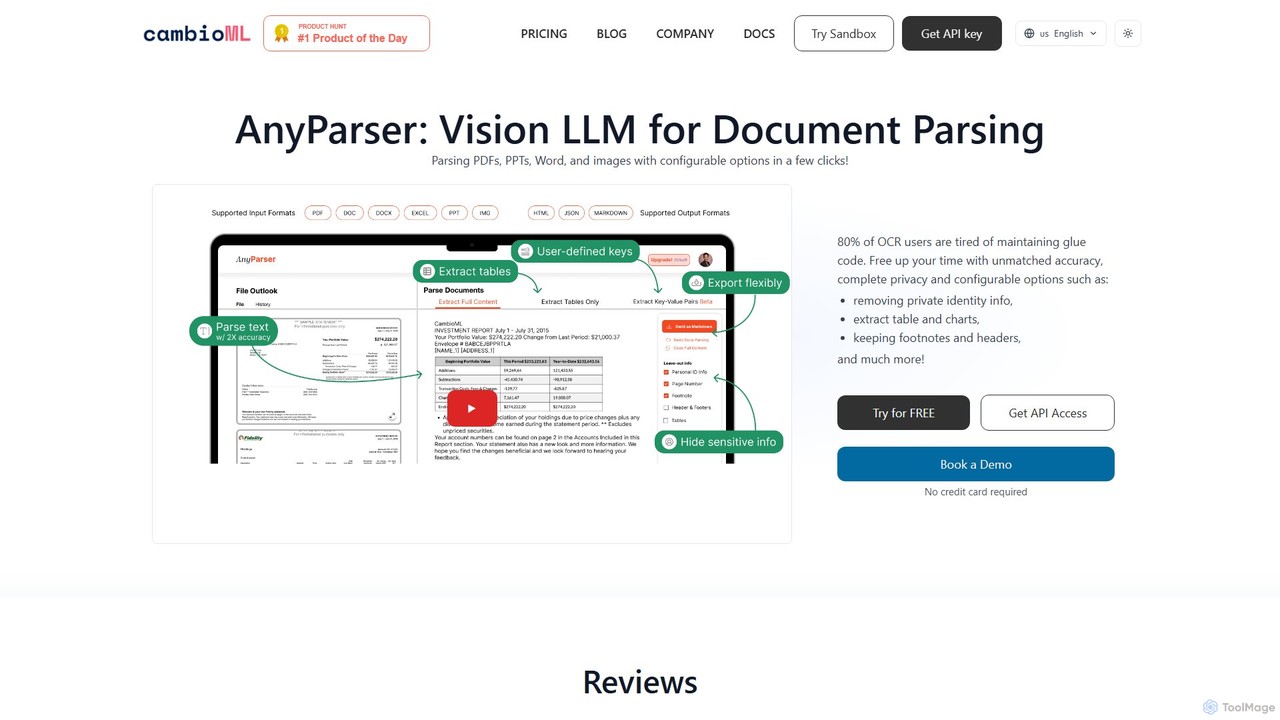
CambioML
CambioML bietet die AnyParser API, ein leistungsstarkes Vision LLM, das für hochpräzises Dokumenten-Parsing entwickelt wurde. Es extrahiert Text, Tabellen, Diagramme und Schlüssel-Wert-Paare aus PDFs, Bildern und Office-Dokumenten. Mit Funktionen wie PII-Schwärzung, konfigurierbaren Ausgaben und Echtzeitverarbeitung ist es ideal für Entwickler und Unternehmen in den Bereichen Finanzen, Forschung und Datenanalyse, um Datenextraktions-Workflows zu automatisieren und dabei Datenschutz und Effizienz zu gewährleisten.
Datenextraktion
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung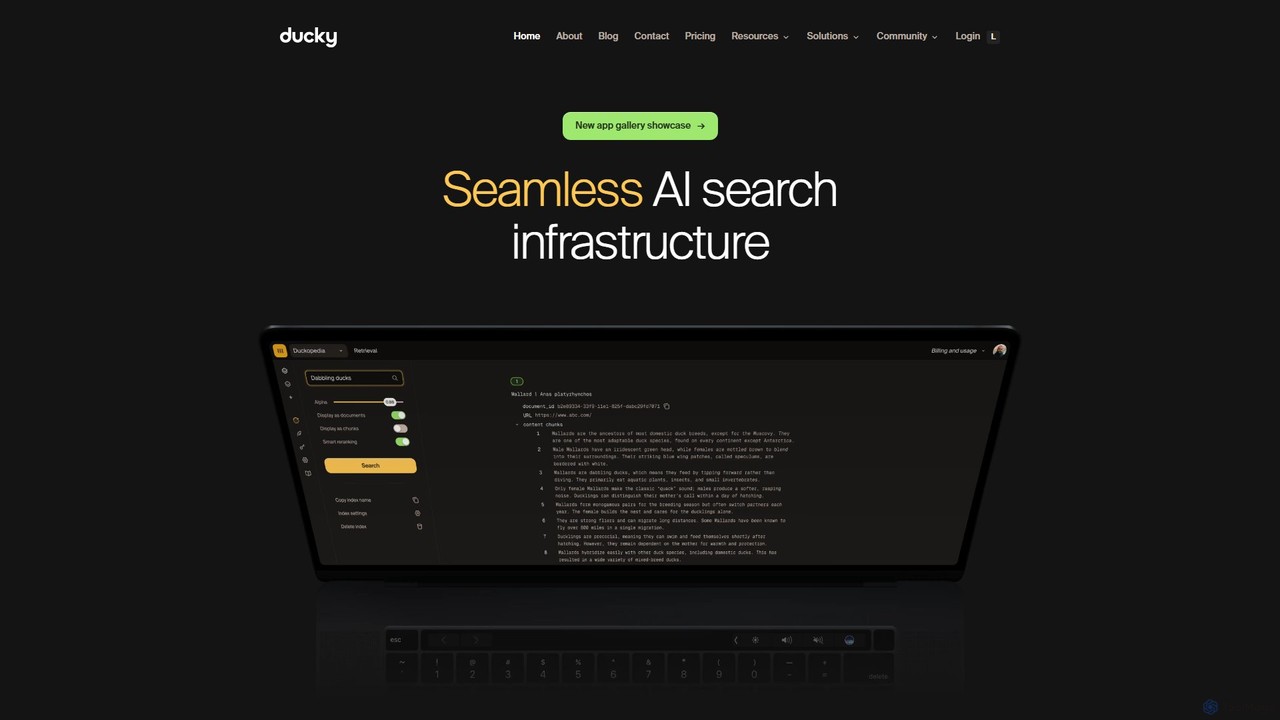
Ducky
Ducky ist eine vollständig verwaltete KI-Suchinfrastruktur für Entwickler. Es vereinfacht die Implementierung von Retrieval-Augmented Generation (RAG), indem es komplexe Aufgaben wie Daten-Chunking, Embedding und Reranking übernimmt. Mit einem einfachen Python-SDK ermöglicht Ducky Entwicklern, schnell präzise und skalierbare semantische Suchfunktionen in ihre Anwendungen zu integrieren und kontextbezogene, halluzinationsfreie Antworten von LLMs zu liefern.
Retrieval-Augmentierte Generierung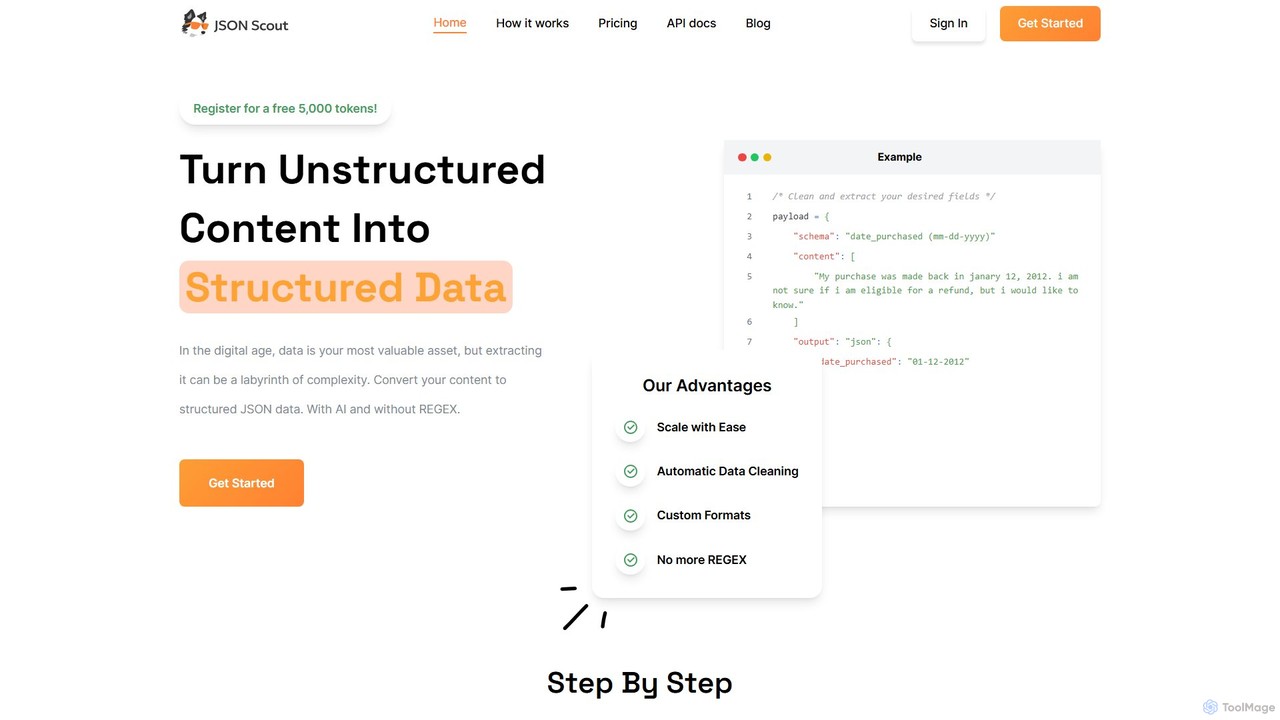
JSON Scout
JSON Scout ist eine KI-gestützte API für Entwickler, die unstrukturierte Text- und Audioinhalte in strukturierte JSON-Daten umwandelt. Es nutzt große Sprachmodelle (LLMs) wie GPT-4o, um die Notwendigkeit komplexer regulärer Ausdrücke (REGEX) zu eliminieren, Entwicklungszeit zu sparen und die Genauigkeit der Datenextraktion zu verbessern.
Datenverarbeitung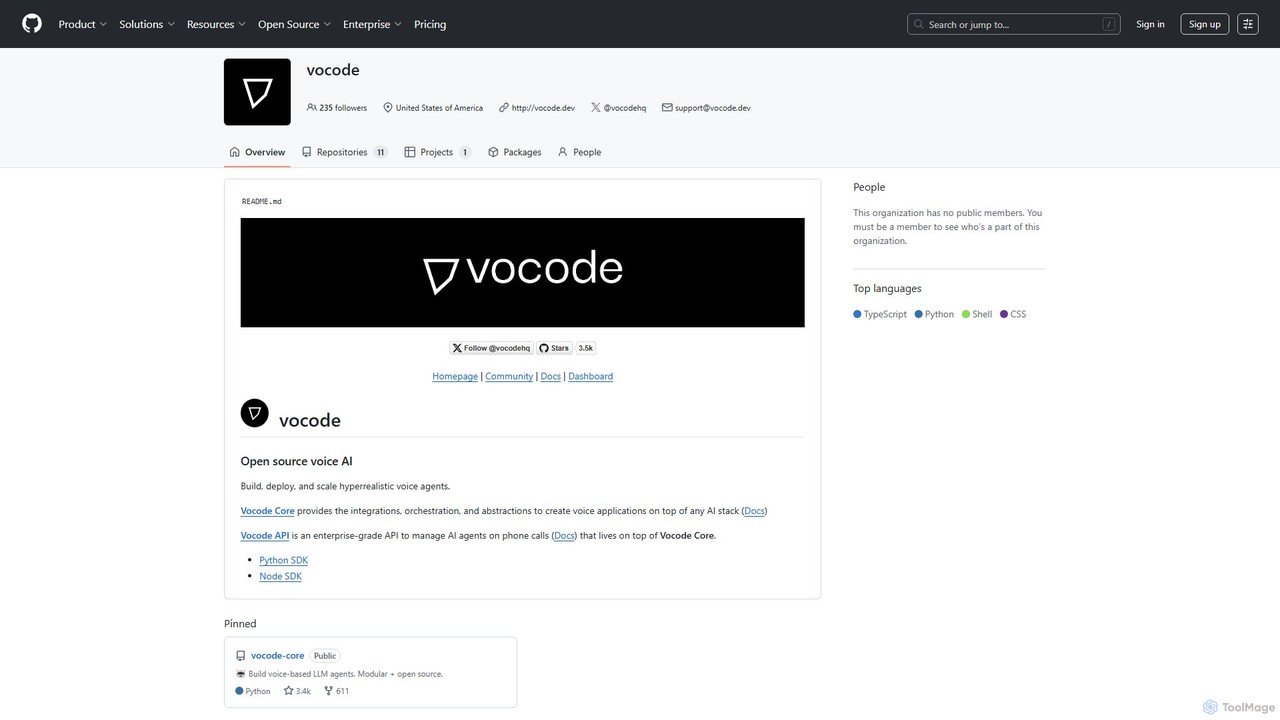
vocode
Vocode ist eine Open-Source-Plattform zum Erstellen, Bereitstellen und Skalieren von hyperrealistischen Sprach-KI-Agenten. Sie bietet Entwicklern ein Kern-Framework und eine unternehmenstaugliche API zur Erstellung anspruchsvoller sprachbasierter LLM-Anwendungen für Aufgaben wie automatisierten Kundenservice, Verkaufsanrufe und interaktive Sprachdialogsysteme (IVR).
Sprachbot
Modal
Modal ist eine hochleistungsfähige, serverlose Infrastrukturplattform für KI- und ML-Entwickler. Sie ermöglicht es Ihnen, Python-Funktionen mit einer einzigen Codezeile in der Cloud auszuführen und bietet sofortigen Zugriff auf GPUs, automatische Skalierung von null auf Tausende von Containern und sekundengenaue Abrechnung. Beseitigen Sie den Infrastrukturaufwand und konzentrieren Sie sich auf die Erstellung und Bereitstellung rechenintensiver Anwendungen wie generative KI, Batch-Verarbeitung und Datenanalyse.
Modellbereitstellung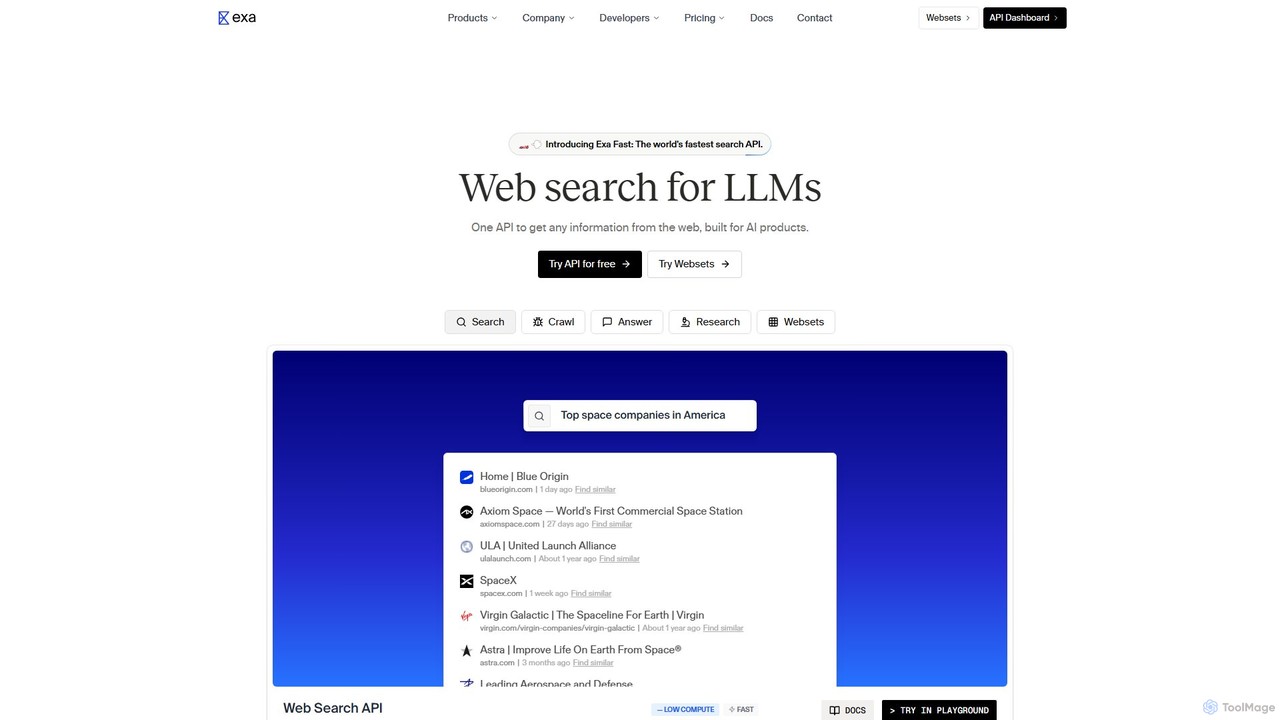
Exa
Exa ist eine KI-native Suchmaschine und API, die für LLMs entwickelt wurde. Sie liefert hochwertige Echtzeit-Webdaten durch semantische Suche, Content-Crawling und agentenbasierte Forschungsfähigkeiten, um KI-Anwendungen zu betreiben, Halluzinationen zu reduzieren und Einblicke zu gewinnen, die traditionelle Suchmaschinen verpassen.
Suchmaschine
Jina AI
Jina AI bietet eine hochmoderne Search Foundation-Plattform mit einer Suite leistungsstarker APIs für multimodale Einbettungen, Reranking und Datenextraktion. Sie wurde für Entwickler und Unternehmen entwickelt, um hochwertige, zuverlässige generative KI, RAG (Retrieval-Augmented Generation) und fortschrittliche Suchanwendungen mit mehrsprachigen und multimodalen Fähigkeiten zu erstellen.
Sprachmodell
Langflow
Langflow ist eine visuelle Open-Source-Benutzeroberfläche zum Erstellen und Bereitstellen von KI-Anwendungen. Es verfügt über eine Drag-and-Drop-Oberfläche, um LLMs, Agenten und Tools zu verketten, was ein schnelles Prototyping und die Bereitstellung komplexer Workflows wie RAG und Multi-Agenten-Systeme ermöglicht. Es unterstützt umfangreiche Integrationen und bietet sowohl selbst gehostete als auch Cloud-Optionen.
Low-Code No-Code
supermemory
supermemory ist eine Speicher-API und Infrastruktur für das KI-Zeitalter, die für Entwickler konzipiert wurde, um LLMs mit einem langlebigen, persistenten Gedächtnis zu erstellen. Es überwindet die Begrenzung des endlichen Kontextfensters und ermöglicht die Erstellung intelligenter, kontextbewusster KI-Agenten, Chatbots und Anwendungen, die sich an vergangene Interaktionen und Informationen über verschiedene Plattformen hinweg erinnern.
LLM
phidata
phidata ist ein Open-Source-Python-Framework zum Erstellen autonomer KI-Assistenten. Es vereinfacht die Integration von LLMs mit Gedächtnis, Wissensdatenbanken und externen Tools und ermöglicht es Entwicklern, mühelos leistungsstarke, zustandsbehaftete KI-Anwendungen zu erstellen.
Frameworks
Tensorlake Comments (0)
Sign in to comment.
AnmeldenNo comments yet.