ToolMage
Iniciar sesión

AI TOOL COMPARISON

Ask On Data vs Datafold

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Resumen del producto

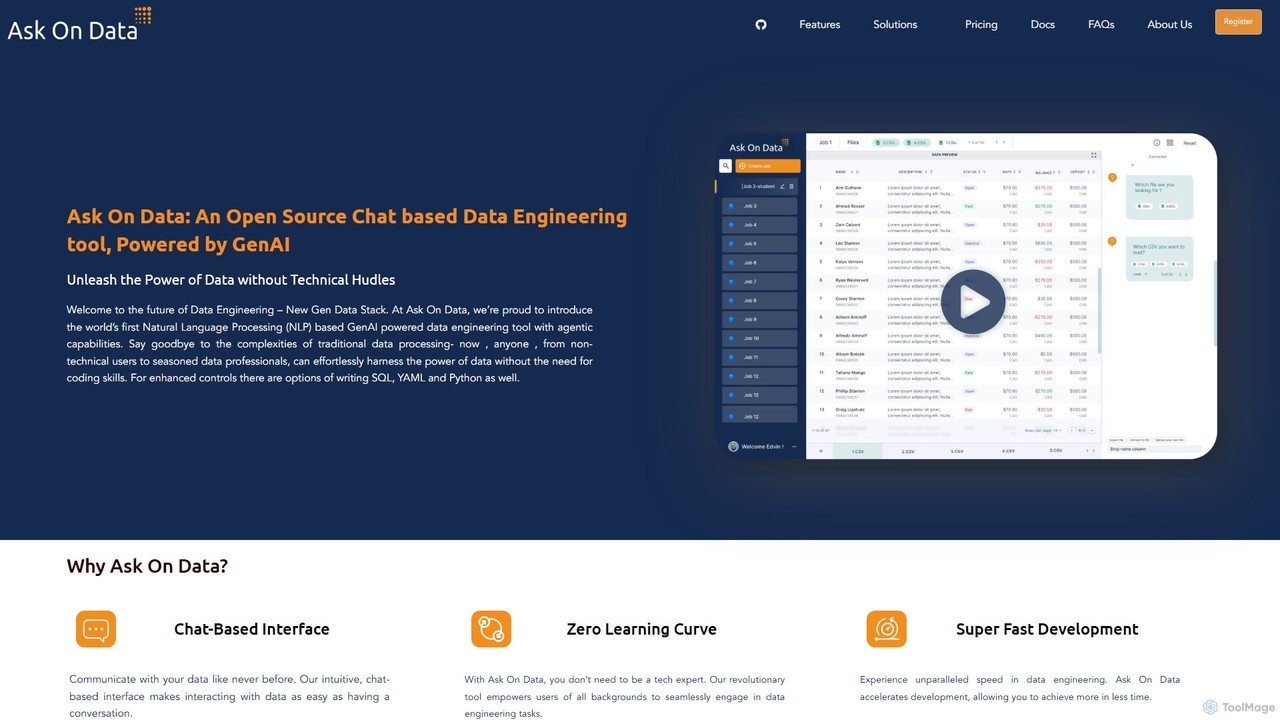
Ask On Data Resumen del producto

Ask On Data es una herramienta de ingeniería de datos de código abierto, impulsada por GenAI, que le permite construir y gestionar pipelines de datos usando una simple interfaz de chat. Al traducir comandos en lenguaje natural a operaciones de datos complejas, elimina la necesidad de codificar, haciendo la ingeniería de datos accesible para todos. Soporta varias fuentes de datos, ofrece vistas previas en tiempo real y proporciona opciones tanto alojadas en la nube como autoalojadas.

Preview

Datafold Resumen del producto

Datafold es una plataforma impulsada por IA para equipos de ingeniería de datos que automatiza las pruebas de calidad de datos, el monitoreo y las migraciones. Utiliza la comparación de datos (data diffing) para comparar conjuntos de datos, permitiendo la detección proactiva de problemas en CI/CD y garantizando una paridad del 100% durante migraciones complejas, acelerando los plazos hasta 6 veces.

Preview

Datos clave

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Ask On Data VS Datafold — Datos clave
Datos claveAsk On DataDatafold
Pricing modelFreemiumPaid
Product typeWebWeb
Primary focusETLAnálisis
Audiencia y rolesSin verificarSin verificar
CategoríasETL · Base de Datos · Procesamiento de Datos · AutomatizaciónAnálisis · Base de Datos · Automatización
Added3 ago 202511 ago 2025
Actualizado19 nov 202619 nov 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Ask On Data

Ask On Data es una revolucionaria herramienta de ingeniería de datos de código abierto que aprovecha la IA Generativa para simplificar y acelerar la creación de pipelines de datos. Introduce una interfaz basada en chat, permitiendo a los usuarios interactuar con sus datos y construir flujos de trabajo complejos usando inglés sencillo. Este enfoque elimina eficazmente las barreras técnicas, democratizando la ingeniería de datos para una amplia gama de usuarios, desde analistas de negocio y científicos de datos hasta ingenieros de datos experimentados. La plataforma está diseñada para ser la pila de datos de próxima generación, haciendo que el procesamiento de datos sea intuitivo, rápido y rentable.

En su núcleo, Ask On Data tiene como objetivo resolver los cuellos de botella comunes en los procesos ETL (Extraer, Transformar, Cargar) tradicionales, como los altos costos, las curvas de aprendizaje pronunciadas y la dependencia de ingenieros especializados. Al proporcionar un asistente de IA para tareas de datos, reduce significativamente el tiempo de desarrollo —hasta en un 92% en comparación con las herramientas convencionales— y capacita a los equipos para que sean más autosuficientes en sus necesidades de preparación de datos.

Cómo usar Ask On Data

Usar Ask On Data es tan simple como tener una conversación. El flujo de trabajo está diseñado para ser intuitivo y no requiere conocimientos previos de codificación:

  1. Conecte su Fuente de Datos: Comience conectándose a sus datos desde una amplia variedad de fuentes, incluyendo archivos planos (CSV, Excel), APIs, bases de datos (como MySQL, PostgreSQL, Firebird), lagos de datos y almacenes de datos (como Amazon Redshift, Snowflake).
  2. Chatee para Transformar: Use la interfaz de chat para emitir comandos en lenguaje natural. Por ejemplo, puede escribir instrucciones como "Unir la tabla A con la tabla B en la columna user_id", "Eliminar filas duplicadas" o "Calcular las ventas totales para cada región".
  3. Previsualice en Tiempo Real: A medida que emite cada comando, Ask On Data proporciona una vista previa instantánea de los datos transformados. Esto le permite validar cada paso de su pipeline y asegurarse de que las operaciones se están realizando como se esperaba.
  4. Valide y Refine: Para usuarios avanzados que necesitan más control, la plataforma ofrece la capacidad de ver, editar e incluso escribir código directamente en SQL o Python. También puede inspeccionar el archivo de configuración YAML subyacente para comprender y ajustar todo el flujo de trabajo.
  5. Programe y Automatice: Una vez que su pipeline de datos esté completo, puede programarlo para que se ejecute en frecuencias específicas (por ejemplo, diariamente, cada hora). Puede configurar detalles del trabajo como cargas completas, cargas incrementales u operaciones de truncar y cargar.
  6. Deshaga y Revise: La plataforma mantiene un historial completo de todas las acciones realizadas. Si comete un error, puede usar fácilmente la funcionalidad de deshacer para revertir los cambios.

Características principales de Ask On Data

  • Interfaz de Chat Impulsada por GenAI: Construya y gestione pipelines de datos simplemente escribiendo instrucciones en inglés sencillo, eliminando la necesidad de codificar.
  • Maestría en Pipelines de Datos: Cree, gestione y optimice sin problemas pipelines de datos de extremo a extremo para la integración, limpieza, manipulación y transformación de datos.
  • Amplio Soporte de Fuentes de Datos: Conéctese a diversas fuentes de datos, incluyendo archivos, APIs, bases de datos, lagos de datos y almacenes de datos.
  • Vista Previa de Datos en Tiempo Real: Vea instantáneamente los resultados de sus transformaciones, lo que permite una validación e iteración rápidas.
  • Control de Código y Transparencia: Para un control mejorado, los usuarios pueden escribir SQL y Python o editar el archivo YAML del pipeline, lo que lo hace adecuado para manejar casos extremos.
  • Programación y Orquestación de Trabajos: Automatice sus flujos de trabajo de datos programando trabajos para que se ejecuten en frecuencias especificadas con opciones de carga detalladas.
  • Historial de Acciones y Deshacer: Rastree fácilmente los cambios y revierta cualquier error con un historial de acciones completo y un simple botón de deshacer.
  • Implementación Flexible: Se ofrece como un servicio en la nube totalmente gestionado o como una versión de código abierto gratuita y autoalojada.

Casos de uso para Ask On Data

Ask On Data es versátil y beneficia a un amplio espectro de usuarios y escenarios:

  • Científicos de Datos e Ingenieros de ML: Preparen y preprocesen conjuntos de datos para modelos de aprendizaje automático de forma independiente, sin esperar a los equipos de ingeniería de datos.
  • Usuarios de BI y Analistas de Datos: Accedan, limpien y transformen directamente los datos para informes y paneles, permitiendo un verdadero análisis de autoservicio.
  • Ingenieros de Datos: Aceleren drásticamente el desarrollo de pipelines complejos de ETL/ELT, liberando tiempo para centrarse en tareas más estratégicas.
  • Usuarios de Negocio: Los usuarios no técnicos pueden interactuar con los datos y realizar tareas básicas de preparación de datos sin ningún conocimiento de codificación.
  • Migración de Datos: Migre datos de manera eficiente entre diferentes sistemas, como pasar de bases de datos locales como MySQL o Firebird a almacenes de datos en la nube como Snowflake o Redshift.

Ventajas de Ask On Data

Ask On Data se destaca con varias ventajas clave:

  • Curva de Aprendizaje Cero: La interfaz de chat intuitiva lo hace accesible para cualquiera, independientemente de su formación técnica.
  • Velocidad Inigualable: Acelere el desarrollo de pipelines de datos de días o semanas a solo minutos, logrando ahorros significativos de tiempo y costos.
  • Rentabilidad: Ofrece más del 80% de ahorro de costos en comparación con las herramientas ETL con licencia tradicionales, con un generoso plan gratuito y de código abierto.
  • Democratización de los Datos: Empodera a todos los usuarios dentro de una organización para que trabajen con datos, rompiendo silos y cuellos de botella.
  • Flexibilidad y Control: Equilibra la simplicidad sin código con el control opcional basado en código para una máxima flexibilidad.

Precios y planes

Ask On Data ofrece varios planes para adaptarse a diferentes necesidades:

  • Código Abierto: Una versión completamente gratuita y autoalojada que incluye soporte para todas las bases de datos, funciones de programación y soporte comunitario. Los usuarios son responsables de los parches y actualizaciones manuales.
  • Gratuito (Nube Gestionada): Un plan gratuito alojado en la nube, ideal para uso a pequeña escala. Admite archivos de Excel y CSV (límite de hasta 5 MB) e incluye actualizaciones automáticas, pero no tiene programación de trabajos.
  • Empresarial: Un plan premium en la nube gestionada para empresas. Incluye soporte para todas las fuentes de datos, programación, soporte de nivel empresarial, actualizaciones automáticas, copias de seguridad y monitoreo. El precio es personalizado; las partes interesadas deben contactar al soporte.

Datafold

Datafold es una plataforma unificada para la calidad de datos proactiva, diseñada específicamente para potenciar a los equipos de ingeniería de datos. Aborda los aspectos más críticos y desafiantes de los flujos de trabajo de datos modernos: garantizar la integridad absoluta de los datos y agilizar la modernización de la infraestructura de datos. Al aprovechar el poder de la IA, los Modelos de Lenguaje Grandes (LLM) avanzados y su tecnología patentada de "comparación de datos" (data diffing), Datafold automatiza las tareas más propensas a errores y que consumen más tiempo. Esto permite a los equipos construir productos de datos altamente fiables a un ritmo mucho más rápido.

La plataforma se basa en el principio de que la calidad de los datos debe ser una parte proactiva e integral del ciclo de vida del desarrollo, no una ocurrencia tardía reactiva. Proporciona las herramientas necesarias para que las empresas superen las limitaciones de los sistemas heredados y construyan con confianza una pila de datos preparada para la IA con una velocidad y precisión inigualables.

Cómo usar Datafold

Datafold se integra a la perfección en los flujos de trabajo de ingeniería de datos existentes, proporcionando un enfoque estructurado y automatizado para diversas tareas.

Para Migraciones de Datos:

  1. Planificar: Utilice el linaje detallado a nivel de columna para mapear todas las dependencias de datos y evaluar con precisión la complejidad de la migración. Esto crea un plan integral, haciendo que los plazos del proyecto sean predecibles y transparentes.
  2. Traducir: El Agente de Migración de Datafold (DMA), impulsado por IA, convierte automáticamente cualquier dialecto de SQL o lógica de transformación basada en GUI a la sintaxis del sistema de destino (por ejemplo, migrando de Oracle PL/SQL a Snowflake SQL). Emplea un bucle de retroalimentación inteligente para refinar iterativamente el código hasta lograr una paridad funcional perfecta.
  3. Validar: Aquí es donde brilla la capacidad central de "comparación de datos" de Datafold. Realiza una comparación a nivel de valor de cada registro entre los sistemas heredado y nuevo, verificando automáticamente el 100% de la precisión de los datos sin necesidad de muestreo manual o scripts tediosos.
  4. Entregar: Tras una validación exitosa, Datafold genera informes completos y evidencia de comparación de datos auditable. Esto proporciona una prueba concreta de la paridad de los datos, lo que acelera la aprobación de las partes interesadas y permite la retirada segura del sistema heredado.

Para Pruebas de Calidad de Datos en CI/CD:

  1. Integración: Conecte Datafold a su sistema de control de versiones, como GitHub o GitLab.
  2. Pruebas Automatizadas: Cuando un desarrollador abre una solicitud de extracción (pull request) que contiene cambios en el código de transformación de datos (por ejemplo, un modelo dbt), Datafold se activa automáticamente para ejecutar una comparación de datos entre los entornos de desarrollo y producción.
  3. Revisar y Desplegar: Los resultados se publican como un comentario claro y conciso dentro de la solicitud de extracción. Esto permite a los revisores ver el impacto exacto de los cambios del código en los datos a nivel de valor, evitando que los problemas de calidad de los datos lleguen a producción.

Características principales de Datafold

  • Migración de Datos Impulsada por IA (Agente de Migración de Datafold - DMA): Automatiza todo el ciclo de vida de la migración, desde la traducción de código SQL entre dialectos dispares hasta la validación completa de extremo a extremo. Maneja de forma inteligente casos límite complejos, como diferencias en el manejo de tipos de datos, funciones no deterministas y codificación de caracteres, para ofrecer una migración hasta 6 veces más rápida.
  • Comparación de Datos (Data Diffing): Un potente motor de validación que realiza comparaciones eficientes a nivel de valor de conjuntos de datos completos, incluso aquellos con miles de millones de filas. Identifica con precisión cualquier adición, eliminación o modificación para garantizar una paridad de datos del 100%.
  • Pruebas Proactivas de CI/CD: Se integra directamente en el flujo de trabajo de desarrollo (pruebas shift-left) para probar el código de transformación de datos antes del despliegue. Incluye análisis de impacto para visualizar cómo los cambios afectan a las tablas descendentes, los paneles de BI y las canalizaciones de ETL inverso.
  • Monitoreo y Observabilidad de Datos: Proporciona detección de anomalías impulsada por ML para monitorear la salud de los datos en producción. Los usuarios pueden definir monitores como código (YAML) o a través de la interfaz de usuario para métricas, cambios de esquema y comparaciones programadas entre bases de datos, con alertas en tiempo real a través de Slack, PagerDuty y correo electrónico.
  • Linaje a Nivel de Columna: Ofrece un mapa completo de las dependencias de los datos que se extiende más allá del almacén de datos a las herramientas de BI (Tableau, Looker, Power BI) y otras aplicaciones. Esto es crucial para el análisis de impacto, el análisis de causa raíz y el cumplimiento normativo.
  • Pruebas de Replicación de Datos: Valida continuamente los datos entre los sistemas de origen y de destino en las canalizaciones de replicación en curso, asegurando que los datos de misión crítica permanezcan sincronizados y precisos en todo momento.

Casos de uso para Datafold

  • Modernización de la Pila de Datos: Acelere drásticamente las migraciones desde sistemas heredados (por ejemplo, Oracle, Teradata, SQL Server) a plataformas de datos en la nube modernas (por ejemplo, Snowflake, BigQuery, Databricks). Por ejemplo, Faire migró más de 5,000 tablas de Redshift a Snowflake seis meses antes de lo previsto utilizando Datafold.
  • Desarrollo y Pruebas de dbt: Potencie los flujos de trabajo de dbt probando automáticamente cada solicitud de extracción, garantizando que los cambios en los modelos de dbt no introduzcan regresiones en la calidad de los datos.
  • Garantizar la Precisión de los Paneles de BI: Utilice el linaje a nivel de columna para rastrear los datos desde su origen hasta los paneles de BI, asegurando que los informes de negocio se construyan sobre una base de datos fiable y precisa.
  • Validación de Canalizaciones de Replicación: Para las organizaciones que utilizan herramientas de ingesta de datos como Fivetran o Airbyte, Datafold puede programar comparaciones de datos regulares para certificar que los datos en el almacén de destino reflejan perfectamente el origen.

Ventajas de Datafold

  • Velocidad sin Precedentes: Comprime los plazos de migración de años a semanas al automatizar las partes más laboriosas del proceso.
  • Precisión Garantizada: Va más allá de los simples recuentos de filas para una validación exhaustiva a nivel de valor, eliminando el riesgo de pérdida o corrupción de datos.
  • Aumento de la Velocidad del Desarrollador: Detecta errores de datos en una fase temprana del pipeline de CI/CD, capacitando a los ingenieros para entregar código más rápido y con mayor confianza.
  • Proactivo, no Reactivo: Implementa una filosofía "shift-left" para la calidad de los datos, previniendo problemas antes de que puedan impactar los sistemas de producción y las operaciones comerciales.
  • Confianza y Colaboración Mejoradas: Proporciona pruebas auditables e innegables de la calidad de los datos, lo que genera confianza con las partes interesadas del negocio y agiliza las aprobaciones de proyectos.
  • Despliegue Seguro y Flexible: Ofrece múltiples modelos de despliegue (SaaS, VPC de inquilino único, autohospedado) y cumple con los principales estándares como SOC2 Tipo II, GDPR e HIPAA.

Precios y planes

Datafold ofrece precios personalizados adaptados a los requisitos únicos de cada equipo. El modelo de precios se basa principalmente en el número de usuarios y el volumen de tablas que se monitorean y prueban. Si bien la plataforma se vende normalmente como una solución integral, se pueden comprar por separado características específicas, como la conversión y validación de migración única o el linaje a nivel de columna independiente. Para obtener una cotización de precios precisa, los clientes potenciales deben ponerse en contacto con el equipo de ventas de Datafold solicitando una demostración en su sitio web oficial.

Posicionamiento

La taxonomía muestra dónde coinciden los productos y dónde destaca cada uno. Los campos desconocidos se muestran claramente y no se completan con suposiciones.

Categorías

Compartido
Base de DatosAutomatización
Solo Ask On Data
ETLProcesamiento de Datos
Solo Datafold
Análisis

Etiquetas

Compartido
base de datosIngeniería de Datosmigración de datos
Solo Ask On Data
Apache Sparkautomatización de datosPipeline de datosTransformación de datosETLIA Generativalow-codeprocesamiento de lenguaje naturalNo-codeCódigo Abierto
Solo Datafold
automatizaciónCI/CDObservabilidad de datoscalidad de datosPrueba de datosValidación de datosdbtSQL

Audiencia y roles

Compartido
No hay datos verificados
Solo Ask On Data
No hay datos verificados
Solo Datafold
No hay datos verificados

Comparación de tráfico

El tráfico usa la misma escala para reflejar de forma fiel la visibilidad de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Ask On Data monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
1.9K
Duración media
0:00
Páginas por visita
1.04
Tasa de rebote
36.34%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 606
  • 2026-01: 1.7K
  • 2026-02: 731
  • 2026-03: 2K
  • 2026-04: 1.4K
  • 2026-05: 1.9K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States44.3%859
🇿🇦South Africa18.54%359
🇮🇳India18.18%353
🇹🇷Turkey13.82%268
🇲🇽Mexico5.16%100

Palabras clave

askdataask on dataaskondataconvert firebird to postegressqlpostgresql import from firebird

Datafold monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
21K
Duración media
1:16
Páginas por visita
2.13
Tasa de rebote
39.96%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 33.5K
  • 2026-01: 24.6K
  • 2026-02: 19.6K
  • 2026-03: 26.3K
  • 2026-04: 20.8K
  • 2026-05: 21K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States54.41%11.4K
🇻🇳Vietnam13.86%2.9K
🇮🇳India12.19%2.6K
🇹🇭Thailand10.7%2.2K
🇵🇰Pakistan8.84%1.9K

Fuentes de tráfico

Source typePercentageEstimated visits
Directo94.33%19.8K
Referido5.67%1.2K

Palabras clave

data-diffdatafolddbt pythonnutrafol revenueopen source data warehouse

Señales de comunidad

Las valoraciones y reacciones son señales de comunidad, no sustituyen el ajuste del producto.

Ask On Data

Valoración
Sin verificar
Comentarios
0
Favoritos
188
Me gusta
172

Datafold

Valoración
Sin verificar
Comentarios
0
Favoritos
183
Me gusta
182

Ask On Data vs Datafold · Preguntas frecuentes

What do Ask On Data and Datafold have in common?
Both tools are listed under Base de Datos、Automatización. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Ask On Data and Datafold free?
Listed pricing models: Ask On Data — Freemium; Datafold — Paid. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Ask On Data and Datafold?
The primary listed category is ETL for Ask On Data, and Análisis for Datafold. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparativas relacionadas