ToolMage
Iniciar sesión

AI TOOL COMPARISON

Datafold vs nao

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Resumen del producto

Datafold Resumen del producto

Datafold es una plataforma impulsada por IA para equipos de ingeniería de datos que automatiza las pruebas de calidad de datos, el monitoreo y las migraciones. Utiliza la comparación de datos (data diffing) para comparar conjuntos de datos, permitiendo la detección proactiva de problemas en CI/CD y garantizando una paridad del 100% durante migraciones complejas, acelerando los plazos hasta 6 veces.

Preview

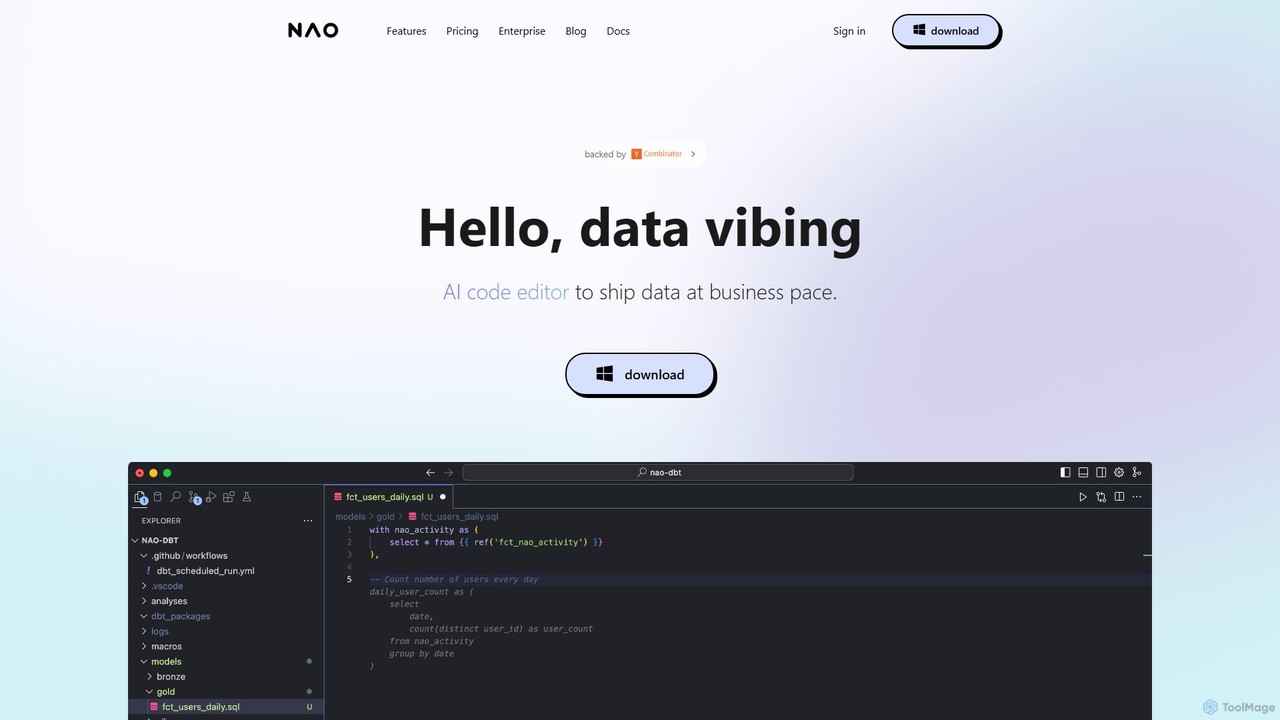
nao Resumen del producto

nao es un editor de código impulsado por IA diseñado para equipos de datos. Agiliza la creación de pipelines de datos en SQL y Python, flujos de trabajo de dbt y análisis al conectarse de forma nativa a su almacén de datos. Su agente inteligente proporciona sugerencias de código conscientes de los datos, controles de calidad y vistas previas de diferencias instantáneas para ayudarle a entregar datos de forma más rápida y segura.

Preview

Datos clave

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Datafold VS nao — Datos clave
Datos claveDatafoldnao
Pricing modelPaidFreemium
Product typeWebApp
Primary focusAnálisisAnálisis
Audiencia y rolesSin verificarSin verificar
CategoríasAnálisis · Base de Datos · AutomatizaciónAnálisis · Base de Datos · Asistente de Código
Added11 ago 20255 ago 2025
Actualizado19 nov 202619 nov 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Datafold

Datafold es una plataforma unificada para la calidad de datos proactiva, diseñada específicamente para potenciar a los equipos de ingeniería de datos. Aborda los aspectos más críticos y desafiantes de los flujos de trabajo de datos modernos: garantizar la integridad absoluta de los datos y agilizar la modernización de la infraestructura de datos. Al aprovechar el poder de la IA, los Modelos de Lenguaje Grandes (LLM) avanzados y su tecnología patentada de "comparación de datos" (data diffing), Datafold automatiza las tareas más propensas a errores y que consumen más tiempo. Esto permite a los equipos construir productos de datos altamente fiables a un ritmo mucho más rápido.

La plataforma se basa en el principio de que la calidad de los datos debe ser una parte proactiva e integral del ciclo de vida del desarrollo, no una ocurrencia tardía reactiva. Proporciona las herramientas necesarias para que las empresas superen las limitaciones de los sistemas heredados y construyan con confianza una pila de datos preparada para la IA con una velocidad y precisión inigualables.

Cómo usar Datafold

Datafold se integra a la perfección en los flujos de trabajo de ingeniería de datos existentes, proporcionando un enfoque estructurado y automatizado para diversas tareas.

Para Migraciones de Datos:

  1. Planificar: Utilice el linaje detallado a nivel de columna para mapear todas las dependencias de datos y evaluar con precisión la complejidad de la migración. Esto crea un plan integral, haciendo que los plazos del proyecto sean predecibles y transparentes.
  2. Traducir: El Agente de Migración de Datafold (DMA), impulsado por IA, convierte automáticamente cualquier dialecto de SQL o lógica de transformación basada en GUI a la sintaxis del sistema de destino (por ejemplo, migrando de Oracle PL/SQL a Snowflake SQL). Emplea un bucle de retroalimentación inteligente para refinar iterativamente el código hasta lograr una paridad funcional perfecta.
  3. Validar: Aquí es donde brilla la capacidad central de "comparación de datos" de Datafold. Realiza una comparación a nivel de valor de cada registro entre los sistemas heredado y nuevo, verificando automáticamente el 100% de la precisión de los datos sin necesidad de muestreo manual o scripts tediosos.
  4. Entregar: Tras una validación exitosa, Datafold genera informes completos y evidencia de comparación de datos auditable. Esto proporciona una prueba concreta de la paridad de los datos, lo que acelera la aprobación de las partes interesadas y permite la retirada segura del sistema heredado.

Para Pruebas de Calidad de Datos en CI/CD:

  1. Integración: Conecte Datafold a su sistema de control de versiones, como GitHub o GitLab.
  2. Pruebas Automatizadas: Cuando un desarrollador abre una solicitud de extracción (pull request) que contiene cambios en el código de transformación de datos (por ejemplo, un modelo dbt), Datafold se activa automáticamente para ejecutar una comparación de datos entre los entornos de desarrollo y producción.
  3. Revisar y Desplegar: Los resultados se publican como un comentario claro y conciso dentro de la solicitud de extracción. Esto permite a los revisores ver el impacto exacto de los cambios del código en los datos a nivel de valor, evitando que los problemas de calidad de los datos lleguen a producción.

Características principales de Datafold

  • Migración de Datos Impulsada por IA (Agente de Migración de Datafold - DMA): Automatiza todo el ciclo de vida de la migración, desde la traducción de código SQL entre dialectos dispares hasta la validación completa de extremo a extremo. Maneja de forma inteligente casos límite complejos, como diferencias en el manejo de tipos de datos, funciones no deterministas y codificación de caracteres, para ofrecer una migración hasta 6 veces más rápida.
  • Comparación de Datos (Data Diffing): Un potente motor de validación que realiza comparaciones eficientes a nivel de valor de conjuntos de datos completos, incluso aquellos con miles de millones de filas. Identifica con precisión cualquier adición, eliminación o modificación para garantizar una paridad de datos del 100%.
  • Pruebas Proactivas de CI/CD: Se integra directamente en el flujo de trabajo de desarrollo (pruebas shift-left) para probar el código de transformación de datos antes del despliegue. Incluye análisis de impacto para visualizar cómo los cambios afectan a las tablas descendentes, los paneles de BI y las canalizaciones de ETL inverso.
  • Monitoreo y Observabilidad de Datos: Proporciona detección de anomalías impulsada por ML para monitorear la salud de los datos en producción. Los usuarios pueden definir monitores como código (YAML) o a través de la interfaz de usuario para métricas, cambios de esquema y comparaciones programadas entre bases de datos, con alertas en tiempo real a través de Slack, PagerDuty y correo electrónico.
  • Linaje a Nivel de Columna: Ofrece un mapa completo de las dependencias de los datos que se extiende más allá del almacén de datos a las herramientas de BI (Tableau, Looker, Power BI) y otras aplicaciones. Esto es crucial para el análisis de impacto, el análisis de causa raíz y el cumplimiento normativo.
  • Pruebas de Replicación de Datos: Valida continuamente los datos entre los sistemas de origen y de destino en las canalizaciones de replicación en curso, asegurando que los datos de misión crítica permanezcan sincronizados y precisos en todo momento.

Casos de uso para Datafold

  • Modernización de la Pila de Datos: Acelere drásticamente las migraciones desde sistemas heredados (por ejemplo, Oracle, Teradata, SQL Server) a plataformas de datos en la nube modernas (por ejemplo, Snowflake, BigQuery, Databricks). Por ejemplo, Faire migró más de 5,000 tablas de Redshift a Snowflake seis meses antes de lo previsto utilizando Datafold.
  • Desarrollo y Pruebas de dbt: Potencie los flujos de trabajo de dbt probando automáticamente cada solicitud de extracción, garantizando que los cambios en los modelos de dbt no introduzcan regresiones en la calidad de los datos.
  • Garantizar la Precisión de los Paneles de BI: Utilice el linaje a nivel de columna para rastrear los datos desde su origen hasta los paneles de BI, asegurando que los informes de negocio se construyan sobre una base de datos fiable y precisa.
  • Validación de Canalizaciones de Replicación: Para las organizaciones que utilizan herramientas de ingesta de datos como Fivetran o Airbyte, Datafold puede programar comparaciones de datos regulares para certificar que los datos en el almacén de destino reflejan perfectamente el origen.

Ventajas de Datafold

  • Velocidad sin Precedentes: Comprime los plazos de migración de años a semanas al automatizar las partes más laboriosas del proceso.
  • Precisión Garantizada: Va más allá de los simples recuentos de filas para una validación exhaustiva a nivel de valor, eliminando el riesgo de pérdida o corrupción de datos.
  • Aumento de la Velocidad del Desarrollador: Detecta errores de datos en una fase temprana del pipeline de CI/CD, capacitando a los ingenieros para entregar código más rápido y con mayor confianza.
  • Proactivo, no Reactivo: Implementa una filosofía "shift-left" para la calidad de los datos, previniendo problemas antes de que puedan impactar los sistemas de producción y las operaciones comerciales.
  • Confianza y Colaboración Mejoradas: Proporciona pruebas auditables e innegables de la calidad de los datos, lo que genera confianza con las partes interesadas del negocio y agiliza las aprobaciones de proyectos.
  • Despliegue Seguro y Flexible: Ofrece múltiples modelos de despliegue (SaaS, VPC de inquilino único, autohospedado) y cumple con los principales estándares como SOC2 Tipo II, GDPR e HIPAA.

Precios y planes

Datafold ofrece precios personalizados adaptados a los requisitos únicos de cada equipo. El modelo de precios se basa principalmente en el número de usuarios y el volumen de tablas que se monitorean y prueban. Si bien la plataforma se vende normalmente como una solución integral, se pueden comprar por separado características específicas, como la conversión y validación de migración única o el linaje a nivel de columna independiente. Para obtener una cotización de precios precisa, los clientes potenciales deben ponerse en contacto con el equipo de ventas de Datafold solicitando una demostración en su sitio web oficial.

nao

nao es un revolucionario editor de código de IA construido desde cero para profesionales de datos. Su objetivo es acelerar todo el flujo de trabajo de datos, desde la escritura de código hasta el despliegue de pipelines, integrándose profundamente con su ecosistema de datos. Diseñado para analistas de datos, ingenieros de análisis, científicos de datos e ingenieros de datos, nao actúa como un socio inteligente, entendiendo el contexto de sus datos para ayudarle a escribir código que no solo es sintácticamente correcto, sino también semánticamente sólido y seguro para su entorno de producción.

A diferencia de los asistentes de código de IA genéricos, nao se conecta directamente a su almacén de datos (soportando plataformas como Databricks, DuckDB y más). Esta integración nativa permite que su IA sea 'consciente de los datos', proporcionando sugerencias basadas en su esquema real, estructuras de tablas y nombres de columnas. Esto elimina las conjeturas y reduce significativamente los errores. El núcleo de nao es su potente agente de IA, que va más allá de la simple finalización de código para convertirse en un guardián de la calidad de sus datos.

Cómo usar nao

Empezar a usar nao es un proceso sencillo, diseñado para integrarse sin problemas en su flujo de trabajo existente:

  1. Descargar e Instalar: Comience descargando el IDE de nao de forma gratuita desde el sitio web oficial. Es una aplicación independiente que se ejecuta en su máquina local.
  2. Conectar su Almacén de Datos: El primer paso crucial es conectar nao a su fuente de datos. Esta conexión segura permite a la IA acceder a los metadatos de su esquema (no a sus datos reales, que permanecen locales) para proporcionar asistencia contextual.
  3. Comenzar a Codificar: Abra una hoja de trabajo de SQL o un script de Python. A medida que escribe, la IA de nao proporciona autocompletado inteligente para consultas SQL y modelos de dbt, consciente de sus tablas y columnas específicas.
  4. Aprovechar el Agente de IA: Use la pestaña de IA dedicada para interactuar con el agente. Puede pedirle que genere consultas complejas, cree modelos de dbt, escriba documentación o agregue pruebas. El agente entiende el contexto de su proyecto, incluidos los modelos de dbt y el linaje a nivel de columna.
  5. Previsualizar y Comparar Diferencias: Antes de confirmar cualquier cambio, utilice la función 'Vista Previa de Diferencias Instantánea'. Esto le muestra el impacto directo que su nuevo código tendrá en los datos, ayudándole a detectar problemas potenciales y a evitar romper cuadros de mando o informes posteriores.
  6. Ejecutar Comprobaciones y Desplegar: El agente puede ejecutar controles de calidad de datos y sus pruebas existentes para validar su código. Una vez que esté seguro, puede entregar sus pipelines de datos más rápido y con mayor confianza.

Características principales de nao

  • Editor de Código Impulsado por IA: Optimizado para SQL y Python con autocompletado inteligente, generación de código y capacidades de análisis conversacional.
  • Integración Nativa con Almacén de Datos: Se conecta directamente a sus fuentes de datos como Databricks y DuckDB para obtener sugerencias de IA conscientes del esquema.
  • Agente de IA Avanzado: Un agente multifacético que ayuda con los controles de calidad de datos, las diferencias de datos instantáneas, la ejecución de pruebas y la comprensión del linaje a nivel de columna.
  • Integración Profunda con dbt: Previsualice modelos de dbt directamente en el IDE, obtenga autocompletado para las columnas del modelo y visualice el gráfico de linaje para entender las dependencias.
  • Vista Previa de Diferencias Instantánea: Vea el impacto de sus cambios de código en los datos en tiempo real, previniendo consecuencias no deseadas.
  • Análisis y Gráficos Conversacionales: Interactúe con sus datos usando lenguaje natural para generar ideas y visualizaciones directamente en el editor.
  • Seguridad de Nivel Empresarial: Sus datos y código permanecen locales. No se comparte nada con un LLM sin permiso explícito, y los planes empresariales ofrecen opciones para LLMs autoalojados para mantener todo dentro de su infraestructura.
  • Entorno de Desarrollo Unificado: Combina las herramientas que ama —editor de SQL, herramienta de transformación (dbt) y linaje de BI— en un único IDE cohesivo.

Casos de uso para nao

nao es versátil y puede aplicarse a numerosas tareas relacionadas con los datos:

  • Desarrollo Acelerado de Pipelines de Datos: Construya e itere rápidamente en pipelines de SQL y Python con código generado por IA y retroalimentación instantánea.
  • Gestión Robusta de Flujos de Trabajo de dbt: Cree, pruebe y documente modelos de dbt de manera más eficiente. Entienda el impacto de los cambios con el linaje a nivel de columna y las vistas previas de los modelos.
  • Análisis de Datos Complejo: Realice análisis sofisticados como distribución, retención, conversión y análisis de causa raíz utilizando indicaciones conversacionales y potentes herramientas de consulta.
  • Aseguramiento de la Calidad de los Datos: Identifique y solucione proactivamente problemas de calidad de datos antes de que afecten a la producción, utilizando los controles automatizados y las diferencias de datos del agente.
  • Refactorización Segura de Código: Refactorice con confianza consultas SQL complejas o modelos de dbt, utilizando la vista previa de diferencias instantánea para asegurar que la salida permanezca consistente.

Ventajas de nao

nao ofrece ventajas significativas sobre los editores de código tradicionales y otros asistentes de IA:

  • Inteligencia Consciente de los Datos: A diferencia de herramientas como Cursor, las sugerencias de nao no son genéricas; están adaptadas a su esquema de datos específico, lo que resulta en un código que funciona correctamente a la primera.
  • Seguridad y Fiabilidad Mejoradas: El enfoque en los controles de calidad de datos, las diferencias y el análisis de impacto del linaje ayuda a prevenir roturas de datos, protegiendo sus cuadros de mando de BI e informes analíticos.
  • Productividad Aumentada: Al unificar múltiples herramientas en un solo IDE y automatizar tareas repetitivas, nao permite a los equipos de datos entregar proyectos significativamente más rápido.
  • Seguridad sin Compromisos: Con un fuerte énfasis en la privacidad de los datos, nao asegura que sus datos sensibles y su código propietario estén seguros, ofreciendo controles de nivel empresarial para una máxima protección.

Precios y planes

nao ofrece una estructura de precios flexible para adaptarse a diferentes necesidades:

  • Plan Starter: Gratis. Este plan incluye una prueba de 15 días de las características Pro, conexión básica al almacén de datos, autocompletado de SQL y vistas previas y linaje de dbt.
  • Plan Pro: $30 por usuario/mes. Incluye todo en el plan Starter, más la pestaña completa de IA en sus datos, el agente de IA completo para flujos de trabajo de datos, diferencias de datos instantáneas y soporte directo.
  • Plan Enterprise: Precios personalizados. Este plan incluye todas las características Pro, más seguridad de datos de nivel empresarial, la opción de LLMs alojados por la empresa, un espacio de trabajo empresarial y un equipo de soporte dedicado.

Posicionamiento

La taxonomía muestra dónde coinciden los productos y dónde destaca cada uno. Los campos desconocidos se muestran claramente y no se completan con suposiciones.

Categorías

Compartido
AnálisisBase de Datos
Solo Datafold
Automatización
Solo nao
Asistente de Código

Etiquetas

Compartido
base de datoscalidad de datosdbtSQL
Solo Datafold
automatizaciónCI/CDIngeniería de Datosmigración de datosObservabilidad de datosPrueba de datosValidación de datos
Solo nao
Asistente de IAIngeniería de AnalíticaEditor de códigoanálisis de datosPipeline de datosHerramientas para desarrolladoresPython

Audiencia y roles

Compartido
No hay datos verificados
Solo Datafold
No hay datos verificados
Solo nao
No hay datos verificados

Comparación de tráfico

El tráfico usa la misma escala para reflejar de forma fiel la visibilidad de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Datafold monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
21K
Duración media
1:16
Páginas por visita
2.13
Tasa de rebote
39.96%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 33.5K
  • 2026-01: 24.6K
  • 2026-02: 19.6K
  • 2026-03: 26.3K
  • 2026-04: 20.8K
  • 2026-05: 21K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States54.41%11.4K
🇻🇳Vietnam13.86%2.9K
🇮🇳India12.19%2.6K
🇹🇭Thailand10.7%2.2K
🇵🇰Pakistan8.84%1.9K

Fuentes de tráfico

Source typePercentageEstimated visits
Directo94.33%19.8K
Referido5.67%1.2K

Palabras clave

data-diffdatafolddbt pythonnutrafol revenueopen source data warehouse

nao monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
19.1K
Duración media
0:22
Páginas por visita
1.73
Tasa de rebote
40.34%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 4K
  • 2026-01: 17.9K
  • 2026-02: 24.2K
  • 2026-03: 22.6K
  • 2026-04: 17.3K
  • 2026-05: 19.1K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States54.42%10.4K
🇮🇳India18.31%3.5K
🇫🇷France10.18%1.9K
🇩🇪Germany9.04%1.7K
🇧🇷Brazil8.05%1.5K

Fuentes de tráfico

Source typePercentageEstimated visits
Directo57.37%11K
Referido42.63%8.1K

Palabras clave

naonao datanao idenao labnao labs

Señales de comunidad

Las valoraciones y reacciones son señales de comunidad, no sustituyen el ajuste del producto.

Datafold

Valoración
Sin verificar
Comentarios
0
Favoritos
183
Me gusta
182

nao

Valoración
Sin verificar
Comentarios
0
Favoritos
169
Me gusta
148

Datafold vs nao · Preguntas frecuentes

What do Datafold and nao have in common?
Both tools are listed under Análisis、Base de Datos. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Datafold and nao free?
Listed pricing models: Datafold — Paid; nao — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Datafold and nao?
The primary listed category is Análisis for Datafold, and Análisis for nao. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparativas relacionadas