

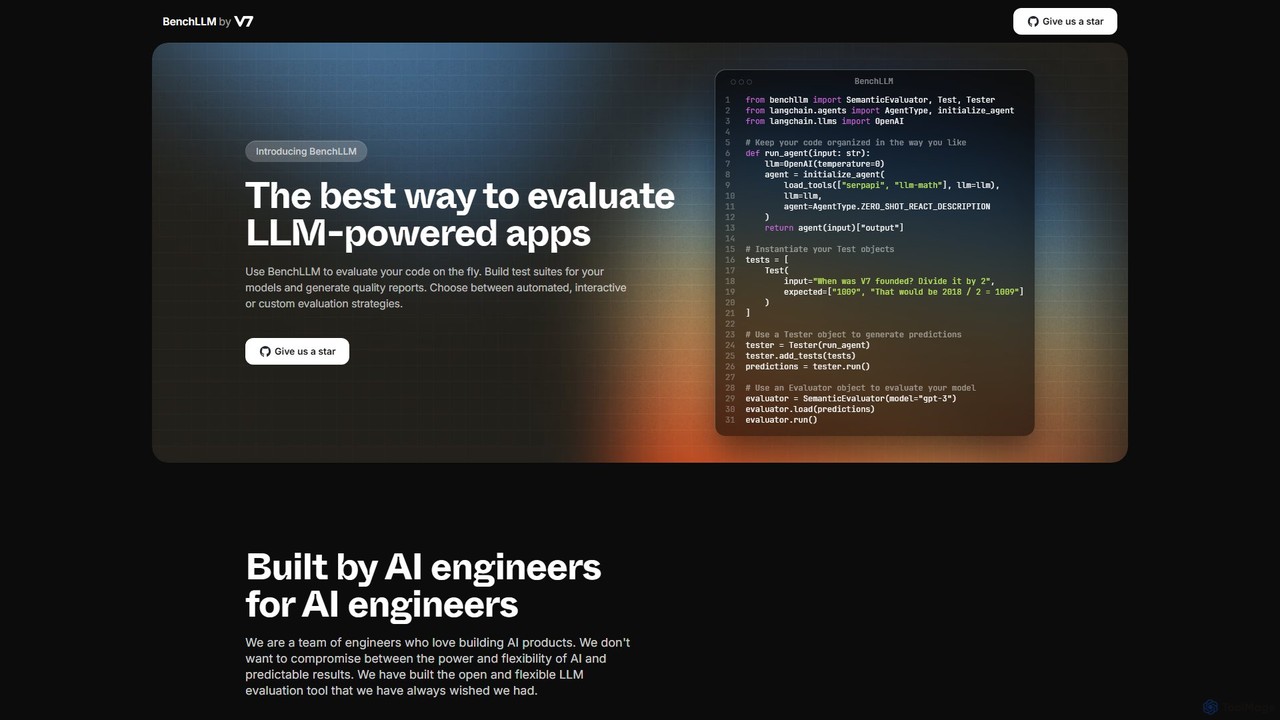
BenchLLM Overview
BenchLLM es un framework de evaluación especializado y de código abierto, meticulosamente diseñado por ingenieros de IA para ingenieros de IA. Aborda directamente el desafío crítico de garantizar la fiabilidad y la previsibilidad en aplicaciones impulsadas por Modelos de Lenguaje Grandes (LLMs). A medida que los modelos de IA se vuelven más potentes y se integran en los productos, la necesidad de pruebas sistemáticas pasa de ser un 'plus' a una parte esencial del ciclo de vida del desarrollo. BenchLLM proporciona las herramientas para cerrar la brecha entre la naturaleza probabilística de los LLMs y la demanda de un rendimiento determinista y de alta calidad.
El framework está diseñado para ser potente y flexible, permitiendo a los desarrolladores crear, gestionar y ejecutar suites de pruebas completas. Estas pruebas pueden evaluar diversos aspectos del rendimiento del modelo, desde la precisión fáctica y la detección de alucinaciones hasta el cumplimiento de formatos de salida específicos. Al integrar estas evaluaciones directamente en el flujo de trabajo de desarrollo, los equipos pueden construir con confianza, detectar regresiones tempranamente y ofrecer de manera consistente una experiencia de usuario superior.
Cómo usar BenchLLM
Usar BenchLLM es sencillo y está diseñado para encajar en los flujos de trabajo de desarrollo existentes. El proceso típicamente implica unos pocos pasos clave:
- Instalación: Como biblioteca de Python, BenchLLM se puede instalar fácilmente en su entorno de proyecto utilizando un gestor de paquetes como pip.
- Definir Pruebas: Puede definir sus casos de prueba de forma intuitiva utilizando formatos simples y legibles por humanos como YAML o JSON. Cada caso de prueba consiste en un prompt de entrada y una o más salidas esperadas. Esto facilita el versionado y la colaboración, ya que las pruebas pueden almacenarse junto con su código fuente.
- Integrar con Su Código: BenchLLM proporciona una API simple para envolver sus funciones que llaman al LLM. Ya sea que esté utilizando la biblioteca de OpenAI directamente, agentes de Langchain o una API personalizada, puede conectarla fácilmente al probador de BenchLLM.
- Ejecutar Pruebas: Las pruebas se pueden ejecutar utilizando la potente Interfaz de Línea de Comandos (CLI) o programáticamente a través de la API de Python. El comando CLI `bench run` ejecutará sus suites de pruebas definidas y generará predicciones de su modelo.
- Evaluar e Informar: Después de ejecutar las pruebas, utiliza un `Evaluador` (por ejemplo, `SemanticEvaluator`) para comparar las salidas reales del modelo con las esperadas. BenchLLM luego genera informes perspicaces que muestran claramente qué pruebas pasaron y cuáles fallaron, proporcionando el contexto necesario para la depuración y la mejora.
Características principales de BenchLLM
- Definición Flexible de Pruebas: Cree y organice pruebas en archivos YAML o JSON fáciles de gestionar, permitiendo suites de pruebas claras y con control de versiones.
- CLI Potente: Una robusta interfaz de línea de comandos le permite ejecutar evaluaciones, generar informes e integrar sin problemas las pruebas en pipelines de CI/CD para una automatización completa.
- API Versátil: Una API de Python amigable para el desarrollador permite pruebas sobre la marcha y lógica de evaluación personalizada directamente dentro del código de su aplicación.
- Múltiples Estrategias de Evaluación: Admite varios métodos de evaluación, incluyendo coincidencia exacta, regex y comprobaciones avanzadas de similitud semántica, para evaluar con precisión la calidad de la salida del modelo.
- Amplia Compatibilidad: Ofrece soporte de fábrica para bibliotecas populares como OpenAI y Langchain, y es extensible para funcionar con cualquier API de LLM personalizada.
- Informes Completos: Genera informes de evaluación claros y accionables que destacan fallos, métricas de rendimiento y regresiones, que se pueden compartir fácilmente con su equipo.
- Monitoreo en Producción: El framework se puede utilizar para monitorear el rendimiento del modelo en producción, ayudando a detectar desviaciones en el rendimiento y asegurar la fiabilidad continua.
Casos de uso para BenchLLM
BenchLLM es versátil y se puede aplicar en numerosos escenarios a lo largo del ciclo de vida del desarrollo de IA. Los casos de uso clave incluyen: Pruebas de Regresión en CI/CD, donde verifica automáticamente que los nuevos cambios no han degradado el rendimiento del modelo; Detección de Alucinaciones, creando pruebas con preguntas que no tienen una respuesta conocida (por ejemplo, eventos futuros) para asegurar que el modelo responda adecuadamente; Benchmarking de Modelos, permitiéndole ejecutar la misma suite de pruebas contra diferentes LLMs (por ejemplo, GPT-4 vs. Claude 3) o variaciones de prompts para medir y comparar objetivamente su rendimiento; y Garantía de Calidad, estableciendo una línea base de calidad que todas las versiones del modelo deben cumplir antes del despliegue.
Ventajas de BenchLLM
La principal ventaja de BenchLLM es que está construido con una mentalidad de 'desarrollador primero'. Es una herramienta abierta y flexible que da a los ingenieros un control total sobre el proceso de evaluación, a diferencia de algunas soluciones de caja negra. Al ser de código abierto, ofrece la máxima transparencia y personalización. Transforma el desarrollo de LLM en una disciplina de ingeniería más estructurada y predecible, alejándose del ensayo y error. Al automatizar la tarea tediosa y propensa a errores de las pruebas manuales, agiliza significativamente el ciclo de desarrollo, mejora la calidad del producto y aumenta la productividad del desarrollador.
Precios y planes
BenchLLM es una herramienta completamente gratuita y de código abierto, construida y mantenida por el equipo de V7. Está disponible para que cualquiera la descargue, use y contribuya a través de su repositorio de GitHub. No hay planes de pago, suscripciones ni costos ocultos para usar su conjunto completo de características, lo que la convierte en una opción accesible para desarrolladores individuales, startups y grandes empresas por igual.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 317
- 2026-1: 1.2K
- 2026-2: 597
- 2026-3: 210
- 2026-4: 0
- 2026-5: 955
Geography
Top 5 countries / regions
- 🇮🇳India100.0%
BenchLLM Alternatives
TestZeus
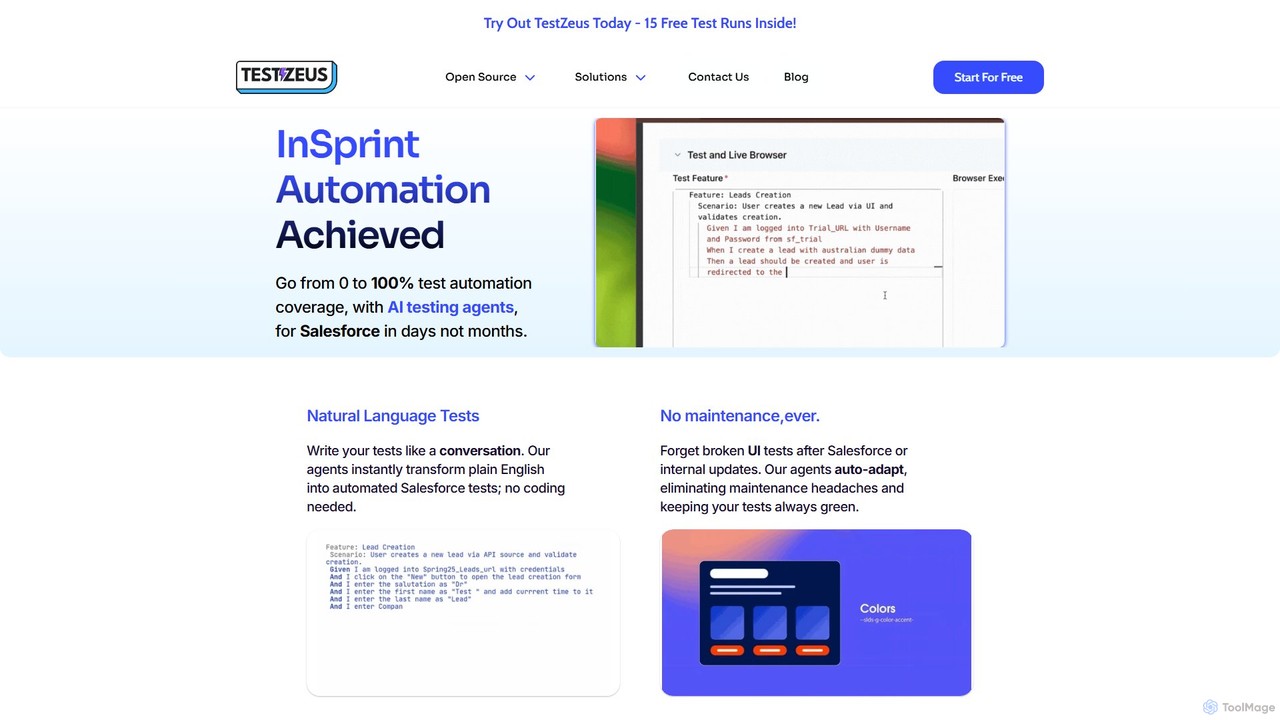
TestZeus es una plataforma de automatización de pruebas sin código, impulsada por IA y diseñada específicamente para Salesforce. Utiliza agentes de IA autónomos para escribir, ejecutar y mantener pruebas a partir de entradas en lenguaje natural, logrando hasta un 100% de cobertura de pruebas en días y eliminando la sobrecarga de mantenimiento.
Prueba
CrewAI
CrewAI es un framework avanzado de código abierto para orquestar agentes de IA autónomos con roles definidos. Fomentando la inteligencia colaborativa, permite que agentes con roles y herramientas distintas trabajen juntos sin problemas para resolver tareas complejas. Este sistema multiagente simplifica el desarrollo de aplicaciones sofisticadas, desde la creación de contenido automatizado hasta el análisis de datos complejos, gestionando interacciones de agentes, delegación de tareas y procesos de flujo de trabajo.
Agente
vocode
Vocode es una plataforma de código abierto para construir, desplegar y escalar agentes de IA de voz hiperrealistas. Proporciona a los desarrolladores un marco central y una API de nivel empresarial para crear sofisticadas aplicaciones de LLM basadas en voz para tareas como servicio al cliente automatizado, llamadas de ventas y sistemas de respuesta de voz interactiva (IVR).
Bot de voz
codegate
Codegate es un gateway de seguridad de código abierto y un marco de multiplexación para sistemas de agentes de IA. Desarrollado por Stacklok, proporciona espacios de trabajo seguros y control de acceso basado en políticas, permitiendo a los desarrolladores construir y gestionar aplicaciones complejas de múltiples agentes de forma segura y eficiente.
Frameworks Agénticos
CopilotKit
CopilotKit es un framework full-stack de código abierto para que los desarrolladores construyan, desplieguen y personalicen copilotos de IA y aplicaciones agénticas dentro de sus aplicaciones. Proporciona componentes de front-end, lógica de back-end e integraciones fluidas con cualquier LLM o framework de agentes, permitiendo la creación de potentes asistentes de IA orientados al usuario.
FrameworksBenchLLM Categories
BenchLLM Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools

Ragas
Ragas es un framework de Python de código abierto para evaluar y probar pipelines de Generación Aumentada por Recuperación (RAG). Proporciona un conjunto de métricas para medir el rendimiento de tus aplicaciones LLM, desde la recuperación de contexto hasta la generación de respuestas. Con la confianza de líderes de la industria como LangChain y LlamaIndex, Ragas ayuda a los desarrolladores a construir sistemas de IA más robustos, fiables y precisos, identificando y mitigando problemas como alucinaciones y respuestas irrelevantes.
MLOpsTestZeus
TestZeus es una plataforma de automatización de pruebas sin código, impulsada por IA y diseñada específicamente para Salesforce. Utiliza agentes de IA autónomos para escribir, ejecutar y mantener pruebas a partir de entradas en lenguaje natural, logrando hasta un 100% de cobertura de pruebas en días y eliminando la sobrecarga de mantenimiento.
PruebaCrewAI
CrewAI es un framework avanzado de código abierto para orquestar agentes de IA autónomos con roles definidos. Fomentando la inteligencia colaborativa, permite que agentes con roles y herramientas distintas trabajen juntos sin problemas para resolver tareas complejas. Este sistema multiagente simplifica el desarrollo de aplicaciones sofisticadas, desde la creación de contenido automatizado hasta el análisis de datos complejos, gestionando interacciones de agentes, delegación de tareas y procesos de flujo de trabajo.
Agente
Chainlit
Chainlit es un framework de Python de código abierto para que los desarrolladores construyan y desplieguen rápidamente aplicaciones de IA conversacional listas para producción. Proporciona una interfaz de chat instantánea y personalizable, permitiéndote centrarte en tu lógica de backend y en las interacciones con LLMs. Con integraciones profundas para LangChain, LlamaIndex y los principales proveedores de LLM, Chainlit simplifica la creación de todo, desde chatbots simples hasta copilotos complejos basados en datos.
Marco
Agenta
Agenta es una plataforma LLMOps de código abierto diseñada para que los equipos construyan aplicaciones LLM fiables. Integra la gestión de prompts, la evaluación sistemática y la observabilidad en un único flujo de trabajo colaborativo, ayudando a desarrolladores, gerentes de producto y expertos en el dominio a pasar de procesos dispersos a un desarrollo estructurado.
Depuración
GPT Researcher
GPT Researcher es un agente de IA autónomo de código abierto diseñado para una investigación rápida y profunda. Automatiza todo el proceso de investigación, desde la recopilación de información de fuentes fiables hasta la organización de hallazgos y la generación de informes completos y citados. Ideal para desarrolladores, analistas e investigadores, se integra con cualquier LLM y motor de búsqueda para ofrecer resultados precisos y factuales sobre cualquier tema en minutos.
API
Prompto
Prompto es una interfaz gratuita, de código abierto y basada en navegador para interactuar con una amplia gama de Grandes Modelos de Lenguaje (LLMs). Utiliza LangChain.js para conectarse directamente a proveedores como OpenAI, Anthropic y modelos locales a través de Ollama, ofreciendo funciones avanzadas como una Arena de comparación de modelos, plantillas de prompts y discusiones multi-IA, todo mientras prioriza la privacidad del usuario al almacenar los datos localmente.
Comparación de Modelosvocode
Vocode es una plataforma de código abierto para construir, desplegar y escalar agentes de IA de voz hiperrealistas. Proporciona a los desarrolladores un marco central y una API de nivel empresarial para crear sofisticadas aplicaciones de LLM basadas en voz para tareas como servicio al cliente automatizado, llamadas de ventas y sistemas de respuesta de voz interactiva (IVR).
Bot de vozcodegate
Codegate es un gateway de seguridad de código abierto y un marco de multiplexación para sistemas de agentes de IA. Desarrollado por Stacklok, proporciona espacios de trabajo seguros y control de acceso basado en políticas, permitiendo a los desarrolladores construir y gestionar aplicaciones complejas de múltiples agentes de forma segura y eficiente.
Frameworks Agénticos
phidata
phidata es un framework de Python de código abierto para construir Asistentes de IA autónomos. Simplifica la integración de LLMs con memoria, bases de conocimiento y herramientas externas, permitiendo a los desarrolladores crear potentes aplicaciones de IA con estado fácilmente.
FrameworksCopilotKit
CopilotKit es un framework full-stack de código abierto para que los desarrolladores construyan, desplieguen y personalicen copilotos de IA y aplicaciones agénticas dentro de sus aplicaciones. Proporciona componentes de front-end, lógica de back-end e integraciones fluidas con cualquier LLM o framework de agentes, permitiendo la creación de potentes asistentes de IA orientados al usuario.
Frameworks
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
Automatización
Confident AI
Confident AI es una plataforma de evaluación y observabilidad de LLM para equipos de ingeniería. Creada por los desarrolladores de la biblioteca de código abierto DeepEval, ayuda a comparar, proteger y mejorar aplicaciones de LLM mediante métricas completas, pruebas de regresión y trazabilidad detallada para garantizar un rendimiento de IA consistente.
Gestión de Modelos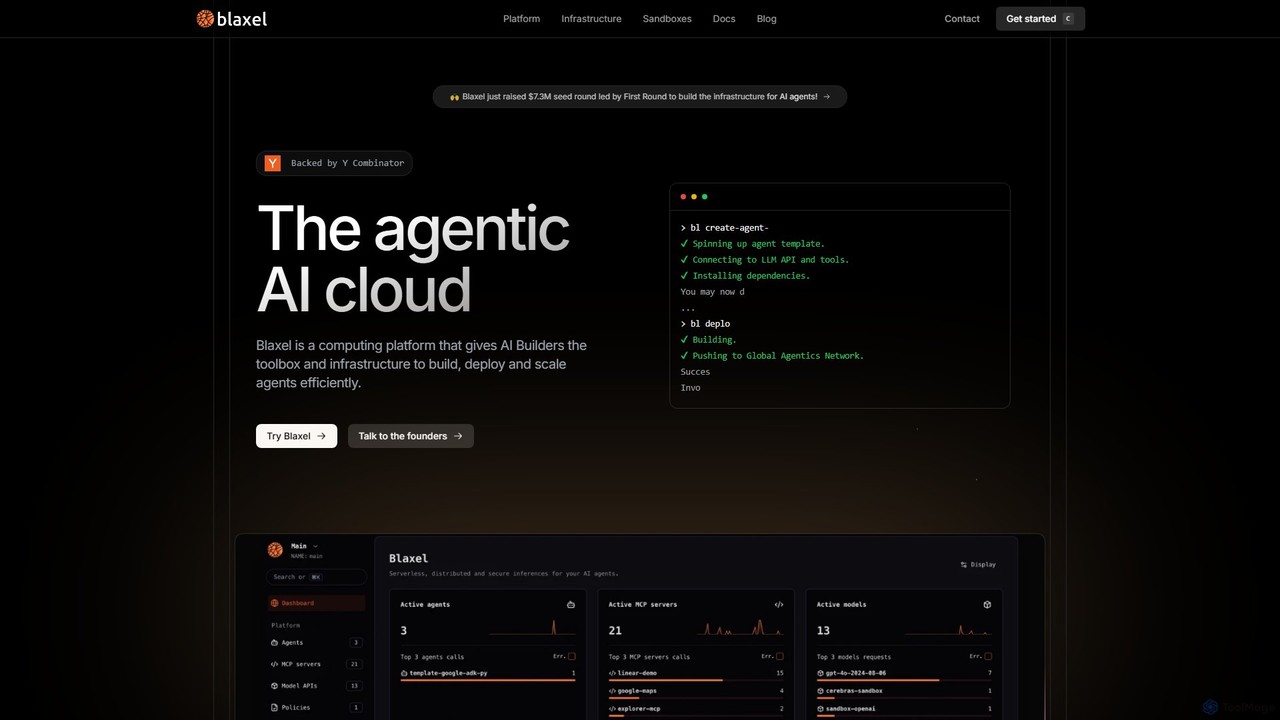
Blaxel
Blaxel es una plataforma de computación sin servidor diseñada para desarrolladores de IA, que proporciona la infraestructura y las herramientas para construir, desplegar y escalar aplicaciones de IA agéntica de manera eficiente. Ofrece VMs en sandbox, una pasarela LLM unificada y observabilidad profunda.
Computación en la Nube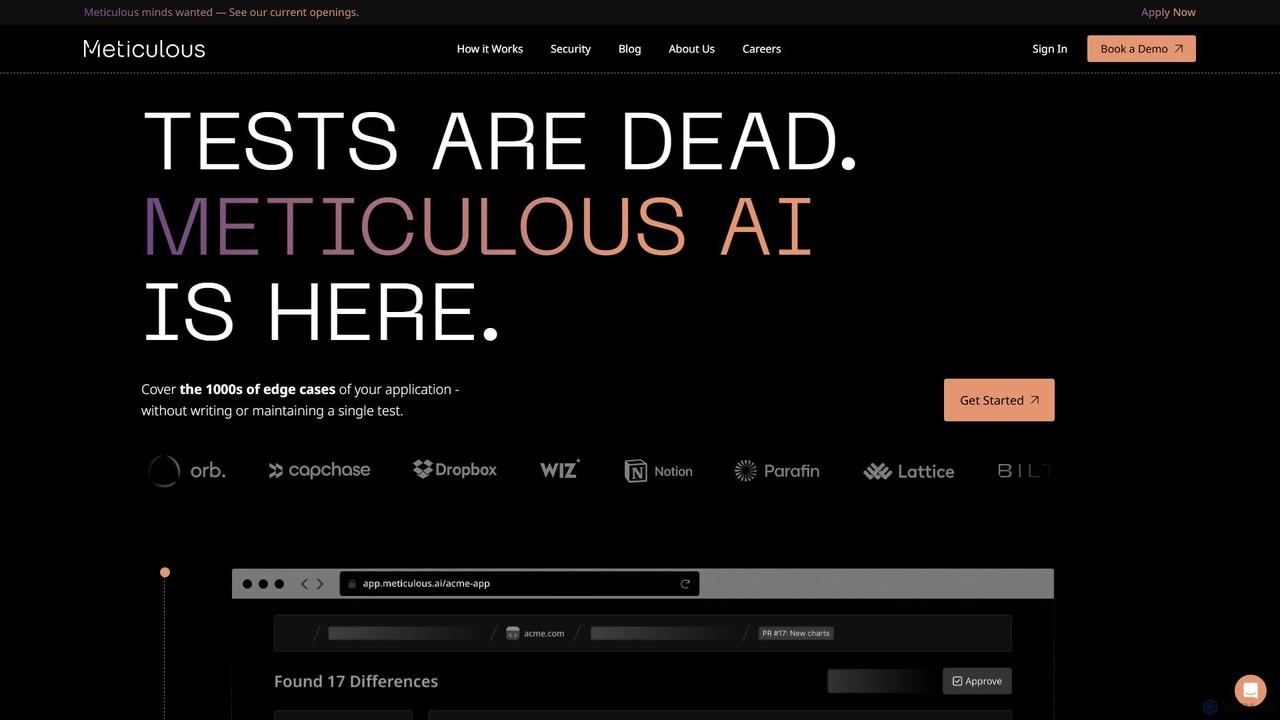
Meticulous
Meticulous es una herramienta impulsada por IA que revoluciona las pruebas de front-end. Genera y mantiene automáticamente pruebas visuales de extremo a extremo grabando las interacciones del usuario, eliminando la necesidad de escribir scripts de prueba manualmente. Esto ayuda a los equipos de desarrollo a detectar regresiones, cubrir casos extremos y entregar código más rápido con confianza, sin la molestia de pruebas inestables o de alto mantenimiento.
Calidad de Código
BenchLLM Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.