

hypermink Overview
HyperMink es una plataforma dedicada a hacer que la IA sea accesible y privada, defendiendo el principio: "Tu IA, Tus Reglas". Su proyecto insignia, Inferenceable, es un potente servidor de inferencia de IA de código abierto diseñado para la simplicidad, el rendimiento y la preparación para la producción. Construido con Node.js y aprovechando el núcleo de alto rendimiento de llama.cpp y llamafile, Inferenceable permite a desarrolladores, investigadores y empresas desplegar y ejecutar grandes modelos de lenguaje (LLM) en su propia infraestructura. Este enfoque de autohospedaje garantiza una privacidad y soberanía de datos absolutas, ya que ninguna información necesita salir de su red local o entorno en la nube. Desmitifica eficazmente el proceso de uso de IA avanzada, dando a los usuarios un control total sobre sus modelos y datos sin estar atados a APIs de terceros costosas y restrictivas.
Cómo usar hypermink
Usar Inferenceable, la herramienta principal de HyperMink, implica un proceso sencillo para los desarrolladores familiarizados con las tecnologías del lado del servidor:
- Descargar desde GitHub: Accede al repositorio oficial de Inferenceable en GitHub y clona o descarga el código fuente en tu máquina local o servidor.
- Instalar Dependencias: Navega al directorio del proyecto e instala las dependencias necesarias de Node.js usando un gestor de paquetes como npm o yarn.
- Descargar un Modelo de IA: Obtén un LLM preentrenado en un formato compatible, como GGUF, que es ampliamente soportado por el backend de llama.cpp. Modelos como Llama 3, Mistral o Phi-3 son excelentes opciones.
- Configurar el Servidor: Edita el archivo de configuración para especificar la ruta a tu modelo descargado, establecer el puerto del servidor, definir el tamaño del contexto y ajustar otros parámetros relacionados con el rendimiento.
- Ejecutar el Servidor: Inicia el servidor de inferencia ejecutando un simple comando en tu terminal. El servidor cargará el modelo especificado en la memoria y se preparará para aceptar solicitudes de API.
- Integrar con Aplicaciones: Realiza llamadas de API REST al punto final del servidor desde cualquiera de tus aplicaciones —ya sea una aplicación web, un backend móvil o un script de análisis de datos— para obtener respuestas generadas por el modelo.
Características principales de hypermink
- Código Abierto y Gratuito: Inferenceable es completamente gratuito para usar, modificar y distribuir bajo su licencia de código abierto. Está disponible en GitHub para una total transparencia.
- Autohospedado para Máxima Privacidad: Ejecuta LLMs en tu propio hardware, ya sea un escritorio local o un servidor en la nube privado, asegurando que tus datos nunca salgan de tu control.
- Motor de Alto Rendimiento: Construido sobre el núcleo C/C++ altamente optimizado de llama.cpp, ofrece velocidades de inferencia rápidas con un uso eficiente de los recursos de CPU y GPU.
- Simple y Conectable: Diseñado con una arquitectura sencilla en Node.js, lo que facilita su configuración, gestión y extensión con plugins o modelos personalizados.
- Listo para Producción: Suficientemente estable y robusto para ser desplegado en entornos de producción para potenciar aplicaciones de IA del mundo real.
- Amplio Soporte de Modelos: Compatible con una amplia gama de LLMs de código abierto que utilizan el formato GGUF, dándote la flexibilidad de elegir el mejor modelo para tus necesidades.
- Interfaz de API Estandarizada: Proporciona una API RESTful limpia que es fácil de integrar con cualquier lenguaje de programación o plataforma.
Casos de uso para hypermink
Inferenceable es ideal para una variedad de aplicaciones donde la privacidad de los datos, el costo y la personalización son críticos:
- Herramientas Empresariales Internas: Desarrolla un chatbot privado para que los empleados consulten bases de conocimiento internas o resuman documentos confidenciales de la empresa sin exposición de datos.
- Funciones Personalizadas con IA: Integra generación de contenido, resumen de texto o completado de código directamente en tu producto de software sin depender de proveedores de API externos.
- Investigación Académica y de IA: Crea un entorno controlado para experimentar con diferentes LLMs, ajustar modelos y estudiar su comportamiento sin límites de uso.
- Aplicaciones con Capacidad Offline: Construye herramientas de IA que pueden ejecutarse en máquinas locales sin conexión a internet, perfectas para entornos seguros o remotos.
- Soluciones de IA Rentables: Potencia tareas de generación o análisis de texto de alto volumen evitando los costos por token asociados con las APIs comerciales de LLM.
Ventajas de hypermink
La principal ventaja de Inferenceable de HyperMink es el control. Los usuarios obtienen soberanía completa sobre su pila de IA. Esto se traduce en varios beneficios clave: privacidad de datos inigualable, ahorros de costos significativos para casos de uso de alto volumen, libertad de las restricciones y límites de tasa de las API de terceros, y la flexibilidad para personalizar cada aspecto del modelo de IA y su despliegue. Además, al ejecutar modelos localmente, las aplicaciones pueden lograr una latencia más baja, lo que resulta en una experiencia de usuario más receptiva.
Precios y planes
El producto principal de HyperMink, el servidor Inferenceable, es completamente gratuito y de código abierto. Está disponible para descargar en GitHub. Los usuarios no tienen que pagar ninguna tarifa de licencia o suscripción para usar el software. Los únicos costos involucrados son los asociados con el propio hardware del usuario (CPU, GPU, RAM) y la infraestructura para alojar el servidor.
hypermink Alternatives
Models
Models de Hathora ofrece un catálogo curado de modelos ASR, TTS y LLM de baja latencia optimizados para IA de voz y aplicaciones en tiempo real. Los desarrolladores pueden explorar, probar e implementar modelos listos para producción rápidamente, con sandboxes interactivas y acceso directo a la API para una integración perfecta en agentes de voz y otras aplicaciones.
API
Fireworks AI
Una plataforma de alto rendimiento para que los desarrolladores construyan, personalicen y escalen aplicaciones de IA generativa. Ofrece un motor de inferencia rápido líder en la industria, capacidades avanzadas de ajuste fino y acceso a una amplia gama de modelos de código abierto, permitiendo soluciones de IA en tiempo real y rentables.
Despliegue de Modelo
LocalAI
LocalAI es una aplicación de escritorio gratuita y de código abierto que te permite ejecutar modelos de IA de forma privada y sin conexión en tu propio ordenador. Simplifica la experimentación con IA sin necesidad de una GPU, ofreciendo funciones como gestión de modelos, verificación de integridad y un servidor de inferencia local.
Despliegue de Modelo
vocode
Vocode es una plataforma de código abierto para construir, desplegar y escalar agentes de IA de voz hiperrealistas. Proporciona a los desarrolladores un marco central y una API de nivel empresarial para crear sofisticadas aplicaciones de LLM basadas en voz para tareas como servicio al cliente automatizado, llamadas de ventas y sistemas de respuesta de voz interactiva (IVR).
Bot de voz
Comet
Comet es una familia de modelos de lenguaje grandes (LLM) de código abierto y alto rendimiento desarrollados por Perplexity AI. Diseñado para una velocidad y precisión excepcionales, Comet impulsa aplicaciones de IA conversacional rápidas y está disponible para desarrolladores a través de API y descarga directa.
Procesamiento del Lenguaje Naturalhypermink Categories
hypermink Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
LocalAI
LocalAI es una aplicación de escritorio gratuita y de código abierto que te permite ejecutar modelos de IA de forma privada y sin conexión en tu propio ordenador. Simplifica la experimentación con IA sin necesidad de una GPU, ofreciendo funciones como gestión de modelos, verificación de integridad y un servidor de inferencia local.
Despliegue de Modelovocode
Vocode es una plataforma de código abierto para construir, desplegar y escalar agentes de IA de voz hiperrealistas. Proporciona a los desarrolladores un marco central y una API de nivel empresarial para crear sofisticadas aplicaciones de LLM basadas en voz para tareas como servicio al cliente automatizado, llamadas de ventas y sistemas de respuesta de voz interactiva (IVR).
Bot de vozComet
Comet es una familia de modelos de lenguaje grandes (LLM) de código abierto y alto rendimiento desarrollados por Perplexity AI. Diseñado para una velocidad y precisión excepcionales, Comet impulsa aplicaciones de IA conversacional rápidas y está disponible para desarrolladores a través de API y descarga directa.
Procesamiento del Lenguaje Natural
Ollama
Ollama es un potente marco de código abierto para ejecutar grandes modelos de lenguaje (LLMs) como Llama 3, Mistral y Gemma localmente en tu propio hardware. Disponible para macOS, Windows y Linux, simplifica la configuración y gestión de modelos de código abierto, permitiendo un desarrollo y uso de IA privado, sin conexión y rentable.
Aprendizaje Automático
Firecrawl
Firecrawl es una API de código abierto, orientada a desarrolladores, que convierte cualquier sitio web en datos limpios y listos para LLM. Gestiona todas las complejidades del web scraping, incluyendo la renderización de JavaScript, la rotación de proxies y los límites de tasa, permitiéndole potenciar aplicaciones de IA, agentes y sistemas RAG con contenido web fiable. Ofrece funcionalidades de scraping, crawling y búsqueda a través de una API sencilla.
Recopilación de Datos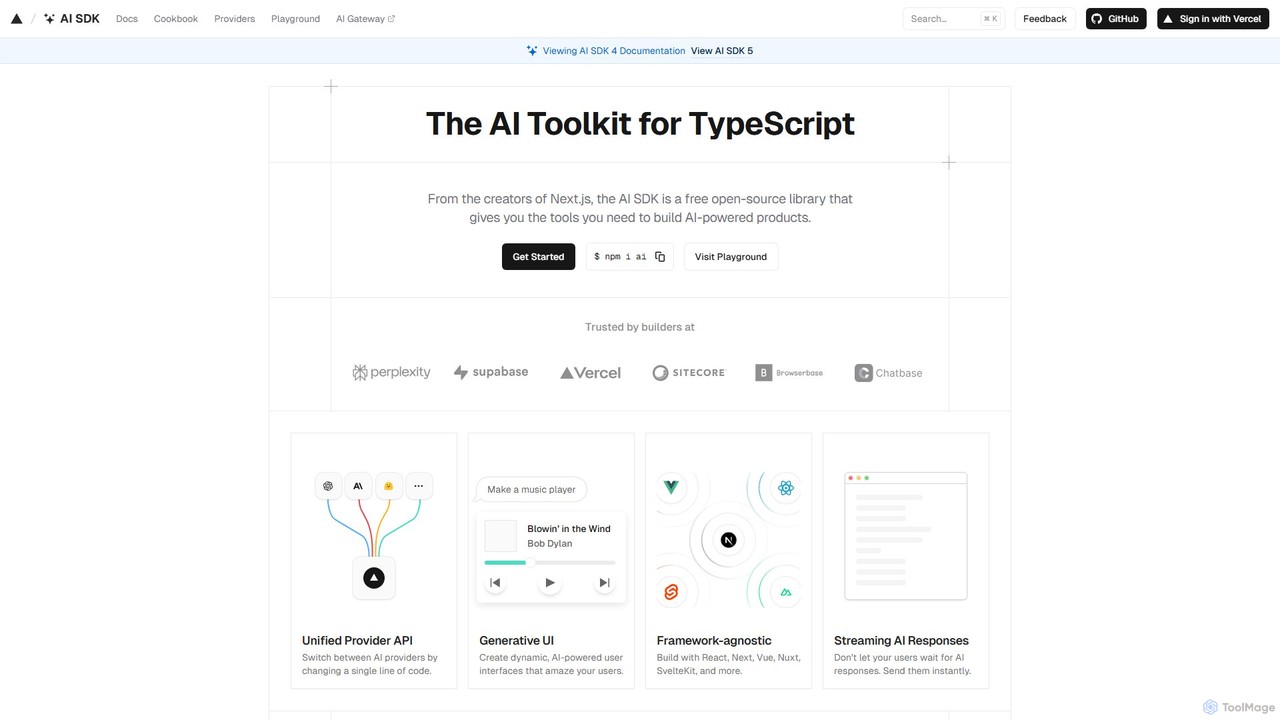
AI SDK
AI SDK de Vercel es un kit de herramientas TypeScript gratuito y de código abierto para crear aplicaciones impulsadas por IA. Proporciona una API unificada para integrar sin problemas varios modelos de lenguaje grandes (LLM) como OpenAI, Google y Anthropic. Simplifica el desarrollo con características como respuestas en streaming, componentes de UI generativos y llamada a herramientas, permitiendo a los desarrolladores construir y lanzar características de IA más rápido en frameworks como Next.js, React y Svelte.
Biblioteca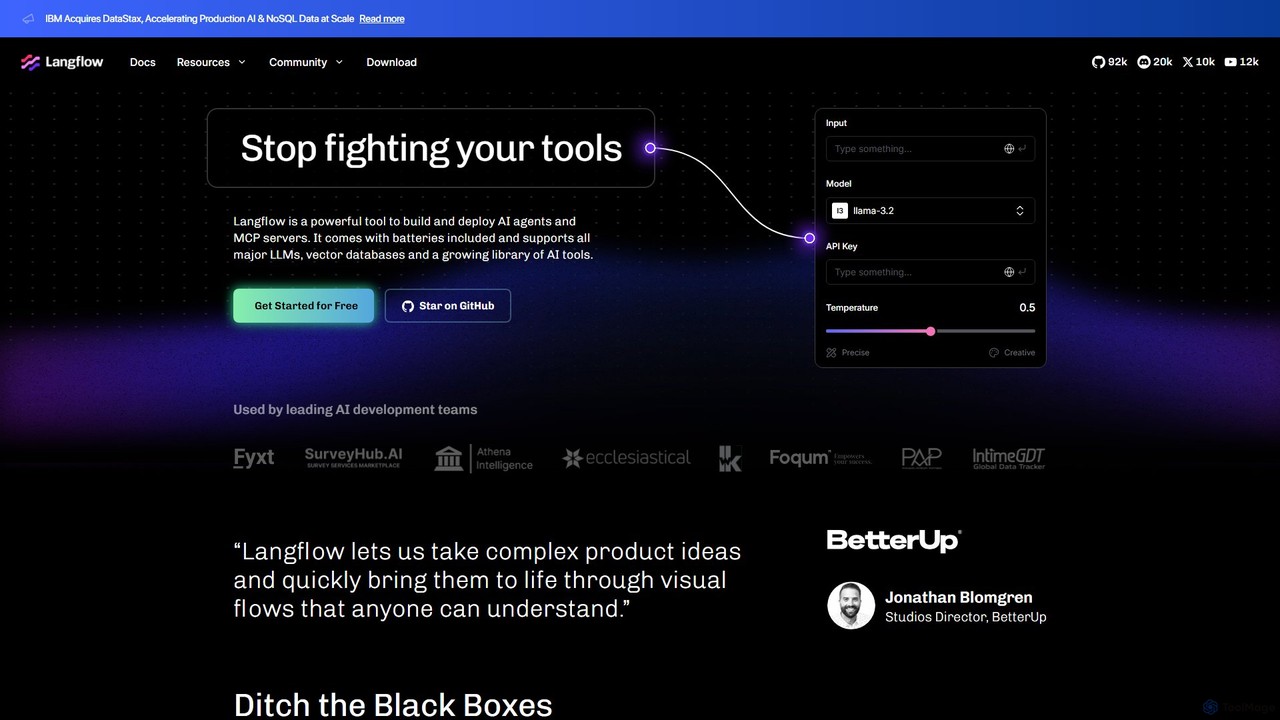
Langflow
Langflow es una interfaz de usuario (UI) visual de código abierto para construir y desplegar aplicaciones de IA. Cuenta con una interfaz de arrastrar y soltar para encadenar LLMs, agentes y herramientas, permitiendo la creación rápida de prototipos y el despliegue de flujos de trabajo complejos como RAG y sistemas multiagente. Admite amplias integraciones y ofrece opciones tanto autoalojadas como en la nube.
Low-code No-code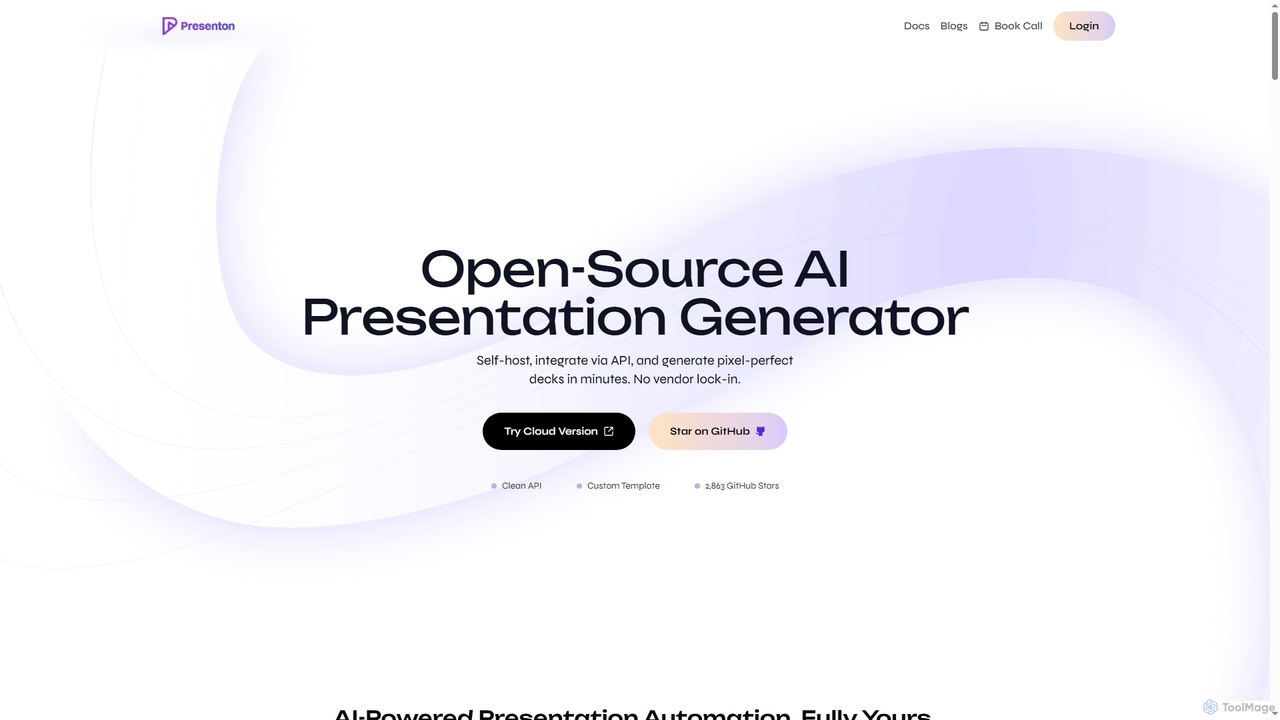
Presenton
Presenton es un generador de presentaciones de IA de código abierto diseñado para desarrolladores y equipos. Permite el autohospedaje, la integración mediante API y la creación de presentaciones perfectas y acordes a la marca a partir de plantillas personalizadas, garantizando un control total, privacidad y sin dependencia de proveedores.
Automatización
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
Automatización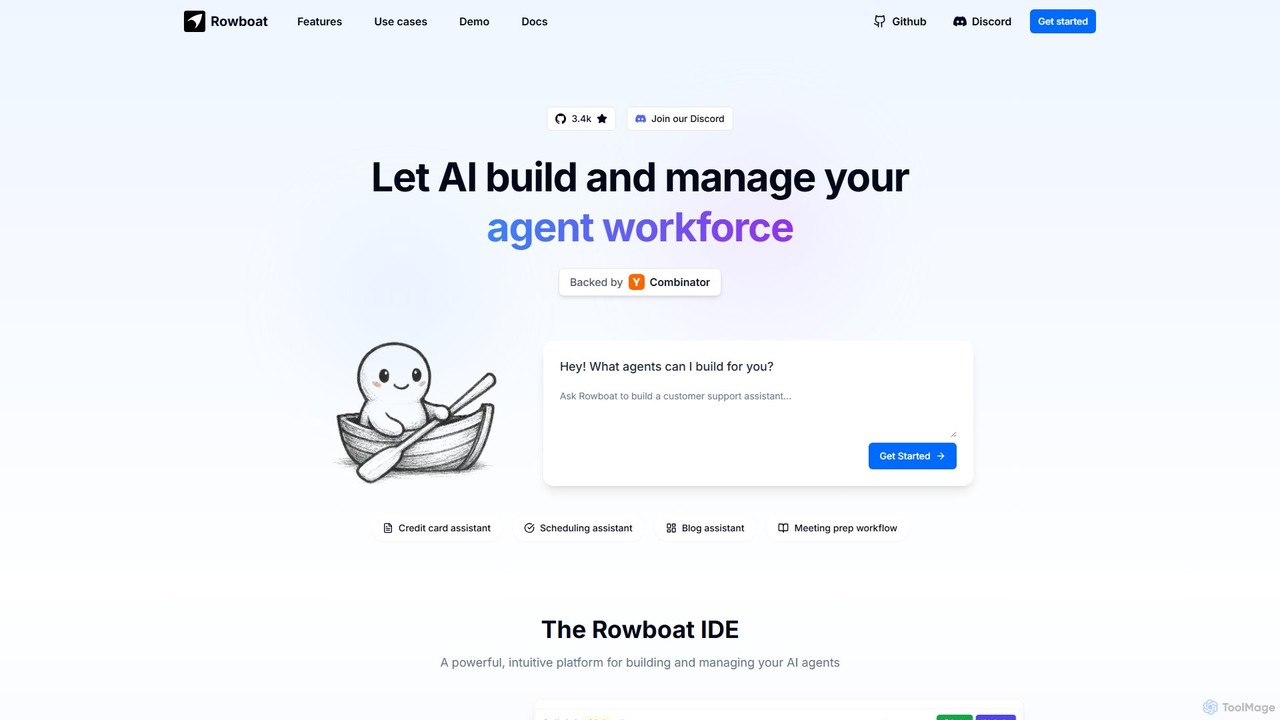
Rowboat
Rowboat es un potente IDE impulsado por IA para construir, gestionar y desplegar sistemas complejos de múltiples agentes. Con el respaldo de Y Combinator, permite a los usuarios describir flujos de trabajo en inglés sencillo, y su copiloto de IA genera automáticamente todo el grafo de agentes, incluyendo roles, prompts e integraciones de herramientas. Está diseñado para simplificar la creación de agentes de IA robustos y del mundo real para productividad, comercio electrónico, soporte y más, con características como flexibilidad de código abierto y soporte para más de 100 LLMs.
Creador de Agentes
Forefront
Forefront es una plataforma para desarrolladores para construir con IA de código abierto. Simplifica la ejecución, el ajuste fino y el despliegue de grandes modelos de lenguaje (LLM) en tus datos privados, ofreciendo una alternativa escalable, segura y rentable a las plataformas de código cerrado. Sé dueño de tus datos, tus modelos y tu IA.
Grandes Modelos de Lenguaje
boundaryml
boundaryml (BAML) es un lenguaje de programación y un conjunto de herramientas especializado para que los desarrolladores extraigan datos estructurados de Modelos de Lenguaje Grandes (LLMs) de forma fiable. Transforma la compleja ingeniería de prompts en un proceso simplificado, similar al código, garantizando salidas con seguridad de tipos y corrección de errores en diversos LLMs y lenguajes de programación como Python y TypeScript. Está diseñado para mejorar la fiabilidad, reducir costes y acelerar los ciclos de desarrollo de aplicaciones de IA.
API
Chatbot UI
Chatbot UI es una interfaz de chatbot de código abierto que te permite conectar con más de 80 modelos de IA, incluyendo los de OpenAI, Google y Anthropic. Ofrece una alternativa autoalojable y personalizable a las plataformas de chat propietarias, dando a los usuarios control total sobre sus datos y conversaciones. Organiza chats, crea prompts y cambia sin problemas entre modelos en un único espacio de trabajo unificado.
Gestión de API
LM Studio
LM Studio es una aplicación de escritorio fácil de usar para descubrir, descargar y ejecutar Modelos de Lenguaje Grandes (LLM) de código abierto localmente en tu ordenador. Ofrece una interfaz de chat simple y un servidor de inferencia local, garantizando la privacidad y el acceso sin conexión.
Chat
OpenLIT
OpenLIT es una plataforma de observabilidad de código abierto y nativa de OpenTelemetry para aplicaciones de IA Generativa y LLM. Simplifica el desarrollo con herramientas para el seguimiento de solicitudes, control de costos, monitoreo de excepciones y análisis de rendimiento. Con un repositorio centralizado de prompts, una bóveda segura para secretos y un playground para comparar LLMs, OpenLIT ofrece una solución integral para monitorear y escalar aplicaciones de IA de manera eficiente.
Gestión de Modelos
hypermink Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.