
Fireworks AI Overview
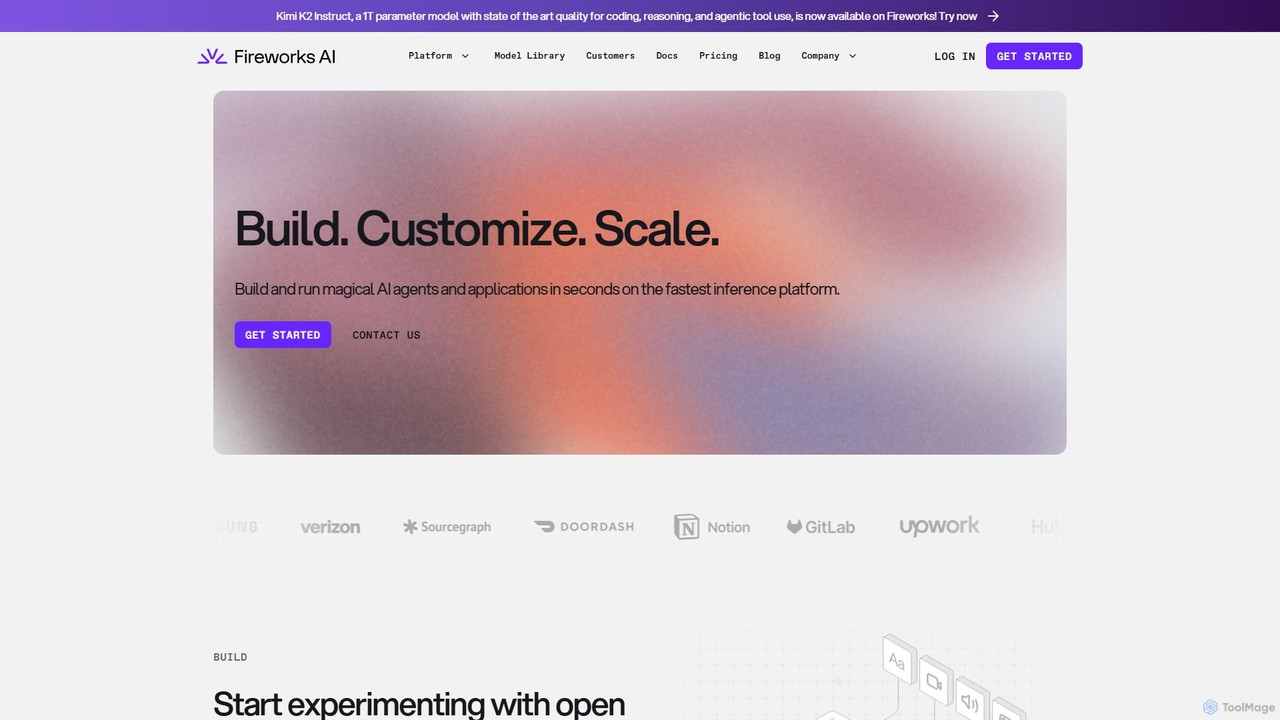
Fireworks AI es una plataforma de desarrollo de vanguardia diseñada para construir, personalizar y escalar aplicaciones de IA generativa con una velocidad y eficiencia inigualables. Se posiciona como la plataforma de inferencia más rápida, capacitando a desarrolladores y empresas para ejecutar y ajustar modelos de IA de código abierto como Llama, Mistral, DeepSeek y Qwen con solo unas pocas líneas de código. La plataforma se basa en un motor de inferencia altamente optimizado, FireAttention, que ofrece un rendimiento en tiempo real, una latencia mínima y un alto rendimiento, lo que la hace ideal para aplicaciones de misión crítica. Fireworks AI abstrae la complejidad de la gestión de GPU, permitiendo a los usuarios centrarse en la construcción de productos de IA innovadores.
Cómo usar Fireworks AI
Usar Fireworks AI es un proceso simplificado para los desarrolladores. Primero, te registras en su sitio web para obtener acceso a la plataforma y recibir créditos gratuitos iniciales. Luego, puedes usar sus intuitivos SDK o realizar llamadas directas a la API para comenzar a experimentar con cientos de modelos abiertos pre-soportados. La plataforma es compatible con OpenAI, lo que facilita la migración. Para necesidades personalizadas, puedes subir tus datos para ajustar un modelo utilizando técnicas avanzadas como el Ajuste Fino Supervisado (SFT) o el Ajuste Fino por Refuerzo (RFT). Una vez que tu modelo está listo, puedes implementarlo utilizando una de las opciones flexibles: Serverless para un uso fácil de pago por token sin arranques en frío, o Despliegues Bajo Demanda para recursos de GPU dedicados, que ofrecen límites de tasa más altos y costos más bajos a escala.
Características principales de Fireworks AI
- Motor de Inferencia Ultrarrápido: Impulsado por el motor propietario FireAttention, ofrece una velocidad líder en la industria, baja latencia y alto rendimiento, superando significativamente a los motores de inferencia estándar como vLLM.
- Amplia Biblioteca de Modelos Abiertos: Acceso instantáneo a cientos de modelos populares de código abierto para texto, visión, audio y generación de imágenes, incluyendo Llama 3.1, Mixtral, Qwen y DeepSeek. Los usuarios también pueden subir modelos personalizados.
- Ajuste Fino y Personalización Avanzados: Proporciona herramientas sofisticadas para la personalización de modelos, incluyendo Ajuste Fino Supervisado (SFT), Ajuste Fino por Refuerzo (RFT) y ajuste consciente de la cuantización para lograr la máxima calidad en casos de uso específicos.
- Servicio Multi-LoRA: Despliega cientos de adaptadores LoRA ajustados en una sola implementación sin costo de servicio adicional, permitiendo una personalización masiva y experimentación eficiente.
- Opciones de Despliegue Flexibles: Ofrece capacidad Serverless (pago por token), Bajo Demanda (pago por segundo de GPU) y Reservada para Empresas para adaptarse a diferentes escalas y requisitos, desde la creación de prototipos hasta la producción a gran escala.
- Capacidades Multimodales: Soporta una amplia gama de tareas de IA, incluyendo generación de texto, transcripción de voz a texto, generación de imágenes y comprensión de lenguaje visual.
- IA Compuesta y Salidas Estructuradas: Funciones como la llamada a funciones, el modo JSON y el modo de gramática permiten construir sistemas de IA complejos y fiables que pueden interactuar con otras herramientas y API.
- Seguridad y Escalabilidad de Nivel Empresarial: Cumple con SOC2 Tipo II, GDPR e HIPAA, con despliegue global en más de 10 nubes y 15 regiones para una alta disponibilidad y un escalado sin interrupciones.
Casos de uso para Fireworks AI
Fireworks AI cuenta con la confianza de empresas líderes como Notion, Sourcegraph y Quora para diversas aplicaciones. Los casos de uso comunes incluyen:
- Agentes de IA en Tiempo Real: Construcción de agentes de voz y chatbots altamente receptivos con una latencia mínima.
- Herramientas de Desarrollo con IA: Creación de asistentes de codificación avanzados, como Cody de Sourcegraph, con autocompletado rápido de código y búsqueda impulsada por IA.
- Sistemas RAG Empresariales: Potenciando flujos de trabajo de Generación Aumentada por Recuperación (RAG) a gran escala, como se ve en Notion, para proporcionar respuestas precisas y contextuales.
- IA Personalizada a Escala: Sirviendo miles de modelos personalizados para diferentes usuarios o dominios, como los modelos de base específicos de dominio de Quora.
- Procesamiento de Medios de Alto Rendimiento: Realizando transcripción de audio y generación de imágenes rápidas para plataformas de creación y análisis de contenido.
Ventajas de Fireworks AI
La principal ventaja de Fireworks AI es su rendimiento extremo. Los testimonios destacan reducciones significativas de latencia (por ejemplo, de 2 segundos a 350 ms para Notion), lo que permite experiencias de usuario en tiempo real. Su rentabilidad es otro beneficio clave, logrado a través de un motor optimizado y características innovadoras como el servicio multi-LoRA. La plataforma ofrece una personalización profunda sin la complejidad habitual, haciendo que la IA avanzada sea accesible. Finalmente, su enfoque centrado en el desarrollador, con SDK robustos, documentación extensa y escalabilidad sin interrupciones, permite a los equipos pasar de la idea a la producción de manera rápida y fiable.
Precios y planes
Fireworks AI opera en un modelo freemium de pago por uso, comenzando con $1 en créditos gratuitos para nuevos usuarios. El precio se desglosa por servicio:
- Inferencia Serverless: Se factura por 1 millón de tokens, con tarifas que varían según el tamaño del modelo (por ejemplo, $0.20 para modelos de 4B-16B, $0.90 para modelos >16B).
- Ajuste Fino: Se cobra por 1 millón de tokens de entrenamiento (por ejemplo, $0.50 para modelos de hasta 16B de parámetros). Servir modelos ajustados cuesta lo mismo que los modelos base.
- Voz a Texto: El precio es por minuto de audio (por ejemplo, Whisper-v3-large a $0.0015/min).
- Generación de Imágenes: Se factura por paso o por imagen, dependiendo del modelo.
- Despliegues Bajo Demanda: Paga por segundo de GPU para hardware dedicado como NVIDIA H100 ($5.80/hora) o A100 ($2.90/hora), ofreciendo un mayor rendimiento y sin límites de tasa.
Esta estructura flexible permite a los usuarios optimizar los costos en función de sus patrones de uso y escala específicos.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 284.6K
- 2026-1: 355.9K
- 2026-2: 323.2K
- 2026-3: 438.1K
- 2026-4: 720.8K
- 2026-5: 610.7K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos55.9%
- 🇻🇳Vietnam15.8%
- 🇮🇳India11.5%
- 🇷🇺Rusia9.3%
- 🇨🇳China7.5%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 90.6% |
Referral | 7.1% |
Email | 2.3% |
Top keywords
| Keyword | Cost per click |
|---|---|
| baseten | $4.41 |
| fireworks | $0.00 |
| fireworks ai | $0.00 |
| fireworks ai careers | $0.00 |
| kimi ai | $0.38 |
Fireworks AI Videos on YouTube




Fireworks AI

Fireworks AI
Fireworks AI Alternatives
thundercompute
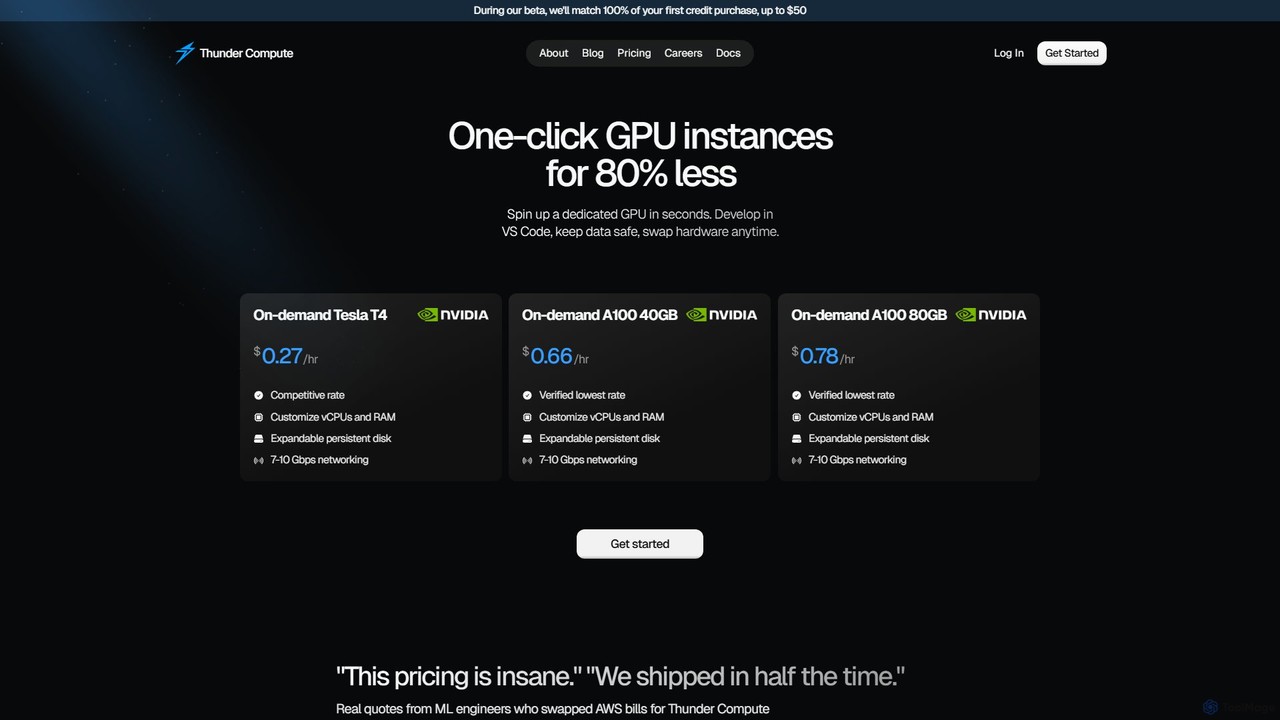
Thunder Compute ofrece una plataforma en la nube de GPU de costo ultrabajo diseñada para desarrolladores de IA y aprendizaje automático. Proporciona instancias de GPU bajo demanda como la NVIDIA A100 y T4 a precios hasta un 80% más bajos que los principales proveedores de la nube. Con características como configuración con un solo clic, integración con VS Code y escalabilidad perfecta, simplifica drásticamente el flujo de trabajo de desarrollo, desde la creación de prototipos hasta la producción, permitiendo a los desarrolladores centrarse en construir modelos en lugar de gestionar la infraestructura.
Aprendizaje Automático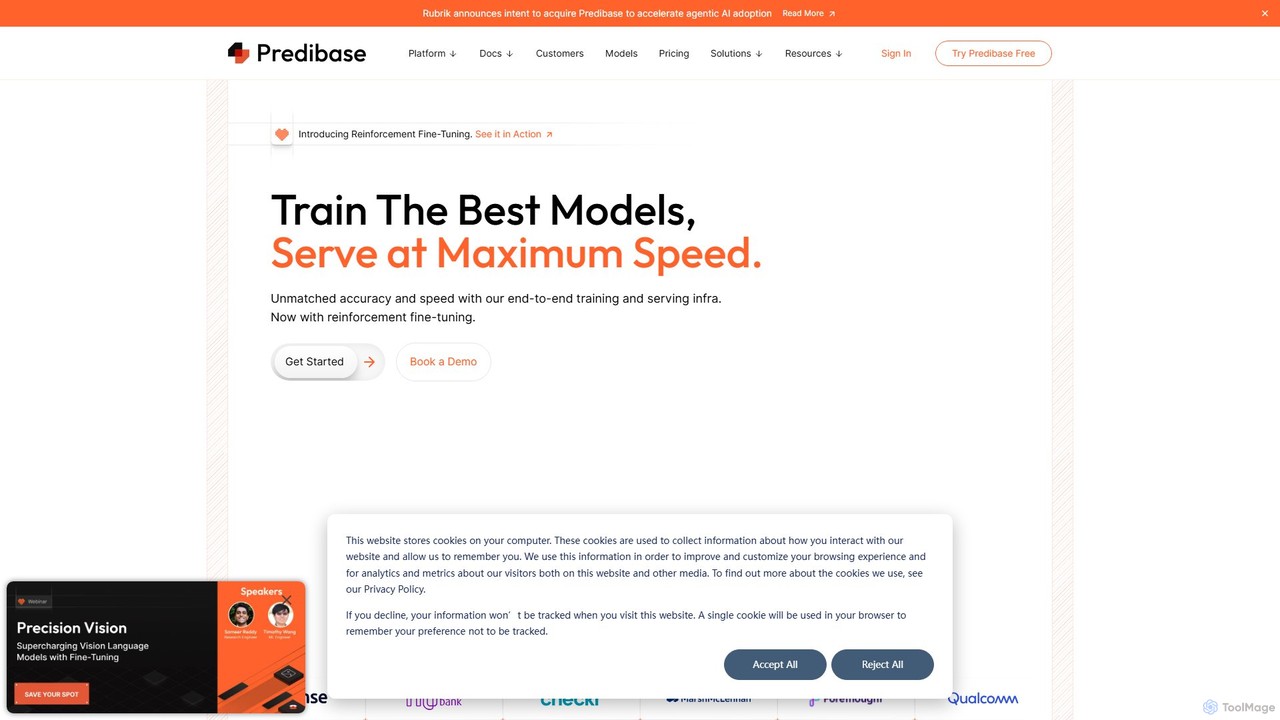
Predibase
Predibase es una plataforma de desarrollo de extremo a extremo para el ajuste fino y el servicio eficientes de Modelos de Lenguaje Grandes (LLM) de código abierto. Permite a los usuarios construir modelos de IA personalizados que superan a grandes modelos propietarios como GPT-4 en tareas específicas, al tiempo que reducen significativamente los costos y la latencia de inferencia. La plataforma cuenta con técnicas avanzadas como el Ajuste Fino por Refuerzo (RFT) y LoRAX para un servicio de alta velocidad y múltiples modelos.
Aprendizaje Automático
Unsloth
Unsloth es una biblioteca de código abierto de alto rendimiento diseñada para acelerar drásticamente el ajuste fino de Modelos de Lenguaje Grandes (LLMs). Permite entrenar hasta 30 veces más rápido utilizando hasta un 90% menos de memoria, haciendo accesible la personalización avanzada de modelos de IA en hardware estándar.
Aprendizaje Automático
Paperspace
Paperspace es una plataforma de computación en la nube de alto rendimiento diseñada para IA y Machine Learning. Proporciona acceso sin esfuerzo a potentes GPU en la nube, cuadernos Jupyter gestionados y una plataforma MLOps completa (Gradient) para construir, entrenar y desplegar modelos. Ideal para desarrolladores, científicos de datos y empresas que buscan acelerar sus flujos de trabajo de IA sin la complejidad de gestionar la infraestructura.
Aprendizaje Automático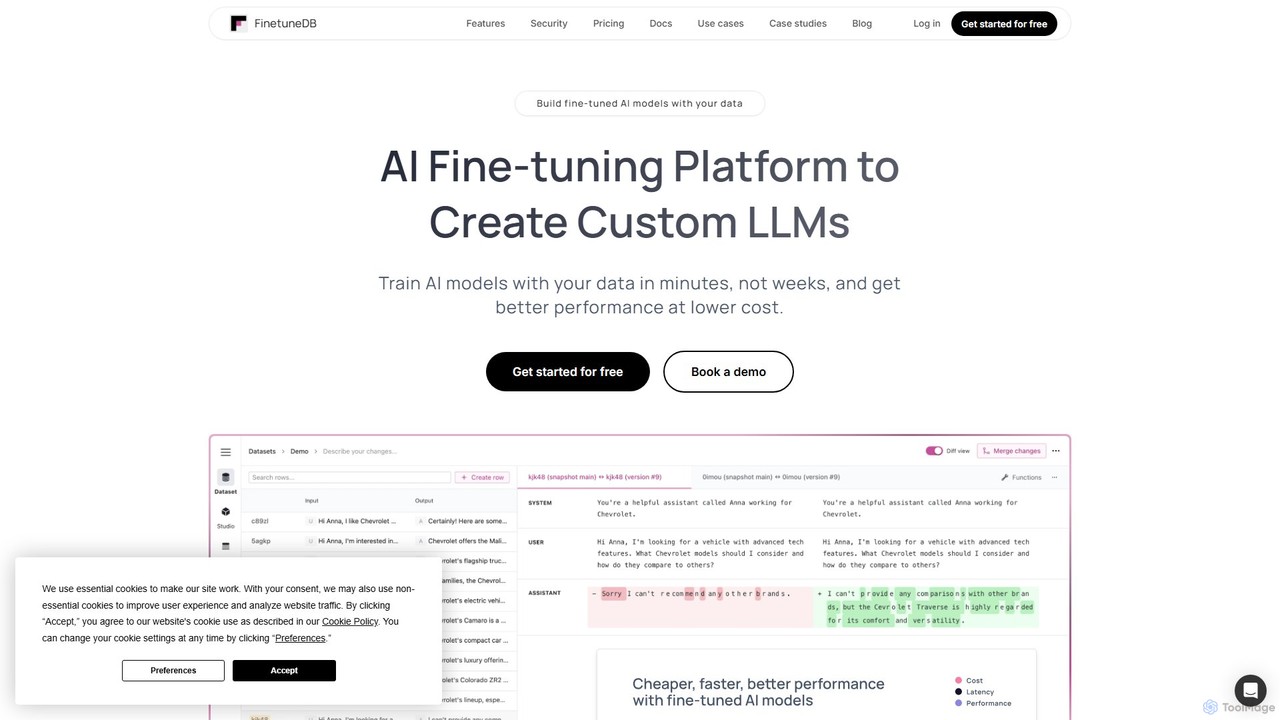
FinetuneDB
FinetuneDB es una plataforma todo en uno de ajuste fino (fine-tuning) de IA para desarrolladores. Simplifica todo el flujo de trabajo para crear Modelos de Lenguaje Grandes (LLMs) personalizados, desde la construcción de conjuntos de datos de alta calidad y el ajuste de modelos como Llama 3 y GPT-4o mini, hasta el despliegue y la evaluación continua en una única plataforma segura.
LlmopsFireworks AI Categories
Fireworks AI Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Predibase
Predibase es una plataforma de desarrollo de extremo a extremo para el ajuste fino y el servicio eficientes de Modelos de Lenguaje Grandes (LLM) de código abierto. Permite a los usuarios construir modelos de IA personalizados que superan a grandes modelos propietarios como GPT-4 en tareas específicas, al tiempo que reducen significativamente los costos y la latencia de inferencia. La plataforma cuenta con técnicas avanzadas como el Ajuste Fino por Refuerzo (RFT) y LoRAX para un servicio de alta velocidad y múltiples modelos.
Aprendizaje Automático
Together AI
Together AI es una plataforma en la nube líder para desarrolladores, que proporciona una infraestructura rápida y rentable para ejecutar, ajustar y entrenar modelos de IA generativa de código abierto. Ofrece una extensa biblioteca de más de 200 modelos, API de inferencia sin servidor, ajuste fino personalizable y clústeres de GPU dedicados, creando una solución integral para construir y escalar aplicaciones de IA.
Infraestructura de GPU
MonsterAPI
MonsterAPI es una plataforma centrada en el desarrollador que simplifica el ajuste fino y el despliegue de modelos de IA generativa de código abierto. Ofrece una interfaz de chat sin código, MonsterGPT, para gestionar tareas complejas, soportando modelos como Llama, SDXL y Whisper. La plataforma proporciona puntos finales de API escalables e infraestructura de GPU de nivel empresarial por una fracción del coste y tiempo habituales, haciendo la IA avanzada accesible para todos los desarrolladores.
Plataforma como Servicio (PaaS)Unsloth
Unsloth es una biblioteca de código abierto de alto rendimiento diseñada para acelerar drásticamente el ajuste fino de Modelos de Lenguaje Grandes (LLMs). Permite entrenar hasta 30 veces más rápido utilizando hasta un 90% menos de memoria, haciendo accesible la personalización avanzada de modelos de IA en hardware estándar.
Aprendizaje AutomáticoFinetuneDB
FinetuneDB es una plataforma todo en uno de ajuste fino (fine-tuning) de IA para desarrolladores. Simplifica todo el flujo de trabajo para crear Modelos de Lenguaje Grandes (LLMs) personalizados, desde la construcción de conjuntos de datos de alta calidad y el ajuste de modelos como Llama 3 y GPT-4o mini, hasta el despliegue y la evaluación continua en una única plataforma segura.
Llmops
Mistral AI
Mistral AI es una empresa líder en IA que proporciona modelos de lenguaje grandes (LLM) de código abierto y de alto rendimiento. Ofrece un versátil asistente de IA, Le Chat, y una potente plataforma para desarrolladores, La Plateforme, centrándose en la configurabilidad, la eficiencia y la privacidad para usuarios tanto individuales como empresariales.
Soluciones Empresariales
fal.ai
Una plataforma de medios generativos para desarrolladores, que proporciona API ultrarrápidas para ejecutar y ajustar modelos avanzados de IA para imágenes, vídeo y 3D. Acceda a modelos de última generación con velocidades de inferencia hasta 4 veces más rápidas.
API e Infraestructura
Scale AI
Scale AI es una plataforma integral que acelera el desarrollo de IA al proporcionar datos de alta calidad, evaluación de modelos y servicios de ajuste fino. Se dirige a laboratorios de IA líderes, empresas y agencias gubernamentales, ofreciendo un completo Motor de Datos para RLHF, etiquetado y generación de datos para potenciar la IA generativa avanzada y los LLMs.
Etiquetado
Cohere
Cohere es una plataforma de IA segura y de nivel empresarial que proporciona a desarrolladores y empresas acceso a modelos de lenguaje grandes y avanzados. Se especializa en la generación de texto, resúmenes, búsqueda semántica y generación aumentada por recuperación (RAG), con un fuerte enfoque en la privacidad de los datos, la personalización mediante fine-tuning y opciones de despliegue flexibles, incluyendo on-premise y nube privada.
Soluciones Empresariales
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
Automatización
AI SDK
AI SDK de Vercel es un kit de herramientas TypeScript gratuito y de código abierto para crear aplicaciones impulsadas por IA. Proporciona una API unificada para integrar sin problemas varios modelos de lenguaje grandes (LLM) como OpenAI, Google y Anthropic. Simplifica el desarrollo con características como respuestas en streaming, componentes de UI generativos y llamada a herramientas, permitiendo a los desarrolladores construir y lanzar características de IA más rápido en frameworks como Next.js, React y Svelte.
Biblioteca
Muapi
Muapi es una potente plataforma de API diseñada para acelerar la generación de imágenes y vídeos con IA. Proporciona a desarrolladores y creadores un acceso unificado a una diversa gama de modelos de IA de vanguardia. Con Muapi, puedes integrar fácilmente funcionalidades como texto a vídeo, imagen a vídeo, generación de personajes consistentes y transferencia de estilo en tus aplicaciones. La plataforma simplifica el proceso de desarrollo, ofreciendo un único punto de acceso API para múltiples tareas avanzadas de IA generativa, respaldado por una estructura de precios clara de pago por uso.
API
Runware
Runware proporciona una API de alto rendimiento y bajo costo para que los desarrolladores integren IA generativa para la creación de imágenes y videos. Aprovechando hardware personalizado y energía renovable, ofrece velocidades de inferencia líderes en la industria para más de 300,000 modelos, incluidos Stable Diffusion, FLUX.1 y Kling. Es una plataforma escalable y fácil de usar que no requiere experiencia en ML, diseñada para construir la próxima generación de aplicaciones nativas de IA.
Plataforma API
Xunfei Spark Agent Development Platform
Una plataforma integral y centralizada de iFlytek para construir, depurar e implementar agentes de IA. Impulsada por el Gran Modelo de Lenguaje Spark, permite a los desarrolladores crear aplicaciones inteligentes a través de una interfaz de bajo código, un extenso mercado de plugins y robustas herramientas de gestión, cubriendo todo el ciclo de vida del agente.
Creador de Agentes
Astria
Una plataforma API centrada en desarrolladores para crear modelos de imagen de IA generativa personalizados. Astria se especializa en el ajuste fino (fine-tuning), permitiendo a los usuarios entrenar la IA en sujetos específicos como personas, objetos o estilos para producir imágenes de alta calidad y altamente personalizadas para diversas aplicaciones, incluyendo sesiones de fotos con IA, probadores virtuales y fotografía de productos.
API
Fireworks AI Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.