

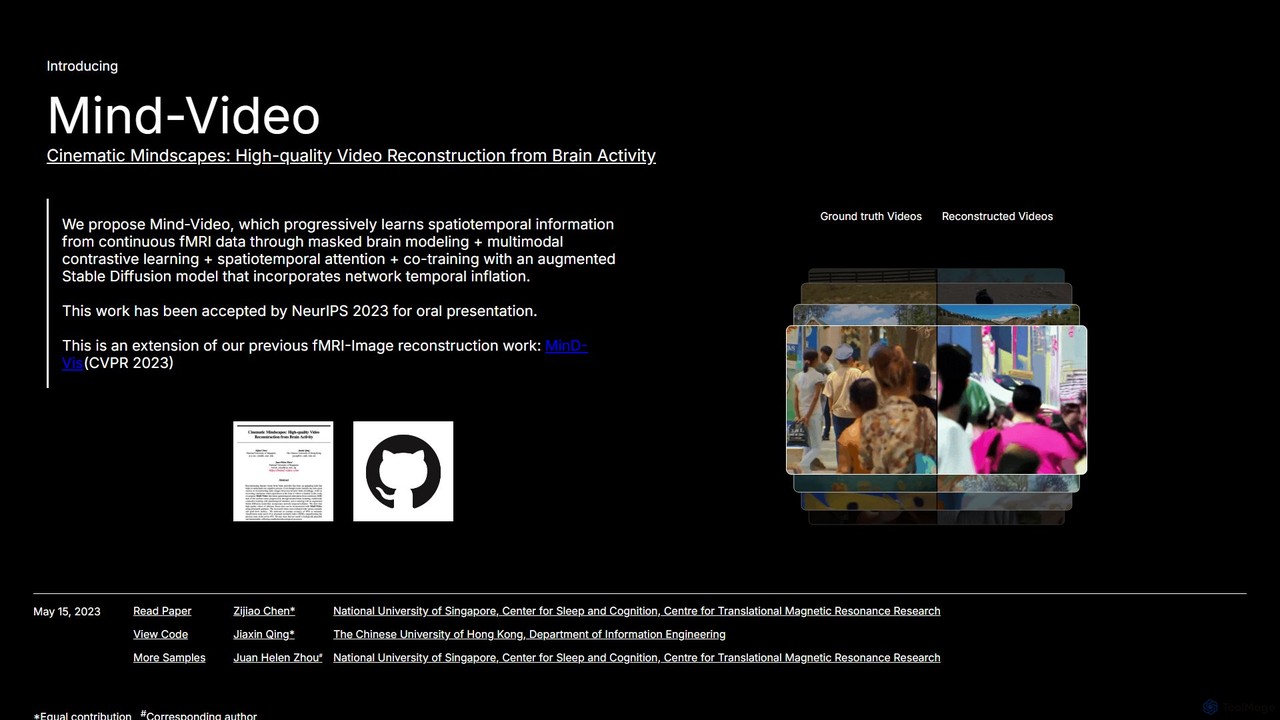
Mind-Video Overview
Mind-Video es un marco de investigación revolucionario desarrollado por investigadores de la Universidad Nacional de Singapur y la Universidad China de Hong Kong. Se sitúa a la vanguardia de la neurociencia y la inteligencia artificial, demostrando la capacidad de reconstruir vídeos continuos de alta calidad a partir de datos de Resonancia Magnética funcional (fMRI) no invasiva. Este proyecto amplía trabajos anteriores sobre la reconstrucción de imágenes estáticas (MinD-Vis) al abordar los complejos desafíos de decodificar experiencias visuales dinámicas a partir de señales cerebrales.
El núcleo de Mind-Video es un innovador pipeline de dos módulos. El primer módulo es un codificador de fMRI que aprende progresivamente información espaciotemporal de la actividad cerebral. Utiliza técnicas avanzadas como el modelado cerebral enmascarado, el aprendizaje contrastivo multimodal y la atención espaciotemporal para capturar tanto el 'qué' como el 'cómo' de la percepción visual. El segundo módulo es un modelo Stable Diffusion aumentado, adaptado específicamente para la generación de vídeo, que se co-entrena con el codificador de fMRI para traducir las características cerebrales aprendidas en videoclips vívidos. Esta arquitectura desacoplada permite un entrenamiento flexible y eficiente, lo que conduce a resultados de vanguardia.
Cómo usar Mind-Video
Mind-Video no es una aplicación comercial lista para usar, sino un marco de investigación con código disponible públicamente. Está destinado a investigadores, desarrolladores y estudiantes en campos como la neurociencia computacional, la IA y las BCI. Para usarlo, normalmente se seguirían estos pasos:
- Acceder a los Recursos del Proyecto: Visite el sitio web oficial del proyecto Mind-Video y navegue a la sección 'Ver Código', que generalmente enlaza a un repositorio de GitHub.
- Configurar el Entorno: Clone el repositorio y configure el entorno computacional requerido. Esto implica instalar bibliotecas específicas de Python, frameworks de aprendizaje profundo (como PyTorch) y otras dependencias mencionadas en la documentación.
- Preparar el Conjunto de Datos: Obtenga conjuntos de datos de fMRI. El propio proyecto utilizó conjuntos de datos públicos como el Human Connectome Project (HCP) y un conjunto de datos específico de fMRI-Vídeo. Los usuarios necesitarían preprocesar sus propios datos de fMRI o datos públicos para que coincidan con el formato de entrada requerido por el modelo.
- Entrenar el Modelo: Siga los scripts e instrucciones proporcionados para entrenar el pipeline de dos módulos. Este es un proceso computacionalmente intensivo que requiere GPUs potentes. El entrenamiento se realiza por etapas: primero se entrena el codificador de fMRI, luego el modelo de difusión y, finalmente, se ajustan juntos.
- Ejecutar la Inferencia: Una vez que el modelo está entrenado, use los scripts de inferencia para introducir nuevos datos de fMRI y generar las reconstrucciones de vídeo correspondientes.
Características principales de Mind-Video
- Reconstrucción de fMRI a Vídeo: La función principal es decodificar las señales de fMRI, que capturan los cambios en el flujo sanguíneo en el cerebro, y traducirlas a contenido de vídeo dinámico.
- Pipeline Desacoplado de Dos Módulos: Presenta una arquitectura flexible con un codificador de fMRI y un modelo Stable Diffusion aumentado, que pueden ser entrenados por separado y luego ajustados conjuntamente para un rendimiento óptimo.
- Aprendizaje Espaciotemporal Progresivo: Emplea un esquema de aprendizaje en múltiples etapas, incluyendo el modelado cerebral enmascarado y el aprendizaje contrastivo multimodal, para construir progresivamente una rica comprensión de las señales cerebrales a lo largo del tiempo.
- Alta Precisión Semántica: Sobresale en la reconstrucción de vídeos que son semánticamente consistentes con los estímulos visuales originales, capturando movimiento, dinámicas de escena y categorías de objetos con alta fidelidad.
- Modelo Biológicamente Plausible e Interpretable: Los mecanismos de atención del modelo se corresponden con redes cerebrales conocidas, como el córtex visual y redes cognitivas superiores, proporcionando valiosos conocimientos sobre la base neural de la percepción visual.
- Investigación de Código Abierto: El código y las metodologías están disponibles públicamente, fomentando más investigación, validación e innovación en el campo de la decodificación cerebral.
Casos de uso para Mind-Video
Las aplicaciones de Mind-Video se encuentran principalmente en la investigación y las tecnologías futuras:
- Neurociencia y Ciencia Cognitiva: Proporciona una herramienta poderosa para estudiar cómo el cerebro procesa, representa y comprende la información visual dinámica. Puede ayudar a validar teorías de la percepción visual y la conciencia.
- Interfaces Cerebro-Computadora (BCI) Avanzadas: Allanar el camino para futuras BCI que podrían permitir a individuos con parálisis severa o trastornos de la comunicación expresar pensamientos complejos o recuerdos visuales.
- Diagnóstico Médico: A largo plazo, tecnologías similares podrían utilizarse para comprender las experiencias visuales subjetivas de pacientes con trastornos neurológicos o psiquiátricos, como alucinaciones en la esquizofrenia o alteraciones visuales tras un ictus.
- Investigación de Sueños e Imaginación: Ofrece una vía potencial para visualizar contenido mental subjetivo como sueños o escenas imaginadas, un objetivo de larga data en psicología y neurociencia.
Ventajas de Mind-Video
- Rendimiento de Vanguardia: Supera significativamente los enfoques anteriores en la reconstrucción de vídeo a partir de fMRI, logrando una precisión del 85% en métricas semánticas, una mejora del 45% sobre el estado del arte anterior.
- Innovación Pionera: Cierra con éxito la brecha entre la reconstrucción de imágenes estáticas y vídeos dinámicos a partir de la actividad cerebral, un importante desafío técnico y científico.
- Visión Científica: El modelo no es solo una 'caja negra'; su interpretabilidad ofrece datos valiosos para los neurocientíficos, confirmando el procesamiento jerárquico de la información visual en el cerebro.
- Abierto y Colaborativo: Al hacer que el código esté disponible, el proyecto fomenta un entorno de investigación colaborativo, permitiendo que otros construyan y amplíen este trabajo innovador.
Precios y planes
Mind-Video es un proyecto de investigación académica y no se ofrece como un producto comercial. El código fuente, el artículo de investigación y los materiales suplementarios están disponibles de forma gratuita para fines académicos y de investigación. No existen planes de precios, suscripciones ni tarifas asociadas con el uso del marco. Los investigadores pueden acceder a los recursos necesarios a través del sitio web oficial del proyecto y los repositorios de código asociados.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 3.0K
- 2026-1: 17.8K
- 2026-2: 7.6K
- 2026-3: 2.3K
- 2026-4: 3.5K
- 2026-5: 3.3K
Geography
Top 5 countries / regions
- 🇧🇷Brasil58.6%
- 🇺🇸Estados Unidos39.1%
- 🇩🇿Argelia2.3%
Top keywords
| Keyword | Cost per click |
|---|---|
| mind video | $0.15 |
| mindvideo | $0.36 |
| mind video ai | $0.19 |
| mindvideo ai | $0.57 |
| mindvideo.ai | $0.00 |
Mind-Video Alternatives
Papers with Code
Papers with Code es un recurso gratuito y abierto para investigadores y desarrolladores de aprendizaje automático. Conecta artículos científicos con su código de fuente abierta correspondiente, haciendo la investigación más accesible y reproducible. La plataforma cuenta con tablas de clasificación de vanguardia, conjuntos de datos explorables y una completa colección de investigación en IA, ayudando a los usuarios a seguir el progreso, encontrar implementaciones y acelerar su trabajo. Es una herramienta esencial para cualquiera en la comunidad de IA/ML.
Aprendizaje Automático
ComfyUI
ComfyUI es una potente interfaz gráfica de usuario basada en nodos, gratuita y de código abierto para la IA generativa. Ofrece un control y una flexibilidad inigualables para crear flujos de trabajo complejos para generar imágenes, vídeos, activos 3D y audio, diseñada para artistas, desarrolladores e investigadores.
Modelado 3D
AnimateDiff
AnimateDiff es una herramienta impulsada por IA que genera videos cortos y animaciones a partir de indicaciones de texto o imágenes estáticas. Al integrar un módulo de movimiento con modelos de Stable Diffusion, da vida a tus ideas creativas, creando bucles fluidos, animaciones de personajes y efectos visuales dinámicos sin esfuerzo.
Animación
Google Labs
Google Labs es el centro oficial para los experimentos de IA de Google, que ofrece acceso temprano a una diversa gama de herramientas creativas y de productividad. Los usuarios pueden explorar, probar y dar su opinión sobre tecnologías de vanguardia como Gemini y Veo, influyendo directamente en el futuro de los productos de IA de Google. Es un campo de juego para creadores, desarrolladores y entusiastas para experimentar la vanguardia de la innovación en inteligencia artificial, desde la creación de películas con IA y la generación de música hasta asistentes de codificación y herramientas de diseño.
Herramientas Experimentales
Leonardo.ai
Leonardo.ai es una completa suite de IA generativa para crear activos visuales de alta calidad. Ofrece una amplia gama de herramientas, incluyendo generación de imágenes y video, AI Canvas, texturizado 3D y numerosos modelos afinados. Ideal para creadores individuales, equipos colaborativos y desarrolladores, enfatiza la calidad, la velocidad y la consistencia de estilo.
Arte GenerativoMind-Video Categories
Mind-Video Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Papers with Code
Papers with Code es un recurso gratuito y abierto para investigadores y desarrolladores de aprendizaje automático. Conecta artículos científicos con su código de fuente abierta correspondiente, haciendo la investigación más accesible y reproducible. La plataforma cuenta con tablas de clasificación de vanguardia, conjuntos de datos explorables y una completa colección de investigación en IA, ayudando a los usuarios a seguir el progreso, encontrar implementaciones y acelerar su trabajo. Es una herramienta esencial para cualquiera en la comunidad de IA/ML.
Aprendizaje AutomáticoComfyUI
ComfyUI es una potente interfaz gráfica de usuario basada en nodos, gratuita y de código abierto para la IA generativa. Ofrece un control y una flexibilidad inigualables para crear flujos de trabajo complejos para generar imágenes, vídeos, activos 3D y audio, diseñada para artistas, desarrolladores e investigadores.
Modelado 3DAnimateDiff
AnimateDiff es una herramienta impulsada por IA que genera videos cortos y animaciones a partir de indicaciones de texto o imágenes estáticas. Al integrar un módulo de movimiento con modelos de Stable Diffusion, da vida a tus ideas creativas, creando bucles fluidos, animaciones de personajes y efectos visuales dinámicos sin esfuerzo.
Animación
Nous Research
Nous Research es una organización de investigación de IA dedicada a desarrollar modelos de lenguaje de código abierto y centrados en el ser humano. Se enfocan en democratizar la IA a través de infraestructura de entrenamiento descentralizada, arquitecturas de modelo avanzadas y potentes API de inferencia, desafiando el enfoque convencional de modelos cerrados.
Computación Descentralizada
Seed
Seed es la iniciativa de investigación avanzada en IA de ByteDance, enfocada en construir inteligencia artificial general. Desarrollan modelos fundacionales en diversos dominios, incluyendo multimodal, visión, habla, robótica y LLMs, impulsando la innovación tanto en la investigación académica como en aplicaciones del mundo real.
Modelos Fundacionales
pinokio
Pinokio es un navegador de escritorio que te permite instalar, ejecutar y controlar aplicaciones de IA y apps basadas en terminal en tu ordenador con un solo clic. Simplifica la compleja configuración de modelos de IA de código abierto al automatizar la creación de entornos, la gestión de dependencias y la ejecución. Esto permite a usuarios de todos los niveles experimentar con potentes herramientas de IA localmente, garantizando la privacidad y el control total sobre sus datos.
Despliegue de Modelo
Stability AI
Stability AI es una empresa líder en IA generativa de código abierto que desarrolla modelos fundacionales para crear imágenes, vídeo, audio, activos 3D y más. Proporciona herramientas potentes y accesibles para creadores, desarrolladores y empresas, destacando la mundialmente reconocida serie de modelos Stable Diffusion. Ofrece opciones de despliegue flexibles, incluyendo APIs, autoalojamiento y servicios en la nube.
API
Allen Institute for AI (AI2)
El Allen Institute for AI (AI2) es un instituto de investigación sin fines de lucro dedicado a construir IA revolucionaria para el bien común. Se enfoca en crear modelos de lenguaje grandes verdaderamente de código abierto como OLMo, conjuntos de datos completos y herramientas de IA especializadas para avanzar en la investigación científica y abordar los principales desafíos globales en áreas como la ciencia climática, la conservación y la medicina.
Conjuntos de datos
Fooocus
Fooocus es una herramienta de generación de imágenes por IA gratuita y de código abierto que simplifica el proceso de creación de imágenes de alta calidad con Stable Diffusion. Combina la facilidad de uso con potentes funciones como inpainting, control de estilo y cambio de caras, haciéndola accesible tanto para principiantes como para usuarios avanzados.
Arte Digital
Zyphra
Zyphra es una empresa de investigación de IA de código abierto que desarrolla modelos fundacionales eficientes y de alto rendimiento. Proporcionan modelos de lenguaje pequeños (SLM) de última generación, sistemas de texto a voz (TTS) y modelos de razonamiento especializados para desarrolladores e investigadores, centrándose en democratizar la IA avanzada para aplicaciones en dispositivos y empresariales.
Desarrollo de Modelo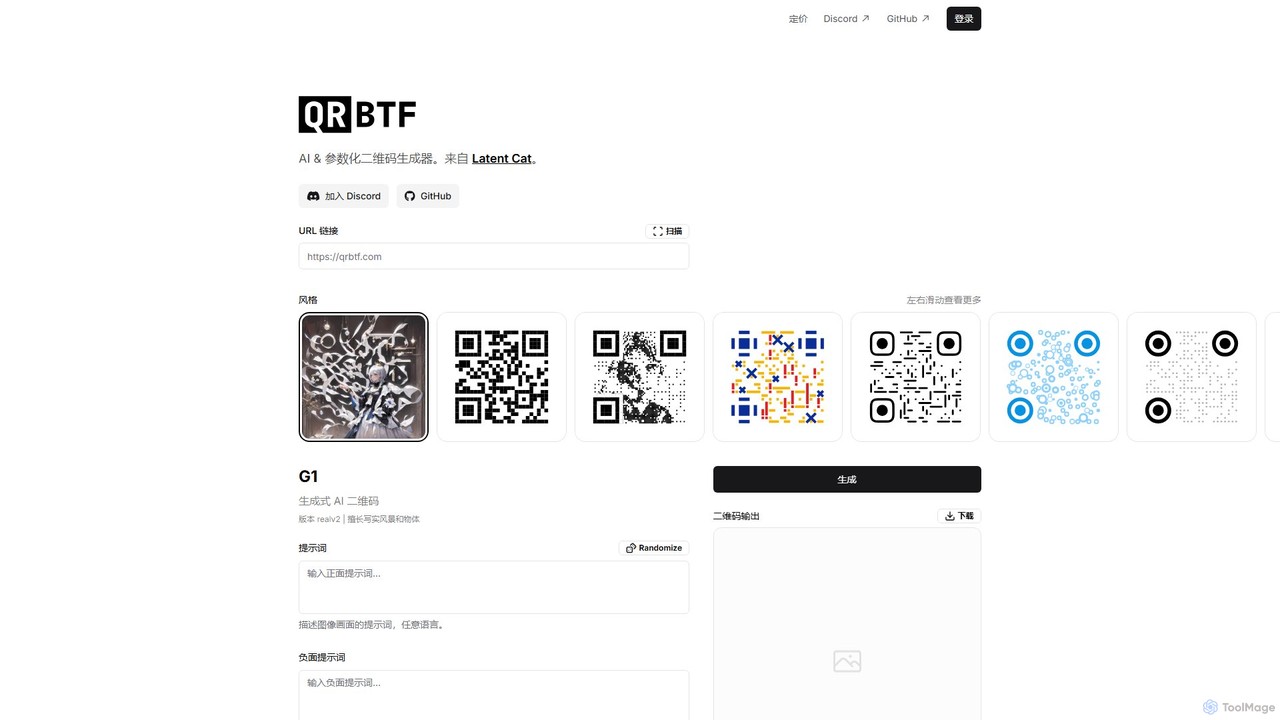
QRBTF
QRBTF es un innovador generador de códigos QR con IA que transforma los códigos QR estándar en impresionantes obras de arte. Aprovechando la IA generativa y los controles paramétricos, los usuarios pueden incrustar códigos QR sin problemas en bellas imágenes basadas en prompts de texto, creando diseños visualmente atractivos y escaneables para marketing, arte y uso personal.
Generador de Arte con IA
Stable Horde
Stable Horde es un clúster distribuido, de código abierto y de colaboración masiva (crowdsourcing) para la generación de imágenes y texto con IA. Permite a cualquiera acceder a potentes modelos de IA aprovechando la potencia de cálculo aportada por voluntarios de una comunidad global, sin necesidad de hardware propio de alta gama.
API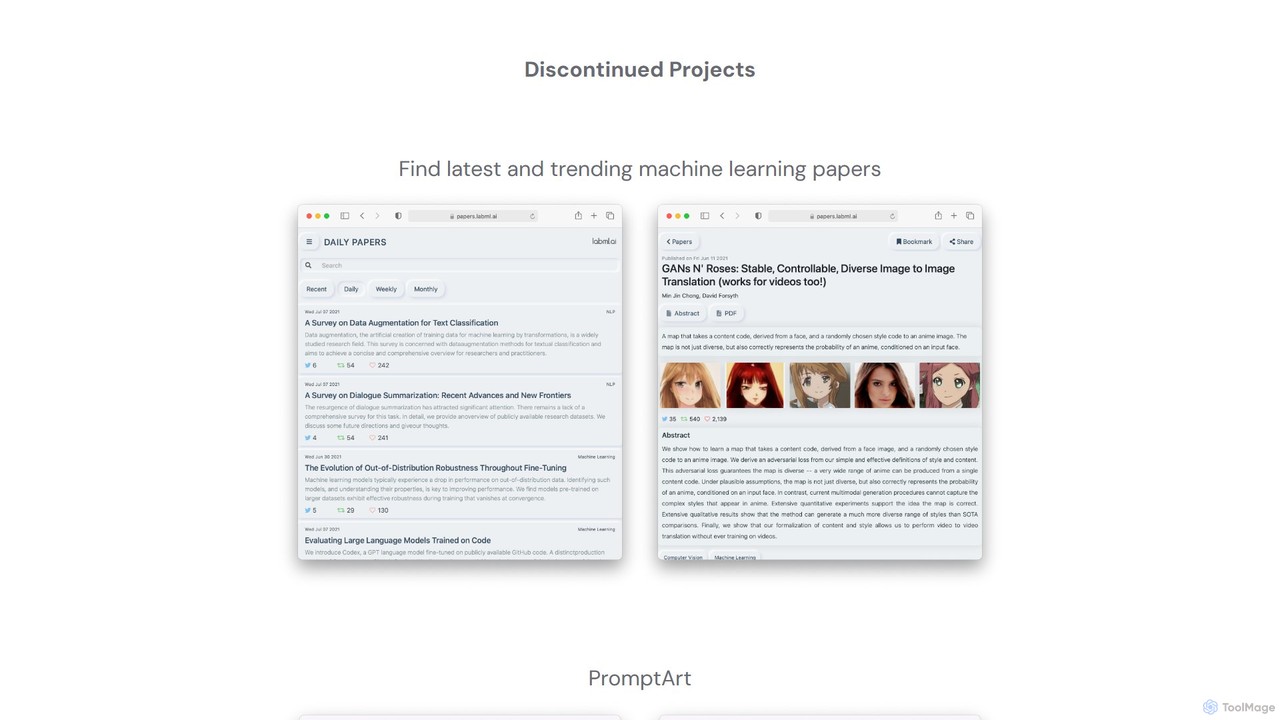
PromptArt
PromptArt es una herramienta de generación de arte impulsada por IA del laboratorio de investigación labml.ai. Permite a los usuarios transformar descripciones de texto en imágenes únicas y visualmente atractivas. Diseñada tanto para artistas como para investigadores de aprendizaje automático, proporciona una plataforma para experimentar con modelos generativos, ajustar parámetros y explorar el potencial creativo de la IA.
Herramientas Creativas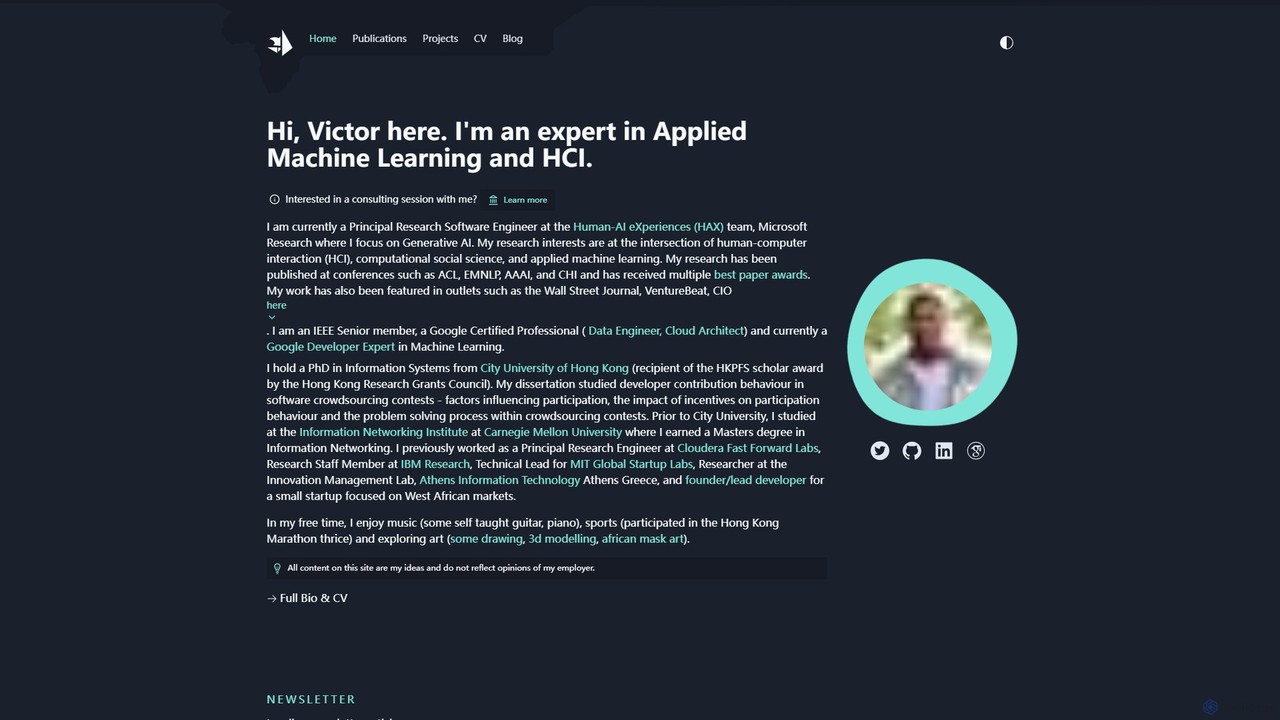
victordibia
Un centro de recursos integral de Victor Dibia, un investigador líder en ML Aplicado e HCI. Presenta herramientas de IA de código abierto como AutoGen Studio y LIDA, artículos en profundidad, trabajos de investigación y charlas sobre IA generativa, sistemas multiagente e interacción humano-computadora. Una plataforma valiosa para desarrolladores, investigadores y entusiastas de la IA.
Visualización de Datos
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
Automatización
Mind-Video Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.