
Tidepool Overview
Tidepool, ampliamente conocido por su nombre anterior, Aquarium, era una sofisticada plataforma de MLOps diseñada para acelerar el desarrollo y despliegue de sistemas de IA de producción de alta calidad. Su misión principal era empoderar a los equipos de aprendizaje automático proporcionando herramientas avanzadas para gestionar, analizar y mejorar sus conjuntos de datos, con un fuerte enfoque en aplicaciones de visión por computadora (CV) y procesamiento del lenguaje natural (PNL). La plataforma se construyó sobre el principio de la IA centrada en los datos, que postula que la calidad de los datos es primordial para el rendimiento del modelo.
Tidepool permitía a los desarrolladores ir más allá de simplemente ajustar las arquitecturas de los modelos y, en su lugar, centrarse en mejorar sistemáticamente sus datos de entrenamiento. Proporcionaba un entorno unificado para encontrar y solucionar problemas dentro de los conjuntos de datos y las predicciones de los modelos, como errores de etiquetado, desequilibrios de datos y casos de fallo del modelo. Al identificar los segmentos de datos más problemáticos, los equipos podían priorizar sus esfuerzos de curación y anotación de datos, lo que conducía a modelos de IA más robustos y precisos en menos tiempo.
Cómo usar Tidepool
El flujo de trabajo típico en la plataforma Tidepool implicaba varios pasos clave para mejorar iterativamente un modelo de aprendizaje automático:
- Integración de datos: Los usuarios comenzaban subiendo sus conjuntos de datos (por ejemplo, imágenes, documentos de texto) y las predicciones del modelo correspondientes a la plataforma a través de su API o interfaz web.
- Visualización del rendimiento: Tidepool procesaba esta información, ofreciendo ricas visualizaciones del conjunto de datos y del rendimiento del modelo. Esto permitía a los equipos explorar dónde el modelo tenía éxito y dónde fallaba.
- Análisis de errores: El potente motor de análisis de errores de la plataforma sacaba a la luz y agrupaba automáticamente los puntos de datos problemáticos. Por ejemplo, podía identificar que el modelo de detección de objetos de un coche autónomo falla sistemáticamente en reconocer a los peatones en condiciones de lluvia.
- Curación de datos: Basándose en los conocimientos del análisis de errores, los equipos podían utilizar las herramientas de Tidepool para filtrar, etiquetar y seleccionar los datos de mayor impacto para re-etiquetado o aumento. Este bucle de aprendizaje activo aseguraba que los recursos de anotación se gastaran en los datos que mejorarían más significativamente el modelo.
- Reentrenamiento e iteración: El conjunto de datos recién curado y mejorado se utilizaba para reentrenar el modelo. Este ciclo iterativo de subir predicciones, analizar errores y curar datos se repetía hasta alcanzar el rendimiento deseado del modelo.
Características principales de Tidepool
- MLOps centrado en datos: Una plataforma unificada para gestionar todo el ciclo de vida de los datos de aprendizaje automático, desde la ingesta hasta la curación.
- Análisis avanzado de errores: Identificaba y agrupaba automáticamente los fallos del modelo, permitiendo a los equipos comprender rápidamente las causas raíz del bajo rendimiento.
- Curación inteligente de datos: Flujos de trabajo de aprendizaje activo para ayudar a seleccionar los datos más valiosos para la anotación, maximizando el impacto de los esfuerzos de etiquetado.
- Visualización rica de datos y modelos: Herramientas interactivas para explorar conjuntos de datos complejos y predicciones de modelos, incluyendo soporte para cuadros delimitadores de imágenes, máscaras de segmentación semántica e incrustaciones de texto.
- Especializado para CV y PNL: Funciones y flujos de trabajo a medida diseñados específicamente para los desafíos de las tareas de visión por computadora y procesamiento del lenguaje natural.
- Centro de colaboración: Proporcionaba un espacio de trabajo compartido para que científicos de datos, ingenieros de ML y anotadores colaboraran en la mejora de la calidad del modelo.
Casos de uso para Tidepool
Tidepool era valioso en diversas industrias que dependen de una IA de alto rendimiento:
- Sistemas autónomos: Los equipos que construyen coches autónomos o drones utilizaban Tidepool para encontrar y solucionar casos límite en sus modelos de percepción, mejorando la seguridad y la fiabilidad.
- Imágenes médicas: Hospitales e instituciones de investigación podían mejorar las herramientas de diagnóstico impulsadas por IA identificando y corrigiendo clasificaciones erróneas en radiografías, resonancias magnéticas o portaobjetos de patología.
- Fintech: Se utilizaba para mejorar los modelos de detección de fraudes analizando datos de transacciones e identificando patrones en los que el modelo funcionaba mal.
- Moderación de contenido: Las plataformas de redes sociales y de contenido podían refinar sus modelos para detectar contenido dañino centrándose en ejemplos ambiguos o dependientes del contexto.
Ventajas de Tidepool
La principal ventaja de Tidepool era su capacidad para acortar significativamente el tiempo necesario para construir una IA lista para producción. Al centrarse en los datos, permitía mejoras de modelo más eficientes y específicas. Sus herramientas especializadas para CV y PNL proporcionaban conocimientos más profundos que las plataformas de datos genéricas. Este enfoque centrado en los datos a menudo conducía a ganancias más sustanciales en la precisión y robustez del modelo en comparación con los esfuerzos puramente centrados en el modelo o en el código.
Precios y planes
Tidepool era un producto comercial que se ofrecía con planes de precios a nivel empresarial adaptados a las necesidades específicas de los equipos de IA. El precio dependía típicamente de factores como el volumen de datos, el número de usuarios y el nivel de soporte requerido.
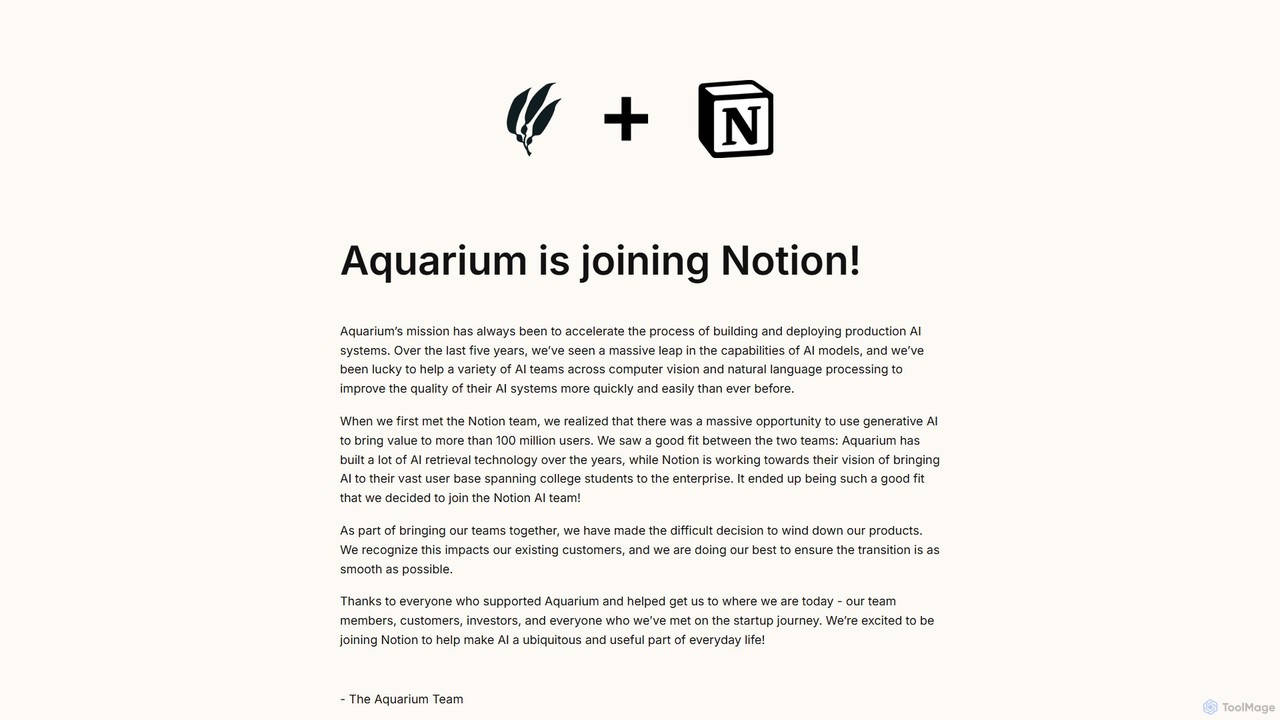
Tenga en cuenta: El equipo de Tidepool (Aquarium) fue adquirido por Notion. Como resultado, el producto independiente de Tidepool ha sido descontinuado y ya no está disponible para nuevos clientes. La experiencia del equipo en tecnología de recuperación de IA se está integrando ahora en los productos de Notion.
Tidepool Alternatives
DataChain
DataChain es una plataforma orientada a desarrolladores para gestionar "Heavy Data": conjuntos de datos multimodales, no estructurados y a gran escala. Permite a los equipos curar, enriquecer y versionar datos como vídeos, imágenes, audio y PDFs para aplicaciones de IA, con pipelines de ETL basados en Python, linaje de datos completo y procesamiento escalable desde el IDE local a la nube.
Base de datos
Supervised.co
Supervised.co es una plataforma de extremo a extremo para construir, entrenar e implementar modelos de aprendizaje automático supervisado. Simplifica el ciclo de vida de MLOps con anotación de datos integrada, entrenamiento de modelos automatizado y despliegue de API con un solo clic, capacitando a los equipos para crear soluciones de IA de alto rendimiento de manera eficiente.
Anotación de Datos
Lightning AI
Lightning AI es una plataforma en la nube diseñada para construir, entrenar y desplegar modelos de IA a escala. Combina el popular framework de código abierto PyTorch Lightning con Lightning AI Studio, un entorno colaborativo basado en navegador sin necesidad de configuración. Accede a potentes GPUs, escala de un portátil a la nube sin problemas y acelera todo tu flujo de trabajo de desarrollo de IA.
Plataforma como Servicio (PaaS)
Label Your Data
Un servicio y plataforma profesional de anotación de datos que proporciona conjuntos de datos etiquetados de alta calidad y precisión para el aprendizaje automático. Admite diversos tipos de datos como imágenes, video, texto y audio, ofreciendo precios flexibles, una plataforma de autoservicio y servicios totalmente gestionados para escalar proyectos de IA de cualquier tamaño.
Gestión de Datos
Lightly
Lightly es una suite integral de visión por computadora para equipos de aprendizaje automático. Agiliza todo el ciclo de vida del desarrollo de modelos, desde la curación y selección inteligente de datos en dispositivos de borde hasta el preentrenamiento y ajuste fino de modelos eficientes y sin etiquetas. Al centrarse en los datos más valiosos, Lightly ayuda a construir modelos de IA más precisos y listos para producción más rápido, reduciendo significativamente los costos de etiquetado y almacenamiento de datos.
Gestión de DatosTidepool Categories
Tidepool Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Roboflow
Roboflow es una plataforma de visión por computadora de extremo a extremo para desarrolladores y empresas. Proporciona un conjunto completo de herramientas para construir, entrenar e implementar modelos de visión por computadora a escala. Desde la creación de conjuntos de datos y el etiquetado colaborativo hasta el entrenamiento de modelos con un solo clic y la implementación en la nube o en dispositivos de borde, Roboflow agiliza todo el ciclo de vida de MLOps para la IA de visión, capacitando a más de un millón de ingenieros para dar a su software el sentido de la vista.
Etiquetado de Datos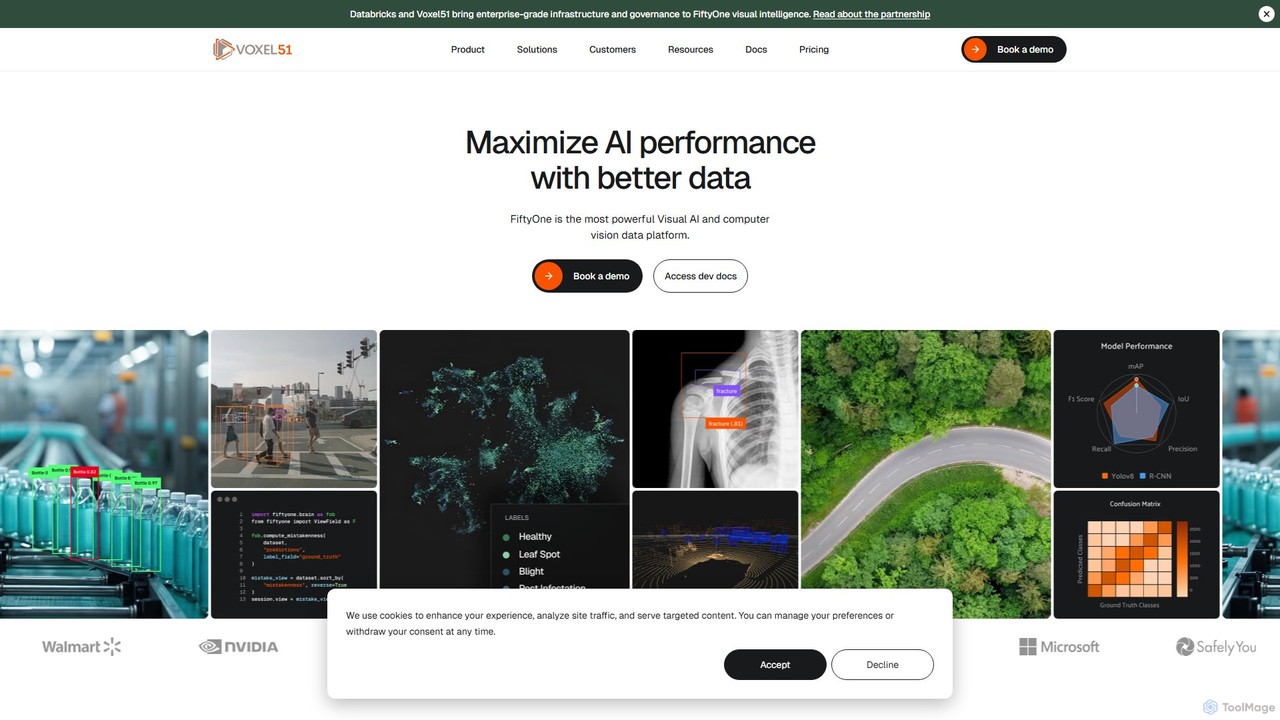
Voxel51
Voxel51 proporciona FiftyOne, una plataforma de visión por computadora e IA multimodal de nivel empresarial. Permite a los desarrolladores y científicos de datos curar, visualizar y evaluar conjuntos de datos complejos, lo que conduce a modelos de mayor rendimiento. Al centrarse en la IA centrada en los datos, FiftyOne agiliza los flujos de trabajo para la anotación de datos, la mejora de la calidad y el análisis de modelos, acelerando todo el ciclo de vida del desarrollo.
MLOpsSupervised.co
Supervised.co es una plataforma de extremo a extremo para construir, entrenar e implementar modelos de aprendizaje automático supervisado. Simplifica el ciclo de vida de MLOps con anotación de datos integrada, entrenamiento de modelos automatizado y despliegue de API con un solo clic, capacitando a los equipos para crear soluciones de IA de alto rendimiento de manera eficiente.
Anotación de DatosLightning AI
Lightning AI es una plataforma en la nube diseñada para construir, entrenar y desplegar modelos de IA a escala. Combina el popular framework de código abierto PyTorch Lightning con Lightning AI Studio, un entorno colaborativo basado en navegador sin necesidad de configuración. Accede a potentes GPUs, escala de un portátil a la nube sin problemas y acelera todo tu flujo de trabajo de desarrollo de IA.
Plataforma como Servicio (PaaS)Label Your Data
Un servicio y plataforma profesional de anotación de datos que proporciona conjuntos de datos etiquetados de alta calidad y precisión para el aprendizaje automático. Admite diversos tipos de datos como imágenes, video, texto y audio, ofreciendo precios flexibles, una plataforma de autoservicio y servicios totalmente gestionados para escalar proyectos de IA de cualquier tamaño.
Gestión de DatosLightly
Lightly es una suite integral de visión por computadora para equipos de aprendizaje automático. Agiliza todo el ciclo de vida del desarrollo de modelos, desde la curación y selección inteligente de datos en dispositivos de borde hasta el preentrenamiento y ajuste fino de modelos eficientes y sin etiquetas. Al centrarse en los datos más valiosos, Lightly ayuda a construir modelos de IA más precisos y listos para producción más rápido, reduciendo significativamente los costos de etiquetado y almacenamiento de datos.
Gestión de Datos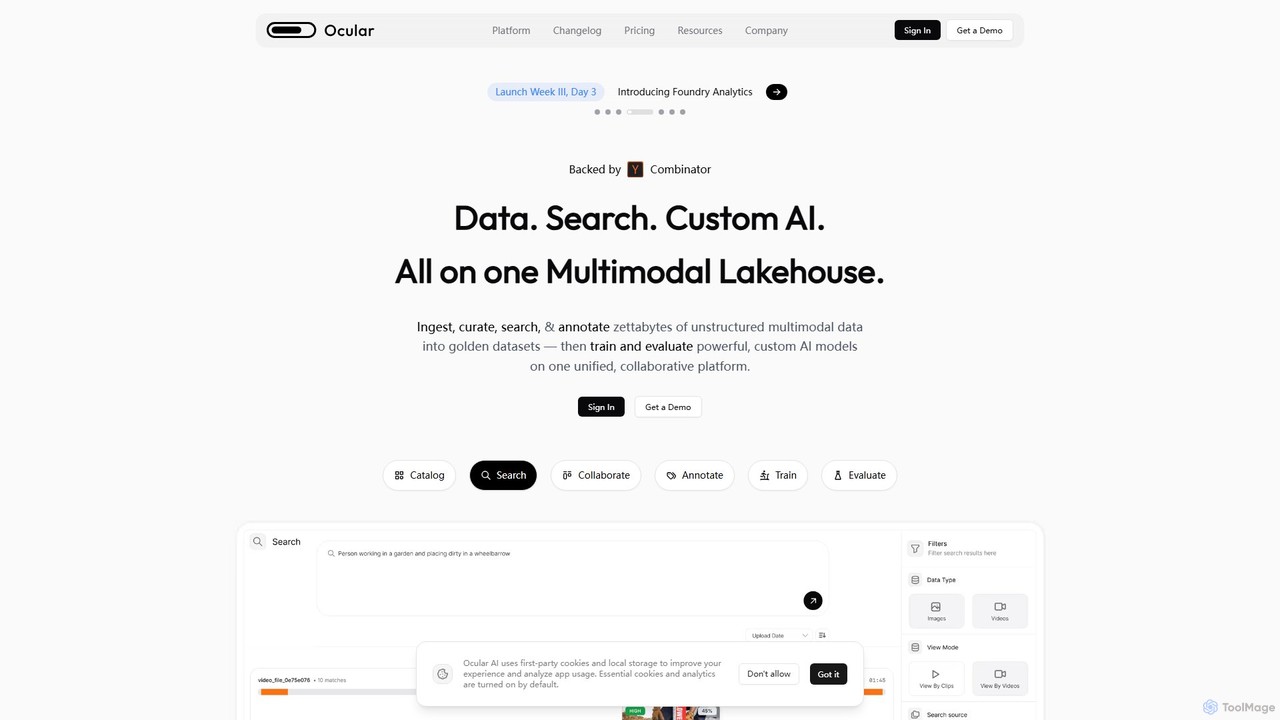
Ocular AI
Ocular AI es una plataforma integral para la era de la IA multimodal, que permite a los equipos ingerir, curar, buscar y anotar zettabytes de datos no estructurados. Proporciona un lakehouse multimodal unificado, búsqueda avanzada y herramientas para entrenar y evaluar modelos de IA personalizados, acelerando todo el ciclo de vida del desarrollo de la IA.
Reconocimiento de Imágenes
balise
Balise es una plataforma de anotación de datos impulsada por IA, diseñada para agilizar la creación de datos de entrenamiento de alta calidad para modelos de machine learning. Ofrece un entorno colaborativo con herramientas inteligentes para etiquetar imágenes, texto, video y audio, acelerando el ciclo de desarrollo para proyectos de visión por computadora y PNL.
Anotación
TensorFlow
TensorFlow es una plataforma de código abierto de extremo a extremo para el aprendizaje automático desarrollada por Google. Proporciona un ecosistema completo y flexible de herramientas, bibliotecas y recursos comunitarios que permite a investigadores y desarrolladores crear e implementar aplicaciones impulsadas por ML. Desde principiantes hasta expertos, TensorFlow ofrece API intuitivas de alto nivel para la creación sencilla de modelos y potentes API de bajo nivel para la investigación avanzada, lo que permite la implementación en servidores, dispositivos de borde y navegadores.
Frameworks
Labellerr
Labellerr es una plataforma de etiquetado y anotación de datos impulsada por IA, diseñada para acelerar el desarrollo de modelos de Visión, PNL y LLM. Ofrece anotación automatizada, garantía de calidad inteligente e integración MLOps perfecta para entregar etiquetas con un 99% de precisión hasta 99 veces más rápido, reduciendo significativamente el tiempo de preparación de datos y los costos de desarrollo para los equipos de IA.
Operaciones de Machine Learning
Anyscale
Anyscale es una plataforma de computación totalmente gestionada para escalar cargas de trabajo de IA y Python. Construida sobre el framework de código abierto Ray por sus creadores originales, permite a los desarrolladores construir, ejecutar y escalar aplicaciones distribuidas, desde el entrenamiento de LLMs hasta el procesamiento de datos, con un rendimiento optimizado y eficiencia de costes en cualquier nube.
MLOps
AI Superior
AI Superior es una empresa alemana de desarrollo y consultoría de IA que ofrece soluciones de IA personalizadas de extremo a extremo. Se especializan en visión por computadora, PNL, análisis predictivo e IA generativa para diversas industrias, aprovechando un equipo de expertos con nivel de doctorado para transformar los desafíos empresariales en aplicaciones escalables y basadas en datos.
Consultoría de IA
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
Automatización
remyx
Remyx es una plataforma de ExperimentOps diseñada para el desarrollo de IA. Ayuda a los equipos de IA y de producto a operacionalizar el conocimiento proporcionando un estudio colaborativo para experimentos estructurados, reutilizables y rastreables. Al centrarse en métricas personalizadas y bucles de aprendizaje guiados, Remyx acelera el ciclo de vida del desarrollo de IA, asegurando que los sistemas de IA estén alineados con los objetivos de negocio del mundo real y el impacto en el usuario.
Experimentación
thinkaiagency
thinkaiagency es una agencia de desarrollo especializada que transforma ideas en Productos Mínimos Viables (MVP) listos para el mercado en solo 2-4 semanas. Se centran en construir aplicaciones web y móviles escalables con integración avanzada de IA, sirviendo a startups y empresas con un enfoque rápido, rentable y dirigido por expertos. Sus servicios abarcan desde LLMs personalizados y visión por computadora hasta análisis predictivo.
Desarrollo de Modelo
Tidepool Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.