ToolMage
Connexion

AI TOOL COMPARISON

Bright Data vs Crawly

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Aperçu du produit

Bright Data Aperçu du produit

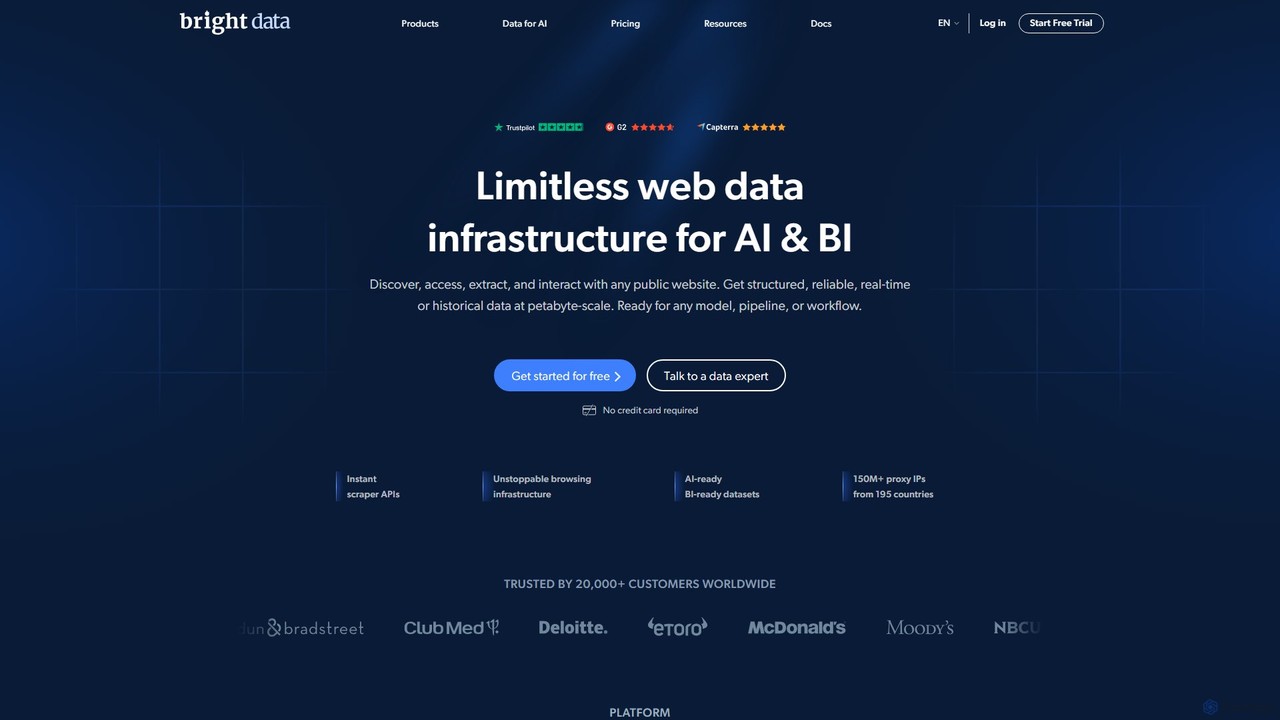
Bright Data est la première plateforme mondiale de données web, offrant une suite complète d'outils comprenant des réseaux de proxys, des scrapers web alimentés par l'IA et des ensembles de données prêts à l'emploi. Elle permet aux entreprises de collecter de grandes quantités de données web publiques pour l'entraînement de l'IA, les études de marché et la veille concurrentielle.

Preview

Crawly Aperçu du produit

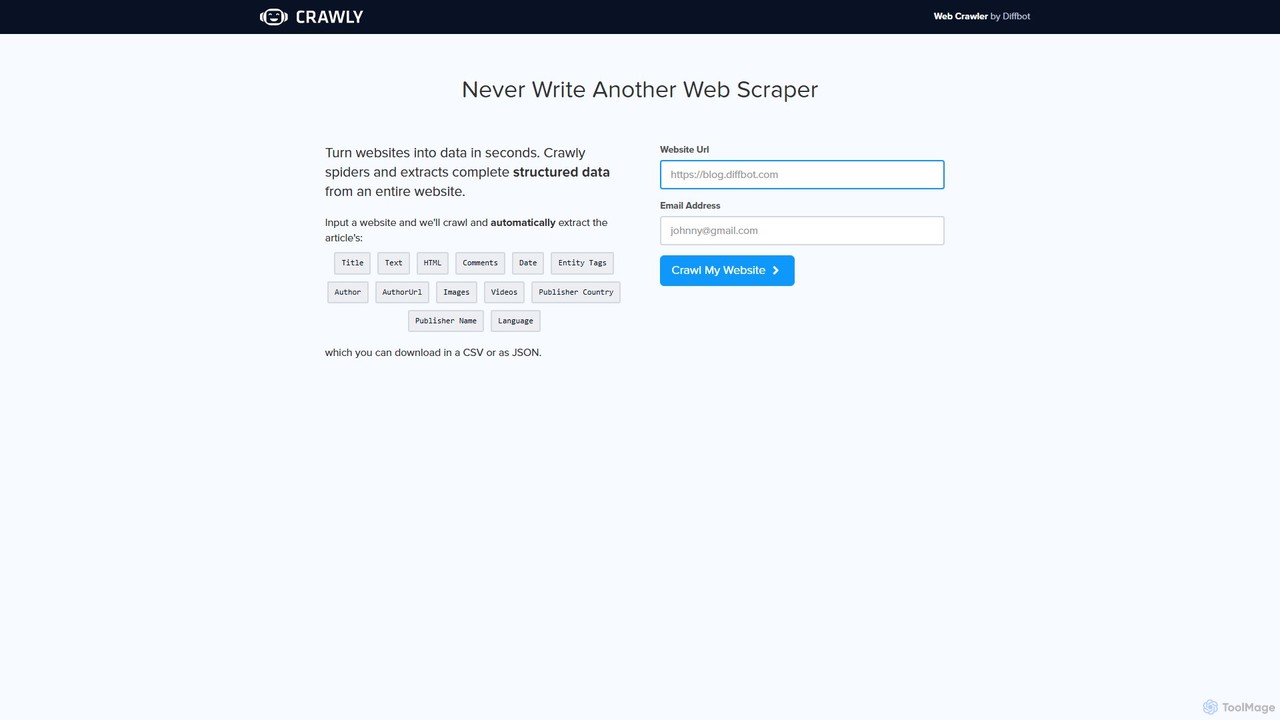
Crawly est un robot d'indexation web alimenté par l'IA de Diffbot qui extrait automatiquement des données structurées de sites web entiers. Il suffit d'entrer une URL, et Crawly parcourt le site pour extraire des informations clés comme des articles, des produits et des discussions, les convertissant en données JSON ou CSV propres sans aucun codage requis.

Preview

Données clés

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Bright Data VS Crawly — Données clés
Données clésBright DataCrawly
Pricing modelPaidFreemium
Product typeWebWeb
Primary focusInformatique décisionnelleWeb scraping
Publics et métiersNon vérifiéNon vérifié
CatégoriesInformatique décisionnelle · Web scraping · API · Étude de marchéWeb scraping · API · Étude de marché · Automatisation
Added12 août 202510 août 2025
Mis à jour19 nov. 202619 nov. 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Bright Data

Bright Data s'impose comme la plateforme de données web n°1 au monde, approuvée par plus de 20 000 organisations dans presque tous les secteurs. Elle fournit une solution robuste et tout-en-un pour découvrir, accéder et extraire des données web publiques à n'importe quelle échelle. Que vous ayez besoin de données en temps réel ou historiques, l'infrastructure de Bright Data est conçue pour fournir des informations structurées et fiables, prêtes pour n'importe quel modèle, pipeline ou flux de travail. La plateforme est conçue pour alimenter le développement de l'IA, soutenir les études de marché, surveiller les actifs en ligne et permettre une prise de décision basée sur les données.

Comment utiliser Bright Data

Bright Data offre une plateforme flexible qui peut être utilisée de plusieurs manières en fonction de vos besoins :

  1. Réseaux de proxys : Intégrez les réseaux de proxys primés de Bright Data (Résidentiel, FAI, Datacenter et Mobile) dans vos scripts ou applications de collecte de données existants. Cela vous permet de router vos requêtes à travers des millions d'adresses IP d'utilisateurs réels, en contournant les géo-restrictions et en évitant les blocages pour accéder à n'importe quel site web public de manière anonyme et réussie.
  2. IDE de Web Scraper : Pour ceux qui souhaitent créer des scrapers personnalisés, l'IDE de Web Scraper fournit un environnement puissant avec des fonctions et des modèles pré-construits. Vous pouvez développer, exécuter et gérer vos scrapers web sans vous soucier de l'infrastructure de proxy sous-jacente, de la mise à l'échelle ou des blocages.
  3. Place de marché de jeux de données : Le moyen le plus simple de commencer est d'accéder à la place de marché de jeux de données. Vous pouvez acheter des ensembles de données structurés et prêts à l'emploi provenant de centaines de sites web populaires comme Amazon, LinkedIn, Zillow et Instagram. Les données peuvent être téléchargées en achat unique ou via un abonnement pour des mises à jour régulières.
  4. API de jeux de données : Pour un accès programmatique, l'API de jeux de données vous permet de définir, de demander et de récupérer des collections de données personnalisées. Le flux de travail implique généralement : 1) Demander une collection en définissant vos sites cibles et vos points de données. 2) Vérifier l'état de la tâche de collecte. 3) Lancer la collecte pour recevoir les données dans votre format préféré (JSON, CSV, Parquet).

Fonctionnalités principales de Bright Data

  • Réseaux de proxys complets : Accès à plus de 72 millions d'adresses IP sur les réseaux Résidentiel, Datacenter, FAI et Mobile dans 195 pays.
  • Scraping web alimenté par l'IA : Des scrapers web avancés et un IDE de Scraper qui peuvent gérer des sites web complexes riches en JavaScript, résoudre les CAPTCHAs et gérer automatiquement les empreintes de navigateur.
  • Vaste place de marché de jeux de données : Un catalogue massif d'ensembles de données pré-collectés et validés provenant des principaux sites de commerce électronique, de médias sociaux, d'immobilier et de veille économique.
  • Évolutivité et performance : Une infrastructure conçue pour traiter des pétaoctets de données, garantissant des taux de réussite élevés et une disponibilité pour les projets de collecte de données à grande échelle.
  • Conformité des données et éthique : Une conformité de pointe avec les lois sur la protection des données comme le RGPD et le CCPA, garantissant une collecte de données éthique et responsable.
  • Livraison flexible des données : Fournit des données propres et structurées dans divers formats, y compris JSON, CSV et Parquet, prêtes pour une analyse immédiate ou l'entraînement de modèles.
  • Services gérés : Pour les entreprises qui préfèrent une approche non interventionniste, Bright Data propose des services de données entièrement gérés où leurs experts s'occupent de l'ensemble du processus de collecte de données pour vous.

Cas d'utilisation pour Bright Data

Les solutions de Bright Data sont polyvalentes et répondent à un large éventail d'applications :

  • IA et apprentissage automatique : Rassemblez des ensembles de données de haute qualité et à grande échelle sur le web pour entraîner et valider des modèles d'apprentissage automatique.
  • Intelligence du commerce électronique et de la vente au détail : Surveillez les prix des concurrents, suivez la disponibilité des produits, agrégez les données des produits et analysez les avis des clients pour optimiser la stratégie.
  • Études de marché : Analysez les tendances du marché, suivez le sentiment de la marque et effectuez une analyse concurrentielle complète en collectant des données sur les sites d'actualités, les forums et les médias sociaux.
  • Services financiers : Collectez des données alternatives à partir de sources publiques pour l'analyse des investissements, l'évaluation des risques et la modélisation financière.
  • Protection de la marque : Scannez le web à la recherche de violations de la propriété intellectuelle, de produits contrefaits et d'utilisation non autorisée des actifs de la marque.

Avantages de Bright Data

Choisir Bright Data offre un avantage concurrentiel significatif. Sa plateforme tout-en-un consolide le besoin de plusieurs fournisseurs en offrant des proxys, des scrapers et des ensembles de données sous un même toit. La qualité et la fiabilité des données sont inégalées, grâce à des processus de validation robustes. L'échelle immense et la portée mondiale de la plateforme signifient qu'aucune cible n'est hors de portée. Fait crucial, l'engagement fort de Bright Data en faveur d'une collecte de données éthique et conforme offre une tranquillité d'esprit aux entreprises opérant dans un paysage réglementaire complexe. Ses outils conviviaux pour les développeurs et son support dédié garantissent une expérience fluide de l'intégration à la production.

Tarification et plans

Bright Data propose un modèle de tarification flexible à l'utilisation ainsi que des plans d'abonnement mensuels et annuels adaptés à différents besoins et échelles.

  • Réseaux de proxys : La tarification est généralement basée sur le trafic (par Go) ou par IP, avec des tarifs différents pour les proxys Datacenter, Résidentiels, FAI et Mobiles. Les plans vont des forfaits de démarrage aux grands engagements d'entreprise.
  • IDE de Web Scraper : Le prix est basé sur l'utilisation, souvent calculé par le nombre de requêtes réussies (CPM).
  • Place de marché de jeux de données : Les jeux de données peuvent être acquis par un achat unique ou un modèle d'abonnement (mensuel, trimestriel, semestriel) qui offre des remises importantes. Le prix est calculé par enregistrement (par exemple, à partir de 2,50 $ pour 1 000 enregistrements), les coûts variant en fonction de la complexité et de la fréquence de rafraîchissement des données.
  • Plans de support : Un plan de support Standard est inclus pour tous les clients. Pour un service amélioré, les plans Premium et Enterprise sont disponibles, offrant un support 24/7, des gestionnaires de compte dédiés et des réponses prioritaires. Le plan Premium coûte 8 % de la facture mensuelle (min 500 $/mois), tandis que le plan Enterprise coûte 10 000 $/mois.

Pour une tarification détaillée et personnalisée, il est recommandé de contacter l'équipe commerciale de Bright Data ou de visiter leur page de tarification officielle.

Crawly

Crawly est un robot d'indexation web puissant et intelligent développé par Diffbot, un leader de l'extraction de données alimentée par l'IA. Il est conçu pour éliminer complètement les défis manuels et techniques du web scraping. Au lieu d'écrire du code complexe ou d'utiliser des sélecteurs fragiles qui se cassent avec les mises à jour de sites web, Crawly s'appuie sur une intelligence artificielle avancée, y compris la vision par ordinateur et le traitement du langage naturel, pour comprendre et interpréter les pages web comme un humain. Cela lui permet d'identifier et d'extraire automatiquement des données complètes et structurées d'un site web entier avec une seule URL en entrée.

La promesse principale de Crawly est de 'transformer les sites web en données en quelques secondes'. Il navigue à travers un site web, suit les liens et analyse la structure de chaque page pour différencier les différents types de contenu tels que les articles, les produits, les discussions et les galeries d'images. Les données extraites sont ensuite organisées dans un format propre et structuré, prêtes à être utilisées immédiatement dans des applications, des analyses de données ou des modèles d'apprentissage automatique.

Comment utiliser Crawly

L'utilisation de Crawly est conçue pour être incroyablement simple et accessible à tous, quel que soit le niveau de compétence technique. Le processus ne comporte que quelques étapes :

  1. Entrer l'URL : Rendez-vous sur le site web de Crawly. Dans le champ de saisie prévu, entrez l'URL complète du site que vous souhaitez explorer.
  2. Fournir l'e-mail : Entrez votre adresse e-mail. Elle est utilisée pour vous notifier et vous livrer les résultats une fois l'exploration terminée.
  3. Lancer l'exploration : Cliquez sur le bouton 'Crawl My Website'. Le moteur d'IA de Crawly commencera alors à parcourir l'ensemble du site, à analyser les pages et à extraire les informations.
  4. Télécharger les données : Une fois le processus terminé, vous recevrez les données extraites. Vous pouvez les télécharger dans des formats pratiques et structurés comme JSON ou CSV, ce qui facilite leur importation dans des bases de données, des feuilles de calcul ou d'autres logiciels.

Fonctionnalités principales de Crawly

  • Extraction automatique alimentée par l'IA : Utilise l'IA avancée de Diffbot pour reconnaître et extraire automatiquement les données d'articles, de produits, de discussions, etc., sans aucune configuration manuelle.
  • Champs de données complets : Extrait un riche ensemble de points de données, y compris le Titre, le Texte, le HTML, les Commentaires, la Date, l'Auteur, l'URL de l'Auteur, les Images, les Vidéos, les Informations sur l'Éditeur (Pays, Nom) et la Langue.
  • Reconnaissance d'entités : Identifie et balise automatiquement les entités dans le texte, telles que les personnes, les organisations et les lieux, ajoutant une autre couche de métadonnées précieuses.
  • Exploration complète du site : Contrairement aux scrapers de page unique, Crawly navigue sur un site web entier pour collecter des données de manière exhaustive.
  • Sortie de données structurées : Fournit des données propres et bien structurées aux formats JSON ou CSV, éliminant le besoin de post-traitement et de nettoyage des données.
  • Solution sans code : Ne nécessite aucune compétence en programmation ni connaissance des technologies de web scraping, ce qui le rend accessible aux spécialistes du marketing, aux chercheurs et aux analystes commerciaux.
  • Robuste et résilient : Parce qu'il comprend la structure sémantique du contenu, il n'est pas facilement cassé par les changements de mise en page du site web, un problème courant avec les scrapers traditionnels.

Cas d'utilisation pour Crawly

Crawly est un outil polyvalent adapté à un large éventail d'applications :

  • Étude de marché : Collectez automatiquement les informations sur les produits des concurrents, les prix, les avis des clients et les mentions dans la presse pour obtenir un avantage concurrentiel.
  • Génération de leads : Extrayez les coordonnées, les informations sur l'entreprise et le personnel clé des sites web d'entreprise et des annuaires en ligne.
  • Agrégation de contenu : Créez un fil d'actualités personnalisé ou une plateforme de contenu en agrégeant des articles, des billets de blog et des vidéos de plusieurs sources.
  • Données pour l'apprentissage automatique : Créez de grands ensembles de données de haute qualité pour entraîner des modèles d'apprentissage automatique, tels que l'analyse des sentiments sur les avis de produits ou l'analyse des tendances à partir d'articles de presse.
  • Veille de marque : Suivez en temps réel la manière dont votre marque, vos produits ou vos dirigeants sont mentionnés sur le web.

Avantages de Crawly

Le principal avantage de Crawly est sa simplicité et sa puissance. Il démocratise l'extraction de données web, permettant aux non-développeurs d'effectuer des tâches qui nécessiteraient normalement une équipe d'ingénieurs. Il permet d'économiser d'énormes quantités de temps et de ressources en automatisant l'ensemble du processus de scraping. De plus, son approche basée sur l'IA garantit une plus grande précision et une meilleure résilience que les méthodes traditionnelles, fournissant un flux fiable de données de haute qualité. En tant que produit de Diffbot, il est soutenu par une technologie de niveau entreprise approuvée par de grandes sociétés du monde entier.

Tarification et plans

Crawly propose une exploration d'essai gratuite directement depuis sa page d'accueil, permettant aux utilisateurs de tester ses capacités en entrant une URL et une adresse e-mail. Ceci est conçu pour fournir un échantillon des données structurées que l'outil peut produire. Pour des besoins plus étendus, tels que l'exploration à grande échelle, l'extraction fréquente de données ou l'accès à l'API pour une utilisation programmatique, les utilisateurs s'abonneraient généralement à la suite complète d'outils proposée par sa société mère, Diffbot. La tarification de Diffbot est échelonnée, avec des plans disponibles pour les startups, les entreprises et les grandes entreprises, offrant différents niveaux d'appels d'API et de fonctionnalités.

Positionnement

La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.

Catégories

Commun
Web scrapingAPIÉtude de marché
Uniquement Bright Data
Informatique décisionnelle
Uniquement Crawly
Automatisation

Étiquettes

Commun
APIExtraction de donnéesétude de marchédonnées structuréesWeb scraping
Uniquement Bright Data
Données d'entraînement d'IAdonnées alternativesCollecte de donnéesDonnées e-commerceProxy
Uniquement Crawly
automatisationDiffbotJSONGénération de leadsNo-coderobot d'exploration web

Publics et métiers

Commun
Aucune donnée vérifiée
Uniquement Bright Data
Aucune donnée vérifiée
Uniquement Crawly
Aucune donnée vérifiée

Comparaison du trafic

Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Bright Data monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
810.9K
Durée moyenne
3:21
Pages par visite
4.77
Taux de rebond
42.51%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 771K
  • 2026-01: 735.5K
  • 2026-02: 714.5K
  • 2026-03: 830.2K
  • 2026-04: 833K
  • 2026-05: 810.9K

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States46.92%380.5K
🇨🇳China21.71%176.1K
🇮🇳India13.14%106.6K
🇬🇧United Kingdom10.78%87.4K
🇻🇳Vietnam7.45%60.4K

Sources de trafic

Source typePercentageEstimated visits
Direct86.27%699.6K
Référence10.39%84.3K
E-mail3.34%27.1K

Mots-clés

apifybright databrightdatasnapchatwayback machine

Crawly monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
1.8K
Durée moyenne
0:31
Pages par visite
1.15
Taux de rebond
93.85%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 2.6K
  • 2026-01: 784
  • 2026-02: 640
  • 2026-03: 1K
  • 2026-04: 475
  • 2026-05: 1.8K

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇳🇬Nigeria82.43%1.5K
🇩🇪Germany9.9%177
🇨🇦Canada7.67%137

Mots-clés

crawl urlcrawlyonline web crawlerwebsite crawlerwebsite crawler online

Signaux communautaires

Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.

Bright Data

Note
Non vérifié
Commentaires
0
Favoris
140
J’aime
156

Crawly

Note
Non vérifié
Commentaires
0
Favoris
162
J’aime
160

Bright Data vs Crawly · FAQ comparative

What do Bright Data and Crawly have in common?
Both tools are listed under Web scraping、API、Étude de marché. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Bright Data and Crawly free?
Listed pricing models: Bright Data — Paid; Crawly — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Bright Data and Crawly?
The primary listed category is Informatique décisionnelle for Bright Data, and Web scraping for Crawly. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparatifs associés