Crawly
Web scraping
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
Web scraping
Web scraping
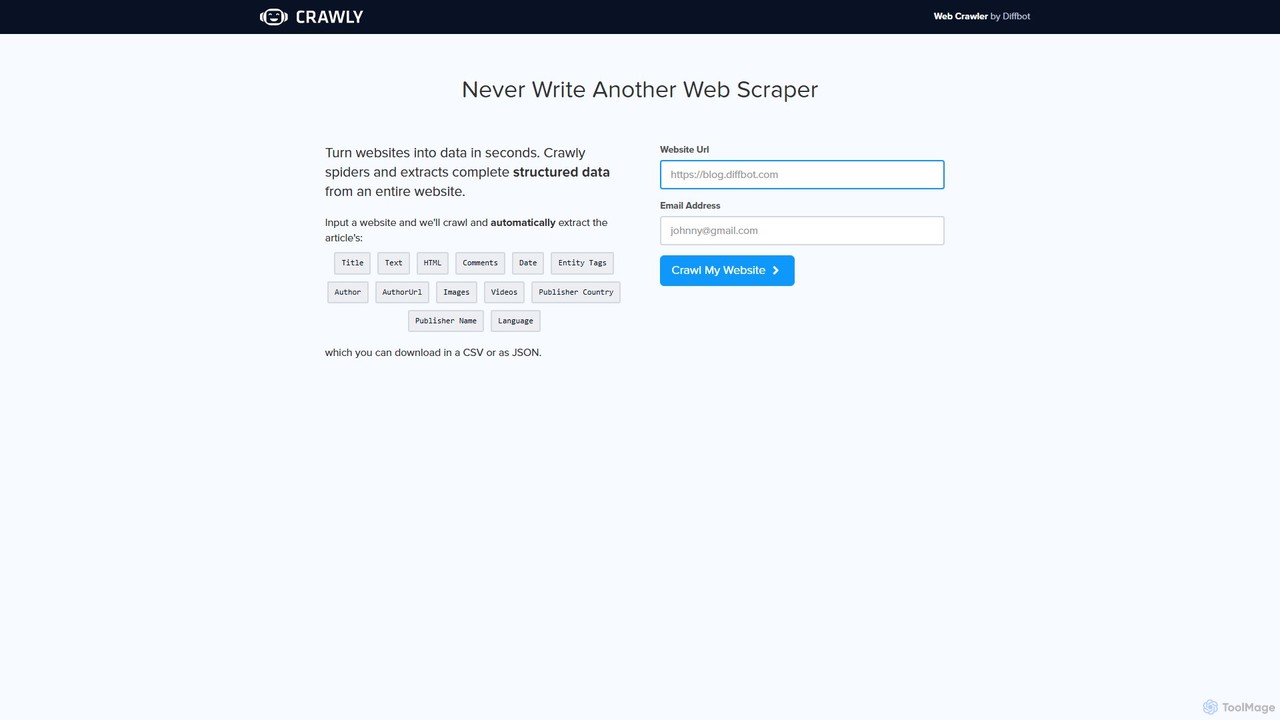
Crawly est un robot d'indexation web alimenté par l'IA de Diffbot qui extrait automatiquement des données structurées de sites web entiers. Il suffit d'entrer une URL, et Crawly parcourt le site pour extraire des informations clés comme des articles, des produits et des discussions, les convertissant en données JSON ou CSV propres sans aucun codage requis.
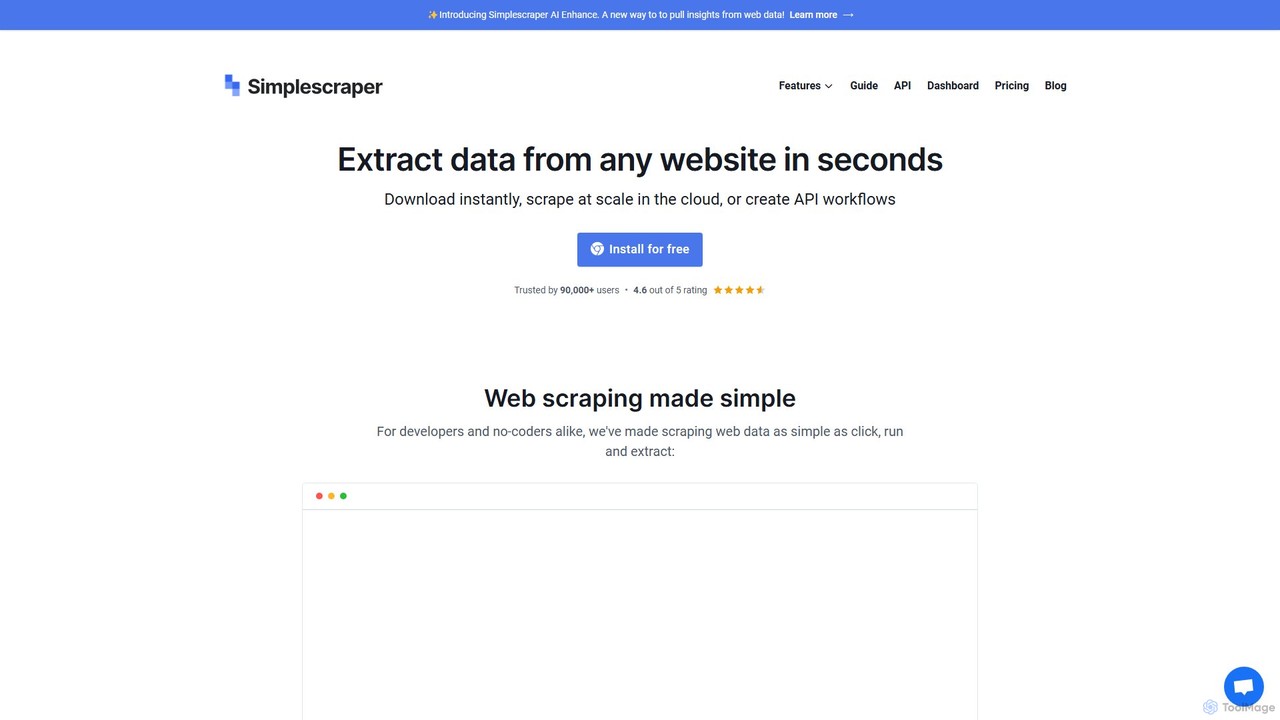
Simplescraper est un puissant outil de web scraping qui extrait des données de n'importe quel site web en quelques secondes. Il propose une extension Chrome conviviale pour la sélection de données sans code, une automatisation basée sur le cloud pour le scraping à grande échelle, et une fonctionnalité innovante d'IA (AI Enhance) pour extraire des informations à l'aide de simples invites. Transformez les sites web en données structurées (CSV, JSON) ou en API instantanées, et intégrez-les avec des outils comme Google Sheets et Airtable.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Données clés | Crawly | Simplescraper |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | Web scraping | Web scraping |
| Publics et métiers | Non vérifié | Non vérifié |
| Catégories | Web scraping · API · Étude de marché · Automatisation | Web scraping · API · Génération de leads · Automatisation |
| Added | 10 août 2025 | 17 août 2025 |
| Mis à jour | 19 nov. 2026 | 19 nov. 2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
Crawly est un robot d'indexation web puissant et intelligent développé par Diffbot, un leader de l'extraction de données alimentée par l'IA. Il est conçu pour éliminer complètement les défis manuels et techniques du web scraping. Au lieu d'écrire du code complexe ou d'utiliser des sélecteurs fragiles qui se cassent avec les mises à jour de sites web, Crawly s'appuie sur une intelligence artificielle avancée, y compris la vision par ordinateur et le traitement du langage naturel, pour comprendre et interpréter les pages web comme un humain. Cela lui permet d'identifier et d'extraire automatiquement des données complètes et structurées d'un site web entier avec une seule URL en entrée.
La promesse principale de Crawly est de 'transformer les sites web en données en quelques secondes'. Il navigue à travers un site web, suit les liens et analyse la structure de chaque page pour différencier les différents types de contenu tels que les articles, les produits, les discussions et les galeries d'images. Les données extraites sont ensuite organisées dans un format propre et structuré, prêtes à être utilisées immédiatement dans des applications, des analyses de données ou des modèles d'apprentissage automatique.
L'utilisation de Crawly est conçue pour être incroyablement simple et accessible à tous, quel que soit le niveau de compétence technique. Le processus ne comporte que quelques étapes :
Crawly est un outil polyvalent adapté à un large éventail d'applications :
Le principal avantage de Crawly est sa simplicité et sa puissance. Il démocratise l'extraction de données web, permettant aux non-développeurs d'effectuer des tâches qui nécessiteraient normalement une équipe d'ingénieurs. Il permet d'économiser d'énormes quantités de temps et de ressources en automatisant l'ensemble du processus de scraping. De plus, son approche basée sur l'IA garantit une plus grande précision et une meilleure résilience que les méthodes traditionnelles, fournissant un flux fiable de données de haute qualité. En tant que produit de Diffbot, il est soutenu par une technologie de niveau entreprise approuvée par de grandes sociétés du monde entier.
Crawly propose une exploration d'essai gratuite directement depuis sa page d'accueil, permettant aux utilisateurs de tester ses capacités en entrant une URL et une adresse e-mail. Ceci est conçu pour fournir un échantillon des données structurées que l'outil peut produire. Pour des besoins plus étendus, tels que l'exploration à grande échelle, l'extraction fréquente de données ou l'accès à l'API pour une utilisation programmatique, les utilisateurs s'abonneraient généralement à la suite complète d'outils proposée par sa société mère, Diffbot. La tarification de Diffbot est échelonnée, avec des plans disponibles pour les startups, les entreprises et les grandes entreprises, offrant différents niveaux d'appels d'API et de fonctionnalités.
Simplescraper est un service complet de web scraping conçu pour rendre l'extraction de données accessible à tous, des non-codeurs aux développeurs expérimentés. Approuvé par plus de 90 000 utilisateurs, il transforme n'importe quel site web en une source de données structurées et exploitables. Avec son extension Chrome intuitive, vous pouvez simplement cliquer sur les données dont vous avez besoin, et avec sa plateforme cloud, vous pouvez exécuter des tâches de scraping automatisées à grande échelle et planifiées. La fonctionnalité phare, Simplescraper AI Enhance, vous permet d'utiliser des invites en langage naturel pour extraire, résumer et analyser le contenu web, éliminant ainsi le besoin de configurations complexes ou de sélecteurs CSS.
Démarrer avec Simplescraper est simple et offre plusieurs approches en fonction de vos besoins :
Simplescraper est polyvalent et peut être appliqué dans diverses industries à de nombreuses fins :
Simplescraper se distingue par sa combinaison de simplicité et de puissance. Son principal avantage est sa conception conviviale, qui démocratise le web scraping pour les utilisateurs non techniques. Les fonctionnalités d'IA réduisent considérablement la barrière à l'entrée, car les utilisateurs n'ont plus besoin de comprendre la structure HTML ou les sélecteurs CSS. Pour les développeurs, il offre un backend robuste et évolutif et une API puissante qui permet d'économiser des centaines d'heures de développement. La fiabilité de l'infrastructure cloud, avec rotation de proxy et résolution de CAPTCHA, garantit des taux de réussite élevés pour les tâches de scraping.
Simplescraper propose un modèle freemium avec des plans conçus pour évoluer avec vos besoins :
Tous les plans payants sont accompagnés d'un support personnalisé. Les crédits sont utilisés pour les tâches de scraping dans le cloud, une page standard coûtant 1 crédit et une page riche en JavaScript coûtant 2 crédits. L'utilisation d'AI Enhance est facturée séparément à 1 crédit pour 800 mots traités.
La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.
Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇳🇬Nigeria | 82.43% | 1.5K |
| 🇩🇪Germany | 9.9% | 177 |
| 🇨🇦Canada | 7.67% | 137 |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 47.86% | 50.1K |
| 🇮🇳India | 28.08% | 29.4K |
| 🇧🇷Brazil | 8.48% | 8.9K |
| 🇬🇧United Kingdom | 8.15% | 8.5K |
| 🇫🇷France | 7.43% | 7.8K |
| Source type | Percentage | Estimated visits |
|---|---|---|
| Direct | 88.2% | 92.4K |
| Référence | 11.73% | 12.3K |
| 0.07% | 73 |
Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.