ToolMage
Connexion

AI TOOL COMPARISON

dstack vs Modelbit

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Aperçu du produit

dstack Aperçu du produit

dstack est un orchestrateur de conteneurs open-source conçu pour les équipes d'IA et de ML. Il simplifie l'orchestration des charges de travail et maximise l'utilisation des GPU sur n'importe quel fournisseur de cloud, cluster sur site ou matériel accéléré. Il fournit une couche de calcul unifiée, rationalisant le développement, l'entraînement et le déploiement de modèles.

Preview

Modelbit Aperçu du produit

Modelbit est une plateforme MLOps pour déployer des modèles de machine learning directement depuis des notebooks Python en production. Elle fournit un flux de travail d'infrastructure-as-code, permettant aux data scientists de déployer, héberger, mettre à l'échelle et gérer des modèles avec une seule ligne de code et un git push.

Preview

Données clés

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

dstack VS Modelbit — Données clés
Données clésdstackModelbit
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusOrchestrationMLOps
Publics et métiersNon vérifiéNon vérifié
CatégoriesOrchestration · MLOps · Gestion d'infrastructureMLOps · Automatisation
Added8 août 20252 août 2025
Mis à jour19 nov. 202619 nov. 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

dstack

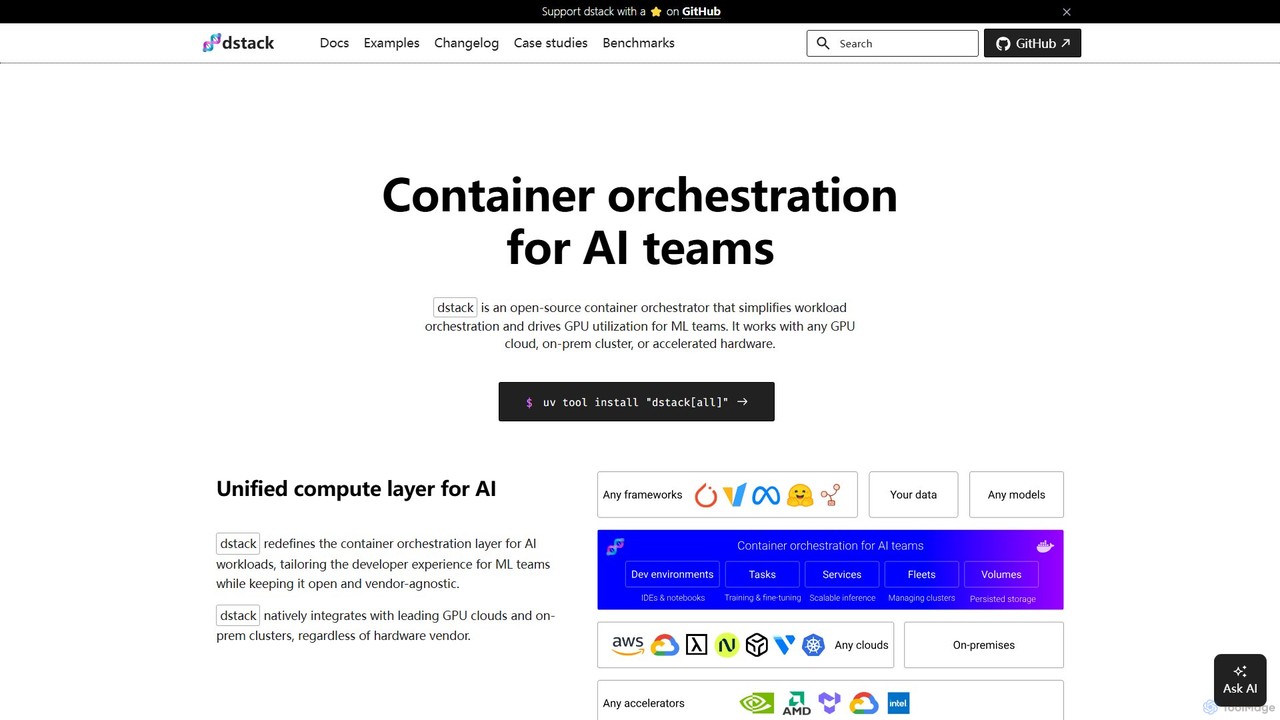
dstack est un puissant orchestrateur de conteneurs open-source spécialement conçu pour relever les défis auxquels sont confrontées les équipes d'Intelligence Artificielle et de Machine Learning. Son objectif principal est de simplifier le processus complexe d'orchestration des charges de travail et d'améliorer considérablement l'utilisation des ressources GPU coûteuses. En tant que plateforme agnostique vis-à-vis des fournisseurs, dstack offre une couche de calcul unifiée qui s'intègre de manière transparente avec n'importe quel cloud GPU (comme AWS, GCP, Azure, OCI), les clusters sur site et une large gamme de matériel accéléré, y compris NVIDIA, AMD, TPU, et plus encore. Cette flexibilité garantit que les équipes ne sont pas enfermées chez un seul fournisseur et peuvent exploiter le meilleur matériel pour leurs besoins, où qu'il se trouve.

La plateforme est conçue avec l'expérience du développeur au cœur, en abstrayant les complexités de l'infrastructure sous-jacente. Cela permet aux ingénieurs ML et aux chercheurs de se concentrer sur la construction, l'entraînement et le déploiement de modèles plutôt que sur la gestion des serveurs, des dépendances et de la mise à l'échelle. dstack est approuvé par des équipes ML de classe mondiale dans des entreprises comme Electronic Arts et Mobius Labs pour sa capacité à passer du prototypage rapide à de grands travaux d'entraînement distribués sur plusieurs nœuds.

Comment utiliser dstack

Démarrer avec dstack est un processus simple conçu pour une adoption rapide :

  1. Configurer le serveur : Vous pouvez commencer par installer le serveur dstack sur votre machine locale en utilisant une commande simple comme uv tool install "dstack[all]" et en l'exécutant avec dstack server. Alternativement, vous pouvez le déployer n'importe où en utilisant l'image Docker officielle ou vous inscrire à dstack Sky, la version cloud gérée, pour éviter de l'héberger vous-même.
  2. Définir les configurations : Les flux de travail dans dstack sont définis à l'aide de simples fichiers YAML dans votre dépôt de projet. Ces configurations décrivent l'environnement, les ressources et les commandes pour vos tâches. Les types de configuration clés incluent :
    • Environnements de développement (Dev Environments) : Pour le développement interactif, vous permettant de connecter votre IDE local (comme VS Code) à une puissante machine GPU distante.
    • Tâches (Tasks) : Pour planifier des travaux par lots, tels que le pré-entraînement ou l'ajustement fin de modèles. Idéal pour les charges de travail qui s'exécutent jusqu'à leur achèvement.
    • Services (Services) : Pour déployer des modèles en tant que points de terminaison sécurisés, à mise à l'échelle automatique et compatibles avec OpenAI.
    • Flottes (Fleets) : Pour gérer des groupes d'instances cloud ou sur site comme un seul pool de ressources.
  3. Appliquer les configurations : Une fois votre fichier YAML prêt, vous l'appliquez à l'aide de l'interface de ligne de commande : dstack apply. dstack s'occupe alors du reste : provisionnement de l'infrastructure nécessaire, planification du travail, gestion de la mise à l'échelle automatique, gestion de la redirection de port et diffusion des journaux vers votre terminal. Pour une exécution détachée, vous pouvez utiliser l'indicateur -d.

Fonctionnalités principales de dstack

  • Couche de calcul unifiée : Fournit un plan de contrôle unique et agnostique vis-à-vis des fournisseurs pour toutes vos ressources de calcul IA, que ce soit sur le cloud ou sur site.
  • Large prise en charge des accélérateurs : Prend en charge nativement une large gamme de matériel, y compris les GPU NVIDIA, les GPU AMD, les TPU Google Cloud, Intel Gaudi et les accélérateurs Tenstorrent.
  • Flux de travail centrés sur le développeur : Offre des configurations spécialisées comme les environnements de développement pour le codage interactif, les tâches pour le traitement par lots et les services pour un déploiement facile des modèles.
  • Gestion efficace des ressources : Dispose d'un planificateur intégré pour maximiser l'utilisation des GPU. Il inclut des politiques pour terminer automatiquement les instances sous-utilisées, ce qui permet de réduire les coûts.
  • Intégration transparente : Fonctionne sans problème avec les principaux clouds GPU (AWS, GCP, Azure, OCI) et peut s'exécuter sur des clusters Kubernetes existants. Les flottes SSH permettent de connecter des serveurs bare-metal.
  • Services à mise à l'échelle automatique : Déployez facilement des modèles en tant que services prêts pour la production avec des fonctionnalités telles que la mise à l'échelle automatique, le HTTPS et des points de terminaison API compatibles avec OpenAI.
  • Persistance des données : Prend en charge les volumes réseau et d'instance pour conserver les données, les modèles et les caches entre les exécutions, garantissant que l'état n'est pas perdu.
  • Configuration avancée : Permet un contrôle fin avec des fonctionnalités telles que les politiques de nouvelle tentative pour les problèmes de capacité, la gestion des variables d'environnement et la prise en charge des images Docker personnalisées.

Cas d'utilisation pour dstack

dstack est polyvalent et prend en charge une large gamme de flux de travail ML :

  • Entraînement et ajustement fin de modèles : Exécutez des travaux d'entraînement sur un seul nœud ou distribués pour de grands modèles de langage (LLM) en utilisant des frameworks populaires comme TRL, Axolotl et DeepSpeed.
  • Inférence et service de modèles : Déployez des modèles optimisés pour l'inférence en utilisant des frameworks de service haute performance comme vLLM, SGLang, TGI et NVIDIA NIM.
  • Développement IA interactif : Les ingénieurs ML peuvent lancer de puissants environnements de développement soutenus par des GPU en quelques secondes, en connectant leur IDE local pour expérimenter et déboguer le code de manière interactive.
  • Gestion de clusters haute performance : Configurez et exécutez des tests (par exemple, des tests NCCL) sur des clusters spécialisés à plusieurs nœuds comme GCP A3 Mega ou des instances compatibles AWS EFA.
  • Optimisation des coûts inter-cloud : Comparez et utilisez sans effort les instances GPU les plus rentables parmi différents fournisseurs de cloud pour une tâche donnée.

Avantages de dstack

Le principal avantage de dstack est sa capacité à simplifier considérablement l'infrastructure IA. Il donne aux équipes ML les moyens de se concentrer sur leurs recherches et leurs modèles plutôt que sur l'infrastructure. Les principaux avantages incluent une productivité accrue, des économies de coûts significatives grâce à une meilleure utilisation des GPU et à l'accès aux instances spot, et la prévention de l'enfermement propriétaire (vendor lock-in). Sa nature open-source favorise la transparence et le développement communautaire, tandis que sa conception centrée sur le développeur rend incroyablement facile la définition d'une configuration et son exécution sans se soucier de la disponibilité des GPU ou des configurations complexes.

Tarification et plans

dstack propose une structure de tarification flexible pour répondre à différents besoins :

  • dstack (Open-Source) : La plateforme de base est open-source et gratuite. Vous pouvez l'auto-héberger sur votre propre infrastructure sans frais de licence.
  • dstack Sky : Un service cloud géré qui s'occupe de l'hébergement du serveur dstack pour vous. Il donne également accès à un marché des GPU les moins chers. Il offre un niveau gratuit pour commencer.
  • dstack Enterprise : Une version auto-hébergée conçue pour les grandes organisations, qui inclut des fonctionnalités de niveau entreprise comme l'authentification unique (SSO), des contrôles de gouvernance avancés et un support d'entreprise dédié. une version d'essai peut être demandée pour cette version.

Ce modèle rend dstack accessible aux chercheurs individuels, aux startups et aux grandes entreprises.

Modelbit

Modelbit est une plateforme complète d'infrastructure-as-code conçue pour rationaliser le déploiement et la gestion des modèles de machine learning dans des environnements de production. Elle cible spécifiquement les équipes ayant des besoins sérieux en matière d'infrastructure ML, comblant le fossé entre le développement de modèles dans des notebooks Python et des systèmes de production robustes et évolutifs. La plateforme gère l'ensemble du cycle de vie opérationnel, y compris le déploiement, le staging, l'hébergement, l'autoscaling, le réentraînement, la détection de dérive et les déploiements fantômes (shadow deployments), le tout géré via du code et de la configuration dans un dépôt Git.

Avec Modelbit, les data scientists peuvent faire passer leurs modèles d'un notebook Jupyter ou Colab à un point de terminaison d'API live et évolutif en quelques minutes. La philosophie centrale est de laisser les data scientists travailler dans leur environnement préféré tout en fournissant un chemin transparent et automatisé vers la production, éliminant ainsi les frictions traditionnelles et les longs délais associés au déploiement ML.

Comment utiliser Modelbit

Le flux de travail est conçu pour la simplicité et l'intégration avec les pratiques existantes de la science des données et de l'ingénierie :

  1. Développer dans un Notebook : Entraînez et finalisez votre modèle de machine learning dans votre environnement Python préféré, comme un notebook Jupyter ou Google Colab.
  2. Importer et Déployer : Importez la bibliothèque Modelbit dans votre notebook. Une fois votre modèle entraîné et toutes les fonctions de traitement de données nécessaires prêtes, appelez la fonction `modelbit.deploy()`. Cette seule commande lance le processus de déploiement.
  3. Empaquetage Automatisé : Modelbit capture automatiquement votre modèle, ses dépendances de code et l'environnement Python spécifique (y compris les versions des paquets), garantissant une réplication parfaite en production.
  4. Gestion Basée sur Git : Connectez votre compte Modelbit à un dépôt GitHub. Les déploiements sont gérés via Git. Par exemple, pousser du code vers une branche 'staging' déploie le modèle dans un environnement de pré-production, tandis que fusionner vers la branche 'main' le promeut en production.
  5. Accéder et Mettre à l'Échelle : Une fois déployé, Modelbit génère automatiquement une API REST unique et une API Snowflake pour votre modèle. Vous pouvez ensuite utiliser l'interface web ou la CLI pour surveiller les performances, consulter les journaux, gérer différentes versions, mettre en place des tests A/B ou revenir à une version précédente si nécessaire. Le système met automatiquement à l'échelle les ressources, y compris les GPU, en fonction du trafic.

Fonctionnalités principales de Modelbit

  • Déploiement Direct depuis le Notebook : Passez d'un modèle dans un notebook à une API de production avec la commande `modelbit.deploy()`, éliminant les étapes manuelles complexes.
  • MLOps Basé sur Git (Infrastructure-as-Code) : Gérez l'ensemble de votre cycle de vie de déploiement ML via Git. Chaque `git push` crée un nouveau déploiement versionné et idempotent.
  • Génération Automatique d'API : Chaque version de modèle obtient son propre environnement conteneurisé avec une API REST et une API Snowflake uniques, prêtes à être intégrées.
  • Autoscaling et Support GPU : Les déploiements sont conteneurisés et isolés, avec une mise à l'échelle automatique pour gérer les charges variables. Prise en charge complète des modèles gourmands en GPU comme les grands transformateurs de vision.
  • Stratégies de Déploiement Avancées : Prend en charge nativement les déploiements fantômes pour tester de nouveaux modèles sur le trafic de production sans impacter les utilisateurs, les tests A/B entre les versions et les retours en arrière instantanés.
  • Flexibilité du Cloud Hybride : Exécutez des modèles dans le cloud sécurisé et multi-tenant de Modelbit ou déployez-les dans votre propre environnement cloud (VPC) pour un contrôle et une confidentialité maximum.
  • Parité d'Environnement : Capture et recrée automatiquement l'environnement Python exact, évitant le problème courant du "ça marche sur ma machine".

Cas d'utilisation pour Modelbit

Modelbit est utilisé par des entreprises pour des applications exigeantes et en temps réel :

  • Détection de Menaces en Temps Réel : Des entreprises comme Ambient AI utilisent Modelbit pour déployer de grands modèles de vision par ordinateur multimodaux qui analysent les flux de sécurité en temps réel pour détecter les menaces, en tirant parti de son support GPU et de ses capacités d'itération rapide.
  • Fintech et Évaluation des Risques : Utilisé pour déployer des modèles de détection de fraude et de souscription de prêts, où une haute disponibilité (99,99 % de temps de fonctionnement) et une faible latence sont critiques.
  • Logistique et E-commerce : Des équipes d'entreprises comme Inventa déploient des modèles pour réduire les délais de livraison prévus et prévoir les volumes de commandes, optimisant directement les opérations commerciales.
  • Santé et Sciences de la Vie : OM1 utilise Modelbit pour alimenter des applications ML qui aident à détecter des maladies rares, démontrant sa capacité à gérer des charges de travail complexes et sensibles.

Avantages de Modelbit

La plateforme offre des avantages significatifs pour les équipes ML :

  • Vitesse et Agilité : Réduit les cycles de déploiement de plusieurs mois ou semaines à quelques minutes seulement, permettant une expérimentation plus rapide et la livraison de nouvelles fonctionnalités.
  • Autonomisation des Data Scientists : Donne aux data scientists l'autonomie de déployer et de gérer leurs propres modèles, libérant ainsi les ressources DevOps et d'ingénierie ML.
  • Fiabilité de Niveau Production : Conçu pour les systèmes critiques avec des fonctionnalités telles que l'isolation des conteneurs, les déploiements idempotents et un temps de fonctionnement prouvé de 99,99 %.
  • Intégration Transparente : S'intègre parfaitement dans les flux de travail modernes de la science des données (Python, notebooks) et de l'ingénierie logicielle (Git, CI/CD).
  • Rentabilité : La fonction d'autoscaling garantit que vous n'utilisez et ne payez que les ressources de calcul nécessaires à un moment donné.

Tarification et plans

Modelbit fonctionne sur un modèle freemium. Il propose un niveau gratuit qui permet aux développeurs individuels et aux petites équipes d'essayer la plateforme et de déployer des modèles. Pour les équipes plus importantes et les cas d'utilisation d'entreprise avec des exigences telles que les déploiements en cloud hybride, des fonctionnalités de sécurité avancées et un support dédié, des plans à tarification personnalisée sont disponibles. Pour obtenir les informations de tarification les plus précises et à jour, il est recommandé de visiter le site web officiel de Modelbit.

Positionnement

La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.

Catégories

Commun
MLOps
Uniquement dstack
OrchestrationGestion d'infrastructure
Uniquement Modelbit
Automatisation

Étiquettes

Commun
Infrastructure en tant que codeapprentissage automatiqueMLOpsDéploiement de modèle
Uniquement dstack
Développement de l'IAinformatique en nuageOrchestration de conteneursGestion GPUKubernetesOpen source
Uniquement Modelbit
Outils de développement IAAutoscalingCI/CD pour le MLscience des donnéesHébergement de modèlesPython

Publics et métiers

Commun
Aucune donnée vérifiée
Uniquement dstack
Aucune donnée vérifiée
Uniquement Modelbit
Aucune donnée vérifiée

Comparaison du trafic

Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

dstack monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
13.1K
Durée moyenne
0:02
Pages par visite
1.21
Taux de rebond
53.77%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 4.8K
  • 2026-01: 16.2K
  • 2026-02: 19.7K
  • 2026-03: 11.8K
  • 2026-04: 9.4K
  • 2026-05: 13.1K

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇫🇷France64.99%8.5K
🇺🇸United States15.02%2K
🇷🇺Russia7.76%1K
🇮🇳India7.35%962
🇩🇪Germany4.88%639

Sources de trafic

Source typePercentageEstimated visits
Direct61.06%8K
E-mail20.74%2.7K
Référence18.2%2.4K

Mots-clés

dstackdstack serverdstack sky free creditssglang routertrl sft コマンドで複数ノードで実行する方法

Modelbit monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
438
Durée moyenne
0:25
Pages par visite
1.62
Taux de rebond
34.27%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 8.1K
  • 2026-01: 2.5K
  • 2026-02: 1.6K
  • 2026-03: 2.4K
  • 2026-04: 3K
  • 2026-05: 438

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇮🇳India100%438

Mots-clés

dbt incremental modelssam segment anything checkpoint bsam_vit_b_01ec64sam_vit_b_01ec64.pthsam_vit_b_01ec64.pth (1)

Signaux communautaires

Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.

dstack

Note
Non vérifié
Commentaires
0
Favoris
215
J’aime
208

Modelbit

Note
Non vérifié
Commentaires
0
Favoris
176
J’aime
178

dstack vs Modelbit · FAQ comparative

What do dstack and Modelbit have in common?
Both tools are listed under MLOps. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are dstack and Modelbit free?
Listed pricing models: dstack — Freemium; Modelbit — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between dstack and Modelbit?
The primary listed category is Orchestration for dstack, and MLOps for Modelbit. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparatifs associés