
dstack Overview
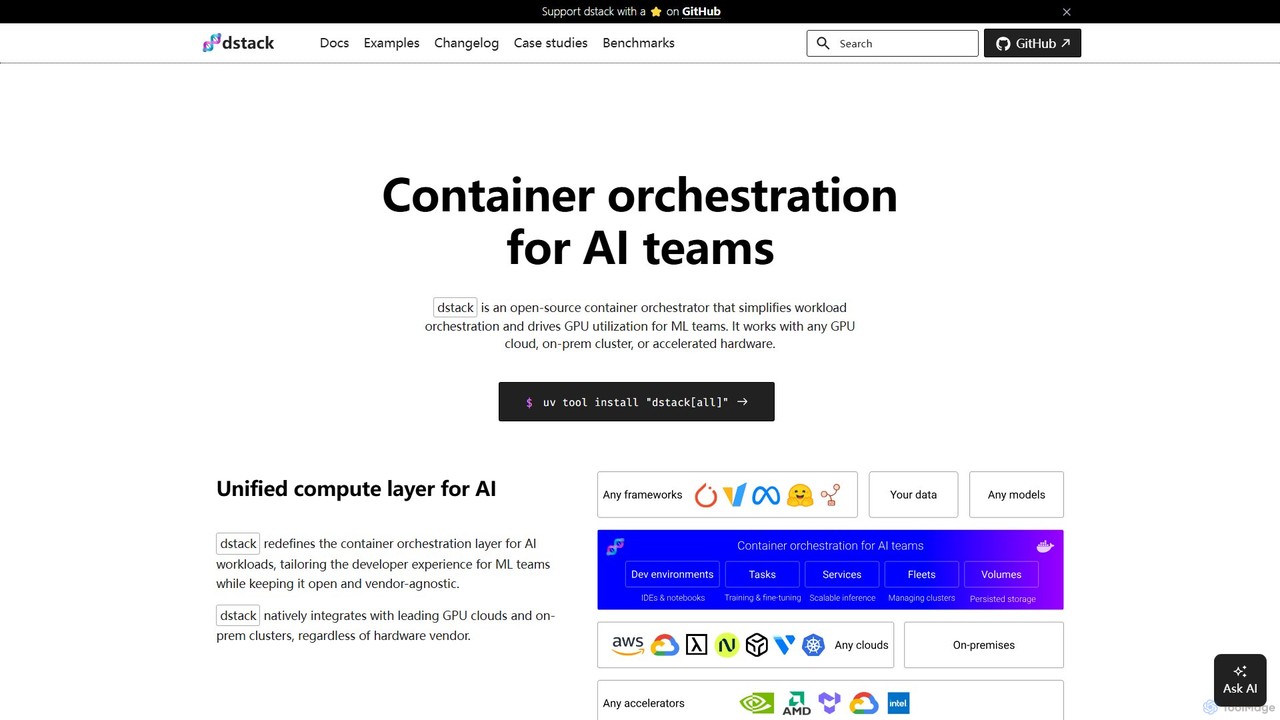
dstack est un puissant orchestrateur de conteneurs open-source spécialement conçu pour relever les défis auxquels sont confrontées les équipes d'Intelligence Artificielle et de Machine Learning. Son objectif principal est de simplifier le processus complexe d'orchestration des charges de travail et d'améliorer considérablement l'utilisation des ressources GPU coûteuses. En tant que plateforme agnostique vis-à-vis des fournisseurs, dstack offre une couche de calcul unifiée qui s'intègre de manière transparente avec n'importe quel cloud GPU (comme AWS, GCP, Azure, OCI), les clusters sur site et une large gamme de matériel accéléré, y compris NVIDIA, AMD, TPU, et plus encore. Cette flexibilité garantit que les équipes ne sont pas enfermées chez un seul fournisseur et peuvent exploiter le meilleur matériel pour leurs besoins, où qu'il se trouve.
La plateforme est conçue avec l'expérience du développeur au cœur, en abstrayant les complexités de l'infrastructure sous-jacente. Cela permet aux ingénieurs ML et aux chercheurs de se concentrer sur la construction, l'entraînement et le déploiement de modèles plutôt que sur la gestion des serveurs, des dépendances et de la mise à l'échelle. dstack est approuvé par des équipes ML de classe mondiale dans des entreprises comme Electronic Arts et Mobius Labs pour sa capacité à passer du prototypage rapide à de grands travaux d'entraînement distribués sur plusieurs nœuds.
Comment utiliser dstack
Démarrer avec dstack est un processus simple conçu pour une adoption rapide :
- Configurer le serveur : Vous pouvez commencer par installer le serveur dstack sur votre machine locale en utilisant une commande simple comme
uv tool install "dstack[all]"et en l'exécutant avecdstack server. Alternativement, vous pouvez le déployer n'importe où en utilisant l'image Docker officielle ou vous inscrire à dstack Sky, la version cloud gérée, pour éviter de l'héberger vous-même. - Définir les configurations : Les flux de travail dans dstack sont définis à l'aide de simples fichiers YAML dans votre dépôt de projet. Ces configurations décrivent l'environnement, les ressources et les commandes pour vos tâches. Les types de configuration clés incluent :
- Environnements de développement (Dev Environments) : Pour le développement interactif, vous permettant de connecter votre IDE local (comme VS Code) à une puissante machine GPU distante.
- Tâches (Tasks) : Pour planifier des travaux par lots, tels que le pré-entraînement ou l'ajustement fin de modèles. Idéal pour les charges de travail qui s'exécutent jusqu'à leur achèvement.
- Services (Services) : Pour déployer des modèles en tant que points de terminaison sécurisés, à mise à l'échelle automatique et compatibles avec OpenAI.
- Flottes (Fleets) : Pour gérer des groupes d'instances cloud ou sur site comme un seul pool de ressources.
- Appliquer les configurations : Une fois votre fichier YAML prêt, vous l'appliquez à l'aide de l'interface de ligne de commande :
dstack apply. dstack s'occupe alors du reste : provisionnement de l'infrastructure nécessaire, planification du travail, gestion de la mise à l'échelle automatique, gestion de la redirection de port et diffusion des journaux vers votre terminal. Pour une exécution détachée, vous pouvez utiliser l'indicateur-d.
Fonctionnalités principales de dstack
- Couche de calcul unifiée : Fournit un plan de contrôle unique et agnostique vis-à-vis des fournisseurs pour toutes vos ressources de calcul IA, que ce soit sur le cloud ou sur site.
- Large prise en charge des accélérateurs : Prend en charge nativement une large gamme de matériel, y compris les GPU NVIDIA, les GPU AMD, les TPU Google Cloud, Intel Gaudi et les accélérateurs Tenstorrent.
- Flux de travail centrés sur le développeur : Offre des configurations spécialisées comme les environnements de développement pour le codage interactif, les tâches pour le traitement par lots et les services pour un déploiement facile des modèles.
- Gestion efficace des ressources : Dispose d'un planificateur intégré pour maximiser l'utilisation des GPU. Il inclut des politiques pour terminer automatiquement les instances sous-utilisées, ce qui permet de réduire les coûts.
- Intégration transparente : Fonctionne sans problème avec les principaux clouds GPU (AWS, GCP, Azure, OCI) et peut s'exécuter sur des clusters Kubernetes existants. Les flottes SSH permettent de connecter des serveurs bare-metal.
- Services à mise à l'échelle automatique : Déployez facilement des modèles en tant que services prêts pour la production avec des fonctionnalités telles que la mise à l'échelle automatique, le HTTPS et des points de terminaison API compatibles avec OpenAI.
- Persistance des données : Prend en charge les volumes réseau et d'instance pour conserver les données, les modèles et les caches entre les exécutions, garantissant que l'état n'est pas perdu.
- Configuration avancée : Permet un contrôle fin avec des fonctionnalités telles que les politiques de nouvelle tentative pour les problèmes de capacité, la gestion des variables d'environnement et la prise en charge des images Docker personnalisées.
Cas d'utilisation pour dstack
dstack est polyvalent et prend en charge une large gamme de flux de travail ML :
- Entraînement et ajustement fin de modèles : Exécutez des travaux d'entraînement sur un seul nœud ou distribués pour de grands modèles de langage (LLM) en utilisant des frameworks populaires comme TRL, Axolotl et DeepSpeed.
- Inférence et service de modèles : Déployez des modèles optimisés pour l'inférence en utilisant des frameworks de service haute performance comme vLLM, SGLang, TGI et NVIDIA NIM.
- Développement IA interactif : Les ingénieurs ML peuvent lancer de puissants environnements de développement soutenus par des GPU en quelques secondes, en connectant leur IDE local pour expérimenter et déboguer le code de manière interactive.
- Gestion de clusters haute performance : Configurez et exécutez des tests (par exemple, des tests NCCL) sur des clusters spécialisés à plusieurs nœuds comme GCP A3 Mega ou des instances compatibles AWS EFA.
- Optimisation des coûts inter-cloud : Comparez et utilisez sans effort les instances GPU les plus rentables parmi différents fournisseurs de cloud pour une tâche donnée.
Avantages de dstack
Le principal avantage de dstack est sa capacité à simplifier considérablement l'infrastructure IA. Il donne aux équipes ML les moyens de se concentrer sur leurs recherches et leurs modèles plutôt que sur l'infrastructure. Les principaux avantages incluent une productivité accrue, des économies de coûts significatives grâce à une meilleure utilisation des GPU et à l'accès aux instances spot, et la prévention de l'enfermement propriétaire (vendor lock-in). Sa nature open-source favorise la transparence et le développement communautaire, tandis que sa conception centrée sur le développeur rend incroyablement facile la définition d'une configuration et son exécution sans se soucier de la disponibilité des GPU ou des configurations complexes.
Tarification et plans
dstack propose une structure de tarification flexible pour répondre à différents besoins :
- dstack (Open-Source) : La plateforme de base est open-source et gratuite. Vous pouvez l'auto-héberger sur votre propre infrastructure sans frais de licence.
- dstack Sky : Un service cloud géré qui s'occupe de l'hébergement du serveur dstack pour vous. Il donne également accès à un marché des GPU les moins chers. Il offre un niveau gratuit pour commencer.
- dstack Enterprise : Une version auto-hébergée conçue pour les grandes organisations, qui inclut des fonctionnalités de niveau entreprise comme l'authentification unique (SSO), des contrôles de gouvernance avancés et un support d'entreprise dédié. une version d'essai peut être demandée pour cette version.
Ce modèle rend dstack accessible aux chercheurs individuels, aux startups et aux grandes entreprises.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 4.8K
- 2026-1: 16.2K
- 2026-2: 19.7K
- 2026-3: 11.8K
- 2026-4: 9.4K
- 2026-5: 13.1K
Geography
Top 5 countries / regions
- 🇫🇷France65.0%
- 🇺🇸États-Unis15.0%
- 🇷🇺Russie7.8%
- 🇮🇳Inde7.3%
- 🇩🇪Allemagne4.9%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 61.1% |
Email | 20.7% |
Referral | 18.2% |
Top keywords
| Keyword | Cost per click |
|---|---|
| dstack | $0.00 |
| dstack server | $0.00 |
| dstack sky free credits | $0.00 |
| sglang router | $0.00 |
| trl sft コマンドで複数ノードで実行する方法 | $0.00 |
dstack Alternatives
Union.ai
Union.ai est une plateforme de niveau entreprise, prête pour la production, pour orchestrer des flux de travail complexes d'IA et d'apprentissage automatique. Basée sur l'open-source Flyte, elle permet aux équipes de construire, servir et mettre à l'échelle des systèmes d'IA composés avec des performances et une efficacité inégalées. Elle comble le fossé entre les données et le ML, optimise les coûts du cloud avec des fonctionnalités comme le 'scale-to-zero', et améliore la vélocité des développeurs grâce à une expérience intégrée et transparente.
Orchestration
UbiOps
UbiOps est une puissante plateforme MLOps pour le service, l'orchestration et l'entraînement de modèles d'IA. Elle permet aux data scientists et aux équipes d'IA de déployer, gérer et mettre à l'échelle leurs modèles de manière transparente sur n'importe quelle infrastructure — locale, hybride ou multi-cloud — sans expertise approfondie en ingénierie. La plateforme gère la conteneurisation, la création d'API et la mise à l'échelle automatique, accélérant le passage du développement à la production pour diverses applications d'IA, y compris l'IA générative et la vision par ordinateur.
Plateforme en tant que service (PaaS)
Modelbit
Modelbit est une plateforme MLOps pour déployer des modèles de machine learning directement depuis des notebooks Python en production. Elle fournit un flux de travail d'infrastructure-as-code, permettant aux data scientists de déployer, héberger, mettre à l'échelle et gérer des modèles avec une seule ligne de code et un git push.
MLOps
Neural Vault
Neural Vault est une plateforme sécurisée et centralisée pour les développeurs IA et les équipes MLOps afin de stocker, versionner, gérer et déployer des modèles de machine learning. Elle rationalise le cycle de vie des modèles, améliore la collaboration et garantit la sécurité et la reproductibilité des projets d'IA.
Stockage
Hopsworks
Hopsworks est un AI Lakehouse en temps réel et le Feature Store le plus avancé de l'industrie. Conçu pour le MLOps, il unifie les données et le calcul pour construire et exploiter des systèmes d'IA fiables et en temps réel. Il prend en charge n'importe quel framework, cloud ou environnement sur site, permettant un développement de modèles plus rapide et une réduction significative des coûts.
Base de donnéesdstack Categories
dstack Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Union.ai
Union.ai est une plateforme de niveau entreprise, prête pour la production, pour orchestrer des flux de travail complexes d'IA et d'apprentissage automatique. Basée sur l'open-source Flyte, elle permet aux équipes de construire, servir et mettre à l'échelle des systèmes d'IA composés avec des performances et une efficacité inégalées. Elle comble le fossé entre les données et le ML, optimise les coûts du cloud avec des fonctionnalités comme le 'scale-to-zero', et améliore la vélocité des développeurs grâce à une expérience intégrée et transparente.
OrchestrationUbiOps
UbiOps est une puissante plateforme MLOps pour le service, l'orchestration et l'entraînement de modèles d'IA. Elle permet aux data scientists et aux équipes d'IA de déployer, gérer et mettre à l'échelle leurs modèles de manière transparente sur n'importe quelle infrastructure — locale, hybride ou multi-cloud — sans expertise approfondie en ingénierie. La plateforme gère la conteneurisation, la création d'API et la mise à l'échelle automatique, accélérant le passage du développement à la production pour diverses applications d'IA, y compris l'IA générative et la vision par ordinateur.
Plateforme en tant que service (PaaS)Modelbit
Modelbit est une plateforme MLOps pour déployer des modèles de machine learning directement depuis des notebooks Python en production. Elle fournit un flux de travail d'infrastructure-as-code, permettant aux data scientists de déployer, héberger, mettre à l'échelle et gérer des modèles avec une seule ligne de code et un git push.
MLOpsNeural Vault
Neural Vault est une plateforme sécurisée et centralisée pour les développeurs IA et les équipes MLOps afin de stocker, versionner, gérer et déployer des modèles de machine learning. Elle rationalise le cycle de vie des modèles, améliore la collaboration et garantit la sécurité et la reproductibilité des projets d'IA.
Stockage
DigitalOcean
DigitalOcean est une plateforme d'infrastructure cloud axée sur les développeurs qui simplifie la création, le déploiement et la mise à l'échelle d'applications. Elle offre une suite complète de produits, y compris des machines virtuelles (Droplets), Kubernetes géré et la plateforme GradientAI, fournissant des ressources GPU puissantes et des outils pour créer et héberger des applications d'IA qui changent le monde, des projets personnels aux grandes entreprises.
Hébergement
Supervised.co
Supervised.co est une plateforme de bout en bout pour la création, l'entraînement et le déploiement de modèles d'apprentissage automatique supervisé. Elle simplifie le cycle de vie MLOps avec l'annotation de données intégrée, l'entraînement de modèles automatisé et le déploiement d'API en un clic, permettant aux équipes de créer efficacement des solutions d'IA haute performance.
Annotation de données
Jyek
Jyek est une plateforme d'agent IA qui comprend les objectifs, crée des plans d'exécution, utilise des outils et fournit des résultats vérifiables pour les tâches complexes à étapes multiples.
Automatisation
Paperspace
Paperspace est une plateforme de cloud computing haute performance conçue pour l'IA et le Machine Learning. Elle offre un accès sans effort à de puissants GPU cloud, des notebooks Jupyter gérés et une plateforme MLOps complète (Gradient) pour construire, entraîner et déployer des modèles. Idéal pour les développeurs, les data scientists et les entreprises cherchant à accélérer leurs flux de travail IA sans la complexité de la gestion d'infrastructure.
Apprentissage automatique
MLflow
MLflow est une plateforme open source pour gérer le cycle de vie de l'apprentissage automatique de bout en bout. Elle permet aux développeurs et aux data scientists de suivre les expériences, de packager le code en exécutions reproductibles, de versionner et de partager les modèles, et de les déployer en production, en prenant en charge à la fois le ML traditionnel et les applications GenAI modernes.
Science des données
Anyscale
Anyscale est une plateforme de calcul entièrement gérée pour la mise à l'échelle des charges de travail d'IA et de Python. Construite sur le framework open-source Ray par ses créateurs originaux, elle permet aux développeurs de construire, d'exécuter et de mettre à l'échelle des applications distribuées, de la formation de LLM au traitement de données, avec des performances optimisées et une efficacité des coûts sur n'importe quel cloud.
MLOps
Flyte
Flyte est une plateforme d'orchestration de flux de travail open-source et native du cloud, conçue pour construire, déployer et gérer des pipelines de données, de machine learning et d'analyse de qualité production. Elle met l'accent sur la scalabilité, la reproductibilité et la facilité d'utilisation, permettant aux équipes de passer en toute transparence du développement local à la production à grande échelle. Avec un SDK Python-first et un support pour plusieurs langages, Flyte permet aux data scientists et aux ingénieurs de créer des flux de travail complexes, versionnés et maintenables.
MLOps
PloyD
PloyD est une plateforme d'opérations d'IA d'entreprise conçue pour rationaliser la mise en production des modèles et applications d'IA. Elle s'attaque aux défis courants tels que les goulots d'étranglement de la vitesse des développeurs, la complexité de l'infrastructure, l'efficacité de l'équipe et la conformité en matière de sécurité, permettant aux organisations de déployer, gérer et faire évoluer les solutions d'IA avec confiance et rapidité.
Systèmes RAG
ai-rnd.com
Une plateforme intégrée pour la recherche et le développement en IA, offrant un espace de travail unifié, des modèles pré-entraînés et un déploiement en un clic pour accélérer l'ensemble du cycle de vie de l'IA. Idéal pour les développeurs, les chercheurs et les entreprises.
Gestion des Données
Determined AI
Determined AI est une plateforme open-source d'entraînement en apprentissage profond qui simplifie et accélère le développement de modèles. Elle offre des outils intégrés pour l'optimisation des hyperparamètres, l'entraînement distribué et le suivi des expériences, permettant aux data scientists d'entraîner de meilleurs modèles plus rapidement et plus efficacement.
Science des donnéesHopsworks
Hopsworks est un AI Lakehouse en temps réel et le Feature Store le plus avancé de l'industrie. Conçu pour le MLOps, il unifie les données et le calcul pour construire et exploiter des systèmes d'IA fiables et en temps réel. Il prend en charge n'importe quel framework, cloud ou environnement sur site, permettant un développement de modèles plus rapide et une réduction significative des coûts.
Base de données
dstack Comments (0)
Sign in to comment.
ConnexionNo comments yet.