

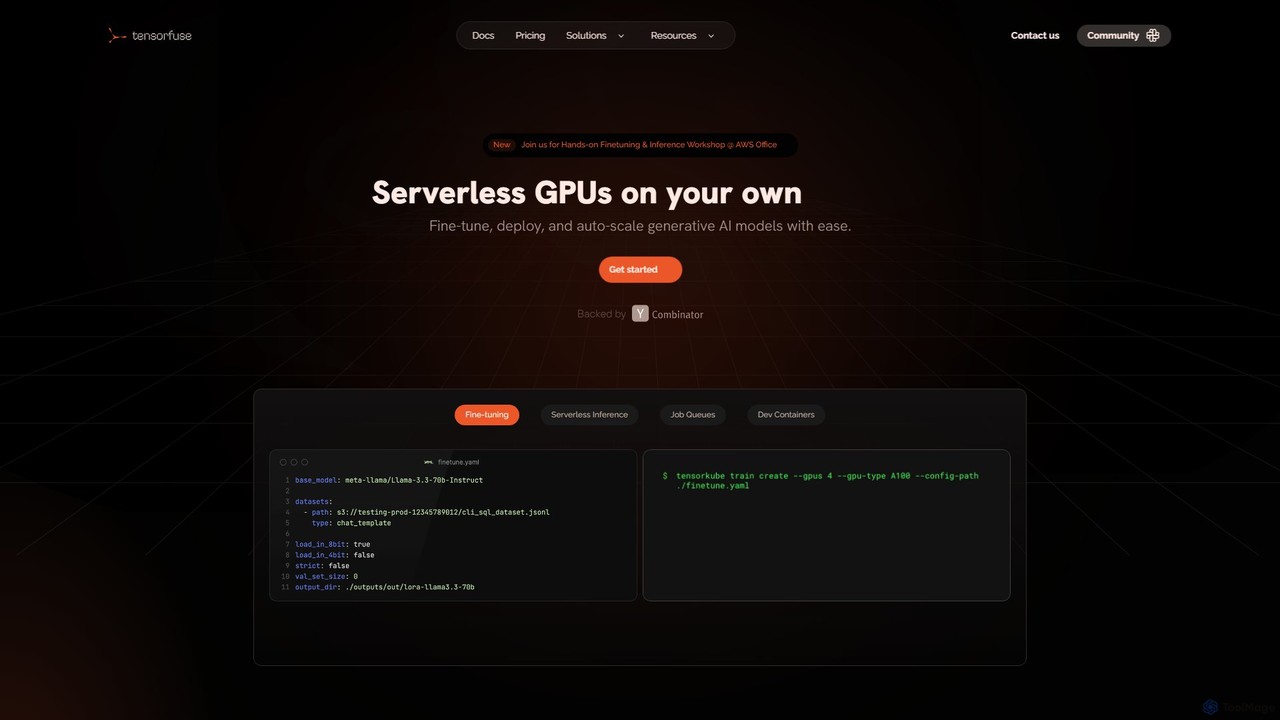
Tensorfuse Overview
Tensorfuse fournit une plateforme puissante aux développeurs et aux organisations pour gérer des GPU sans serveur directement sur leur propre infrastructure cloud AWS. Elle est conçue pour rationaliser l'ensemble du cycle de vie des modèles d'IA générative, de l'affinage et de l'expérimentation au déploiement et à la mise à l'échelle automatique en production. En faisant abstraction des complexités de Kubernetes, Docker et du provisionnement d'infrastructure, Tensorfuse permet aux équipes de se concentrer sur la création d'applications d'IA, réduisant ainsi considérablement le temps de mise sur le marché et les coûts opérationnels.
La plateforme est conçue pour offrir le meilleur des deux mondes : la simplicité d'une architecture sans serveur et la sécurité et le contrôle de l'exécution sur votre cloud privé. Cela signifie que vos données propriétaires et les poids de vos modèles ne quittent jamais vos compartiments S3 privés, garantissant une sécurité et une conformité maximales. Tensorfuse est conçu pour l'efficacité, avec un runtime de conteneur optimisé qui permet des démarrages à froid rapides pour les charges de travail GPU lourdes, permettant aux services de passer de zéro à une échelle supérieure en quelques secondes.
Comment utiliser Tensorfuse
Le démarrage avec Tensorfuse est conçu pour être un processus simple :
- Inscrivez-vous et connectez AWS : Commencez par vous inscrire à un plan (y compris un niveau gratuit 'Hacker') et connectez votre compte AWS. Tensorfuse configurera alors les ressources nécessaires dans votre environnement cloud.
- Utilisez les conteneurs de développement pour l'expérimentation : Connectez votre IDE local (comme VS Code) directement à un GPU cloud à l'aide des conteneurs de développement de Tensorfuse. Cela élimine le besoin de SSH, de copie de code et de gestion des dépendances. Toute modification de votre code local est instantanément synchronisée, permettant une expérimentation rapide en temps réel.
- Affiner les modèles : Utilisez des bibliothèques d'entraînement populaires comme Axolotl, Unsloth ou Hugging Face pour affiner des modèles open-source sur vos jeux de données propriétaires. Vous pouvez également écrire des boucles d'entraînement personnalisées. La plateforme gère le provisionnement et la gestion des GPU sous-jacents.
- Déployer pour l'inférence : Déployez vos modèles entraînés ou pré-entraînés en tant que points de terminaison sans serveur. Ces points de terminaison s'adaptent automatiquement en fonction du trafic entrant, de zéro pour gérer une forte concurrence, garantissant ainsi une rentabilité et des performances optimales. Les modèles peuvent être exposés en tant qu'API compatibles avec OpenAI.
- Gérer avec les files d'attente de tâches : Pour les tâches asynchrones comme le traitement par lots ou l'inférence hors ligne, utilisez la fonction de files d'attente de tâches. Vous pouvez mettre en file d'attente des tâches par programmation, définir des paramètres de mise à l'échelle minimum et maximum pour une allocation efficace des ressources, et surveiller leur état via une simple commande CLI.
Fonctionnalités principales de Tensorfuse
- Inférence sans serveur : Met à l'échelle automatiquement les déploiements de GPU en réponse au trafic, avec des démarrages à froid rapides (démarrage des conteneurs en quelques secondes) et la possibilité de réduire à zéro pour économiser des coûts.
- Affinage efficace : Affinez les modèles en toute sécurité sur vos données privées en utilisant le S3 de votre cloud. Il offre une intégration flexible avec des frameworks populaires comme Axolotl et Huggingface.
- Files d'attente de tâches : Déployez et mettez en file d'attente des tâches par programmation pour le traitement par lots, avec une allocation efficace des ressources et un contrôle des coûts grâce à une mise à l'échelle configurable.
- Conteneurs de développement : Connectez le code local aux GPU du cloud sans SSH pour un développement et une expérimentation rapides et itératifs directement depuis votre IDE préféré.
- Inférence Multi-LoRA : Prise en charge native pour entraîner et échanger à chaud des milliers d'adaptateurs LoRA sur un seul GPU, maximisant l'utilisation du matériel et réduisant les coûts d'inférence.
- Large prise en charge matérielle : Exécutez des charges de travail sur une variété de matériels, y compris les GPU NVIDIA (A10G, A100, H100), les puces AWS Trainium/Inferentia, les TPU et les FPGA.
- Sécurité du cloud privé : Toutes les données, jeux de données et poids de modèles restent dans vos compartiments S3 privés d'AWS, garantissant un contrôle et une sécurité complets.
Cas d'utilisation pour Tensorfuse
Tensorfuse est idéal pour un large éventail d'applications IA/ML :
- Startups et petites équipes : Créez et déployez rapidement des fonctionnalités basées sur l'IA sans équipe DevOps dédiée, passant de l'idée à la production 20 fois plus vite.
- Inférence à grande échelle : Servez des modèles d'IA générative pour des applications avec un trafic en dents de scie ou imprévisible, en ne payant que pour le calcul que vous utilisez.
- Affinage de modèles personnalisés : Les entreprises peuvent affiner des modèles de base comme Llama ou Mistral sur leurs données propriétaires pour créer des modèles spécialisés et performants pour des besoins commerciaux spécifiques.
- Charges de travail de traitement par lots : Exécutez efficacement des tâches non en temps réel telles que l'analyse de données, la génération de rapports ou l'inférence hors ligne à grande échelle à l'aide du système de file d'attente de tâches rentable.
- Recherche et expérimentation en ML : Les chercheurs et les ingénieurs ML peuvent utiliser les conteneurs de développement pour itérer rapidement sur les modèles sans attendre la configuration de l'infrastructure.
Avantages de Tensorfuse
Les utilisateurs choisissent Tensorfuse pour ses avantages significatifs, notamment une réduction rapportée de 30 % des dépenses en GPU cloud et un temps de production 20 fois plus rapide. Il élimine le besoin de solutions DevOps complexes et autogérées, libérant ainsi des ressources d'ingénierie. La plateforme offre les performances et l'évolutivité d'un service géré avec la sécurité et les avantages financiers de l'exécution sur votre propre cloud. Les témoignages soulignent l'équipe de support exceptionnelle et réactive, qui aide à la migration et aux problèmes courants, rendant le processus d'intégration fluide et efficace.
Tarification et plans
Tensorfuse propose une structure de tarification à plusieurs niveaux pour répondre à différents besoins :
- Hacker (Gratuit) : Pour les développeurs indépendants et les projets personnels. Comprend 100 heures de GPU gérées (MGH), l'inférence sans serveur, les conteneurs de développement et le support communautaire.
- Starter (249 $/mois) : Pour les petites équipes. Comprend 2 000 MGH, toutes les fonctionnalités Hacker, plus l'affinage, les actions GitHub, les domaines personnalisés et le support Slack privé. Un essai gratuit de 14 jours est disponible.
- Growth (799 $/mois) : Pour les startups en croissance. Comprend 5 000 MGH, toutes les fonctionnalités Starter, plus les tâches par lots et les files d'attente de tâches, les environnements, l'inférence Multi-LoRA et le support premium. Un essai gratuit de 14 jours est disponible.
- Enterprise (Personnalisé) : Pour les grandes organisations ayant besoin de fonctionnalités avancées. Comprend des MGH personnalisés avec des remises sur volume, toutes les fonctionnalités Growth, plus le contrôle d'accès basé sur les rôles (RBAC), le SSO, la sécurité de niveau entreprise (SOC2, HIPAA) et un support d'ingénierie dédié.
- Offre pour startups : Les startups en phase de démarrage avec moins de 500 000 $ de financement peuvent être éligibles à 10 000 heures de gestion de calcul GPU gratuites pendant 6 mois.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 10.1K
- 2026-1: 5.4K
- 2026-2: 4.2K
- 2026-3: 4.9K
- 2026-4: 5.3K
- 2026-5: 6.7K
Geography
Top 5 countries / regions
- 🇺🇸États-Unis38.2%
- 🇻🇳Viêt Nam36.6%
- 🇮🇳Inde25.2%
Top keywords
| Keyword | Cost per click |
|---|---|
| aws serverless gpu | $0.00 |
| brew install aws cli | $4.38 |
| llama.cpp serverless | $0.00 |
| llm inference servers compared: vllm vs tgi vs sglang vs triton | $0.00 |
| tensorfuse | $18.26 |
Tensorfuse Alternatives

Baseten
Baseten est une plateforme d'inférence de qualité production pour déployer, mettre à l'échelle et gérer des modèles d'IA. Elle offre des runtimes haute performance, des flux de travail de développeur fluides et des options de déploiement flexibles (cloud, auto-hébergé, hybride). Idéal pour les équipes d'ingénierie et de ML qui construisent des applications d'IA critiques.
Déploiement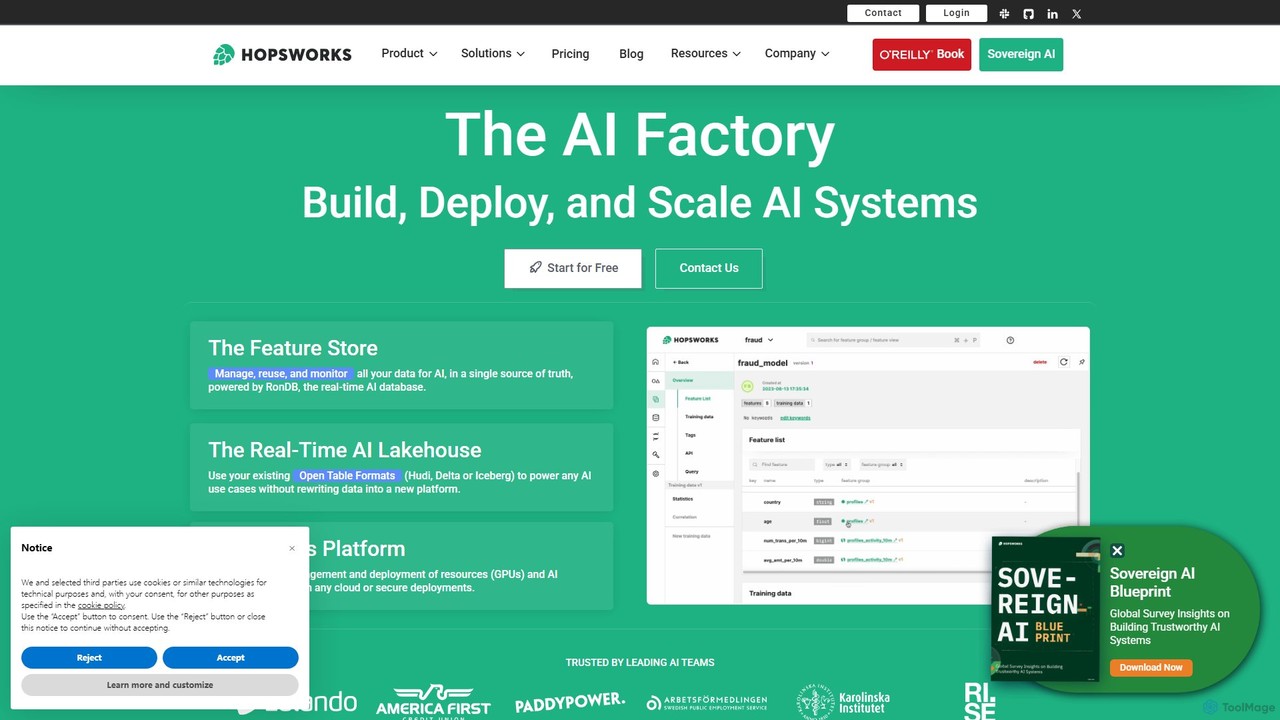
Hopsworks
Hopsworks est un AI Lakehouse en temps réel et le Feature Store le plus avancé de l'industrie. Conçu pour le MLOps, il unifie les données et le calcul pour construire et exploiter des systèmes d'IA fiables et en temps réel. Il prend en charge n'importe quel framework, cloud ou environnement sur site, permettant un développement de modèles plus rapide et une réduction significative des coûts.
Base de données
Runpod
Runpod est une plateforme cloud conçue pour l'IA et l'apprentissage automatique, offrant une puissance de calcul GPU évolutive pour le déploiement, l'entraînement et l'exécution de modèles d'IA. Elle fournit des GPU sans serveur, des modèles préconfigurés et une tarification rentable pour simplifier l'ensemble du flux de travail de développement de l'IA, de l'idée à la production.
Apprentissage automatique
Nebius
Nebius est une plateforme cloud haute performance spécialement conçue pour l'IA et l'apprentissage automatique. Elle fournit un accès aux derniers GPU NVIDIA, à des clusters évolutifs avec réseau InfiniBand et à des services entièrement gérés comme Kubernetes et Slurm, permettant un entraînement, un affinage et une inférence de modèles d'IA fluides à n'importe quelle échelle.
Apprentissage automatique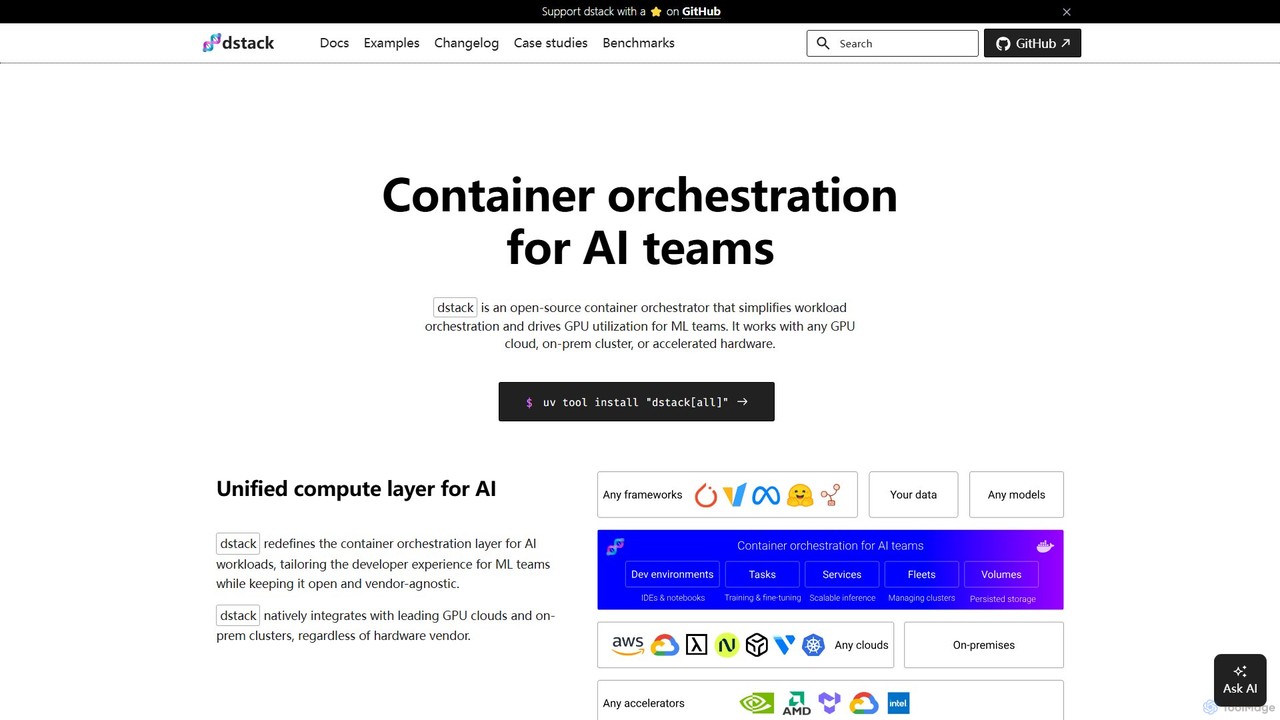
dstack
dstack est un orchestrateur de conteneurs open-source conçu pour les équipes d'IA et de ML. Il simplifie l'orchestration des charges de travail et maximise l'utilisation des GPU sur n'importe quel fournisseur de cloud, cluster sur site ou matériel accéléré. Il fournit une couche de calcul unifiée, rationalisant le développement, l'entraînement et le déploiement de modèles.
OrchestrationTensorfuse Categories
Tensorfuse Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Baseten
Baseten est une plateforme d'inférence de qualité production pour déployer, mettre à l'échelle et gérer des modèles d'IA. Elle offre des runtimes haute performance, des flux de travail de développeur fluides et des options de déploiement flexibles (cloud, auto-hébergé, hybride). Idéal pour les équipes d'ingénierie et de ML qui construisent des applications d'IA critiques.
Déploiement
Jyek
Jyek est une plateforme d'agent IA qui comprend les objectifs, crée des plans d'exécution, utilise des outils et fournit des résultats vérifiables pour les tâches complexes à étapes multiples.
AutomatisationRunpod
Runpod est une plateforme cloud conçue pour l'IA et l'apprentissage automatique, offrant une puissance de calcul GPU évolutive pour le déploiement, l'entraînement et l'exécution de modèles d'IA. Elle fournit des GPU sans serveur, des modèles préconfigurés et une tarification rentable pour simplifier l'ensemble du flux de travail de développement de l'IA, de l'idée à la production.
Apprentissage automatiqueNebius
Nebius est une plateforme cloud haute performance spécialement conçue pour l'IA et l'apprentissage automatique. Elle fournit un accès aux derniers GPU NVIDIA, à des clusters évolutifs avec réseau InfiniBand et à des services entièrement gérés comme Kubernetes et Slurm, permettant un entraînement, un affinage et une inférence de modèles d'IA fluides à n'importe quelle échelle.
Apprentissage automatiquedstack
dstack est un orchestrateur de conteneurs open-source conçu pour les équipes d'IA et de ML. Il simplifie l'orchestration des charges de travail et maximise l'utilisation des GPU sur n'importe quel fournisseur de cloud, cluster sur site ou matériel accéléré. Il fournit une couche de calcul unifiée, rationalisant le développement, l'entraînement et le déploiement de modèles.
Orchestration
GPUX
GPUX est une plateforme cloud GPU décentralisée et sans serveur pour une inférence de modèles d'IA rapide et abordable. Elle permet aux développeurs d'exécuter des modèles via une API et aux propriétaires de GPU de gagner de l'argent en contribuant leur matériel à un réseau P2P.
Déploiement de modèle
CircleCI
CircleCI est une plateforme leader d'intégration continue et de livraison continue (CI/CD) qui automatise le processus de développement logiciel. Elle permet aux équipes d'ingénierie de construire, tester et déployer du code rapidement, de manière fiable et à grande échelle, augmentant ainsi la productivité et la confiance à chaque livraison.
Gestion de l'infrastructure
Together AI
Together AI est une plateforme cloud de premier plan pour les développeurs, fournissant une infrastructure rapide et rentable pour exécuter, affiner et entraîner des modèles d'IA générative open source. Elle offre une vaste bibliothèque de plus de 200 modèles, des API d'inférence sans serveur, un affinage personnalisable et des clusters GPU dédiés, créant une solution de bout en bout pour construire et faire évoluer des applications d'IA.
Infrastructure GPU
ComfyOnline
Une plateforme cloud pour exécuter des workflows ComfyUI en ligne sans matériel coûteux. Elle offre un environnement sans serveur, un déploiement d'API en un clic pour les applications d'IA, et un accès payant à l'utilisation à des GPU haute performance comme H100 et A100. Elle simplifie l'ensemble du processus, de la création du workflow au déploiement évolutif.
API et Infrastructure
Beam
Beam est une plateforme cloud sans serveur conçue pour les développeurs afin d'exécuter, de mettre à l'échelle et de déployer facilement des modèles et des applications d'IA/ML sur des GPU. Elle offre une mise à l'échelle automatique instantanée, une facturation à la seconde et un flux de travail simplifié, vous permettant de passer du code à une API évolutive en quelques minutes sans gérer une infrastructure complexe.
Apprentissage automatique
Addepto
Addepto est une société leader dans le développement d'IA et le conseil en Big Data qui dote les entreprises de solutions d'IA personnalisées. Spécialisée en science des données, en apprentissage automatique, en MLOps et en stratégie d'IA générative, elle aide ses clients à transformer des données complexes en informations exploitables et en avantage concurrentiel. Addepto propose des services de bout en bout, de la consultation initiale à la mise en œuvre et au support continu, garantissant des solutions sur mesure qui génèrent des résultats commerciaux tangibles.
Conseil
ComfyDeploy
ComfyDeploy est une plateforme cloud conçue pour que les équipes puissent créer, partager et mettre à l'échelle des flux de travail ComfyUI. Elle permet le déploiement en un clic d'API prêtes pour la production, fournit une infrastructure GPU à mise à l'échelle automatique et offre des interfaces simplifiées pour les utilisateurs non techniques. Collaborez en toute transparence, gérez les nœuds et modèles personnalisés, et transformez des processus créatifs complexes en applications évolutives sans surcharge d'ingénierie.
Déploiement de modèle
Release.ai
Release.ai est une plateforme de niveau entreprise pour les développeurs afin de déployer, gérer et mettre à l'échelle facilement des modèles d'IA haute performance. Elle offre une latence d'inférence inférieure à 100 ms, une mise à l'échelle automatique transparente, une sécurité robuste et une vaste bibliothèque de modèles pré-optimisés, permettant une intégration rapide dans n'importe quel flux de travail de développement avec seulement quelques lignes de code.
Plateforme en tant que service (PaaS)
LastMile AI
LastMile AI est une plateforme de développement de niveau entreprise pour tester, évaluer et surveiller les applications d'IA générative. Elle fournit des outils comme AutoEval pour l'ajustement fin d'évaluateurs personnalisés, la génération de données synthétiques et la surveillance en temps réel afin de garantir la fiabilité et la préparation à la production des systèmes d'IA.
Évaluation de Modèle
MonsterAPI
MonsterAPI est une plateforme axée sur les développeurs qui simplifie l'ajustement fin (fine-tuning) et le déploiement de modèles d'IA générative open-source. Elle propose une interface de chat sans code, MonsterGPT, pour gérer des tâches complexes, prenant en charge des modèles comme Llama, SDXL et Whisper. La plateforme fournit des points de terminaison d'API évolutifs et une infrastructure GPU de niveau entreprise pour une fraction du coût et du temps habituels, rendant l'IA avancée accessible à tous les développeurs.
Plateforme en tant que service (PaaS)
Tensorfuse Comments (0)
Sign in to comment.
ConnexionNo comments yet.