ToolMage
Connexion

AI TOOL COMPARISON

dstack vs Neural Vault

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Aperçu du produit

dstack Aperçu du produit

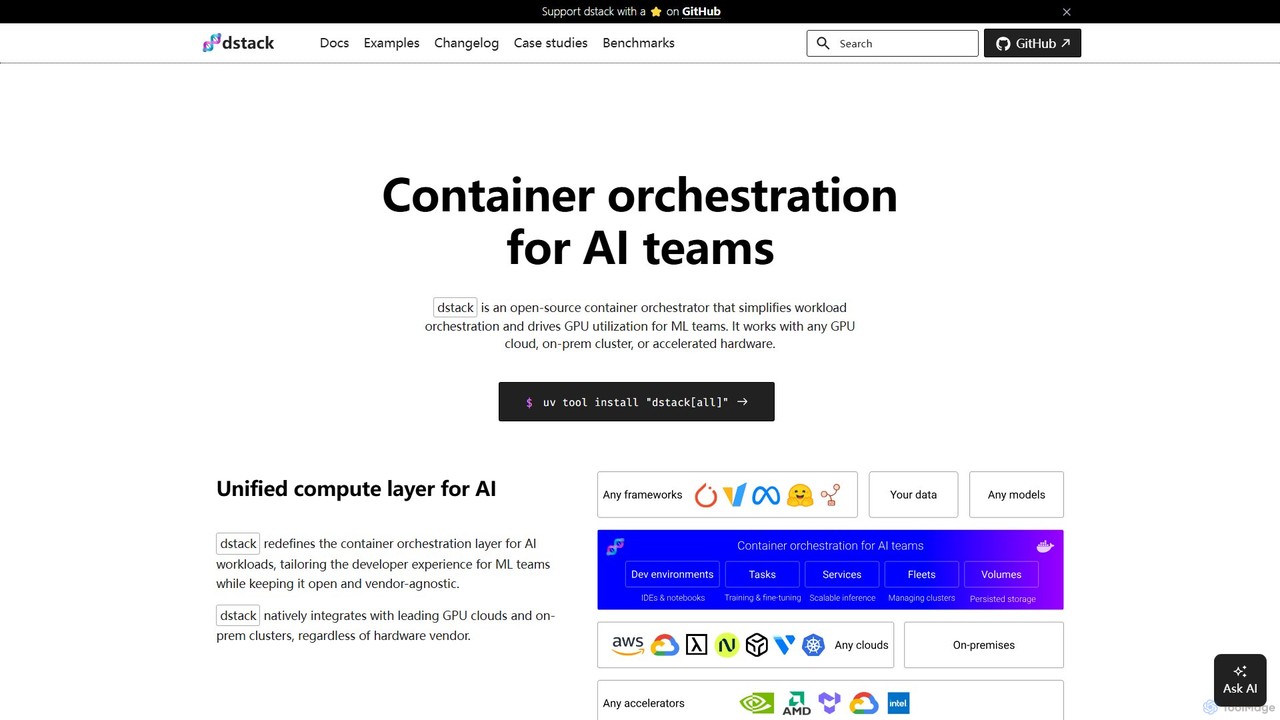
dstack est un orchestrateur de conteneurs open-source conçu pour les équipes d'IA et de ML. Il simplifie l'orchestration des charges de travail et maximise l'utilisation des GPU sur n'importe quel fournisseur de cloud, cluster sur site ou matériel accéléré. Il fournit une couche de calcul unifiée, rationalisant le développement, l'entraînement et le déploiement de modèles.

Preview

Neural Vault Aperçu du produit

Neural Vault est une plateforme sécurisée et centralisée pour les développeurs IA et les équipes MLOps afin de stocker, versionner, gérer et déployer des modèles de machine learning. Elle rationalise le cycle de vie des modèles, améliore la collaboration et garantit la sécurité et la reproductibilité des projets d'IA.

Preview

Données clés

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

dstack VS Neural Vault — Données clés
Données clésdstackNeural Vault
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusOrchestrationStockage
Publics et métiersNon vérifiéNon vérifié
CatégoriesOrchestration · MLOps · Gestion d'infrastructureStockage · MLOps · Collaboration
Added8 août 202510 août 2025
Mis à jour19 nov. 202619 nov. 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

dstack

dstack est un puissant orchestrateur de conteneurs open-source spécialement conçu pour relever les défis auxquels sont confrontées les équipes d'Intelligence Artificielle et de Machine Learning. Son objectif principal est de simplifier le processus complexe d'orchestration des charges de travail et d'améliorer considérablement l'utilisation des ressources GPU coûteuses. En tant que plateforme agnostique vis-à-vis des fournisseurs, dstack offre une couche de calcul unifiée qui s'intègre de manière transparente avec n'importe quel cloud GPU (comme AWS, GCP, Azure, OCI), les clusters sur site et une large gamme de matériel accéléré, y compris NVIDIA, AMD, TPU, et plus encore. Cette flexibilité garantit que les équipes ne sont pas enfermées chez un seul fournisseur et peuvent exploiter le meilleur matériel pour leurs besoins, où qu'il se trouve.

La plateforme est conçue avec l'expérience du développeur au cœur, en abstrayant les complexités de l'infrastructure sous-jacente. Cela permet aux ingénieurs ML et aux chercheurs de se concentrer sur la construction, l'entraînement et le déploiement de modèles plutôt que sur la gestion des serveurs, des dépendances et de la mise à l'échelle. dstack est approuvé par des équipes ML de classe mondiale dans des entreprises comme Electronic Arts et Mobius Labs pour sa capacité à passer du prototypage rapide à de grands travaux d'entraînement distribués sur plusieurs nœuds.

Comment utiliser dstack

Démarrer avec dstack est un processus simple conçu pour une adoption rapide :

  1. Configurer le serveur : Vous pouvez commencer par installer le serveur dstack sur votre machine locale en utilisant une commande simple comme uv tool install "dstack[all]" et en l'exécutant avec dstack server. Alternativement, vous pouvez le déployer n'importe où en utilisant l'image Docker officielle ou vous inscrire à dstack Sky, la version cloud gérée, pour éviter de l'héberger vous-même.
  2. Définir les configurations : Les flux de travail dans dstack sont définis à l'aide de simples fichiers YAML dans votre dépôt de projet. Ces configurations décrivent l'environnement, les ressources et les commandes pour vos tâches. Les types de configuration clés incluent :
    • Environnements de développement (Dev Environments) : Pour le développement interactif, vous permettant de connecter votre IDE local (comme VS Code) à une puissante machine GPU distante.
    • Tâches (Tasks) : Pour planifier des travaux par lots, tels que le pré-entraînement ou l'ajustement fin de modèles. Idéal pour les charges de travail qui s'exécutent jusqu'à leur achèvement.
    • Services (Services) : Pour déployer des modèles en tant que points de terminaison sécurisés, à mise à l'échelle automatique et compatibles avec OpenAI.
    • Flottes (Fleets) : Pour gérer des groupes d'instances cloud ou sur site comme un seul pool de ressources.
  3. Appliquer les configurations : Une fois votre fichier YAML prêt, vous l'appliquez à l'aide de l'interface de ligne de commande : dstack apply. dstack s'occupe alors du reste : provisionnement de l'infrastructure nécessaire, planification du travail, gestion de la mise à l'échelle automatique, gestion de la redirection de port et diffusion des journaux vers votre terminal. Pour une exécution détachée, vous pouvez utiliser l'indicateur -d.

Fonctionnalités principales de dstack

  • Couche de calcul unifiée : Fournit un plan de contrôle unique et agnostique vis-à-vis des fournisseurs pour toutes vos ressources de calcul IA, que ce soit sur le cloud ou sur site.
  • Large prise en charge des accélérateurs : Prend en charge nativement une large gamme de matériel, y compris les GPU NVIDIA, les GPU AMD, les TPU Google Cloud, Intel Gaudi et les accélérateurs Tenstorrent.
  • Flux de travail centrés sur le développeur : Offre des configurations spécialisées comme les environnements de développement pour le codage interactif, les tâches pour le traitement par lots et les services pour un déploiement facile des modèles.
  • Gestion efficace des ressources : Dispose d'un planificateur intégré pour maximiser l'utilisation des GPU. Il inclut des politiques pour terminer automatiquement les instances sous-utilisées, ce qui permet de réduire les coûts.
  • Intégration transparente : Fonctionne sans problème avec les principaux clouds GPU (AWS, GCP, Azure, OCI) et peut s'exécuter sur des clusters Kubernetes existants. Les flottes SSH permettent de connecter des serveurs bare-metal.
  • Services à mise à l'échelle automatique : Déployez facilement des modèles en tant que services prêts pour la production avec des fonctionnalités telles que la mise à l'échelle automatique, le HTTPS et des points de terminaison API compatibles avec OpenAI.
  • Persistance des données : Prend en charge les volumes réseau et d'instance pour conserver les données, les modèles et les caches entre les exécutions, garantissant que l'état n'est pas perdu.
  • Configuration avancée : Permet un contrôle fin avec des fonctionnalités telles que les politiques de nouvelle tentative pour les problèmes de capacité, la gestion des variables d'environnement et la prise en charge des images Docker personnalisées.

Cas d'utilisation pour dstack

dstack est polyvalent et prend en charge une large gamme de flux de travail ML :

  • Entraînement et ajustement fin de modèles : Exécutez des travaux d'entraînement sur un seul nœud ou distribués pour de grands modèles de langage (LLM) en utilisant des frameworks populaires comme TRL, Axolotl et DeepSpeed.
  • Inférence et service de modèles : Déployez des modèles optimisés pour l'inférence en utilisant des frameworks de service haute performance comme vLLM, SGLang, TGI et NVIDIA NIM.
  • Développement IA interactif : Les ingénieurs ML peuvent lancer de puissants environnements de développement soutenus par des GPU en quelques secondes, en connectant leur IDE local pour expérimenter et déboguer le code de manière interactive.
  • Gestion de clusters haute performance : Configurez et exécutez des tests (par exemple, des tests NCCL) sur des clusters spécialisés à plusieurs nœuds comme GCP A3 Mega ou des instances compatibles AWS EFA.
  • Optimisation des coûts inter-cloud : Comparez et utilisez sans effort les instances GPU les plus rentables parmi différents fournisseurs de cloud pour une tâche donnée.

Avantages de dstack

Le principal avantage de dstack est sa capacité à simplifier considérablement l'infrastructure IA. Il donne aux équipes ML les moyens de se concentrer sur leurs recherches et leurs modèles plutôt que sur l'infrastructure. Les principaux avantages incluent une productivité accrue, des économies de coûts significatives grâce à une meilleure utilisation des GPU et à l'accès aux instances spot, et la prévention de l'enfermement propriétaire (vendor lock-in). Sa nature open-source favorise la transparence et le développement communautaire, tandis que sa conception centrée sur le développeur rend incroyablement facile la définition d'une configuration et son exécution sans se soucier de la disponibilité des GPU ou des configurations complexes.

Tarification et plans

dstack propose une structure de tarification flexible pour répondre à différents besoins :

  • dstack (Open-Source) : La plateforme de base est open-source et gratuite. Vous pouvez l'auto-héberger sur votre propre infrastructure sans frais de licence.
  • dstack Sky : Un service cloud géré qui s'occupe de l'hébergement du serveur dstack pour vous. Il donne également accès à un marché des GPU les moins chers. Il offre un niveau gratuit pour commencer.
  • dstack Enterprise : Une version auto-hébergée conçue pour les grandes organisations, qui inclut des fonctionnalités de niveau entreprise comme l'authentification unique (SSO), des contrôles de gouvernance avancés et un support d'entreprise dédié. une version d'essai peut être demandée pour cette version.

Ce modèle rend dstack accessible aux chercheurs individuels, aux startups et aux grandes entreprises.

Neural Vault

Neural Vault est une plateforme MLOps de niveau entreprise conçue pour servir de référentiel central et sécurisé pour tous vos modèles de machine learning. Dans le paysage complexe du développement de l'IA, la gestion des versions de modèles, la garantie de la reproductibilité et la rationalisation du déploiement peuvent être des défis importants. Neural Vault répond à ces problèmes en fournissant un environnement unifié qui agit comme une source unique de vérité pour les scientifiques des données, les ingénieurs en machine learning et les équipes DevOps. Il est conçu pour protéger vos actifs d'IA les plus précieux — vos modèles entraînés — tout en accélérant le passage de l'expérimentation à la production.

La plateforme est plus qu'un simple stockage ; c'est une solution complète de gestion du cycle de vie des modèles. Elle s'intègre de manière transparente dans les flux de travail existants, offrant des outils robustes pour le contrôle de version, le suivi des métadonnées et la collaboration. En traitant les modèles comme des citoyens de première classe dans le cycle de vie du développement logiciel, Neural Vault aide les organisations à mettre en œuvre les meilleures pratiques en matière de gouvernance, de conformité et de sécurité dans leurs initiatives d'IA, favorisant ainsi l'innovation et réduisant les frais généraux opérationnels.

Comment utiliser Neural Vault

L'utilisation de Neural Vault est conçue pour être intuitive pour les développeurs et les professionnels du MLOps. Le processus suit généralement ces étapes :

  1. Configuration du Projet : Commencez par vous inscrire et créer un nouveau projet ou espace de travail. Cela sert de conteneur pour les modèles et les collaborations connexes.
  2. Téléchargement du Modèle : Après avoir entraîné un modèle, vous pouvez le télécharger dans le coffre-fort en utilisant l'interface utilisateur web, une interface de ligne de commande (CLI) ou une API REST. La plateforme prend en charge tous les principaux formats de modèles, y compris TensorFlow, PyTorch, scikit-learn et ONNX.
  3. Versionnement et Métadonnées : Chaque fois que vous téléchargez un modèle, Neural Vault peut créer automatiquement une nouvelle version. Vous pouvez joindre des métadonnées riches à chaque version, telles que l'ensemble de données utilisé, les hyperparamètres, les métriques de performance (par exemple, la précision, le score F1) et les liens vers le référentiel de code d'entraînement. Cela crée une lignée complète pour une reproductibilité totale.
  4. Collaboration : Invitez des membres de l'équipe à votre projet et attribuez des rôles (par exemple, lecteur, contributeur, administrateur) pour contrôler l'accès. Les équipes peuvent examiner, commenter et approuver les modèles avant qu'ils ne soient promus à l'étape suivante.
  5. Intégration et Déploiement : Intégrez Neural Vault dans vos pipelines CI/CD. Utilisez l'API ou la CLI pour extraire des versions de modèles spécifiques pour des tests et un déploiement automatisés. La plateforme offre des intégrations pré-construites pour le déploiement dans des environnements comme Kubernetes, AWS SageMaker, Google Vertex AI et Azure ML.
  6. Surveillance : Une fois qu'un modèle est déployé, vous pouvez utiliser des webhooks ou des intégrations d'API pour renvoyer les données de performance de production dans Neural Vault, ce qui vous permet de surveiller la dérive du modèle et la dégradation des performances au fil du temps.

Fonctionnalités principales de Neural Vault

  • Registre de Modèles Sécurisé : Un référentiel centralisé et crypté pour stocker tous vos modèles de ML et artefacts associés.
  • Contrôle de Version Avancé : Versionnement automatique des modèles avec une sémantique de type Git, vous permettant de suivre les modifications, de comparer les versions et de revenir en arrière si nécessaire.
  • Gestion Riche des Métadonnées : La capacité de stocker et d'interroger des métadonnées étendues, garantissant que le contexte et les performances de chaque modèle sont bien documentés.
  • Collaboration en Équipe : Espaces de travail et contrôle d'accès basé sur les rôles (RBAC) pour faciliter une collaboration sécurisée entre les équipes de science des données, d'ingénierie et d'opérations.
  • Indépendant du Framework : Prise en charge complète de tous les principaux frameworks et bibliothèques de machine learning.
  • API et CLI Robustes : Une API puissante et un outil en ligne de commande permettent l'automatisation et une intégration transparente dans n'importe quel flux de travail MLOps.
  • Automatisation du Déploiement : Rationalisez le processus de déploiement des modèles dans divers environnements de pré-production et de production.
  • Pistes d'Audit et de Conformité : Maintenez un journal complet et immuable de toutes les activités pour la gouvernance et la conformité réglementaire.

Cas d'utilisation pour Neural Vault

Neural Vault est polyvalent et peut être appliqué dans diverses industries et équipes :

  • Équipes MLOps : Pour construire et maintenir des pipelines CI/CD robustes et automatisés pour le machine learning.
  • Équipes de Science des Données : Pour gérer les expériences, partager les modèles et assurer la reproductibilité de leur travail.
  • Gouvernance et Informatique d'Entreprise : Pour appliquer les politiques de sécurité, gérer l'accès aux modèles d'IA sensibles et assurer la conformité avec des réglementations comme le RGPD ou l'HIPAA.
  • Startups en IA : Pour établir rapidement une base MLOps solide sans investir massivement dans la construction d'une infrastructure personnalisée.
  • Institutions de Recherche : Pour créer un référentiel partagé et versionné pour les modèles, facilitant la collaboration et la validation des résultats de recherche.

Avantages de Neural Vault

Neural Vault offre un avantage concurrentiel distinct en se concentrant sur la sécurité, la collaboration et l'automatisation. Son principal avantage est de fournir une 'source unique de vérité' qui comble le fossé entre le développement de modèles et les opérations de production. Cette centralisation réduit considérablement les erreurs, améliore l'efficacité et renforce la sécurité. De plus, son accent sur la reproductibilité et le suivi de la lignée est essentiel pour les industries réglementées et pour instaurer la confiance dans les systèmes d'IA. En simplifiant le déploiement et l'intégration, il raccourcit considérablement le temps de cycle 'du laboratoire à la production', permettant aux entreprises de valoriser plus rapidement leurs investissements en IA.

Tarification et plans

Neural Vault propose une structure de tarification à plusieurs niveaux pour répondre à différents besoins :

  • Plan Développeur (Gratuit) : Idéal pour les développeurs individuels et les amateurs. Comprend jusqu'à 3 projets privés, 5 Go de stockage et un support communautaire.
  • Plan Équipe (25 $ par utilisateur/mois) : Conçu pour les équipes de petite et moyenne taille. Comprend des projets illimités, 50 Go de stockage par utilisateur, des fonctionnalités de collaboration avancées et un support par e-mail prioritaire.
  • Plan Entreprise (Tarification sur mesure) : Pour les grandes organisations ayant des besoins avancés. Comprend tout ce qui est dans le plan Équipe plus l'intégration SSO, les options de déploiement sur site, un support dédié et des fonctionnalités de sécurité et de conformité avancées.

Positionnement

La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.

Catégories

Commun
MLOps
Uniquement dstack
OrchestrationGestion d'infrastructure
Uniquement Neural Vault
StockageCollaboration

Étiquettes

Commun
Développement de l'IAapprentissage automatiqueMLOpsDéploiement de modèle
Uniquement dstack
informatique en nuageOrchestration de conteneursGestion GPUInfrastructure en tant que codeKubernetesOpen source
Uniquement Neural Vault
CI/CD pour l'IACollaborationGestion de modèlesRegistre de modèlesContrôle de version

Publics et métiers

Commun
Aucune donnée vérifiée
Uniquement dstack
Aucune donnée vérifiée
Uniquement Neural Vault
Aucune donnée vérifiée

Comparaison du trafic

Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

dstack monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
13.1K
Durée moyenne
0:02
Pages par visite
1.21
Taux de rebond
53.77%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 4.8K
  • 2026-01: 16.2K
  • 2026-02: 19.7K
  • 2026-03: 11.8K
  • 2026-04: 9.4K
  • 2026-05: 13.1K

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇫🇷France64.99%8.5K
🇺🇸United States15.02%2K
🇷🇺Russia7.76%1K
🇮🇳India7.35%962
🇩🇪Germany4.88%639

Sources de trafic

Source typePercentageEstimated visits
Direct61.06%8K
E-mail20.74%2.7K
Référence18.2%2.4K

Mots-clés

dstackdstack serverdstack sky free creditssglang routertrl sft コマンドで複数ノードで実行する方法

Neural Vault

Non vérifié

Signaux communautaires

Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.

dstack

Note
Non vérifié
Commentaires
0
Favoris
215
J’aime
208

Neural Vault

Note
Non vérifié
Commentaires
0
Favoris
181
J’aime
162

dstack vs Neural Vault · FAQ comparative

What do dstack and Neural Vault have in common?
Both tools are listed under MLOps. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are dstack and Neural Vault free?
Listed pricing models: dstack — Freemium; Neural Vault — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between dstack and Neural Vault?
The primary listed category is Orchestration for dstack, and Stockage for Neural Vault. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparatifs associés