Foxscrape
Extraction de Données
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
Extraction de Données
Extraction de Données
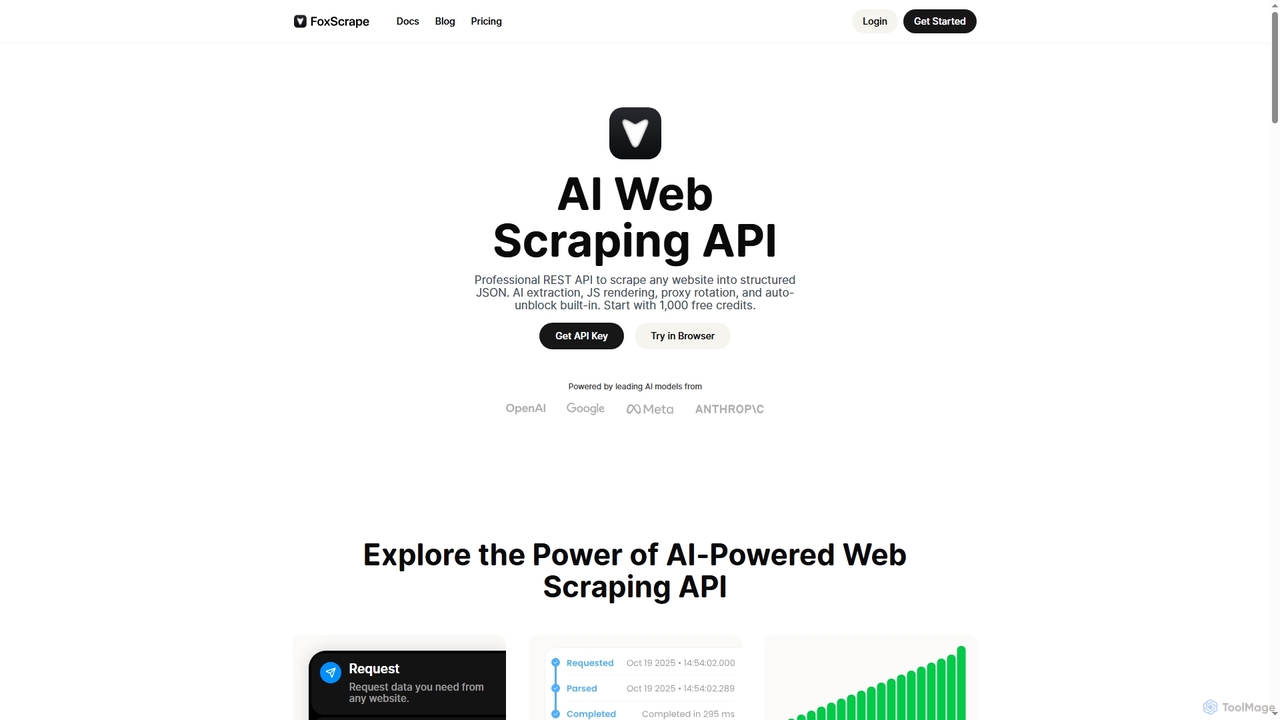
FoxScrape est une API REST de web scraping alimentée par l'IA pour les développeurs. Elle simplifie l'extraction de données en convertissant n'importe quel site web en données JSON structurées à l'aide de fonctionnalités telles que l'analyse pilotée par l'IA à partir de l'anglais simple, le rendu JavaScript pour les sites dynamiques et la rotation automatique de proxy pour éviter les blocages.
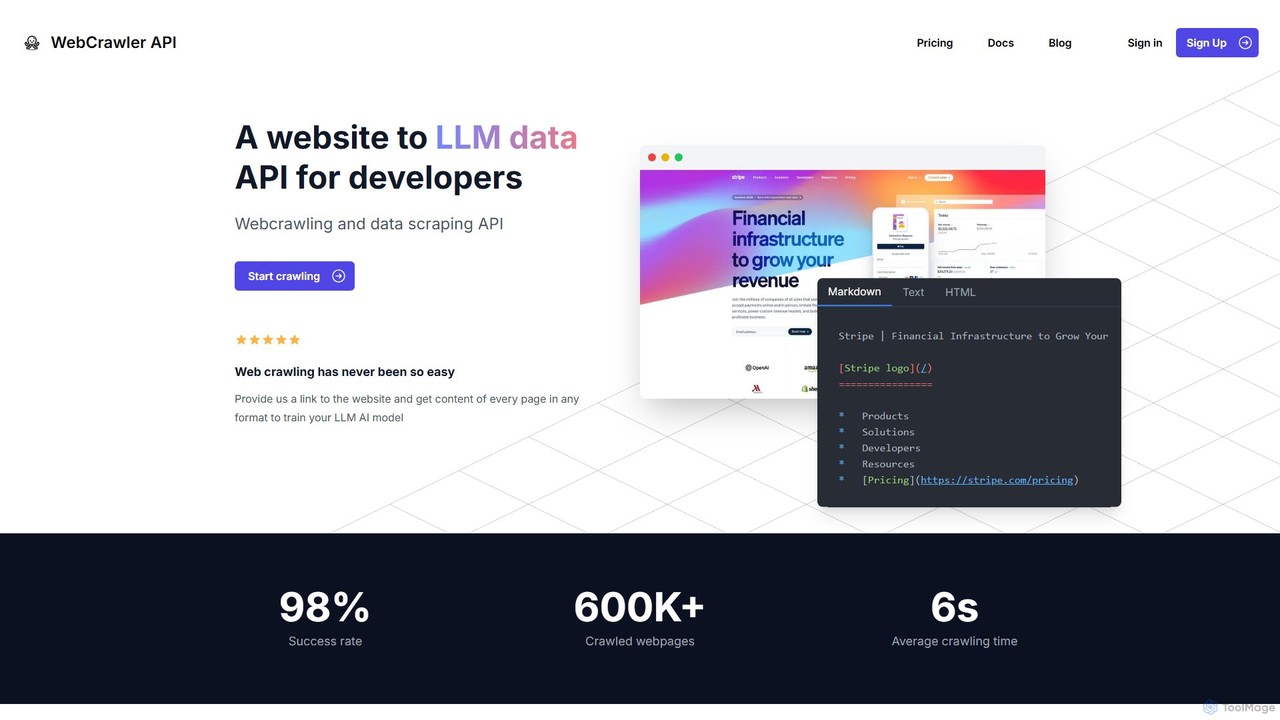
Webcrawlerapi est une API puissante pour les développeurs permettant de crawler sans effort des sites web et d'extraire des données propres. Elle simplifie le web scraping en gérant le rendu JavaScript, les mesures anti-bot et l'analyse des données. Idéale pour collecter du contenu structuré comme du Markdown ou du texte pour entraîner des modèles d'IA LLM ou pour les systèmes de Génération Augmentée par Récupération (RAG), elle offre un taux de réussite élevé et un modèle de tarification simple au paiement à l'usage.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Données clés | Foxscrape | Webcrawlerapi |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | Extraction de Données | Extraction de Données |
| Publics et métiers | Analyste d'affaires · Analyste de données · Scientifique de données · Responsable Marketing · Chef de Produit · Développeur de logiciels | Non vérifié |
| Catégories | Extraction de Données · API · Automatisation | Extraction de Données · API · Automatisation |
| Added | 5 nov. 2025 | 2 août 2025 |
| Mis à jour | 19 nov. 2026 | 19 nov. 2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
FoxScrape fournit une API REST professionnelle conçue pour rationaliser le processus de web scraping pour les développeurs. Elle permet aux utilisateurs d'extraire des données structurées de n'importe quel site web et de les recevoir dans un format JSON propre. La plateforme est conçue pour être puissante mais facile à utiliser, s'adressant à la fois aux débutants et aux professionnels expérimentés. Elle exploite des milliers d'instances Chrome sans tête pour s'assurer que les requêtes API se comportent comme un véritable utilisateur, contournant les mesures anti-bot courantes et extrayant les données de manière fiable à grande échelle.
Pour utiliser FoxScrape, les développeurs peuvent commencer par obtenir une clé API gratuite qui inclut 1 000 crédits. L'intégration est simple : effectuez un appel API REST au point de terminaison de FoxScrape, en incluant votre clé API dans l'en-tête 'Authorization' et l'URL cible en tant que paramètre. Pour les sites web dynamiques construits avec des frameworks comme React ou Vue, il suffit d'activer le paramètre 'render_js'. Pour une extraction intelligente, décrivez les données requises en anglais simple, et l'IA se chargera de l'analyse sans avoir besoin de sélecteurs CSS ou XPath.
FoxScrape est idéal pour une variété de tâches d'extraction de données. Les développeurs et les analystes de données peuvent l'utiliser pour la surveillance des prix sur les sites de commerce électronique, la collecte d'annonces immobilières, l'agrégation d'avis clients, la réalisation d'études de marché en extrayant les données des concurrents, et l'extraction des résultats des moteurs de recherche pour l'analyse SEO. Sa capacité à gérer des sites complexes le rend également adapté à l'extraction de données à partir de portails financiers, de médias sociaux et de sites d'actualités.
Le principal avantage de FoxScrape est son intelligence et sa fiabilité. L'extraction alimentée par l'IA élimine le besoin de sélecteurs CSS fragiles, rendant les scrapers plus résistants aux mises à jour des sites web. La rotation de proxy intégrée et le rendu au niveau du navigateur garantissent des taux de réussite élevés et empêchent le blocage. Il offre une solution tout-en-un qui combine un scraper, un moteur de rendu et un gestionnaire de proxy en une seule API évolutive, ce qui permet aux développeurs d'économiser un temps et des efforts considérables par rapport à la création et à la maintenance d'une configuration maison.
FoxScrape propose un modèle de tarification transparent avec un essai gratuit. Les nouveaux utilisateurs reçoivent 1 000 crédits API gratuits sans avoir besoin de carte de crédit.
Webcrawlerapi est une API spécialisée conçue pour rationaliser le processus de crawling web et d'extraction de données pour les développeurs. À une époque où les données sont cruciales pour l'entraînement des grands modèles de langage (LLM) et l'alimentation des applications d'IA, le web scraping traditionnel présente des défis importants. Ceux-ci incluent la gestion du contenu dynamique rendu par JavaScript, le contournement des systèmes anti-bot sophistiqués, la gestion des proxys et le nettoyage du HTML désordonné en formats utilisables. Webcrawlerapi abstrait toutes ces complexités, fournissant une interface simple mais puissante pour transformer n'importe quel site web en une source de données structurée.
Avec un taux de réussite rapporté de 98% et un temps de crawling moyen de seulement 6 secondes, le service est conçu pour l'efficacité et la fiabilité. Il permet aux développeurs de se concentrer sur la logique de leur application principale au lieu de s'enliser dans les subtilités de la construction et de la maintenance d'une infrastructure de crawling évolutive. En fournissant un lien, les développeurs peuvent recevoir du contenu propre et prêt à l'emploi dans des formats comme le Markdown, le texte ou le HTML brut, ce qui le rend parfait pour alimenter les pipelines d'entraînement de modèles d'IA ou les bases de connaissances pour les systèmes RAG.
L'intégration de Webcrawlerapi dans votre projet est conçue pour être simple. Le processus ne nécessite généralement que quelques lignes de code. Tout d'abord, vous devez vous inscrire sur le site web de Webcrawlerapi pour obtenir votre clé d'accès API unique. Ensuite, vous pouvez utiliser l'une de leurs bibliothèques clientes fournies pour les langages de programmation populaires.
Par exemple, dans un environnement NodeJS, vous commenceriez par installer la bibliothèque cliente via npm : npm i webcrawlerapi-js. Ensuite, dans votre code, vous importez la bibliothèque, créez une nouvelle instance de client avec votre clé API, et appelez la méthode `crawl`. Cette méthode prend des paramètres tels que l' `url` cible, le `scrape_type` souhaité (par exemple, 'markdown'), et des limites optionnelles comme `items_limit`. L'API gère ensuite l'ensemble du processus de crawling en arrière-plan et renvoie une réponse JSON structurée avec les données extraites. Des modèles d'intégration simples similaires sont disponibles pour Python, PHP et .NET, le rendant accessible à un large éventail de développeurs.
Webcrawlerapi est polyvalent et peut être appliqué à une variété de tâches à forte intensité de données. Ses principaux cas d'utilisation tournent autour de l'IA et de l'analyse de données.
Le principal avantage de Webcrawlerapi est sa simplicité et son efficacité. Il permet aux équipes de développement de déléguer l'ensemble de l'infrastructure de crawling web et de la charge de maintenance. Cela se traduit par un délai de mise sur le marché plus rapide pour les produits basés sur les données. Le taux de réussite élevé (98%) et les fonctionnalités anti-bot robustes garantissent la fiabilité des pipelines de données. De plus, son modèle de tarification transparent au paiement à l'usage est très rentable, car vous ne payez que pour les requêtes réussies, éliminant ainsi le risque et les frais généraux associés aux abonnements ou à la construction d'une solution interne.
Webcrawlerapi emploie un modèle de tarification 'paiement à l'usage' simple et transparent, évitant complètement les abonnements et les frais cachés. Les coûts sont calculés en fonction du nombre de pages que vous crawlez avec succès chaque mois. Le service inclut des tâches de crawl illimitées, un réseau de proxy illimité et géré automatiquement, et un support par e-mail dans sa tarification. Pour une estimation claire des coûts, le site web fournit un calculateur. Par exemple, le crawling de 10 000 pages en un mois coûterait environ 20 $. Ce modèle est idéal pour les projets de toutes tailles, des expériences à petite échelle aux opérations de données à grande échelle, car les coûts évoluent directement avec l'utilisation. La plateforme permet également aux utilisateurs d'essayer le service avant d'acheter, probablement via une allocation de crédit gratuite pour les nouveaux comptes.
La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.
Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇧🇷Brazil | 27.03% | 439 |
| 🇨🇭Switzerland | 25.81% | 419 |
| 🇮🇳India | 25.7% | 417 |
| 🇦🇹Austria | 15.65% | 254 |
| 🇺🇸United States | 5.81% | 94 |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 49.13% | 2.7K |
| 🇩🇪Germany | 20.9% | 1.1K |
| 🇮🇳India | 14.85% | 809 |
| 🇻🇳Vietnam | 12.23% | 666 |
| 🇦🇺Australia | 2.89% | 157 |
Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.
Oui, Foxscrape est conçu pour scraper les sites web modernes. En activant le paramètre `render_js` dans votre requête API, le service utilise des instances de Chrome sans tête pour rendre entièrement n'importe quel site construit avec des frameworks comme React, Vue ou Angular, vous permettant d'extraire du contenu dynamique.
Vous pouvez intégrer Foxscrape en effectuant des requêtes HTTP vers son point de terminaison d'API REST. Selon la documentation, vous devez inclure votre clé API dans l'en-tête `Authorization` en tant que jeton Bearer (par exemple, `Authorization: Bearer YOUR_API_KEY`). La documentation fournit des exemples pour cURL et l'API `fetch` de JavaScript pour vous aider à démarrer rapidement.
Foxscrape emploie un système de rotation automatique de proxy qui s'appuie sur un grand pool géo-distribué de proxys premium. Cette fonctionnalité fait tourner automatiquement les adresses IP pour vos requêtes, réduisant considérablement les chances de rencontrer des limites de taux, des CAPTCHA et des interdictions d'IP de la part des sites web cibles.
L'API Foxscrape utilise des codes de statut HTTP standard pour indiquer le résultat d'une requête. Selon la documentation, une requête réussie renvoie un code de statut `200`. Les erreurs sont indiquées par des codes comme `400` pour les mauvaises requêtes (paramètres manquants/invalides), `401` pour une clé API invalide, ou `500` pour une erreur interne du serveur.
Foxscrape propose deux principaux plans payants : le plan Starter à 20 $/mois pour 150 000 crédits API et 20 requêtes simultanées, et le plan Pro à 79 $/mois pour 1 000 000 de crédits API et 100 requêtes simultanées. Il existe également un essai gratuit qui fournit 1 000 crédits API aux nouveaux utilisateurs sans nécessiter de carte de crédit.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.