ToolMage
Connexion

AI TOOL COMPARISON

UseScraper vs Webcrawlerapi

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Aperçu du produit

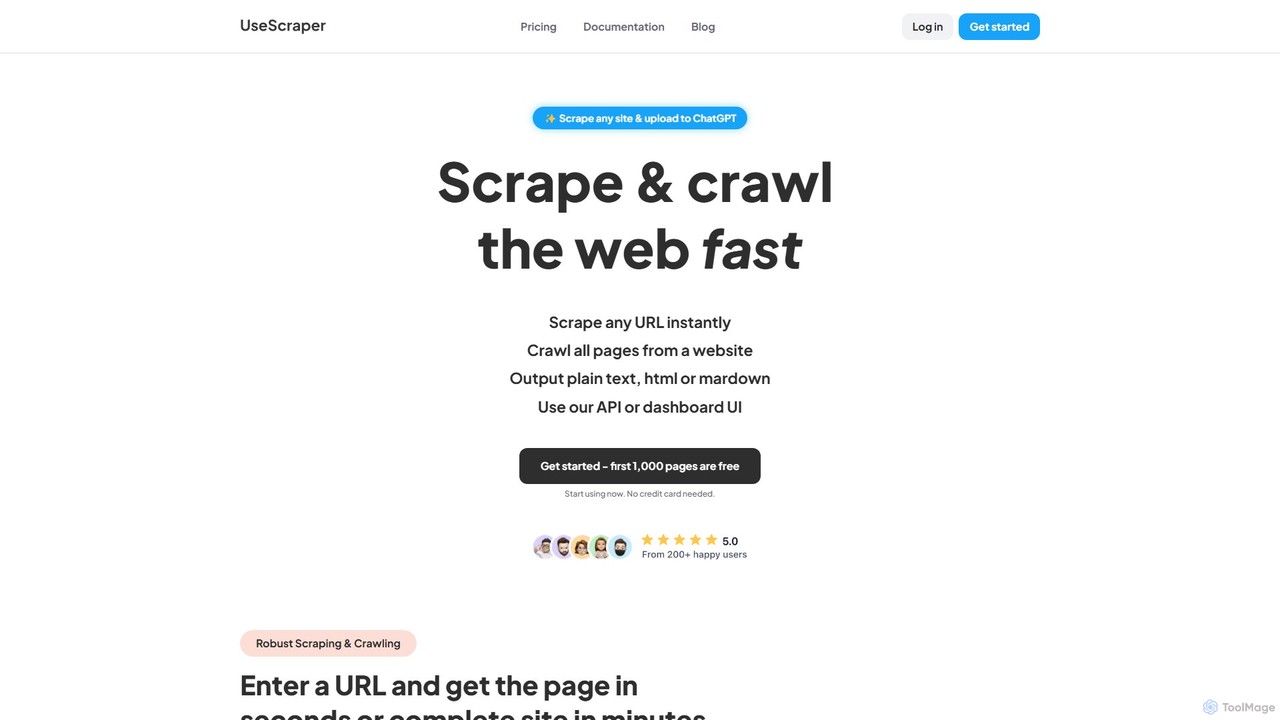
UseScraper Aperçu du produit

UseScraper est une puissante API de crawler et de scraper web conçue pour les développeurs et les applications d'IA. Elle extrait efficacement les données de n'importe quel site web, avec un rendu JavaScript complet, une infrastructure auto-évolutive et des formats de sortie propres comme le Markdown, idéal pour alimenter des LLM comme ChatGPT.

Preview

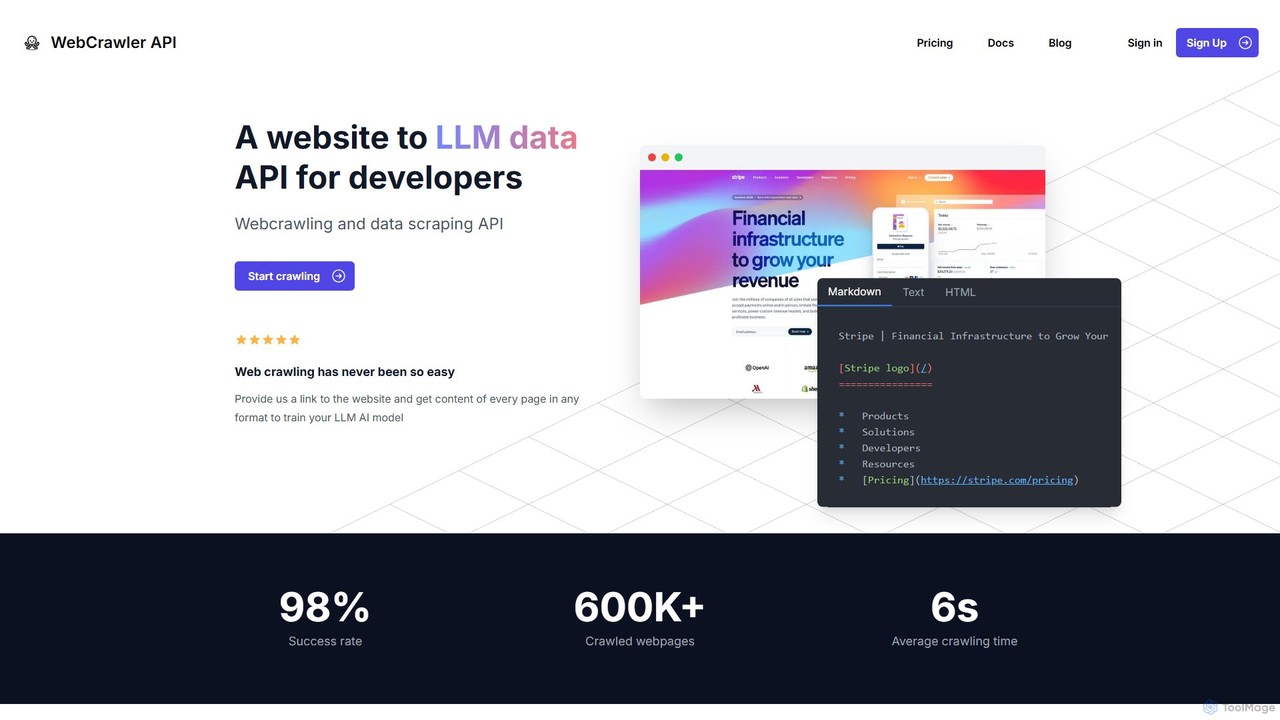
Webcrawlerapi Aperçu du produit

Webcrawlerapi est une API puissante pour les développeurs permettant de crawler sans effort des sites web et d'extraire des données propres. Elle simplifie le web scraping en gérant le rendu JavaScript, les mesures anti-bot et l'analyse des données. Idéale pour collecter du contenu structuré comme du Markdown ou du texte pour entraîner des modèles d'IA LLM ou pour les systèmes de Génération Augmentée par Récupération (RAG), elle offre un taux de réussite élevé et un modèle de tarification simple au paiement à l'usage.

Preview

Données clés

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

UseScraper VS Webcrawlerapi — Données clés
Données clésUseScraperWebcrawlerapi
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusExtraction de DonnéesExtraction de Données
Publics et métiersNon vérifiéNon vérifié
CatégoriesExtraction de Données · API · AutomatisationExtraction de Données · API · Automatisation
Added5 août 20252 août 2025
Mis à jour19 nov. 202619 nov. 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

UseScraper

UseScraper est un service de scraping et de crawling web robuste et évolutif fourni via une API simple mais puissante. Il est conçu dès le départ pour la vitesse et la fiabilité, permettant aux utilisateurs d'extraire des données de n'importe quelle page web en quelques secondes ou de crawler des sites web entiers en quelques minutes. Cet outil est particulièrement précieux pour les développeurs, les data scientists et les entreprises qui ont besoin de collecter des données web pour des études de marché, la génération de leads, la surveillance des prix ou pour entraîner des modèles d'IA.

La plateforme est conçue pour gérer les complexités du web moderne. Elle utilise un véritable navigateur Chrome pour un rendu JavaScript complet, garantissant que le contenu des applications dynamiques à page unique (SPA) est capturé avec précision. Cette capacité le rend supérieur à de nombreux scrapers traditionnels qui ne récupèrent que du HTML statique. La sortie peut être livrée dans plusieurs formats, y compris du HTML brut, du texte brut et, surtout, du Markdown propre et bien structuré, qui est le format idéal pour le traitement par les systèmes d'IA et les grands modèles de langage (LLM).

Comment utiliser UseScraper

L'utilisation de UseScraper est simple pour les développeurs de tous niveaux. Le processus implique quelques étapes simples :

  1. Inscrivez-vous : Créez un compte gratuit pour commencer. Aucune carte de crédit n'est requise, et vous recevez 1 000 scrapes de page gratuits et 25 $ de crédits lors de votre inscription.
  2. Choisissez votre outil : Décidez si vous avez besoin de scraper une seule URL ou de crawler un site web entier. UseScraper propose des API dédiées pour les deux tâches (API Scraper et API Crawler).
  3. Faites une requête API : Utilisez votre langage de programmation préféré (Python, JavaScript, C#, etc.) pour faire une requête au point de terminaison de l'API UseScraper. Il vous suffit de fournir la ou les URL cibles.
  4. Configurez les options : Vous pouvez personnaliser votre requête avec des options avancées, telles que l'exclusion d'URL ou d'éléments CSS spécifiques, la configuration de webhooks pour les notifications et le choix de votre format de sortie souhaité (markdown, text ou html).
  5. Recevez les données : Le contenu scrapé est renvoyé dans la réponse de l'API. Pour les travaux de crawl plus importants, les résultats sont stockés dans un magasin de données dédié, accessible via l'API. Vous pouvez également définir l'expiration automatique des données pour gérer le stockage.

Fonctionnalités principales de UseScraper

  • API Scraper & Crawler : Des API dédiées pour scraper instantanément des pages uniques ou crawler des milliers de pages d'un site web.
  • Rendu JavaScript complet : Utilise un véritable navigateur Chrome pour rendre le JavaScript, garantissant une extraction de données précise à partir de sites web dynamiques et de SPA.
  • Sortie Markdown prête pour l'IA : Fournit une sortie Markdown propre et structurée, parfaite pour une utilisation dans les applications d'IA, les systèmes RAG et pour alimenter les connaissances des LLM comme ChatGPT. Le texte brut et le HTML sont également disponibles.
  • Infrastructure haute vitesse et évolutive : Construite sur une infrastructure auto-évolutive qui permet un scraping et un crawling parallèles ultra-rapides de milliers de pages par minute.
  • Contrôle de crawling avancé : Les fonctionnalités incluent le crawling multi-sites dans une seule tâche, l'exclusion d'URL spécifiques avec des motifs glob, et la suppression de contenu répétitif (comme les en-têtes/pieds de page) à l'aide de sélecteurs CSS.
  • Rotation automatique des proxys : (Bientôt disponible) Fait tourner automatiquement les proxys pour contourner les mesures anti-scraping et éviter la limitation de débit, garantissant des taux de réussite élevés.
  • Notifications par Webhook : Recevez des mises à jour en temps réel sur l'état et l'achèvement de vos travaux de crawl via des webhooks.
  • Magasin de données intégré : Les données scrapées sont enregistrées dans un magasin de données accessible via l'API, avec des options pour définir l'expiration automatique des données.

Cas d'utilisation pour UseScraper

UseScraper est polyvalent et peut être appliqué à un large éventail de tâches d'extraction de données :

  • Entraînement de modèles d'IA : Scrapez de grandes quantités de contenu web pour créer des ensembles de données pour l'entraînement de modèles d'apprentissage automatique ou pour construire une base de connaissances pour la Génération Augmentée par Récupération (RAG) avec des LLM.
  • Analyse du marché et de la concurrence : Agrégez les informations sur les produits, les prix, les avis et les actualités des sites web concurrents pour éclairer la stratégie commerciale.
  • Génération de leads : Extrayez les coordonnées et les informations commerciales des annuaires en ligne et des réseaux professionnels.
  • Agrégation de contenu : Alimentez des portails d'actualités, des sites d'offres d'emploi ou des sites d'annonces immobilières en collectant automatiquement des données de plusieurs sources.
  • SEO et Marketing : Surveillez les classements des moteurs de recherche, suivez les mentions de marque et analysez les profils de backlinks en crawlant les SERP et les sites web.

Avantages de UseScraper

UseScraper se distingue par son accent sur la performance, la compatibilité avec le web moderne et l'expérience des développeurs. Ses principaux avantages incluent sa capacité à gérer sans effort les sites riches en JavaScript, la fourniture d'une sortie Markdown propre et adaptée à l'IA, et son architecture évolutive à haute vitesse. Le modèle de tarification flexible, y compris un généreux niveau gratuit, le rend accessible pour des projets de toutes tailles, des petits scripts aux opérations de données d'entreprise à grande échelle.

Tarification et plans

UseScraper propose une structure de tarification transparente et évolutive :

  • Plan Pay as you go : 0 $/mois. Vous ne payez que ce que vous utilisez à un taux de 1 $ pour 1 000 pages web. Ce plan comprend 10 tâches simultanées, les API Scraper & Crawler, le rendu JavaScript et est parfait pour les petits projets. Les 1 000 premières pages sont gratuites.
  • Plan Pro : 99 $/mois, plus les coûts d'utilisation de 1 $ pour 1 000 pages web. Ce plan est conçu pour les opérations à grande échelle et inclut tout ce qui se trouve dans le plan gratuit, plus des tâches simultanées illimitées, le crawling de pages illimitées par site web, des proxys avancés (bientôt disponibles) et un support prioritaire.

Les nouveaux utilisateurs reçoivent 25 $ de crédits gratuits lors de leur inscription, offrant un point de départ substantiel pour les tests et le développement.

Webcrawlerapi

Webcrawlerapi est une API spécialisée conçue pour rationaliser le processus de crawling web et d'extraction de données pour les développeurs. À une époque où les données sont cruciales pour l'entraînement des grands modèles de langage (LLM) et l'alimentation des applications d'IA, le web scraping traditionnel présente des défis importants. Ceux-ci incluent la gestion du contenu dynamique rendu par JavaScript, le contournement des systèmes anti-bot sophistiqués, la gestion des proxys et le nettoyage du HTML désordonné en formats utilisables. Webcrawlerapi abstrait toutes ces complexités, fournissant une interface simple mais puissante pour transformer n'importe quel site web en une source de données structurée.

Avec un taux de réussite rapporté de 98% et un temps de crawling moyen de seulement 6 secondes, le service est conçu pour l'efficacité et la fiabilité. Il permet aux développeurs de se concentrer sur la logique de leur application principale au lieu de s'enliser dans les subtilités de la construction et de la maintenance d'une infrastructure de crawling évolutive. En fournissant un lien, les développeurs peuvent recevoir du contenu propre et prêt à l'emploi dans des formats comme le Markdown, le texte ou le HTML brut, ce qui le rend parfait pour alimenter les pipelines d'entraînement de modèles d'IA ou les bases de connaissances pour les systèmes RAG.

Comment utiliser Webcrawlerapi

L'intégration de Webcrawlerapi dans votre projet est conçue pour être simple. Le processus ne nécessite généralement que quelques lignes de code. Tout d'abord, vous devez vous inscrire sur le site web de Webcrawlerapi pour obtenir votre clé d'accès API unique. Ensuite, vous pouvez utiliser l'une de leurs bibliothèques clientes fournies pour les langages de programmation populaires.

Par exemple, dans un environnement NodeJS, vous commenceriez par installer la bibliothèque cliente via npm : npm i webcrawlerapi-js. Ensuite, dans votre code, vous importez la bibliothèque, créez une nouvelle instance de client avec votre clé API, et appelez la méthode `crawl`. Cette méthode prend des paramètres tels que l' `url` cible, le `scrape_type` souhaité (par exemple, 'markdown'), et des limites optionnelles comme `items_limit`. L'API gère ensuite l'ensemble du processus de crawling en arrière-plan et renvoie une réponse JSON structurée avec les données extraites. Des modèles d'intégration simples similaires sont disponibles pour Python, PHP et .NET, le rendant accessible à un large éventail de développeurs.

Fonctionnalités principales de Webcrawlerapi

  • Gestion automatisée des liens : L'API découvre et gère intelligemment tous les liens internes d'un site web, assurant un crawling complet tout en gérant automatiquement les doublons et en nettoyant les URL.
  • Rendu JavaScript avancé : Elle rend efficacement le contenu dynamique côté client en utilisant un système stable et robuste, surmontant l'instabilité et les problèmes de mémoire souvent associés à des outils comme Puppeteer ou Playwright.
  • Contournement robuste des anti-bots : Webcrawlerapi est doté de mécanismes intégrés pour faire face aux CAPTCHAs, aux blocages d'IP, aux limites de taux et à d'autres défenses anti-bot courantes, garantissant un taux de réussite élevé.
  • Nettoyage automatique des données : Elle inclut des règles d'analyse puissantes pour convertir le HTML brut et complexe en formats propres et structurés comme le Markdown ou le texte brut, ce qui permet aux développeurs d'économiser un temps de post-traitement considérable.
  • Infrastructure évolutive : Le service gère une infrastructure distribuée de crawlers et de proxys, vous permettant de faire évoluer vos efforts d'extraction de données de quelques pages à des millions sans vous soucier du matériel sous-jacent ou de la gestion du réseau.
  • API et SDK conviviaux pour les développeurs : Offre une API simple et des bibliothèques clientes officielles pour les principaux langages comme NodeJS, Python, PHP et .NET, avec une documentation claire.

Cas d'utilisation pour Webcrawlerapi

Webcrawlerapi est polyvalent et peut être appliqué à une variété de tâches à forte intensité de données. Ses principaux cas d'utilisation tournent autour de l'IA et de l'analyse de données.

  • Collecte de données pour l'entraînement de LLM : Crawler systématiquement des sites web, des blogs et des forums pour recueillir de grandes quantités de données textuelles de haute qualité et spécifiques à un domaine pour l'entraînement ou l'affinage de grands modèles de langage personnalisés.
  • Génération Augmentée par Récupération (RAG) : Construire et maintenir des bases de connaissances à jour pour les systèmes RAG. Crawler la documentation des produits, les centres d'aide ou les sites d'actualités pour fournir aux LLM des informations précises et en temps réel pour répondre aux requêtes des utilisateurs.
  • Étude de marché et analyse concurrentielle : Extraire automatiquement les détails des produits, les informations sur les prix, les avis des clients et le contenu marketing des sites web des concurrents pour obtenir des informations stratégiques.
  • Agrégation de contenu : Alimenter des agrégateurs de nouvelles, des sites d'offres d'emploi ou des sites d'annonces immobilières en crawlant régulièrement plusieurs sources et en consolidant les données sur une plateforme unifiée.

Avantages de Webcrawlerapi

Le principal avantage de Webcrawlerapi est sa simplicité et son efficacité. Il permet aux équipes de développement de déléguer l'ensemble de l'infrastructure de crawling web et de la charge de maintenance. Cela se traduit par un délai de mise sur le marché plus rapide pour les produits basés sur les données. Le taux de réussite élevé (98%) et les fonctionnalités anti-bot robustes garantissent la fiabilité des pipelines de données. De plus, son modèle de tarification transparent au paiement à l'usage est très rentable, car vous ne payez que pour les requêtes réussies, éliminant ainsi le risque et les frais généraux associés aux abonnements ou à la construction d'une solution interne.

Tarification et plans

Webcrawlerapi emploie un modèle de tarification 'paiement à l'usage' simple et transparent, évitant complètement les abonnements et les frais cachés. Les coûts sont calculés en fonction du nombre de pages que vous crawlez avec succès chaque mois. Le service inclut des tâches de crawl illimitées, un réseau de proxy illimité et géré automatiquement, et un support par e-mail dans sa tarification. Pour une estimation claire des coûts, le site web fournit un calculateur. Par exemple, le crawling de 10 000 pages en un mois coûterait environ 20 $. Ce modèle est idéal pour les projets de toutes tailles, des expériences à petite échelle aux opérations de données à grande échelle, car les coûts évoluent directement avec l'utilisation. La plateforme permet également aux utilisateurs d'essayer le service avant d'acheter, probablement via une allocation de crédit gratuite pour les nouveaux comptes.

Positionnement

La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.

Catégories

Commun
Extraction de DonnéesAPIAutomatisation
Uniquement UseScraper
Aucune donnée vérifiée
Uniquement Webcrawlerapi
Aucune donnée vérifiée

Étiquettes

Commun
APIautomatisationCollecte de donnéesExtraction de donnéesRendu JavaScriptGénération Augmentée par Récupération
Uniquement UseScraper
Données IAChatGPTOutils pour développeursMarkdownrobot d'exploration webWeb scraping
Uniquement Webcrawlerapi
Scraping de donnéesoutil de développementEntraînement de LLMExploration web

Publics et métiers

Commun
Aucune donnée vérifiée
Uniquement UseScraper
Aucune donnée vérifiée
Uniquement Webcrawlerapi
Aucune donnée vérifiée

Comparaison du trafic

Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

UseScraper

Non vérifié

Webcrawlerapi monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
5.4K
Durée moyenne
0:46
Pages par visite
1.95
Taux de rebond
41.65%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 5.1K
  • 2026-01: 4.5K
  • 2026-02: 4K
  • 2026-03: 4.3K
  • 2026-04: 5.6K
  • 2026-05: 5.4K

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States49.13%2.7K
🇩🇪Germany20.9%1.1K
🇮🇳India14.85%809
🇻🇳Vietnam12.23%666
🇦🇺Australia2.89%157

Mots-clés

better to save as an html or md file packing more informationdata scraping law casesfirecrawl alternativesllms txt generator onlinesubmit website to chatgpt

Signaux communautaires

Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.

UseScraper

Note
Non vérifié
Commentaires
0
Favoris
188
J’aime
166

Webcrawlerapi

Note
Non vérifié
Commentaires
0
Favoris
182
J’aime
179

UseScraper vs Webcrawlerapi · FAQ comparative

What do UseScraper and Webcrawlerapi have in common?
Both tools are listed under Extraction de Données、API、Automatisation. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are UseScraper and Webcrawlerapi free?
Listed pricing models: UseScraper — Freemium; Webcrawlerapi — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between UseScraper and Webcrawlerapi?
The primary listed category is Extraction de Données for UseScraper, and Extraction de Données for Webcrawlerapi. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparatifs associés