

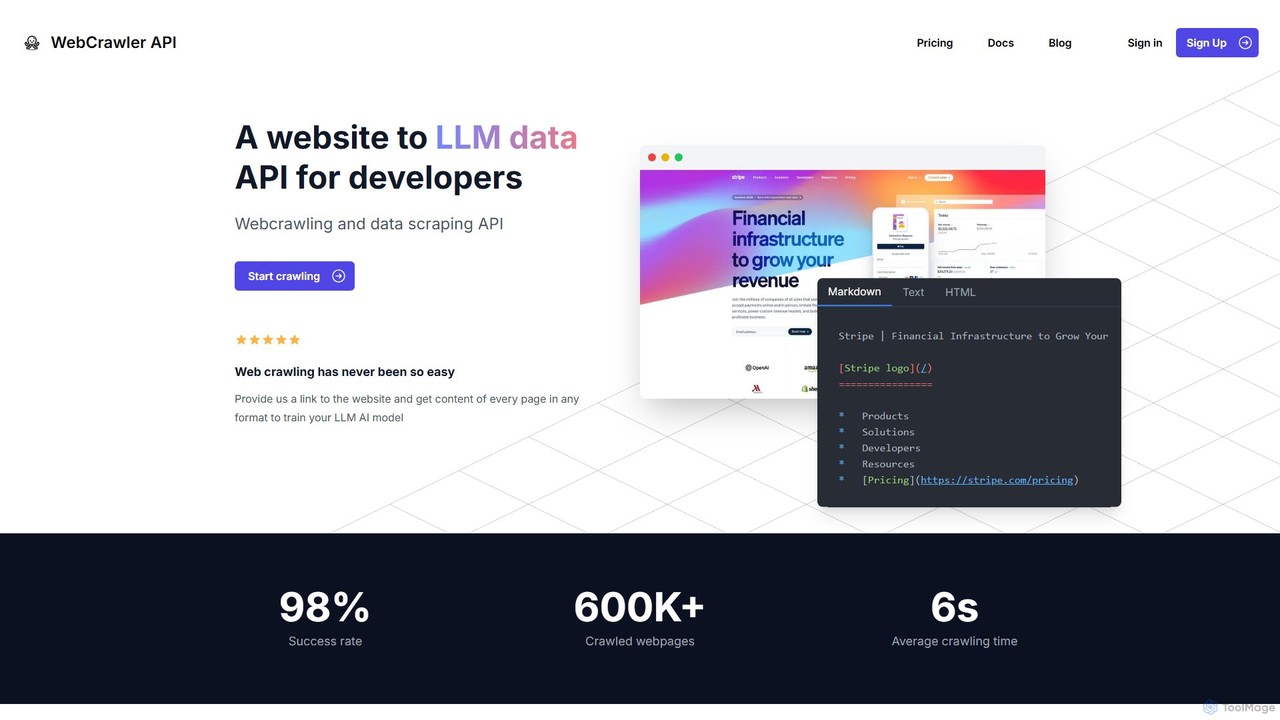
Webcrawlerapi Overview
Webcrawlerapi est une API spécialisée conçue pour rationaliser le processus de crawling web et d'extraction de données pour les développeurs. À une époque où les données sont cruciales pour l'entraînement des grands modèles de langage (LLM) et l'alimentation des applications d'IA, le web scraping traditionnel présente des défis importants. Ceux-ci incluent la gestion du contenu dynamique rendu par JavaScript, le contournement des systèmes anti-bot sophistiqués, la gestion des proxys et le nettoyage du HTML désordonné en formats utilisables. Webcrawlerapi abstrait toutes ces complexités, fournissant une interface simple mais puissante pour transformer n'importe quel site web en une source de données structurée.
Avec un taux de réussite rapporté de 98% et un temps de crawling moyen de seulement 6 secondes, le service est conçu pour l'efficacité et la fiabilité. Il permet aux développeurs de se concentrer sur la logique de leur application principale au lieu de s'enliser dans les subtilités de la construction et de la maintenance d'une infrastructure de crawling évolutive. En fournissant un lien, les développeurs peuvent recevoir du contenu propre et prêt à l'emploi dans des formats comme le Markdown, le texte ou le HTML brut, ce qui le rend parfait pour alimenter les pipelines d'entraînement de modèles d'IA ou les bases de connaissances pour les systèmes RAG.
Comment utiliser Webcrawlerapi
L'intégration de Webcrawlerapi dans votre projet est conçue pour être simple. Le processus ne nécessite généralement que quelques lignes de code. Tout d'abord, vous devez vous inscrire sur le site web de Webcrawlerapi pour obtenir votre clé d'accès API unique. Ensuite, vous pouvez utiliser l'une de leurs bibliothèques clientes fournies pour les langages de programmation populaires.
Par exemple, dans un environnement NodeJS, vous commenceriez par installer la bibliothèque cliente via npm : npm i webcrawlerapi-js. Ensuite, dans votre code, vous importez la bibliothèque, créez une nouvelle instance de client avec votre clé API, et appelez la méthode `crawl`. Cette méthode prend des paramètres tels que l' `url` cible, le `scrape_type` souhaité (par exemple, 'markdown'), et des limites optionnelles comme `items_limit`. L'API gère ensuite l'ensemble du processus de crawling en arrière-plan et renvoie une réponse JSON structurée avec les données extraites. Des modèles d'intégration simples similaires sont disponibles pour Python, PHP et .NET, le rendant accessible à un large éventail de développeurs.
Fonctionnalités principales de Webcrawlerapi
- Gestion automatisée des liens : L'API découvre et gère intelligemment tous les liens internes d'un site web, assurant un crawling complet tout en gérant automatiquement les doublons et en nettoyant les URL.
- Rendu JavaScript avancé : Elle rend efficacement le contenu dynamique côté client en utilisant un système stable et robuste, surmontant l'instabilité et les problèmes de mémoire souvent associés à des outils comme Puppeteer ou Playwright.
- Contournement robuste des anti-bots : Webcrawlerapi est doté de mécanismes intégrés pour faire face aux CAPTCHAs, aux blocages d'IP, aux limites de taux et à d'autres défenses anti-bot courantes, garantissant un taux de réussite élevé.
- Nettoyage automatique des données : Elle inclut des règles d'analyse puissantes pour convertir le HTML brut et complexe en formats propres et structurés comme le Markdown ou le texte brut, ce qui permet aux développeurs d'économiser un temps de post-traitement considérable.
- Infrastructure évolutive : Le service gère une infrastructure distribuée de crawlers et de proxys, vous permettant de faire évoluer vos efforts d'extraction de données de quelques pages à des millions sans vous soucier du matériel sous-jacent ou de la gestion du réseau.
- API et SDK conviviaux pour les développeurs : Offre une API simple et des bibliothèques clientes officielles pour les principaux langages comme NodeJS, Python, PHP et .NET, avec une documentation claire.
Cas d'utilisation pour Webcrawlerapi
Webcrawlerapi est polyvalent et peut être appliqué à une variété de tâches à forte intensité de données. Ses principaux cas d'utilisation tournent autour de l'IA et de l'analyse de données.
- Collecte de données pour l'entraînement de LLM : Crawler systématiquement des sites web, des blogs et des forums pour recueillir de grandes quantités de données textuelles de haute qualité et spécifiques à un domaine pour l'entraînement ou l'affinage de grands modèles de langage personnalisés.
- Génération Augmentée par Récupération (RAG) : Construire et maintenir des bases de connaissances à jour pour les systèmes RAG. Crawler la documentation des produits, les centres d'aide ou les sites d'actualités pour fournir aux LLM des informations précises et en temps réel pour répondre aux requêtes des utilisateurs.
- Étude de marché et analyse concurrentielle : Extraire automatiquement les détails des produits, les informations sur les prix, les avis des clients et le contenu marketing des sites web des concurrents pour obtenir des informations stratégiques.
- Agrégation de contenu : Alimenter des agrégateurs de nouvelles, des sites d'offres d'emploi ou des sites d'annonces immobilières en crawlant régulièrement plusieurs sources et en consolidant les données sur une plateforme unifiée.
Avantages de Webcrawlerapi
Le principal avantage de Webcrawlerapi est sa simplicité et son efficacité. Il permet aux équipes de développement de déléguer l'ensemble de l'infrastructure de crawling web et de la charge de maintenance. Cela se traduit par un délai de mise sur le marché plus rapide pour les produits basés sur les données. Le taux de réussite élevé (98%) et les fonctionnalités anti-bot robustes garantissent la fiabilité des pipelines de données. De plus, son modèle de tarification transparent au paiement à l'usage est très rentable, car vous ne payez que pour les requêtes réussies, éliminant ainsi le risque et les frais généraux associés aux abonnements ou à la construction d'une solution interne.
Tarification et plans
Webcrawlerapi emploie un modèle de tarification 'paiement à l'usage' simple et transparent, évitant complètement les abonnements et les frais cachés. Les coûts sont calculés en fonction du nombre de pages que vous crawlez avec succès chaque mois. Le service inclut des tâches de crawl illimitées, un réseau de proxy illimité et géré automatiquement, et un support par e-mail dans sa tarification. Pour une estimation claire des coûts, le site web fournit un calculateur. Par exemple, le crawling de 10 000 pages en un mois coûterait environ 20 $. Ce modèle est idéal pour les projets de toutes tailles, des expériences à petite échelle aux opérations de données à grande échelle, car les coûts évoluent directement avec l'utilisation. La plateforme permet également aux utilisateurs d'essayer le service avant d'acheter, probablement via une allocation de crédit gratuite pour les nouveaux comptes.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 5.1K
- 2026-1: 4.5K
- 2026-2: 4.0K
- 2026-3: 4.3K
- 2026-4: 5.6K
- 2026-5: 5.4K
Geography
Top 5 countries / regions
- 🇺🇸États-Unis49.1%
- 🇩🇪Allemagne20.9%
- 🇮🇳Inde14.8%
- 🇻🇳Viêt Nam12.2%
- 🇦🇺Australie2.9%
Top keywords
| Keyword | Cost per click |
|---|---|
| better to save as an html or md file packing more information | $0.00 |
| data scraping law cases | $0.00 |
| firecrawl alternatives | $11.71 |
| llms txt generator online | $0.00 |
| submit website to chatgpt | $0.00 |
Webcrawlerapi Alternatives
UseScraper
UseScraper est une puissante API de crawler et de scraper web conçue pour les développeurs et les applications d'IA. Elle extrait efficacement les données de n'importe quel site web, avec un rendu JavaScript complet, une infrastructure auto-évolutive et des formats de sortie propres comme le Markdown, idéal pour alimenter des LLM comme ChatGPT.
Extraction de Données
Foxscrape
FoxScrape est une API REST de web scraping alimentée par l'IA pour les développeurs. Elle simplifie l'extraction de données en convertissant n'importe quel site web en données JSON structurées à l'aide de fonctionnalités telles que l'analyse pilotée par l'IA à partir de l'anglais simple, le rendu JavaScript pour les sites dynamiques et la rotation automatique de proxy pour éviter les blocages.
Extraction de Données
instantapi
instantapi est une API de web scraping alimentée par l'IA, conçue pour la simplicité et la vitesse. Elle permet aux utilisateurs d'extraire des données structurées de n'importe quel site web avec un seul appel API, éliminant le besoin de codage complexe ou de configuration manuelle. Idéal pour les développeurs, les analystes de données et les entreprises qui ont besoin d'une extraction de données rapide, abordable et fiable sans les tracas des scrapers web traditionnels.
Extraction de Données
Skrape
Skrape est une API de web scraping alimentée par LLM, conçue pour transformer n'importe quel site web en données propres, structurées et prêtes pour les LLM. Elle simplifie l'extraction de données en convertissant les pages web en JSON structuré ou en markdown propre, ce qui la rend idéale pour l'entraînement d'IA, les systèmes RAG et l'analyse de données. Avec des fonctionnalités telles que la gestion de contenu dynamique et le crawling intelligent, Skrape offre une solution fiable pour les développeurs et les entreprises afin d'automatiser leurs pipelines de collecte de données.
Scraping
Isomeric
Isomeric est une API alimentée par l'IA qui transforme le texte désordonné et non structuré de n'importe quelle source en données JSON propres et structurées. En définissant un schéma JSON simple, vous pouvez extraire automatiquement des informations spécifiques de sites web, de documents juridiques, de transcriptions de support client, et plus encore, optimisant ainsi les pipelines de données et l'automatisation.
Extraction de DonnéesWebcrawlerapi Categories
Webcrawlerapi Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
UseScraper
UseScraper est une puissante API de crawler et de scraper web conçue pour les développeurs et les applications d'IA. Elle extrait efficacement les données de n'importe quel site web, avec un rendu JavaScript complet, une infrastructure auto-évolutive et des formats de sortie propres comme le Markdown, idéal pour alimenter des LLM comme ChatGPT.
Extraction de DonnéesSkrape
Skrape est une API de web scraping alimentée par LLM, conçue pour transformer n'importe quel site web en données propres, structurées et prêtes pour les LLM. Elle simplifie l'extraction de données en convertissant les pages web en JSON structuré ou en markdown propre, ce qui la rend idéale pour l'entraînement d'IA, les systèmes RAG et l'analyse de données. Avec des fonctionnalités telles que la gestion de contenu dynamique et le crawling intelligent, Skrape offre une solution fiable pour les développeurs et les entreprises afin d'automatiser leurs pipelines de collecte de données.
ScrapingFoxscrape
FoxScrape est une API REST de web scraping alimentée par l'IA pour les développeurs. Elle simplifie l'extraction de données en convertissant n'importe quel site web en données JSON structurées à l'aide de fonctionnalités telles que l'analyse pilotée par l'IA à partir de l'anglais simple, le rendu JavaScript pour les sites dynamiques et la rotation automatique de proxy pour éviter les blocages.
Extraction de Données
Scrapeless
Une boîte à outils de web scraping alimentée par l'IA pour les développeurs et les entreprises. Elle offre une suite d'outils comprenant un navigateur de scraping, une API de scraping universelle et une API Deep SERP pour extraire sans effort des données web publiques à grande échelle. Elle est spécialisée dans le contournement des mesures anti-bot, fournissant des données structurées pour le e-commerce, les études de marché et la formation de modèles d'IA, avec un accent sur la fiabilité et la facilité d'utilisation.
Scraping
URLtoText
URLtoText est un outil alimenté par l'IA qui extrait du texte propre et structuré de n'importe quel site web ou PDF. Il supprime intelligemment les publicités, les barres latérales et autres encombrements pour ne fournir que le contenu principal. Doté du rendu JavaScript, de proxys IP résidentiels et d'une API pour développeurs, il est conçu pour les chercheurs, les développeurs et les entreprises ayant besoin d'une extraction de données fiable à partir de pages web statiques et dynamiques.
Curation de Contenu
Apify
Apify est une plateforme full-stack de web scraping et d'automatisation qui permet aux développeurs de créer, déployer et publier des outils d'extraction de données, appelés 'Actors'. Elle offre une vaste place de marché de scrapers pré-construits pour des sites populaires comme Google Maps, Instagram et TikTok, ainsi qu'une infrastructure cloud robuste pour créer des solutions personnalisées. Avec le support de Python et JavaScript, de bibliothèques open-source et d'intégrations transparentes, Apify simplifie la collecte de données web à toute échelle.
Collecte de Données
CapSolver
CapSolver est un service de résolution automatique de CAPTCHA alimenté par l'IA, conçu pour les développeurs et les professionnels de la RPA. Il fournit une solution de haute précision, rapide et évolutive pour contourner divers types de CAPTCHAs, y compris reCAPTCHA, hCaptcha et FunCaptcha, facilitant ainsi le web scraping, l'extraction de données et l'automatisation des processus en toute fluidité.
Extraction de Données
Jyek
Jyek est une plateforme d'agent IA qui comprend les objectifs, crée des plans d'exécution, utilise des outils et fournit des résultats vérifiables pour les tâches complexes à étapes multiples.
Automatisation
WebScraping.AI
WebScraping.AI est une API avancée pour les développeurs qui simplifie le web scraping grâce à l'IA. Elle propose des proxys rotatifs, le rendu JavaScript et le géociblage pour contourner les blocages et accéder au contenu dynamique. Sa force principale réside dans ses outils alimentés par LLM, capables d'extraire des données non structurées, de générer des résumés et de répondre à des questions directement depuis les pages web, optimisant ainsi la collecte de données pour tout projet.
Extraction de Données
AgentQL
AgentQL est un ensemble d'outils pour développeurs qui connecte les LLM et les agents IA au web. Il utilise un langage de requête alimenté par l'IA pour extraire de manière robuste des données structurées et automatiser les interactions web, servant d'alternative puissante et auto-réparatrice aux sélecteurs XPath et CSS fragiles.
LLM
Crawleo
Une puissante API deux-en-un pour les systèmes d'IA, offrant une recherche web en temps réel et un crawling approfondi. Elle fournit des données structurées et prêtes pour l'IA (JSON, Markdown) depuis n'importe quel site web, en contournant les mesures anti-bot et en garantissant la confidentialité avec une politique stricte de non-conservation des données. Conçue pour les pipelines RAG, les LLM et les flux d'automatisation.
Récupération de données
Jsonify
Jsonify est une plateforme alimentée par l'IA conçue pour que les entreprises trouvent, extraient et structurent automatiquement des données à partir de divers documents et sources web dans un format JSON propre. Elle rationalise les flux de travail de traitement des données, élimine la saisie manuelle et permet une intégration transparente via sa robuste API.
Analyse de données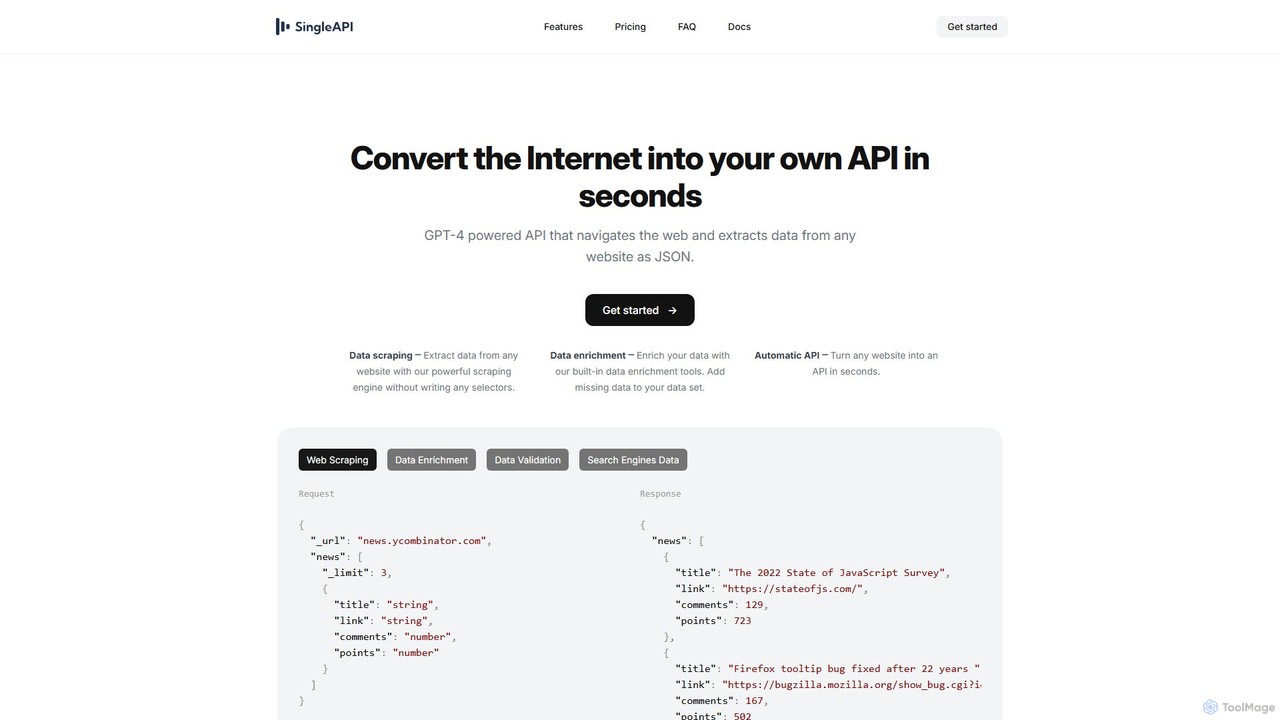
SingleAPI
SingleAPI est un outil alimenté par GPT-4 qui convertit instantanément n'importe quel site web en une API JSON structurée. Il simplifie le web scraping, l'extraction de données et l'enrichissement de données sans écrire de code ou de sélecteurs, permettant aux utilisateurs d'accéder sans effort aux données web pour diverses applications.
Web scraping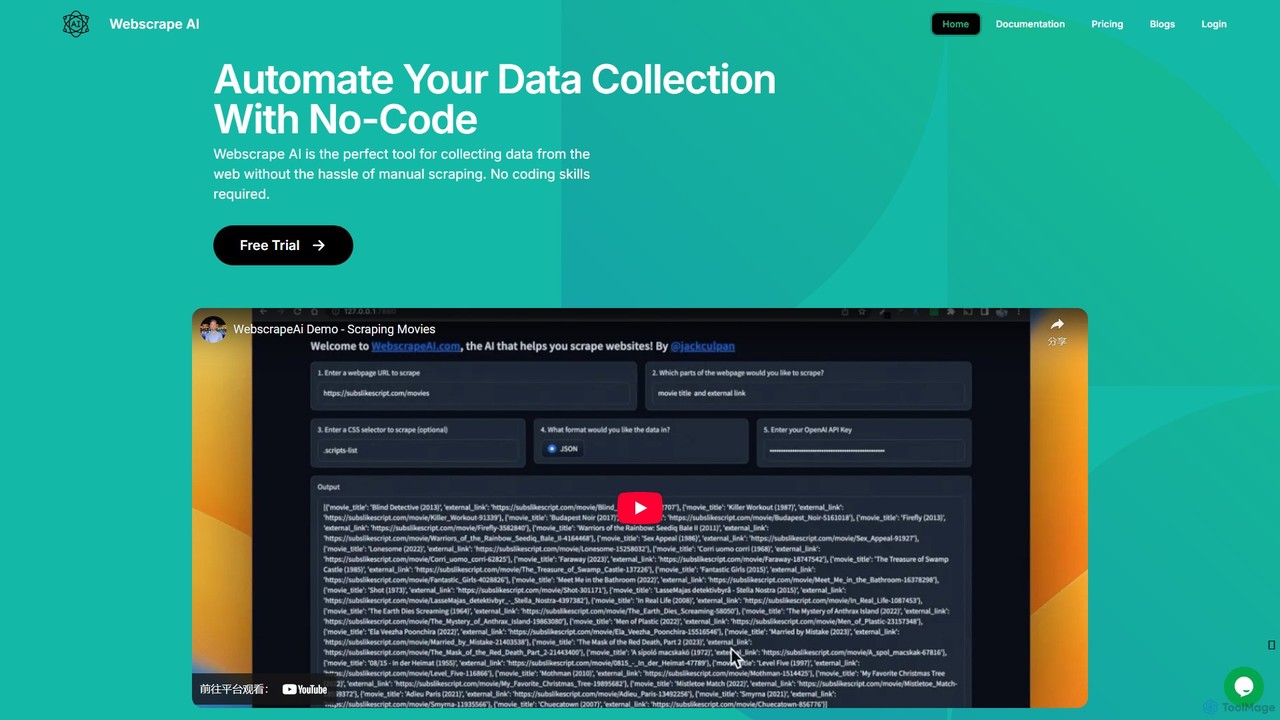
webscrapeai
WebscrapeAI est une plateforme sans code, alimentée par l'IA, conçue pour automatiser la collecte de données web. Fournissez simplement une URL et spécifiez les données dont vous avez besoin, et l'IA gère l'ensemble du processus de scraping. Il prend en charge les sites web dynamiques, le scraping en masse, l'intégration de proxy et offre une API pour les développeurs, rendant l'extraction de données rapide, précise et accessible à tous.
Web scraping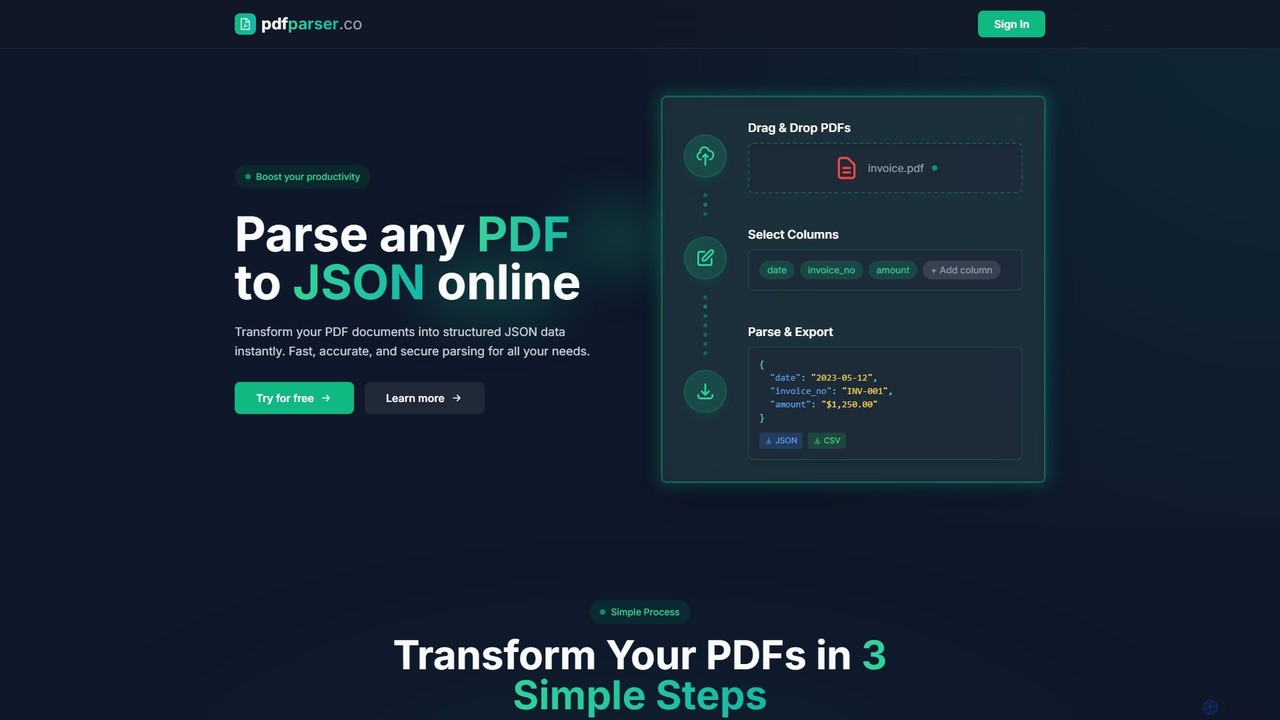
pdfparser
Un service API alimenté par l'IA, conçu pour les développeurs et les entreprises, pour analyser sans effort les documents PDF. Il extrait le texte, les tableaux et les données structurées de n'importe quel PDF, y compris les fichiers numérisés, et renvoie une sortie JSON propre et lisible par machine, automatisant les flux de travail d'extraction de données.
Automatisation
Webcrawlerapi Comments (0)
Sign in to comment.
ConnexionNo comments yet.