
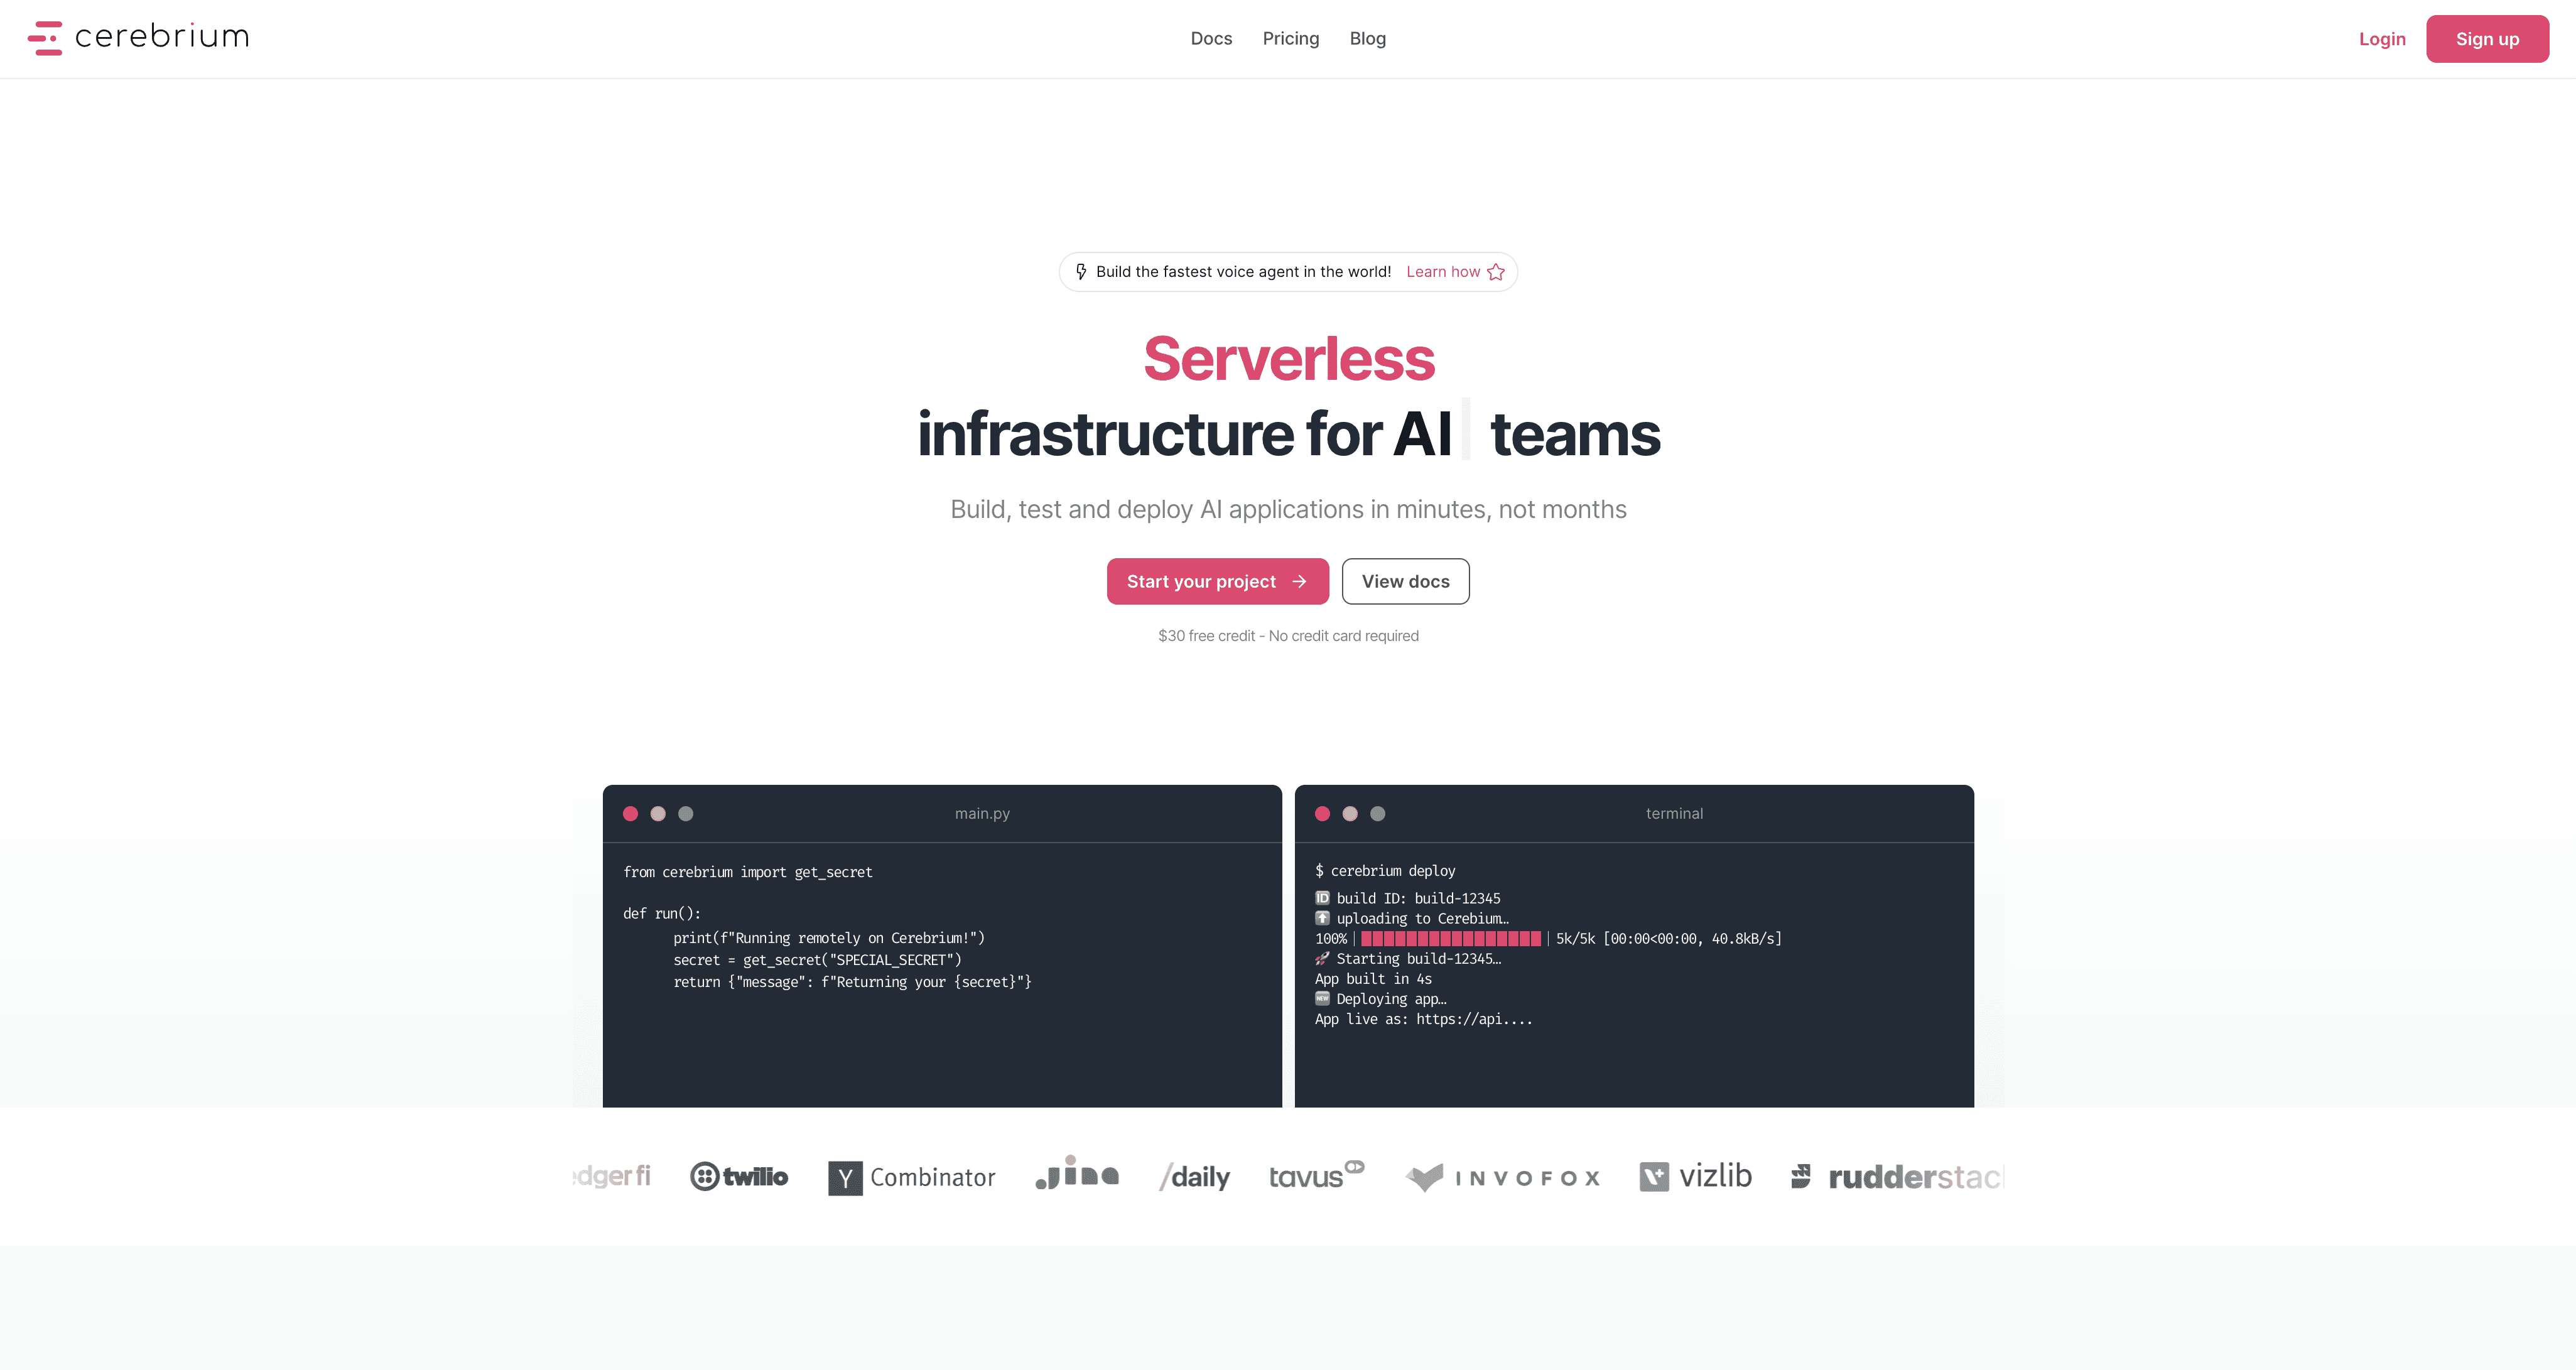
Cerebrium Overview
Cerebrium est une plateforme d'infrastructure IA sans serveur de pointe, méticuleusement conçue pour permettre aux développeurs et aux entreprises de déployer, gérer et mettre à l'échelle des applications IA haute performance. Elle simplifie fondamentalement le flux de travail de développement en abstrayant les complexités de la gestion de l'infrastructure, telles que l'approvisionnement des serveurs, la configuration et l'orchestration. Cela permet aux équipes de se concentrer entièrement sur la création de produits IA innovants, des robots vocaux en temps réel et de l'IA générative aux tâches de traitement par lots à grande échelle.
Fondée avec la vision de réinventer l'infrastructure IA, Cerebrium fournit un environnement robuste, fiable et évolutif, auquel font confiance les startups comme les grandes entreprises. La plateforme est optimisée pour la vitesse, la performance et la rentabilité, garantissant que les modèles d'IA peuvent être déployés à l'échelle mondiale avec une faible latence et une haute disponibilité.
Comment utiliser Cerebrium
Démarrer avec Cerebrium est conçu pour être un processus simple et rapide, permettant aux développeurs de passer du code à un point de terminaison d'API évolutif en quelques minutes :
- Initialiser le projet : Commencez par utiliser la CLI ou le tableau de bord de Cerebrium pour initialiser un nouveau projet. Cela met en place la configuration de base de votre application.
- Sélectionner le matériel : Choisissez le matériel optimal pour votre charge de travail. Cerebrium offre une large sélection de plus de 12 types de GPU, y compris NVIDIA T4, A10, A100, H100, ainsi que des CPU, vous assurant d'avoir la puissance de calcul adéquate pour n'importe quelle tâche.
- Configurer et déployer : Configurez les paramètres de votre application sans avoir besoin d'une syntaxe spéciale. Vous pouvez utiliser des Dockerfiles personnalisés pour un contrôle total de l'environnement. Une seule commande (`cerebrium deploy`) pousse votre code et le déploie en tant que fonction sans serveur.
- Mettre à l'échelle et surveiller : Une fois déployée, votre application s'adapte automatiquement de zéro à des milliers de requêtes en fonction de la demande. Vous pouvez surveiller les performances, consulter les journaux et suivre les métriques de bout en bout grâce aux outils d'observabilité intégrés et au support d'OpenTelemetry.
Fonctionnalités principales de Cerebrium
- Auto-scaling sans serveur : Met à l'échelle automatiquement les applications de zéro à des milliers de conteneurs et inversement, garantissant que vous ne payez que pour le calcul que vous utilisez.
- Démarrages à froid rapides : Les applications sur Cerebrium ont un temps de démarrage à froid moyen de 2 secondes ou moins, ce qui est crucial pour les applications en temps réel destinées aux utilisateurs.
- Support GPU étendu : Accès à plus de 12 types de GPU différents (T4, A10, A100, H100, H200, etc.) pour répondre à des exigences spécifiques de performance et de coût.
- Déploiements multi-régions : Déployez des applications à l'échelle mondiale dans plusieurs régions pour réduire la latence pour les utilisateurs et garantir la résidence des données et la conformité.
- Support d'endpoints avancés : Support natif des API REST, des endpoints WebSocket pour les interactions en temps réel, et des endpoints de Streaming pour les modèles d'IA générative.
- Gestion efficace de la charge de travail : Fonctionnalités telles que le traitement par lots des requêtes pour maximiser le débit du GPU, les contrôles de concurrence et les tâches asynchrones pour les travaux en arrière-plan comme l'entraînement de modèles.
- Flux de travail convivial pour les développeurs : Intégration transparente avec les pipelines CI/CD, déploiements progressifs pour des mises à jour sans interruption de service, et gestion sécurisée des secrets.
- Sécurité et conformité : La plateforme est conforme aux normes SOC 2 et HIPAA, avec une garantie de disponibilité de 99,999 %, assurant la sécurité des données et la fiabilité des services.
Cas d'utilisation pour Cerebrium
Cerebrium est suffisamment polyvalent pour alimenter un large éventail d'applications IA, comme le démontrent ses études de cas réussies :
- Grands modèles de langage (LLM) : Déploiement et mise à l'échelle d'applications d'IA générative, telles que les chatbots, les outils de création de contenu et les assistants de codage.
- IA vocale en temps réel : Création d'agents vocaux IA à très faible latence et de services de transcription en temps réel, comme on le voit avec des entreprises comme Vapi.
- Avatars numériques et assistants virtuels : Alimentation d'avatars et d'assistants numériques semblables à des humains qui nécessitent une inférence et une interaction en temps réel, comme ceux utilisés par Tavus et bitHuman.
- Traitement d'images et de vidéos : Exécution de pipelines d'inférence à grande échelle pour la reconnaissance d'images, l'analyse vidéo et la génération de contenu.
- Traitement par lots et entraînement de modèles : Exécution de grandes tâches asynchrones pour l'ajustement fin de modèles ou le traitement efficace de jeux de données massifs.
Avantages de Cerebrium
Cerebrium offre un avantage concurrentiel significatif pour les équipes qui développent avec l'IA :
- Simplicité radicale : Élimine le besoin d'une équipe MLOps ou d'infrastructure dédiée, permettant aux développeurs de déployer des modèles de manière indépendante.
- Rentabilité : Le modèle de tarification à la seconde pour le calcul signifie qu'aucun coût n'est engagé pour les ressources inactives, ce qui entraîne des économies significatives.
- Haute performance : Optimisé pour une faible latence et un débit élevé, ce qui le rend idéal pour les services IA exigeants et en temps réel.
- Évolutivité à la demande : Gère sans effort les pics de trafic imprévisibles sans intervention manuelle.
- Flexibilité et contrôle : Prend en charge les environnements personnalisés via Docker, donnant aux développeurs un contrôle total sur leur pile applicative.
Tarification et plans
La tarification de Cerebrium est transparente et basée sur un modèle de paiement à l'usage pour les ressources de calcul, complété par des plans mensuels pour des fonctionnalités et un support supplémentaires.
- Plan Hobby : 0 $/mois + coûts de calcul. Idéal pour les développeurs et les petits projets, il comprend 3 sièges d'utilisateur, jusqu'à 3 applications déployées et un support communautaire.
- Plan Standard : 100 $/mois + coûts de calcul. Conçu pour les applications en production, ce plan offre 10 sièges d'utilisateur, 10 applications déployées, 30 GPU simultanés et une rétention des journaux de 30 jours.
- Plan Enterprise : Tarification personnalisée. Pour les grandes équipes et les entreprises nécessitant une mise à l'échelle illimitée, un support dédié, une rétention des journaux illimitée et des fonctionnalités de conformité avancées.
Les coûts de calcul sont facturés à la seconde et varient en fonction du matériel (par exemple, T4 à 0,000164 $/s, A100 80 Go à 0,000694 $/s). La mémoire et le stockage sont également facturés en fonction de l'utilisation, les 100 premiers Go de stockage étant gratuits.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 31.5K
- 2026-1: 35.9K
- 2026-2: 25.5K
- 2026-3: 32.1K
- 2026-4: 53.9K
- 2026-5: 42.3K
Geography
Top 5 countries / regions
- 🇺🇸États-Unis86.8%
- 🇳🇬Nigeria5.2%
- 🇻🇳Viêt Nam4.6%
- 🇮🇳Inde1.9%
- 🇧🇷Brésil1.6%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 97.3% |
Referral | 2.1% |
Email | 0.5% |
Top keywords
| Keyword | Cost per click |
|---|---|
| cerebrium | $6.12 |
| cerebrium ai | $0.00 |
| cerebrium careers | $0.00 |
| confidential gpus serverless | $0.00 |
| ultravox-glm-4p7 latency | $0.00 |
Cerebrium Alternatives

Runpod
Runpod est une plateforme cloud conçue pour l'IA et l'apprentissage automatique, offrant une puissance de calcul GPU évolutive pour le déploiement, l'entraînement et l'exécution de modèles d'IA. Elle fournit des GPU sans serveur, des modèles préconfigurés et une tarification rentable pour simplifier l'ensemble du flux de travail de développement de l'IA, de l'idée à la production.
Apprentissage automatique
Replicate
Replicate est une plateforme cloud pour les développeurs permettant d'exécuter, d'affiner et de déployer des modèles d'IA via une API simple. Elle élimine le besoin de gérer une infrastructure complexe, offrant un accès à des milliers de modèles avec une tarification à l'usage et une mise à l'échelle automatique.
Apprentissage automatique
Baseten
Baseten est une plateforme d'inférence de qualité production pour déployer, mettre à l'échelle et gérer des modèles d'IA. Elle offre des runtimes haute performance, des flux de travail de développeur fluides et des options de déploiement flexibles (cloud, auto-hébergé, hybride). Idéal pour les équipes d'ingénierie et de ML qui construisent des applications d'IA critiques.
Déploiement
ai-rnd.com
Une plateforme intégrée pour la recherche et le développement en IA, offrant un espace de travail unifié, des modèles pré-entraînés et un déploiement en un clic pour accélérer l'ensemble du cycle de vie de l'IA. Idéal pour les développeurs, les chercheurs et les entreprises.
Gestion des Données
LangDrive
LangDrive est une plateforme centrée sur les développeurs offrant une API unifiée pour affiner, gérer et déployer des grands modèles de langage (LLM) open source. Elle simplifie le pipeline complexe de MLOps, permettant aux entreprises de créer de puissants modèles d'IA personnalisés pour des tâches spécialisées avec un meilleur contrôle des données et des coûts.
Gestion des APICerebrium Categories
Cerebrium Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Modal
Modal est une plateforme d'infrastructure sans serveur haute performance pour les développeurs IA et ML. Elle vous permet d'exécuter des fonctions Python dans le cloud avec une seule ligne de code, offrant un accès instantané aux GPU, une mise à l'échelle automatique de zéro à des milliers de conteneurs et une tarification à la seconde. Éliminez la surcharge d'infrastructure et concentrez-vous sur la création et le déploiement d'applications gourmandes en calcul comme l'IA générative, le traitement par lots et l'analyse de données.
Déploiement de modèle
Beam
Beam est une plateforme cloud sans serveur conçue pour les développeurs afin d'exécuter, de mettre à l'échelle et de déployer facilement des modèles et des applications d'IA/ML sur des GPU. Elle offre une mise à l'échelle automatique instantanée, une facturation à la seconde et un flux de travail simplifié, vous permettant de passer du code à une API évolutive en quelques minutes sans gérer une infrastructure complexe.
Apprentissage automatique
Inferless
Inferless est une plateforme GPU sans serveur conçue pour les développeurs afin de déployer des modèles d'apprentissage automatique en quelques minutes. Elle élimine la gestion de l'infrastructure, offrant une mise à l'échelle automatique à partir de zéro pour gérer les charges de travail fluctuantes. La plateforme est optimisée pour des démarrages à froid ultra-rapides et une rentabilité, permettant aux utilisateurs d'économiser jusqu'à 90 % sur les factures de GPU en ne payant que ce qu'ils utilisent.
Déploiement de l'Apprentissage AutomatiqueRunpod
Runpod est une plateforme cloud conçue pour l'IA et l'apprentissage automatique, offrant une puissance de calcul GPU évolutive pour le déploiement, l'entraînement et l'exécution de modèles d'IA. Elle fournit des GPU sans serveur, des modèles préconfigurés et une tarification rentable pour simplifier l'ensemble du flux de travail de développement de l'IA, de l'idée à la production.
Apprentissage automatiqueReplicate
Replicate est une plateforme cloud pour les développeurs permettant d'exécuter, d'affiner et de déployer des modèles d'IA via une API simple. Elle élimine le besoin de gérer une infrastructure complexe, offrant un accès à des milliers de modèles avec une tarification à l'usage et une mise à l'échelle automatique.
Apprentissage automatiqueBaseten
Baseten est une plateforme d'inférence de qualité production pour déployer, mettre à l'échelle et gérer des modèles d'IA. Elle offre des runtimes haute performance, des flux de travail de développeur fluides et des options de déploiement flexibles (cloud, auto-hébergé, hybride). Idéal pour les équipes d'ingénierie et de ML qui construisent des applications d'IA critiques.
Déploiementai-rnd.com
Une plateforme intégrée pour la recherche et le développement en IA, offrant un espace de travail unifié, des modèles pré-entraînés et un déploiement en un clic pour accélérer l'ensemble du cycle de vie de l'IA. Idéal pour les développeurs, les chercheurs et les entreprises.
Gestion des DonnéesLangDrive
LangDrive est une plateforme centrée sur les développeurs offrant une API unifiée pour affiner, gérer et déployer des grands modèles de langage (LLM) open source. Elle simplifie le pipeline complexe de MLOps, permettant aux entreprises de créer de puissants modèles d'IA personnalisés pour des tâches spécialisées avec un meilleur contrôle des données et des coûts.
Gestion des API
Jyek
Jyek est une plateforme d'agent IA qui comprend les objectifs, crée des plans d'exécution, utilise des outils et fournit des résultats vérifiables pour les tâches complexes à étapes multiples.
Automatisation
OctoAI
OctoAI est une plateforme de calcul haute performance permettant aux développeurs d'exécuter, d'ajuster et de mettre à l'échelle des modèles d'IA générative de manière efficace. Elle propose des points de terminaison d'API optimisés et prêts pour la production pour des modèles open-source populaires comme Llama, Mixtral et Stable Diffusion. En se concentrant sur des optimisations système approfondies, OctoAI offre des vitesses d'inférence plus rapides et des coûts réduits, permettant aux entreprises de créer et de déployer des applications d'IA évolutives sans gérer d'infrastructure complexe.
API
novita.ai
Novita AI est une plateforme cloud axée sur les développeurs, offrant un accès abordable et évolutif à plus de 200 modèles d'IA via des API simples. Elle fournit des GPU sans serveur, des instances GPU dédiées et le déploiement de modèles personnalisés, permettant aux développeurs de créer et de faire évoluer des applications d'IA sans gérer l'infrastructure.
GPU
PPIO
PPIO est une plateforme de cloud computing distribué de premier plan qui fournit une puissance de calcul IA, des API de modèles et des services d'edge computing rentables et performants. Elle offre aux développeurs et aux entreprises des solutions complètes pour les applications d'IA, de vidéo et de métavers, avec des GPU sans serveur, des instances conteneurisées et un accès aux grands modèles de langage et multimodaux populaires.
Hébergement de modèles
Union.ai
Union.ai est une plateforme de niveau entreprise, prête pour la production, pour orchestrer des flux de travail complexes d'IA et d'apprentissage automatique. Basée sur l'open-source Flyte, elle permet aux équipes de construire, servir et mettre à l'échelle des systèmes d'IA composés avec des performances et une efficacité inégalées. Elle comble le fossé entre les données et le ML, optimise les coûts du cloud avec des fonctionnalités comme le 'scale-to-zero', et améliore la vélocité des développeurs grâce à une expérience intégrée et transparente.
Orchestration
Float16.cloud
Float16.cloud est une plateforme GPU sans serveur conçue pour accélérer le développement de l'IA. Elle offre un accès instantané à des GPU H100 haute performance avec une facturation à la seconde, aucune configuration et aucun démarrage à froid. Les développeurs peuvent déployer des LLM open-source, entraîner des modèles et exécuter des charges de travail d'IA directement à partir de scripts Python sans gérer l'infrastructure.
Plateforme en tant que service (PaaS)
Nexlayer
Nexlayer est la première plateforme cloud native d'agents, conçue pour permettre aux agents de codage IA de déployer rapidement des applications prêtes pour la production. Elle automatise les infrastructures complexes, permettant aux développeurs et fondateurs de lancer des applications full-stack, des API et des bases de données en quelques minutes sans les frais généraux de DevOps.
Application Development
Cerebrium Comments (0)
Sign in to comment.
ConnexionNo comments yet.